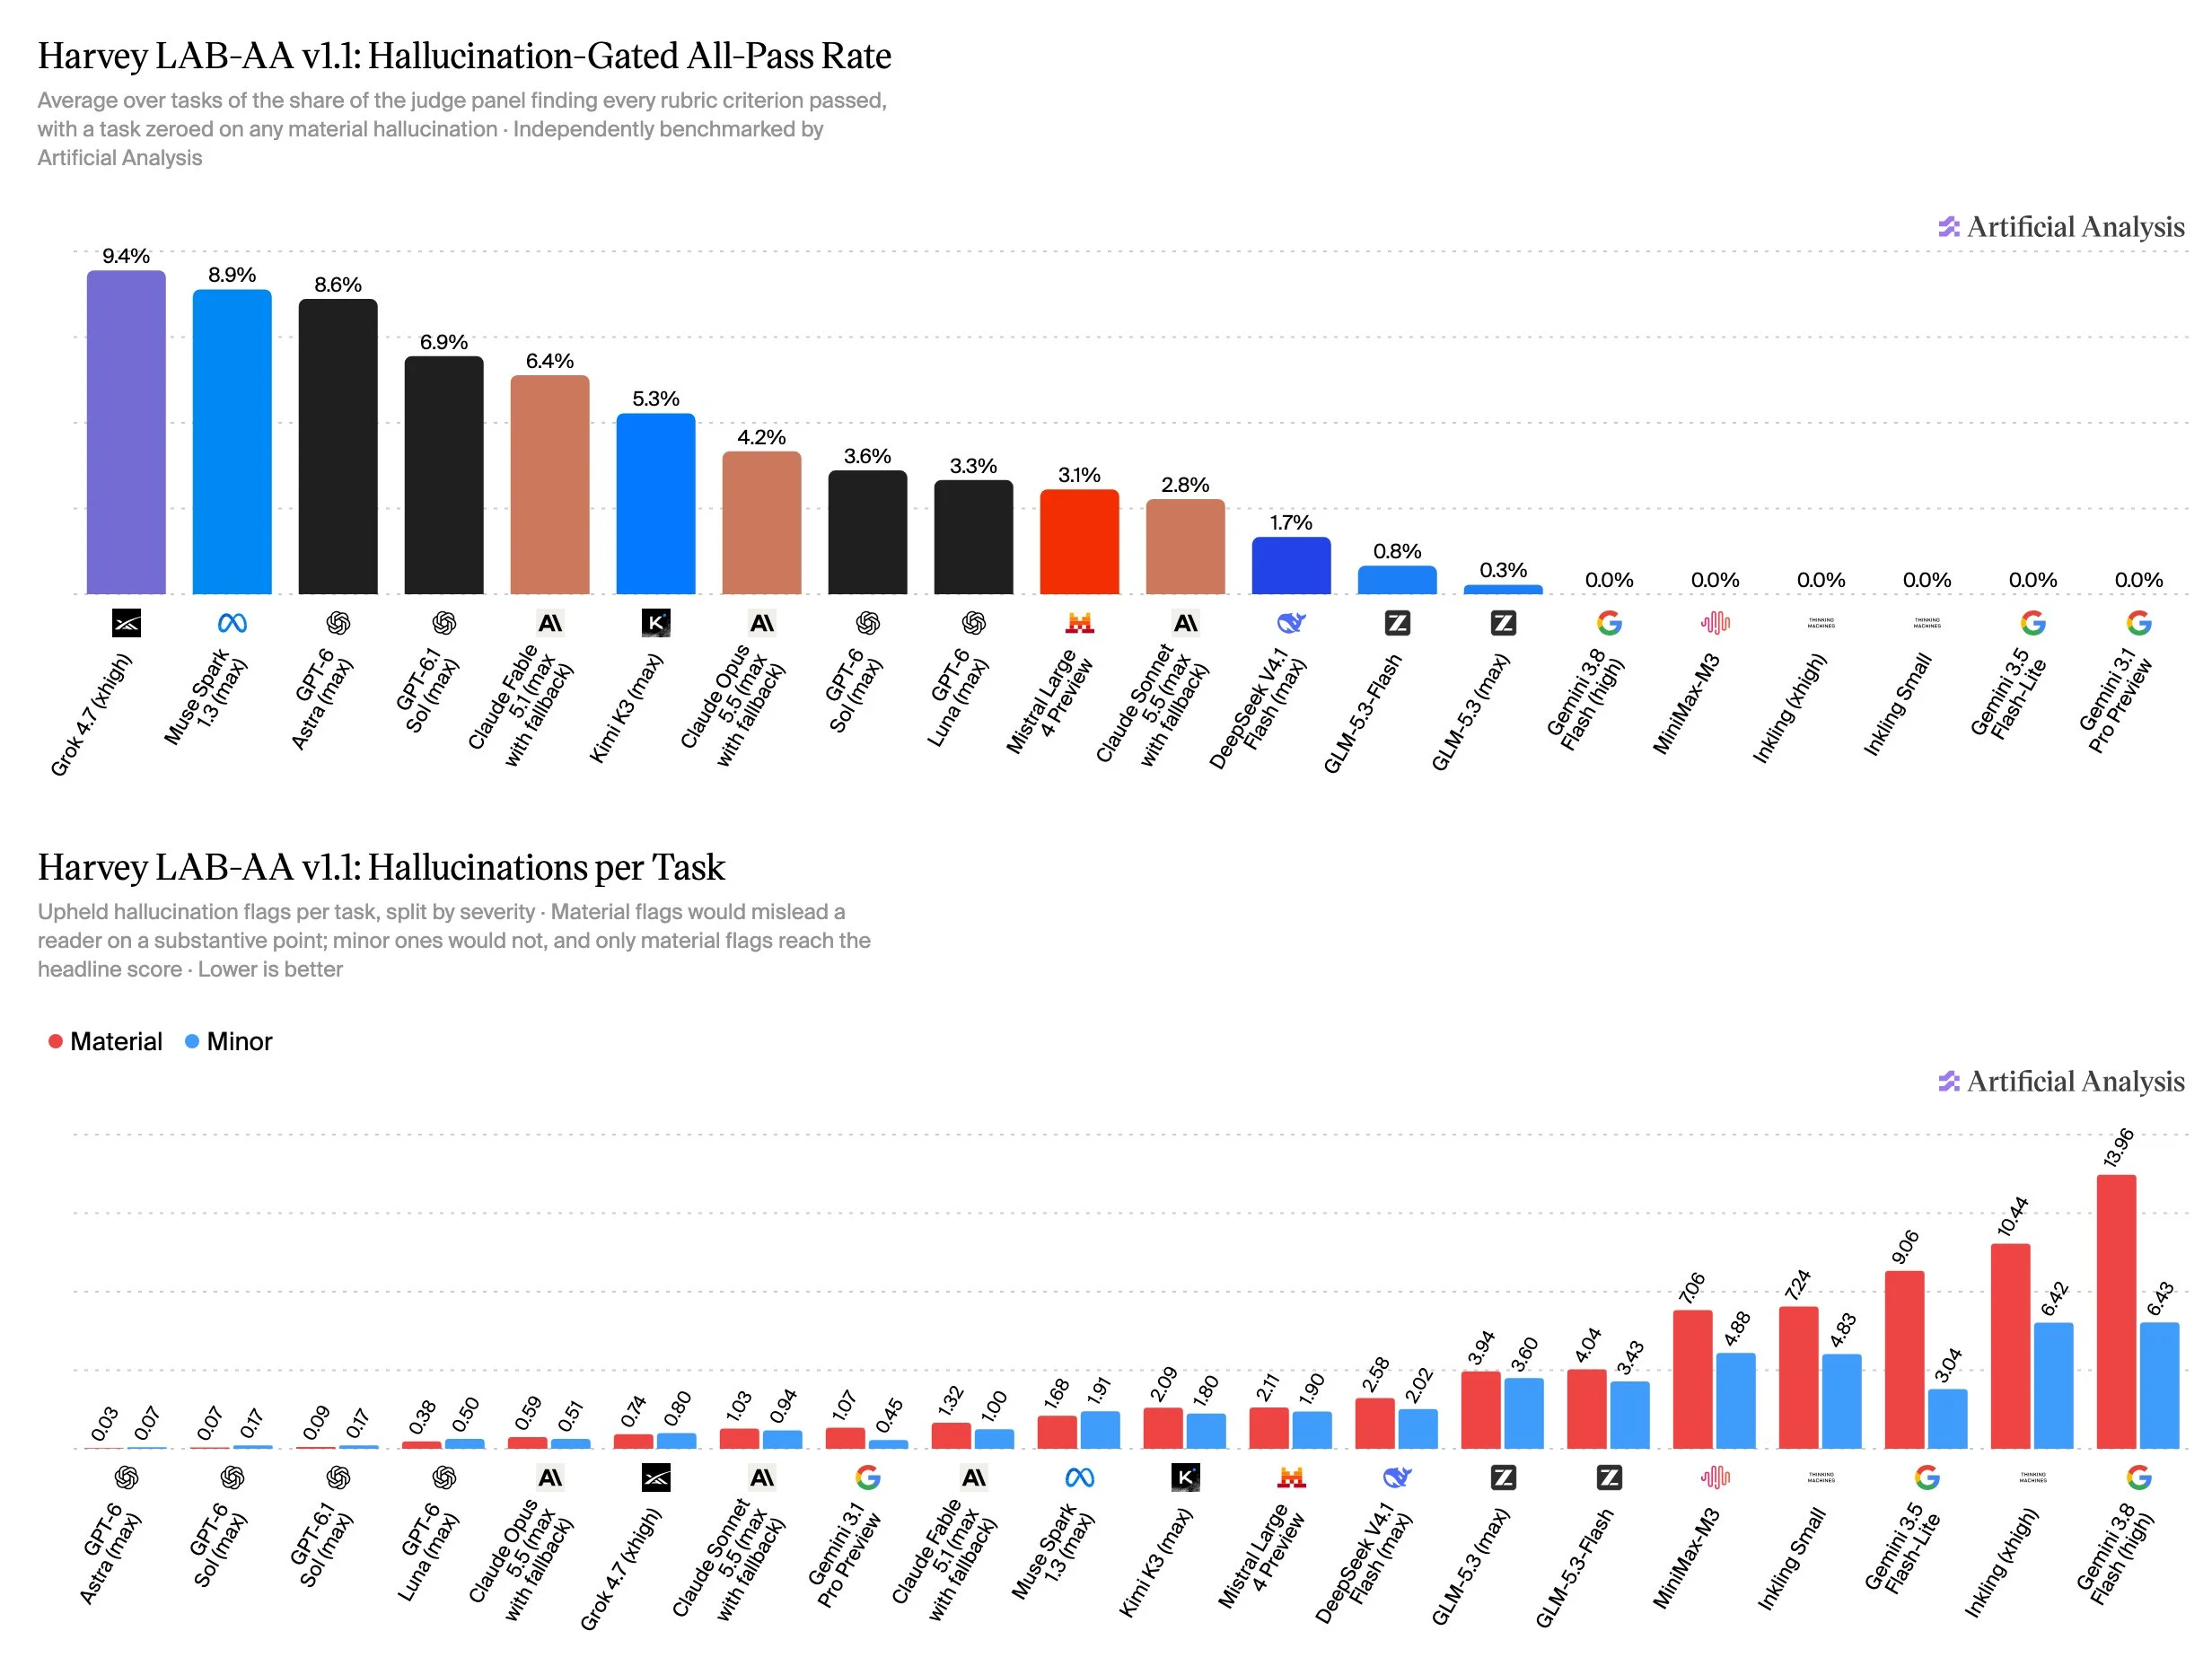
今日、Harveyとの協力によりHarvey LAB-AA v1.1を発表します。これにより、Legal Agent Benchmark(LAB)のスコアリング手法が更新され、 hallucinationチェックが追加され、正確な回答で重大な誤りが含まれないことが求められるようになりました。LAB-AA v1.1の新しい主要指標であるHallucination-Gated All-Pass Rateは、成果物がすべての基準を満たし、重大な hallucinationが含まれていない場合にのみ、タスクにポイントを与えます。
実質的な点、例えば契約上要求される日付が間違っているような点において、読者を誤解させるものを物質的幻想と定義する。一方、軽微な幻想とは、提出物の法的解釈に意味ある影響を与えない実際の誤りである。軽微な幻想は別途報告され、ハイライトスコアには影響を与えない。
Grok 4.7 (xhigh)は、Hallucination-Gated All-Pass率が9.4%で首位を占めている。また、リリース時にテストされたモデルの中で、通過結果の60%以上に実質的な幻覚が含まれている。
これは、Harvey LAB-AAの方法論を向上させるための最初のステップです。今後の更新では、法律家が重視する全ての要因を、スタイルやトーンといった使いやすさの機能も含めてより正確に考慮するために、Harveyと協力しています。
重要なポイント:
➤ ランキングトップ:@SpaceXAIのGrok 4.7 (xhigh)は、Hallucination-Gated All-Pass率が9.4%でリードしており、@AIatMetaのMuse Spark 1.3 (max)が8.9%、@OpenAIのGPT-6 Astra (max)が8.6%であることからわずかにリードしている。
➤ 幻覚が順位表を変える:幻覚ゲートがない場合、Muse Spark 1.3(最大)は26.7%の全通過率で明らかに首位になりますが、そのうち3分の2は一つ以上の物質的な幻覚を含むため、幻覚ゲート付き全通過率は8.9%になります。GPT-6 Astra(最大)は幻覚ゲート後、ほぼ全ての通過を保持し(8.9%から8.6%)、10位から3位へと順位を上げます
➤ GPT-6モデルファミリーが最も信頼性が高い:GPT-6 Astra(最大)は、120のタスクすべてで4回実行される各タスクあたり0.03の物質的幻想を平均し、GPT-6 Sol(最大)は0.07を平均する。20のタスクのサブセット上で6つのチェッカーモデルを比較すると、Claude Opus 5.5(高レベル)を含むすべてのチェッカーにおいて、GPT-6 Astraは0の物質的幻想を示した。対照的に、Gemini 3.8 Flash(高レベル)は各タスクあたり13.96の物質的幻想を平均する。
➤トップスコアモデルが最も高価というわけではありません:Grok 4.7 (xhigh)はリーダーボードで首位に立ち、タスクあたり約9.50ドルのコストです。これは、最も高価なモデルであるClaude Fable 5.1 (max with fallback)の約21.70ドル、つまりコストの半分以下に相当します。Muse Spark 1.3 (max)はコスト対性能が優れており、タスクあたり約4.20ドルで2位になります。
Harvey LABと協力に関する作業でお役に立った@nikogrupenおよび@harveyの@ItsJulioPereyraに感謝します。