
研究によると、AIエージェントチームはほとんど測定可能な品質向上にもかかわらず、大量のトークンを無駄に使っている
 Matthias Bastian
のLinkedInプロフィールを表示
Oct 11, 2026
研究によると、AIエージェントチームは単独のエージェントと比べてほとんど良い結果を出さないことがわかりました。
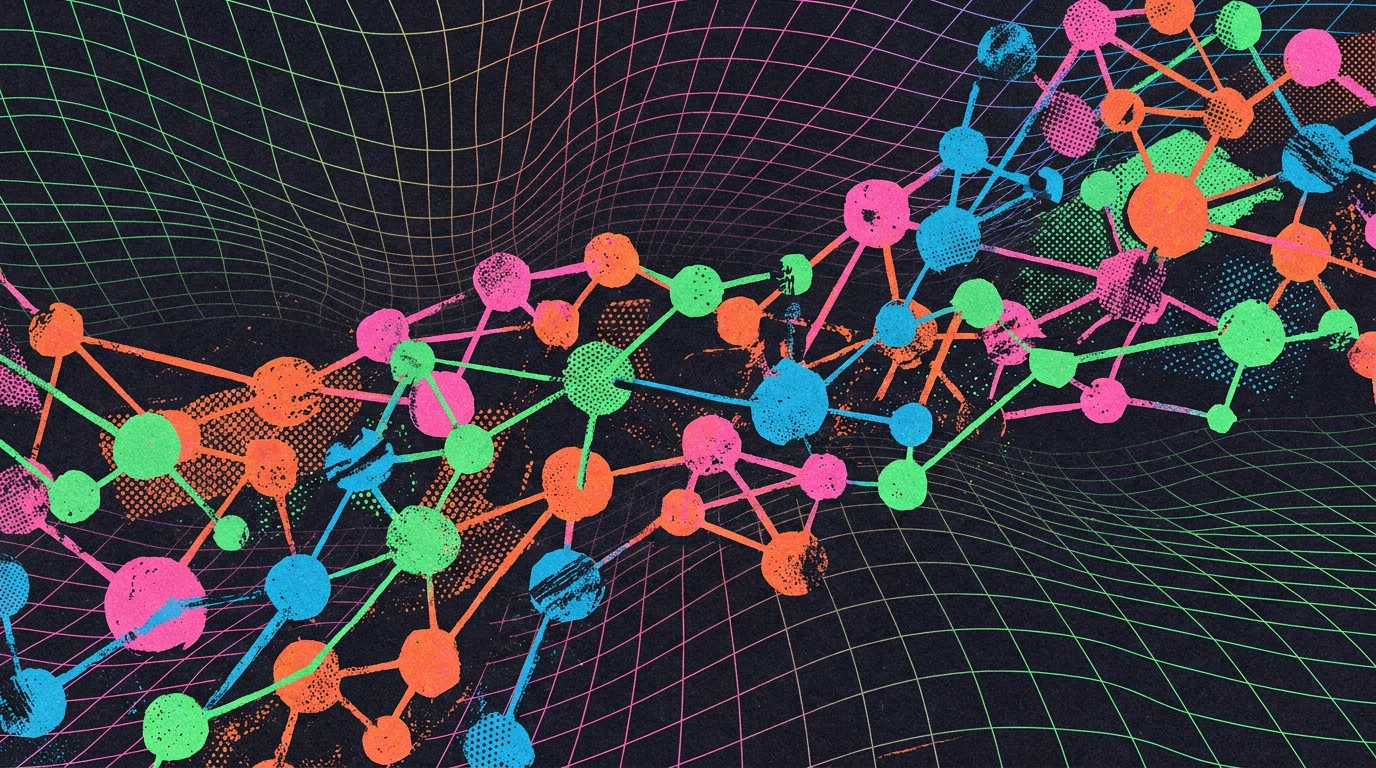
Evals社のVals AIは、「Vibe Code Bench」において、GPT-6 SolとClaude Opus 5.5を、単独でもチームでも、中程度の推論レベルと最大限の推論努力レベルの2つのレベルでテストした。チームのコストは、単一エージェントより1.8倍から5.1倍高かった。
4つの比較において、チームとソロエージェントの間で、統計的に有意な改善が見られたのは1つだけでした。それは中程度の推論能力において、GPT-6 Solが7.3ポイント高い得点を記録したことです。最大限の推論能力では、チーム構成はSolもOpusも5.5の実質的な優位性を与えませんでした。結果からわかるのは、エージェントチームの追加コストは、特にモデルがすでに最大計算能力で動作している場合、ほとんどのケースで価値がないということです。
| Opus 5.5のタスク | 1人のエージェント | 10人のエージェント | 30人のエージェント | 100人のエージェント |
|---|---|---|---|---|
| 知識ベース | 0.53 | 0.70 | 0.71 | 0.74 |
| Lean定理証明 | 0.39 | 0.66 | 0.66 | 0.68 |
Fable 5.1は、10人以上のエージェントの場合、Lean定理証明タスクでより大きな品質向上を示したが、すべてのテストにおいてOpus 5.5よりも低いスコアであった。知識ベースタスクでは、30人から100人へと人数を増やすと、Fableのスコアは実際にわずかに低下した。
さらに多くのエージェントはスピードを求めるが、より良い出力は求めない
OpenAIの研究者ノアム・ブラウンは、Dwarkesh Podcastで、マルチエージェントシステムは主に速度を求めるものであり、品質の向上ではないと確認した。4つのエージェントがタスクを2倍の速さで解決したが、コストも2倍になった。16個のエージェントがある場合にはこのパターンは維持されたが、効率性はわずかに低下した。
効果はタスクに大きく依存する。ウェブリサーチや数学はうまく並行処理できるが、小説の執筆にはそうではないと彼は言った。小説に対して10,000人のエージェントを投入することは、10,000人を投入することと同じく無意味だとブラウンは認めた。コストがあまりにも高いため、非常に多くのエージェントを扱う方法はほとんど研究されていないという。
OpenAIの開発者エリック・プロヴェンシェは、ちょうどこの理由からエージェント群の使用に反対している。彼は、エージェント間の調整が崩れるため、それはおそらく無駄な費用だと主張した。彼はこれを「調整税」と呼んだ。
アイアイニュース 過度な宣伝なし – 人間が選んだ情報
広告なしの読書、毎週のAIニュースレター、年に6回の独占的「AI Radar」フロンティアレポート、完全なアーカイブアクセス、およびコメントセクションへのアクセスを得るために、THE DECODERを購読してください。
全体の内容はこちらです。
話題を排除した報道をお届けします。
- THE DECODERのすべての記事に完全なアクセス権
- 広告なし
- コメントやコミュニティの議論に参加する
- 週刊のAIニュースレビューをメールで送る
- 6回/年:「AIレーダー」――最も重要なAIのテーマに関する深い探求
- 毎日のAIニュース、常に最新です
- 私たちの完全な10年間アーカイブ
- AIに関する10年以上の経験を持つチームによって担当されている