IT之家 10月12日の報道によると、アリ千問は本日、QwenGyreを正式に発表した。これは長期的なインテリジェントアプリケーションタスク向けのオンライン強化学習フレームワークである。
公式によると、スマートアイドルが複雑な作業を担当する際、一度の実行には数時間がかかり、モデルと環境の間で数百回の相互依存したインタラクションが行われ、百万レベルのトークンが処理されるという。QwenGyreは弾性スケジューリングと軌道処理を通じて、このような長時間にわたるタスクを有効な訓練源にすることに成功し、能力と効率の向上ももたらされる。
QwenGyreはGPUをいくつかの計算ユニットに分けることができ、タスクが一連を終わるたびに空いたユニットが訓練に移ります。まるでプロジェクトチームで誰かが先に成果を出し、先に振り返りに参加するようにです。進行中のタスクは全く邪魔されず、進捗と状態がそのまま保持され、以前計算したキャッシュも全体として移動し、やり直す必要はありません。新たに空いたユニットは直接このラウンドの訓練に加わり、計算が速い人が多くの仕事を担当し、最終的に核心ユニットが結果をまとめて、パラメータ更新が行われます。
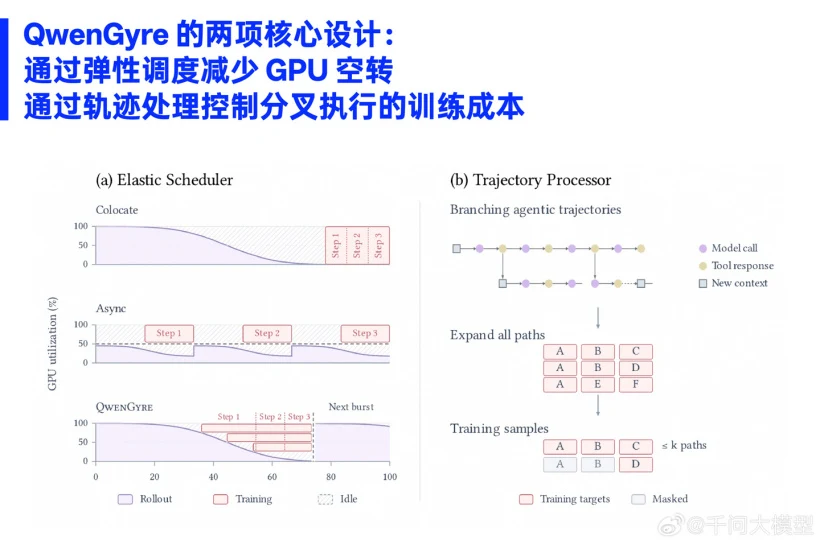
IT之家が注視したところによると、QwenGyreはToken-in Token-out方式を通じて、各出力が生成された際の実際の文脈を記録し、共有プレフィックスで構成されたトラックツリーに整理され、選択されたパスのみが訓練サンプルとして展開される。同時に、タイムオーバーだが部分的に完了したタスクもPartial Scoringを通じて有用なフィードバックを提供し、どの努力も無駄にはならない。
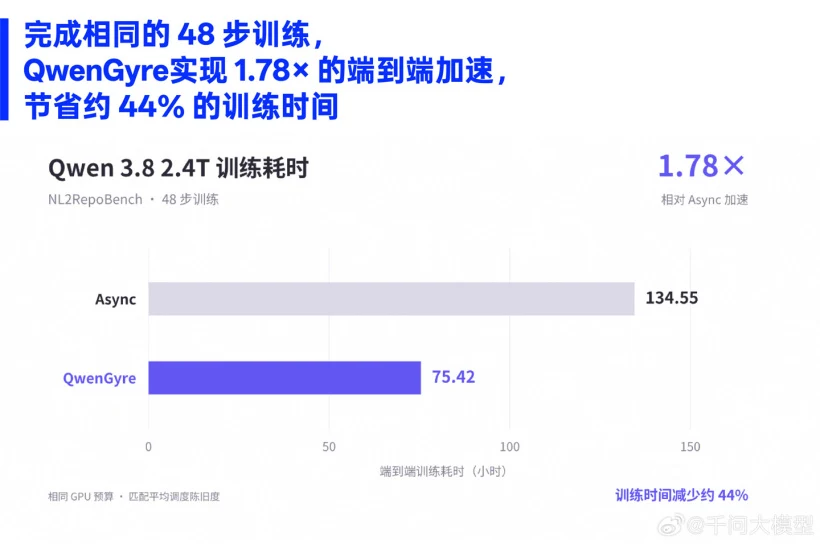
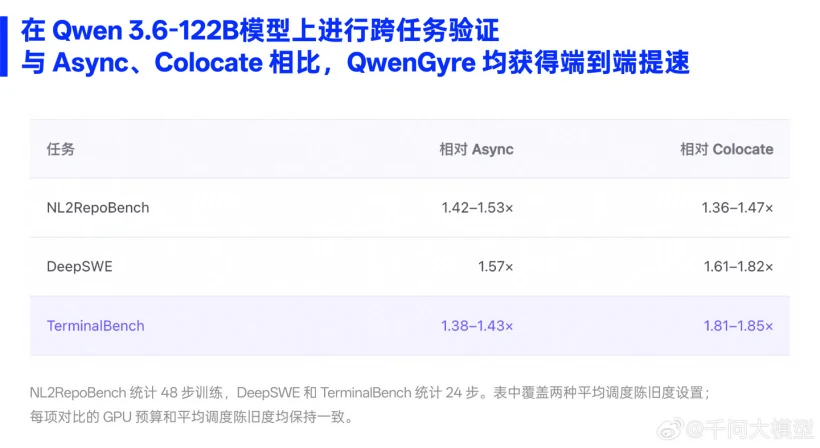
パフォーマンスに関しては、公式チームがNL2RepoBenchのオンライン強化学習実験において、各ローリングで約70万トークンを処理するタスクで訓練を行い、48ステップの訓練後、モデルの通過率は52.5%から58.5%に向上した。同じGPU予算で、QwenGyreはAsync方式に比べて1.78倍のエンドツーエンドの加速が実現され、訓練スコアはAsyncやColocateとほぼ同等であった。Qwen3.6-122B上での異なるタスク間の検証では、NL2RepoBench、DeepSWE、TerminalBenchの3種類のタスクすべてでエンドツーエンドの速度向上が確認された。