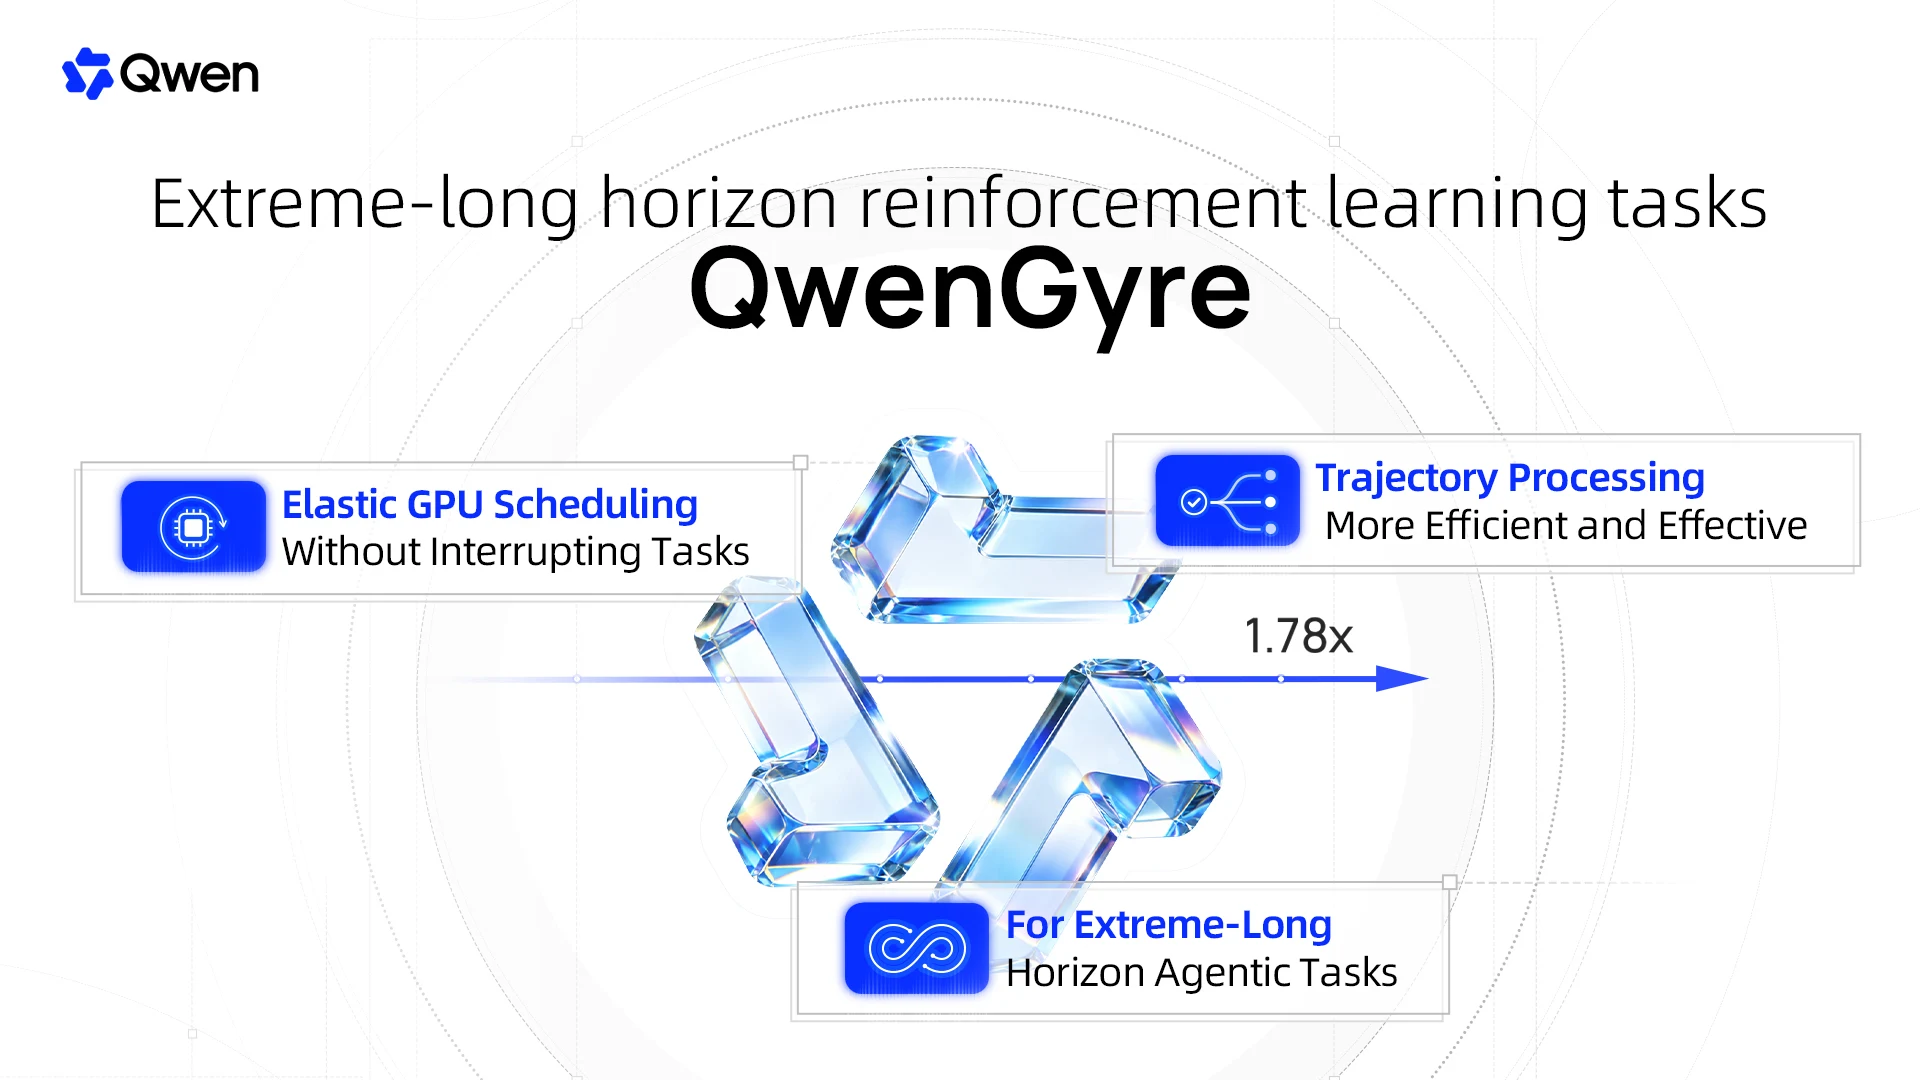
QwenGyre を紹介します。エラスティック RL を極限の長期ホライズン(XLong)エージェント学習にもたらします。✨
2つの中核設計とともに登場します:🥳
- Elastic Scheduler:需要の変化に応じて rollout と training の間で GPU を再配分—実行中のタスクは中断されません。Colocate 比 最大1.85倍、Async 比 1.78倍の高速化。
- Trajectory Processor:分岐する実行(コンパクション、サブエージェント、リトライ)を、プレフィックス共有の軌跡ツリーへと変換し、学習サンプルを上限付きかつ重複排除した形にします。タイムアウト後の部分的な進捗も評価されます。
Qwen3.8-2.4T-A95B で1ロールあたり約700Kトークンにスケールし、QwenGyre は NL2RepoBench を48ステップで 52.5% から 58.5% へ引き上げ、Async 比でエンドツーエンドの学習時間を約44%削減しました。
🔗 論文はこちら:
https://arxiv.org/abs/2609.33848