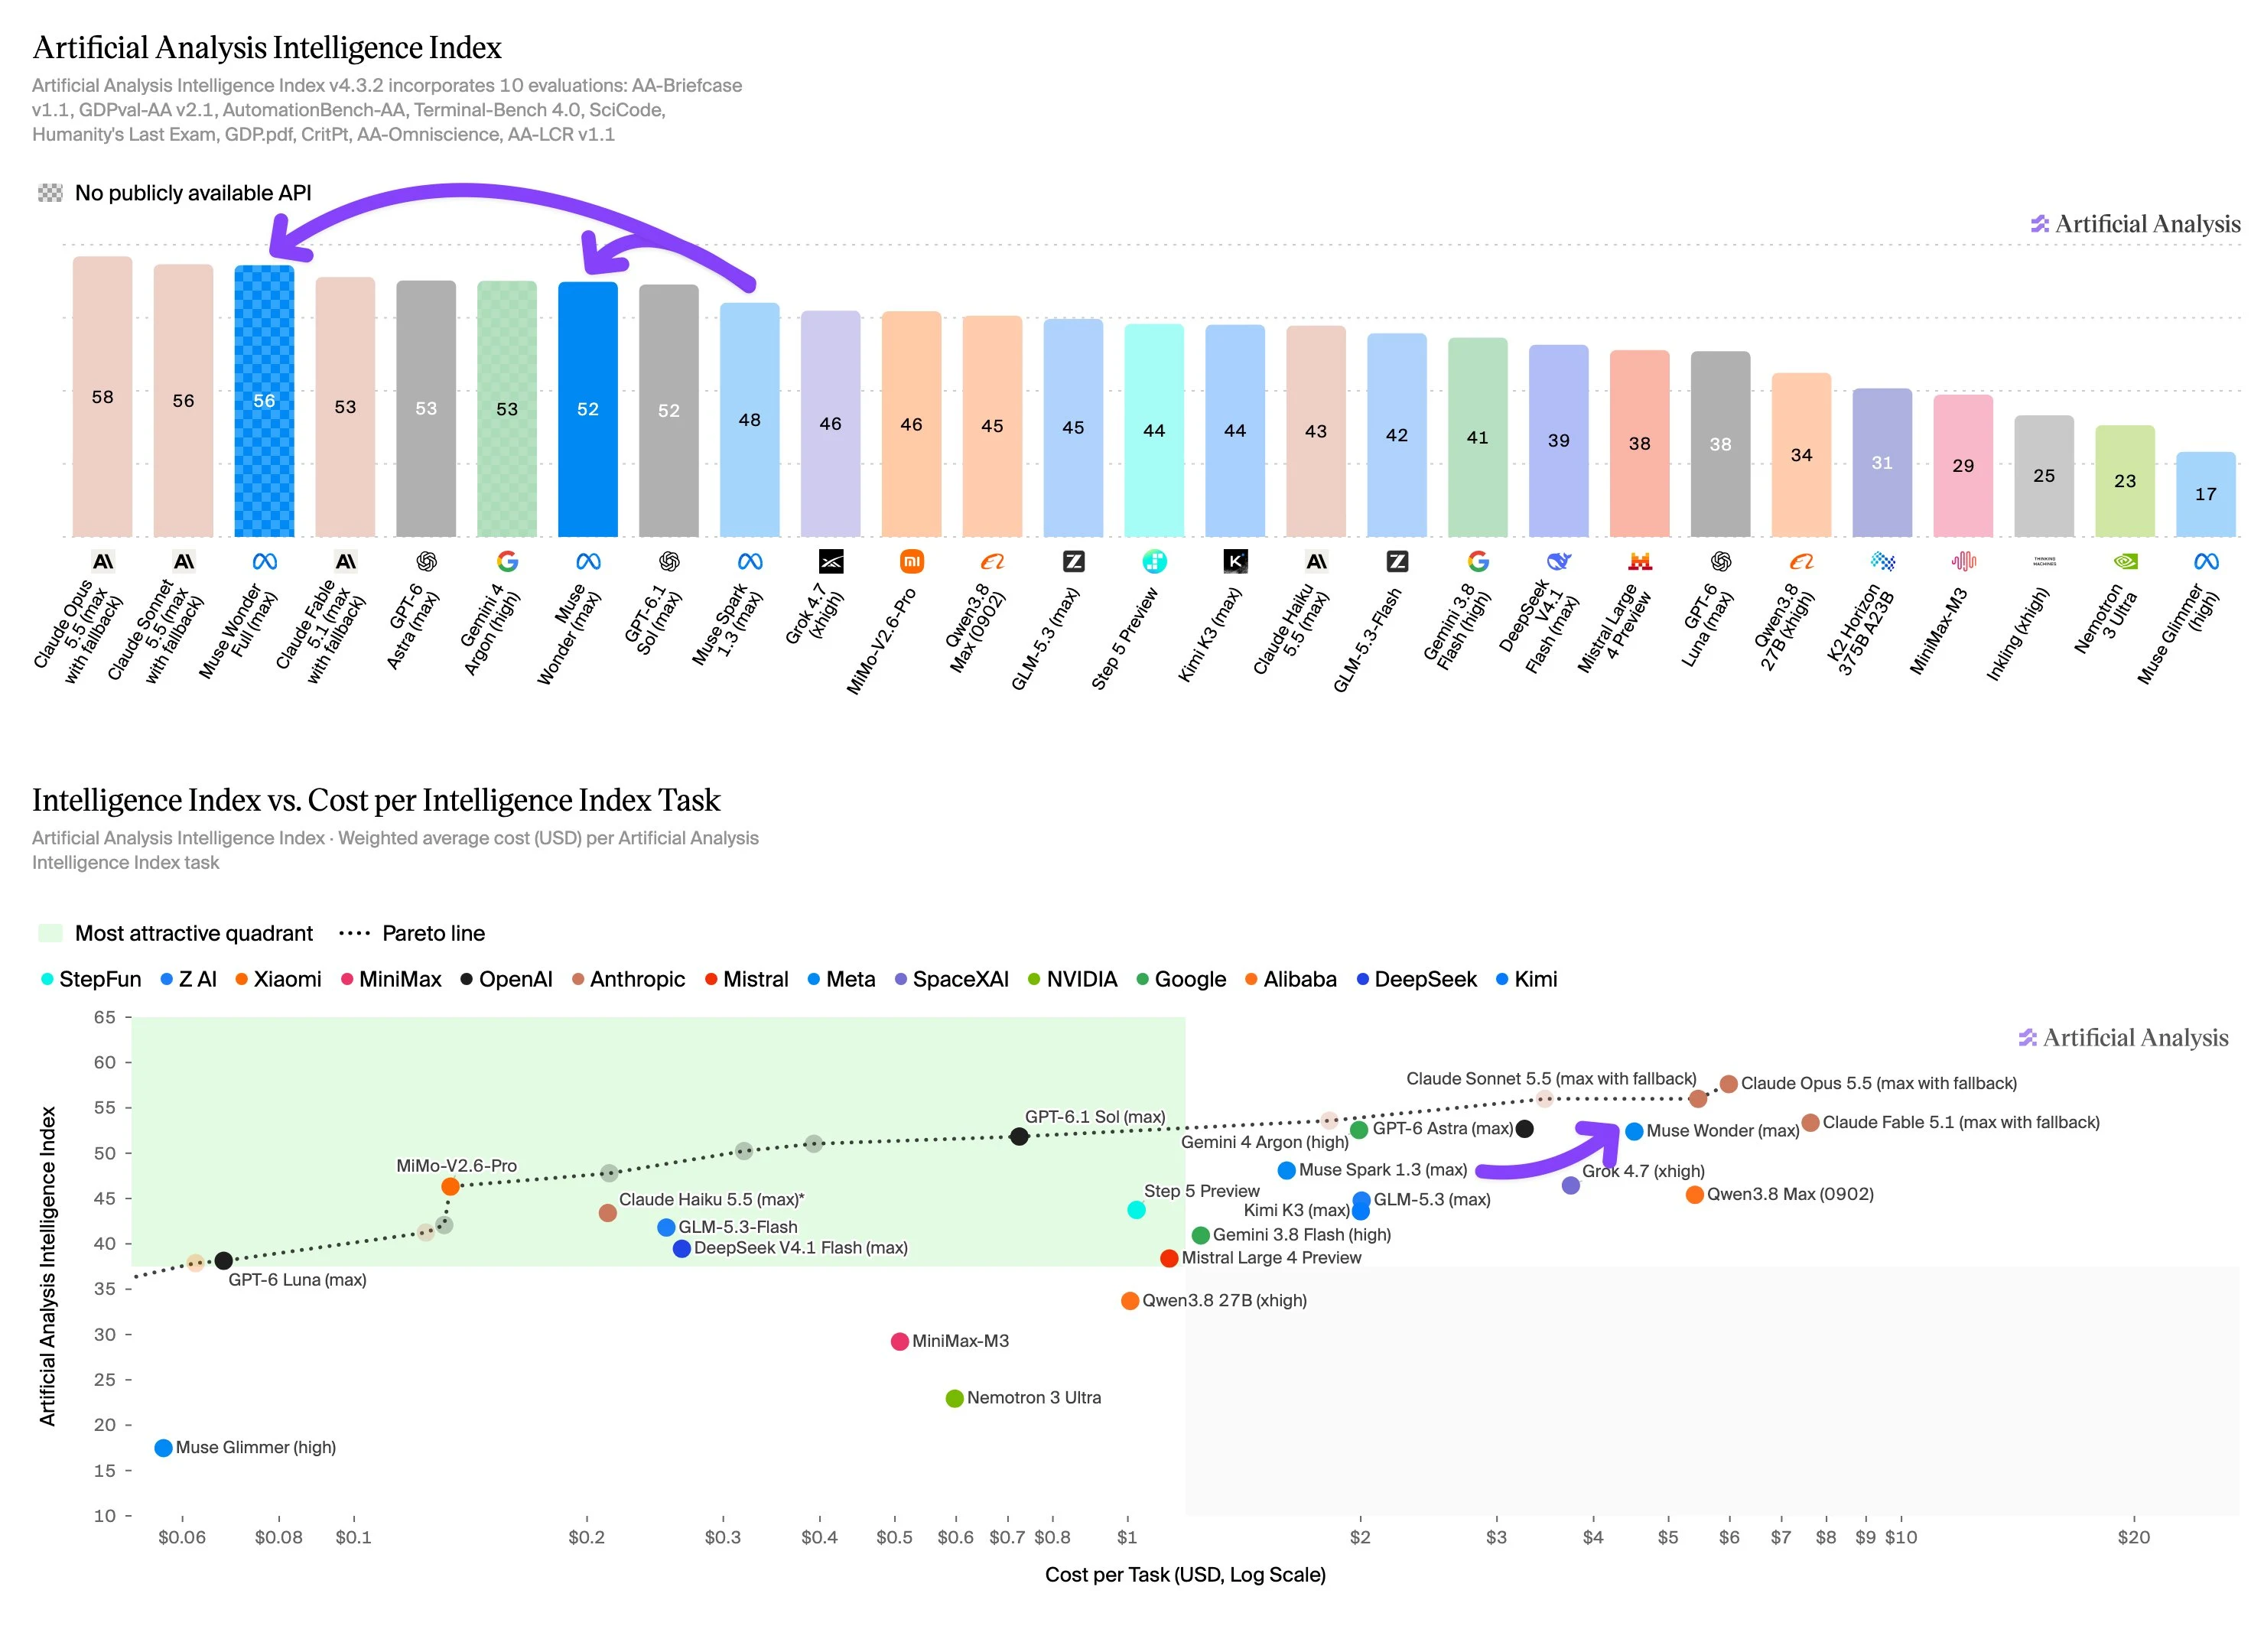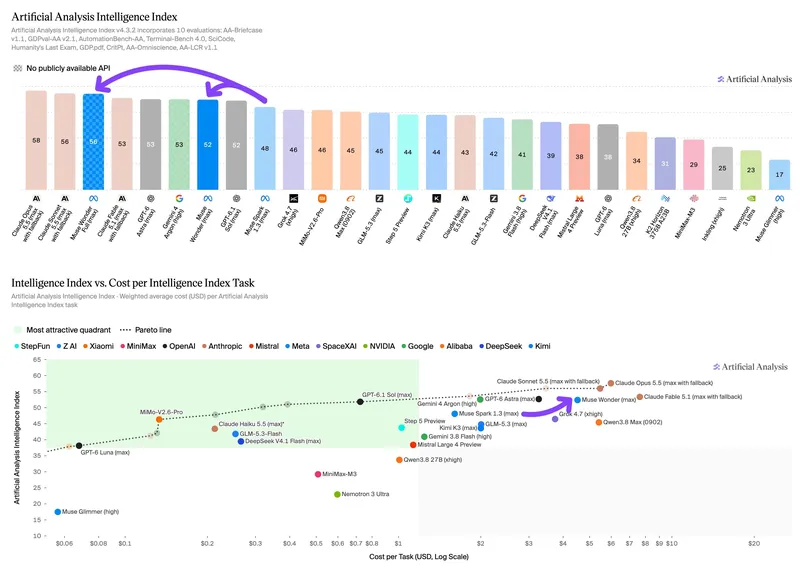
MetaはMuse WonderとMuse Wonder Fullを発表し、最大の推論努力下で人工分析インテリジェンス指数v4.3で52点と56点を記録した。これは、Muse Spark 1.3(最大)の48点よりも大きな成果であり、発売間隔はわずか6週間であった。
Muse WonderはMetaの第一方APIを利用できるユーザー向けですが、Muse Wonder Fullは現在Muse Codeユーザー限定で利用可能です。Metaによると、各モデルは個人用およびプロフェッショナルエージェント用に設計されているとのことです。
@AIatMeta、@finkd、@alexandr_wangのリリースを祝福します!
重要なポイント:
➤ 両モデルは全体的なインテリジェンス指数スコアにおいて材料の飛躍的な向上を示しています。Muse Wonder Full (max)は、10回のインテリジェンス指数評価を通じてMuse Spark 1.3 (max)を上回り、8ポイントで56に達しました。最大の改善はエージェントベースの評価で見られました:Terminal-Bench 4.0 (+24ポイント、33%から57%)、GDPval-AA v2.1 (+176 Elo、1681から1857)、AA-Briefcase (+148 Elo、1581から1729)です。Muse Wonder (max)は4ポイントのインテリジェンス指数を獲得し、52に達し、顕著な改善が見られました。 Muse Spark 1.3(最大)は、Terminal-Bench 4.0で33%から52%、AutomationBench-AAでは58%から68%の性能を示す。
➤ Muse Wonder Full (max)は、10のIntelligence Index評価のうち6つでトップ3に入り、特にエージェント型知識作業と科学的推論において優れています。エージェント型知識作業では、GDP.pdfで33%の差で首位となり、GDPval-AA v2.1では1857 Eloで2位、AA-Briefcaseでは1729 Elo、AutomationBench-AAでは71%で3位です。科学的推論では、CritPtリーダーボードで33%で首位となり、SciCodeでは63%で3位です。 これは、Muse Spark 1.3(最大)の相対的な強みに基づいています。Muse Spark 1.3は、これら二つの分野において特に優れた能力を示しました。
➤ 両モデルはMuse Spark 1.3 (最大)よりも少ない出力トークンを使用します。Muse Wonder (最大)およびMuse Wonder Full (最大)は、Intelligence Indexタスクあたり約54kの出力トークンを使用し、Muse Spark 1.3 (最大、60k)よりも約10%低いです。この使用量は、同程度の知能を持つモデルであるGemini 4 Argon (高、62k)やClaude Fable 5.1 (最大、フォールバックあり、78k)よりも低いですが、GPT-6.1 Sol (最大、38k)やGPT-6 Astra (最大、27k)よりは高いです。 Muse Wonder Full (max)は、Intelligence IndexタスクにおいてMuse Wonder (max)より16%少ない入力トークンを使用する(6.44M対7.69M)。つまり、より知能が高く、トークン効率も高いということだ。
➤ Muse Wonder (max)のタスクあたりのコストは、他の同程度の知能を持つモデルよりも高くなります。効率的な出力トークン使用にもかかわらず、プレミアムAPIの料金(百万入力トークンあたり$4、百万出力トークンあたり$20)と高い入力トークン使用量(1タスクあたり7.69M)により、Muse Wonder (max)のコストはIntelligence Indexタスクあたり$4.52に上昇します。 これはClaude Fable 5.1(フォールバル対応最大価格、7.63ドル)、Claude Opus 5.5(フォールバル対応最大価格、5.98ドル)、Claude Sonnet 5.5(フォールバル対応最大価格、5.46ドル)より低いが、GPT-6 Astra(最大価格、3.26ドル)、Gemini 4 Argon(高価格、1.99ドル)、GPT-6.1 Sol(最大価格、0.72ドル)、およびその前代モデルMuse Spark 1.3(最大価格、1.60ドル)より高い。Muse Wonder Fullのペーター単位価格は現時点で利用できないため、この段階ではタスクあたりのコストを推定することはできない。
➤ 両モデルはコーディングエージェントの性能が大幅に向上しました。Muse Wonder Fullは、Muse Codeにおいて人工分析コーディングエージェント指数で68点を記録し、Claude CodeとSonnet 5.5(最大値、68点)およびOpus 5.5(最大値、66点)と並びました。Muse Wonder(最大値)は63点です。これらは、Muse Spark 1.3(最大値)で54点を記録するMuse Codeよりも実質的な向上を示しています。
新しい2モデルのその他の詳細:
➤ コンテキストウィンドウ:各1Mトークン、Muse Spark 1.3と同様のまま
➤ 料金:Muse Wonderの場合、1Mトークンあたり入力4ドル/キャッシュされた入力0.20ドル/出力20ドル。Muse Wonder Fullのトークンあたりの料金はまだ発表されていない
➤ 入力形式:テキスト、画像、ビデオ、音声
➤ 出力形式:テキスト
➤ 利用可能性:Muse Wonderはリリース時にMetaの第一方APIおよびMuse Codeで利用可能であり、Muse Wonder FullはMuse Codeユーザーのみが利用できる