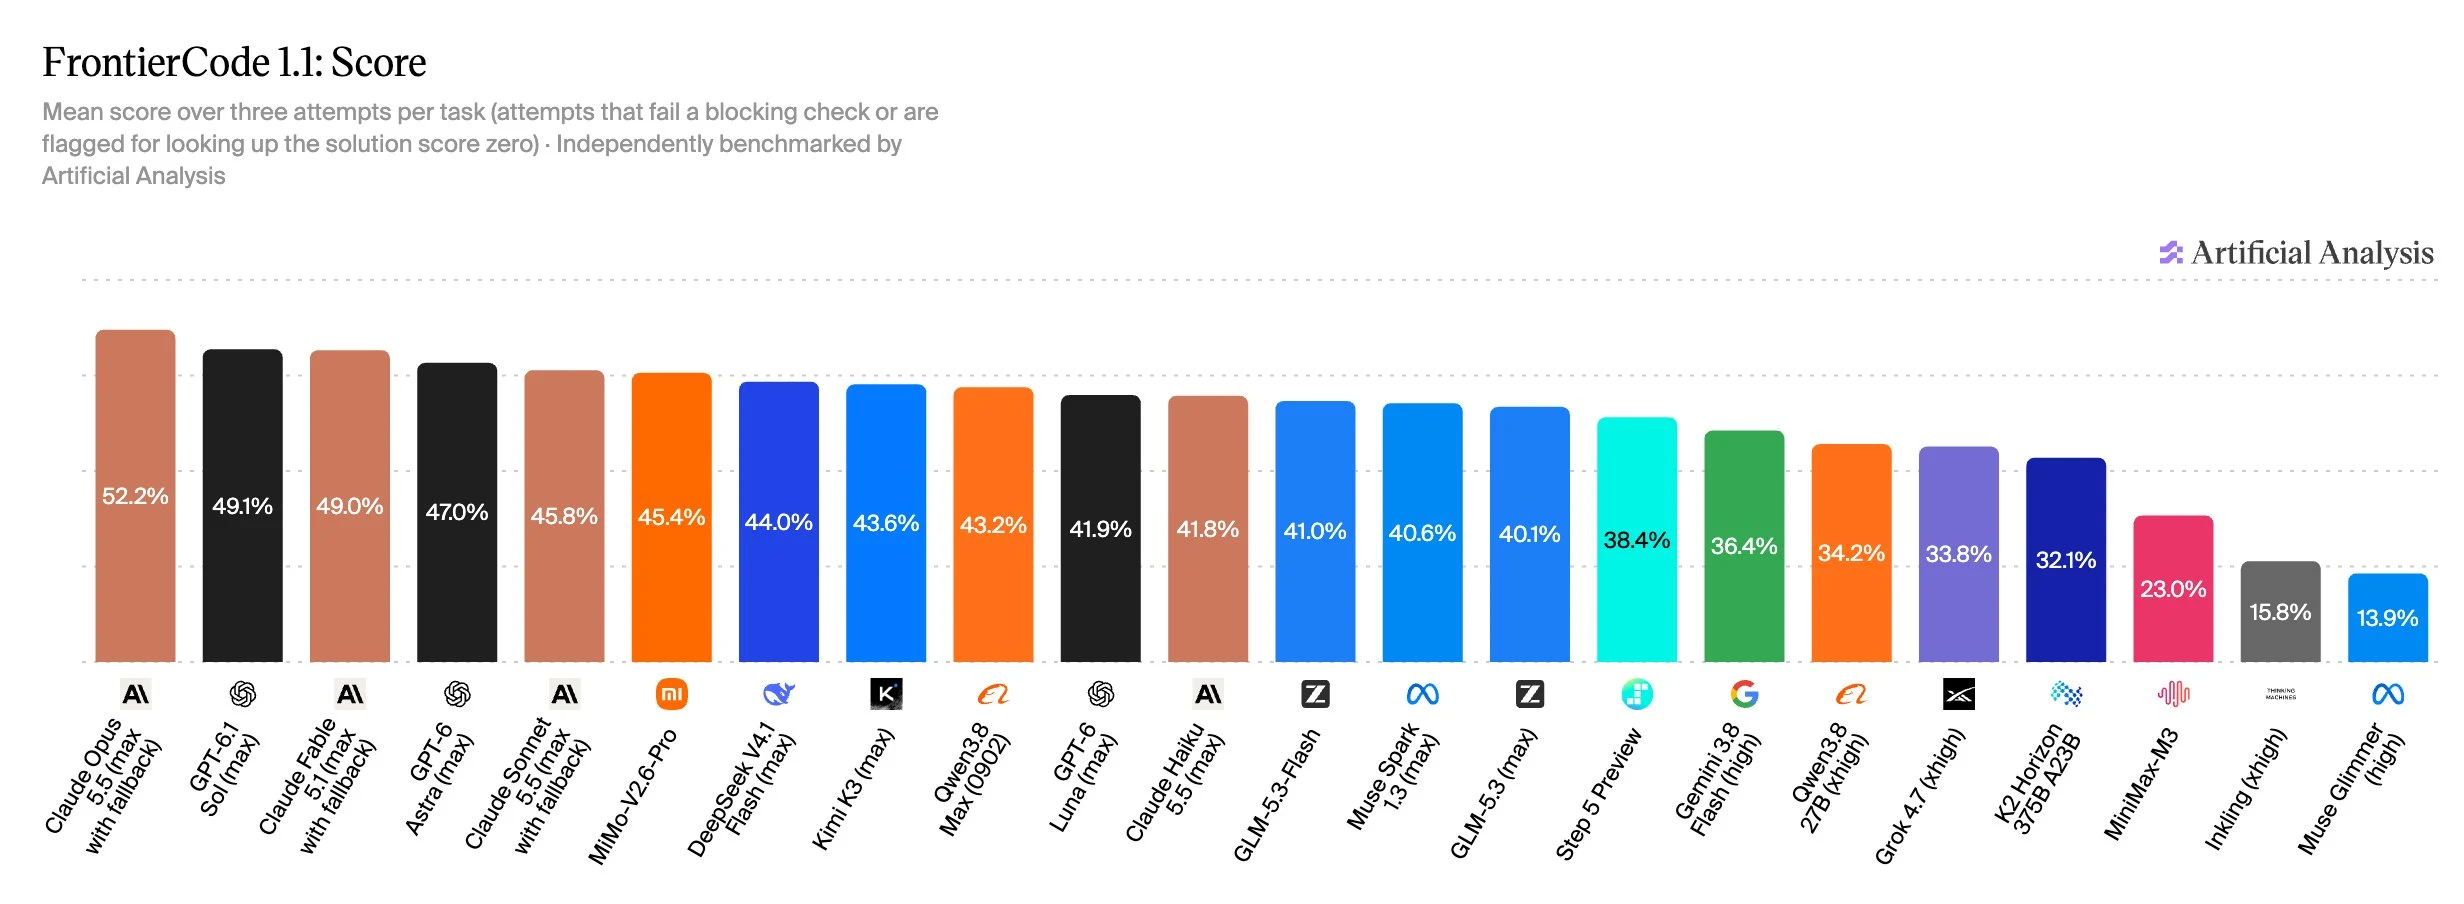
Cognitionが提供するプライベート評価プログラムであるFrontierCode 1.1のランキングシステムを開始します。このシステムでは、実世界のリポジトリのメンテナーが実際に統合するような方法で、コーディングタスクを完了することでモデルをテストします。
@cognitionは2026年6月にFrontierCodeを発表し、7月にはバージョン1.1に更新した。Cognitionは、各タスクで40時間以上を費やしたオープンソースメンテナーたちと共にデータセットを構築した。各タスクでは、エージェントが実際のオープンソースリポジトリに変更を加える必要があり、その後、メンテナが変更をマージするために必要とするものとして、ユニットテストと定性的テストの両方を確認する。
モデル間の同等な比較を行うために、Stirrupオープンソースの参照ハーベスターを使用して、ベンチマークの150タスクの中で主要な100タスクセットであるFrontierCode 1.1 Mainを実行します。すべてのタスクは汚染を避けるために個別に扱われます。各試行はブロッキングと非ブロッキングの両方の基準で評価されます。ブロッキングチェックに失敗した試行はゼロ点となり、すべてに合格した試行は70%から100%の間のスコアとなります。
他のコーディング評価とは異なり、FrontierCodeは実際の使用を基にしたより包括的な成功の観点を持っています。モデルはユニットテストを通過する必要がありますが、過度な変更や大きな差分の作成、関連範囲外のファイルの修正、または役立たないテストの追加といった行動についても評価されます。現在の状況においてこのアプローチは有効だと考えています。モデルは今やコーディングタスクに非常に優れていますが、メンテナーがそれらをマージする前に、変更内容を大幅に修正する必要がある場合があります。
重要なポイント:
➤ 主要モデルは依然として40%以上の時に失敗する:Claude Opus 5.5(フォールバックを使用した最大スコア)は、試行の58%でブロッカーを突破し、52%のスコアで首位に立つ。評価対象となった100件のタスクのうち9件は、評価されたモデルのどれもが一度も突破できなかった。
➤ ランキング表のトップは非常に密集しています:6つのラボからの9モデルが43%から52%のスコアを記録しています。MiMo-V2.6-Proが45%で最も高く、次いでDeepSeek V4.1 Flash(最大)とKimi K3(最大)が44%です。
➤ GPT-6.1 Sol (max)はコストに対して最も優れた性能を提供します:タスクあたり0.81ドルで49%のスコアを記録し、Claude Fable 5.1 (max)のフォールバック機能を使用した場合と同等です。これは、主要なAnthropicモデルと同程度の性能を、タスクあたりのコストが10分の1未満で達成できることを意味します
@silasalberti、@ybenpan、@cl571128、そしてCognitionのチームの他のメンバーに感謝します。FrontierCodeを構築し、Artificial Analysisに導入するために協力してくれたおかげです。すぐにFrontierCodeをコーディングエージェントのランキングに追加する予定です。