
重要なポイント
- AI Search により、「ユーザーは不満を感じたか?」や「PII が漏洩したか?」のような、トレースの意味的理解に基づいて会話を検索できるようになりました。
- 平易な言葉でふるまいを記述すると、高速な判定モデルがトレースを読み取り、そのふるまいが発生したものを返します。
- LangSmithは使用しています 軌跡 トレースを正規化し、コンテキストの肥大化を抑え、クエリ結果を高速に提供するためです。
エージェント 跡 大規模で、マルチモーダルであり、情報密度が高いものです。トレースには、ユーザーの入力、エージェントの応答方法、ロジックの失敗といった重要な詳細が記録されます。そのため、ユーザー行動の理解やエージェントのパフォーマンス向上に固有の価値を持つ一方で、従来のデータプラットフォームはこのような大規模な非構造化ペイロードを扱うようには作られていませんでした。
トレースデータを活用するには、ライフサイクル全体を支えるインフラが必要です。大量の実行データを取り込んで保存し、トレースを柔軟にクエリし、それをデバッグ、プロダクト分析、アノテーションのような運用ワークフロー向けのビューへと変換することです。それが、私たちが SmithDB を構築した理由です。SmithDB は、次の用途のためにトレースデータ専用に設計されたデータベースです。 LangSmith、また近年では カスタムアプリトレースをもとにチームがカスタマイズされたビューを作成できる機能です。
本日、追加するのは AI検索自然言語を使ってトレースを照会する新しい方法です。
なぜ私たちはAI Searchを構築したのか
各トレースには、ユーザーの入力、エージェントの推論、ツール呼び出し、応答が含まれており、エージェントがどこで良好に動作し、どこで失敗しているかを理解するために必要なすべての情報が揃っています。LangSmithを利用するチームは、エージェントのトレースを精査して、評価(eval)のための事例を見つけ出すことがよくあります。 データセット または審査担当者のための会話 アノテーションキュー.
しかし、適切なトレースを見つけるのは手間がかかります。「PII が漏洩したか?」や「ユーザーが不満を感じたか?」といった質問は、タグやメタデータのような単一のトレース属性にきれいに対応づけることができず、全文検索でも答えることはできません。これらにはトレースの内容を理解することが必要です。これまでは、事前に評価ツールをセットアップするか、トレースを手動で確認する必要がありました。
こうした理由から、私たちはAI Searchを構築しました。探している動作を記述すると、LangSmithがそれが発生したトレースを返します。これにより、干し草の山から針を探すようなトレースを見つけたり、問題のあるパターンをその場で検索したりできるようになります。
検索できる内容
トレースのコンテンツに現れるものなら何でも検索できます。タスクを完了したと言ったのに実際には完了していなかったエージェント、不満を感じたり回答に反論したりしたユーザー、PIIを漏洩したモデルへのリクエスト、サブスクリプションを解約しようとしているユーザーなどを探すことができます。プロダクトチームは「サポートしていない統合への要望」「競合の言及」「オンボーディングに混乱したユーザー」などを検索し、ユーザー自身の言葉でプロダクトの不足点を把握できます。
AI Searchは、すでに使用しているフィルタとも連携して動作するため、エラーが発生したトレースのみを対象に検索したり、特定のタグが付いたものだけを対象に検索したりできます。
どのように作ったか
モデルがすべてのトレースを読み取る理由
ベクトル検索は、完全一致の単語ではなく意味で検索する一般的な方法です。この方法では、クエリと各トレースを、テキストの内容を捉えた短い数値のリストである埋め込み(embedding)に変換します。そして、クエリの埋め込みに最も近い埋め込みを持つトレースを返します。これは、請求に関する会話を見つけるといったトピック検索には有効です。しかし、埋め込みはトレース全体を1つの小さなベクトルに詰め込むため、その圧縮には情報の欠落が伴います。クエリに関連する重要な詳細が失われることがあります。エージェントが実際に作業を成功させたトレースと、成功したと言っただけのトレースが、ほぼ同じ埋め込みになってしまうこともあり得ます。これらを区別するには、トレースの実際の言葉を質問とともに読み取り、何が起きたのかを推論できるモデルが必要です。
最近まで、検索時にそれを行うのは遅すぎてコストも高すぎました。高速な決定モデルがこれを変えました。決定モデルは、入力についての1つの狭い質問に、大規模に実行できるほど素早く安価に答えます。AI Searchは決定モデルの推論を、エージェントオブザーバビリティ向けのデータレイヤーである SmithDBと組み合わせています。トレースが到着すると、SmithDBはそれらを軌跡(トラジェクトリ)に変換します。検索を実行すると、フィルタが候補を絞り込み、決定モデルが残りの各軌跡をあなたの説明と照合します。
トレースは大きく、さまざまな形式で存在する
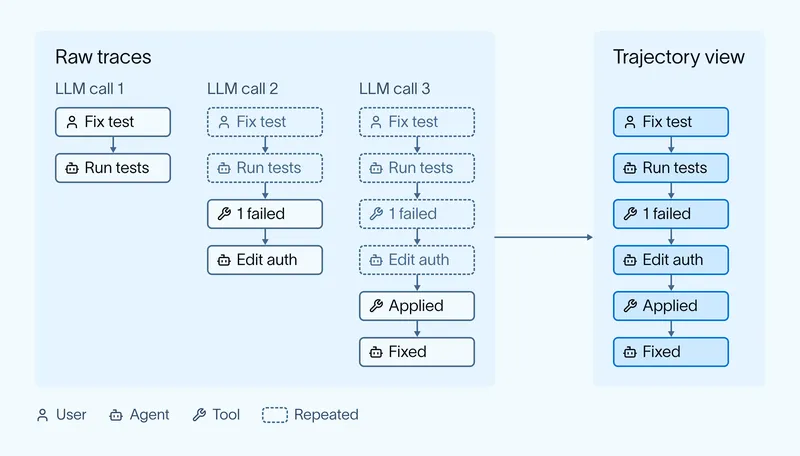
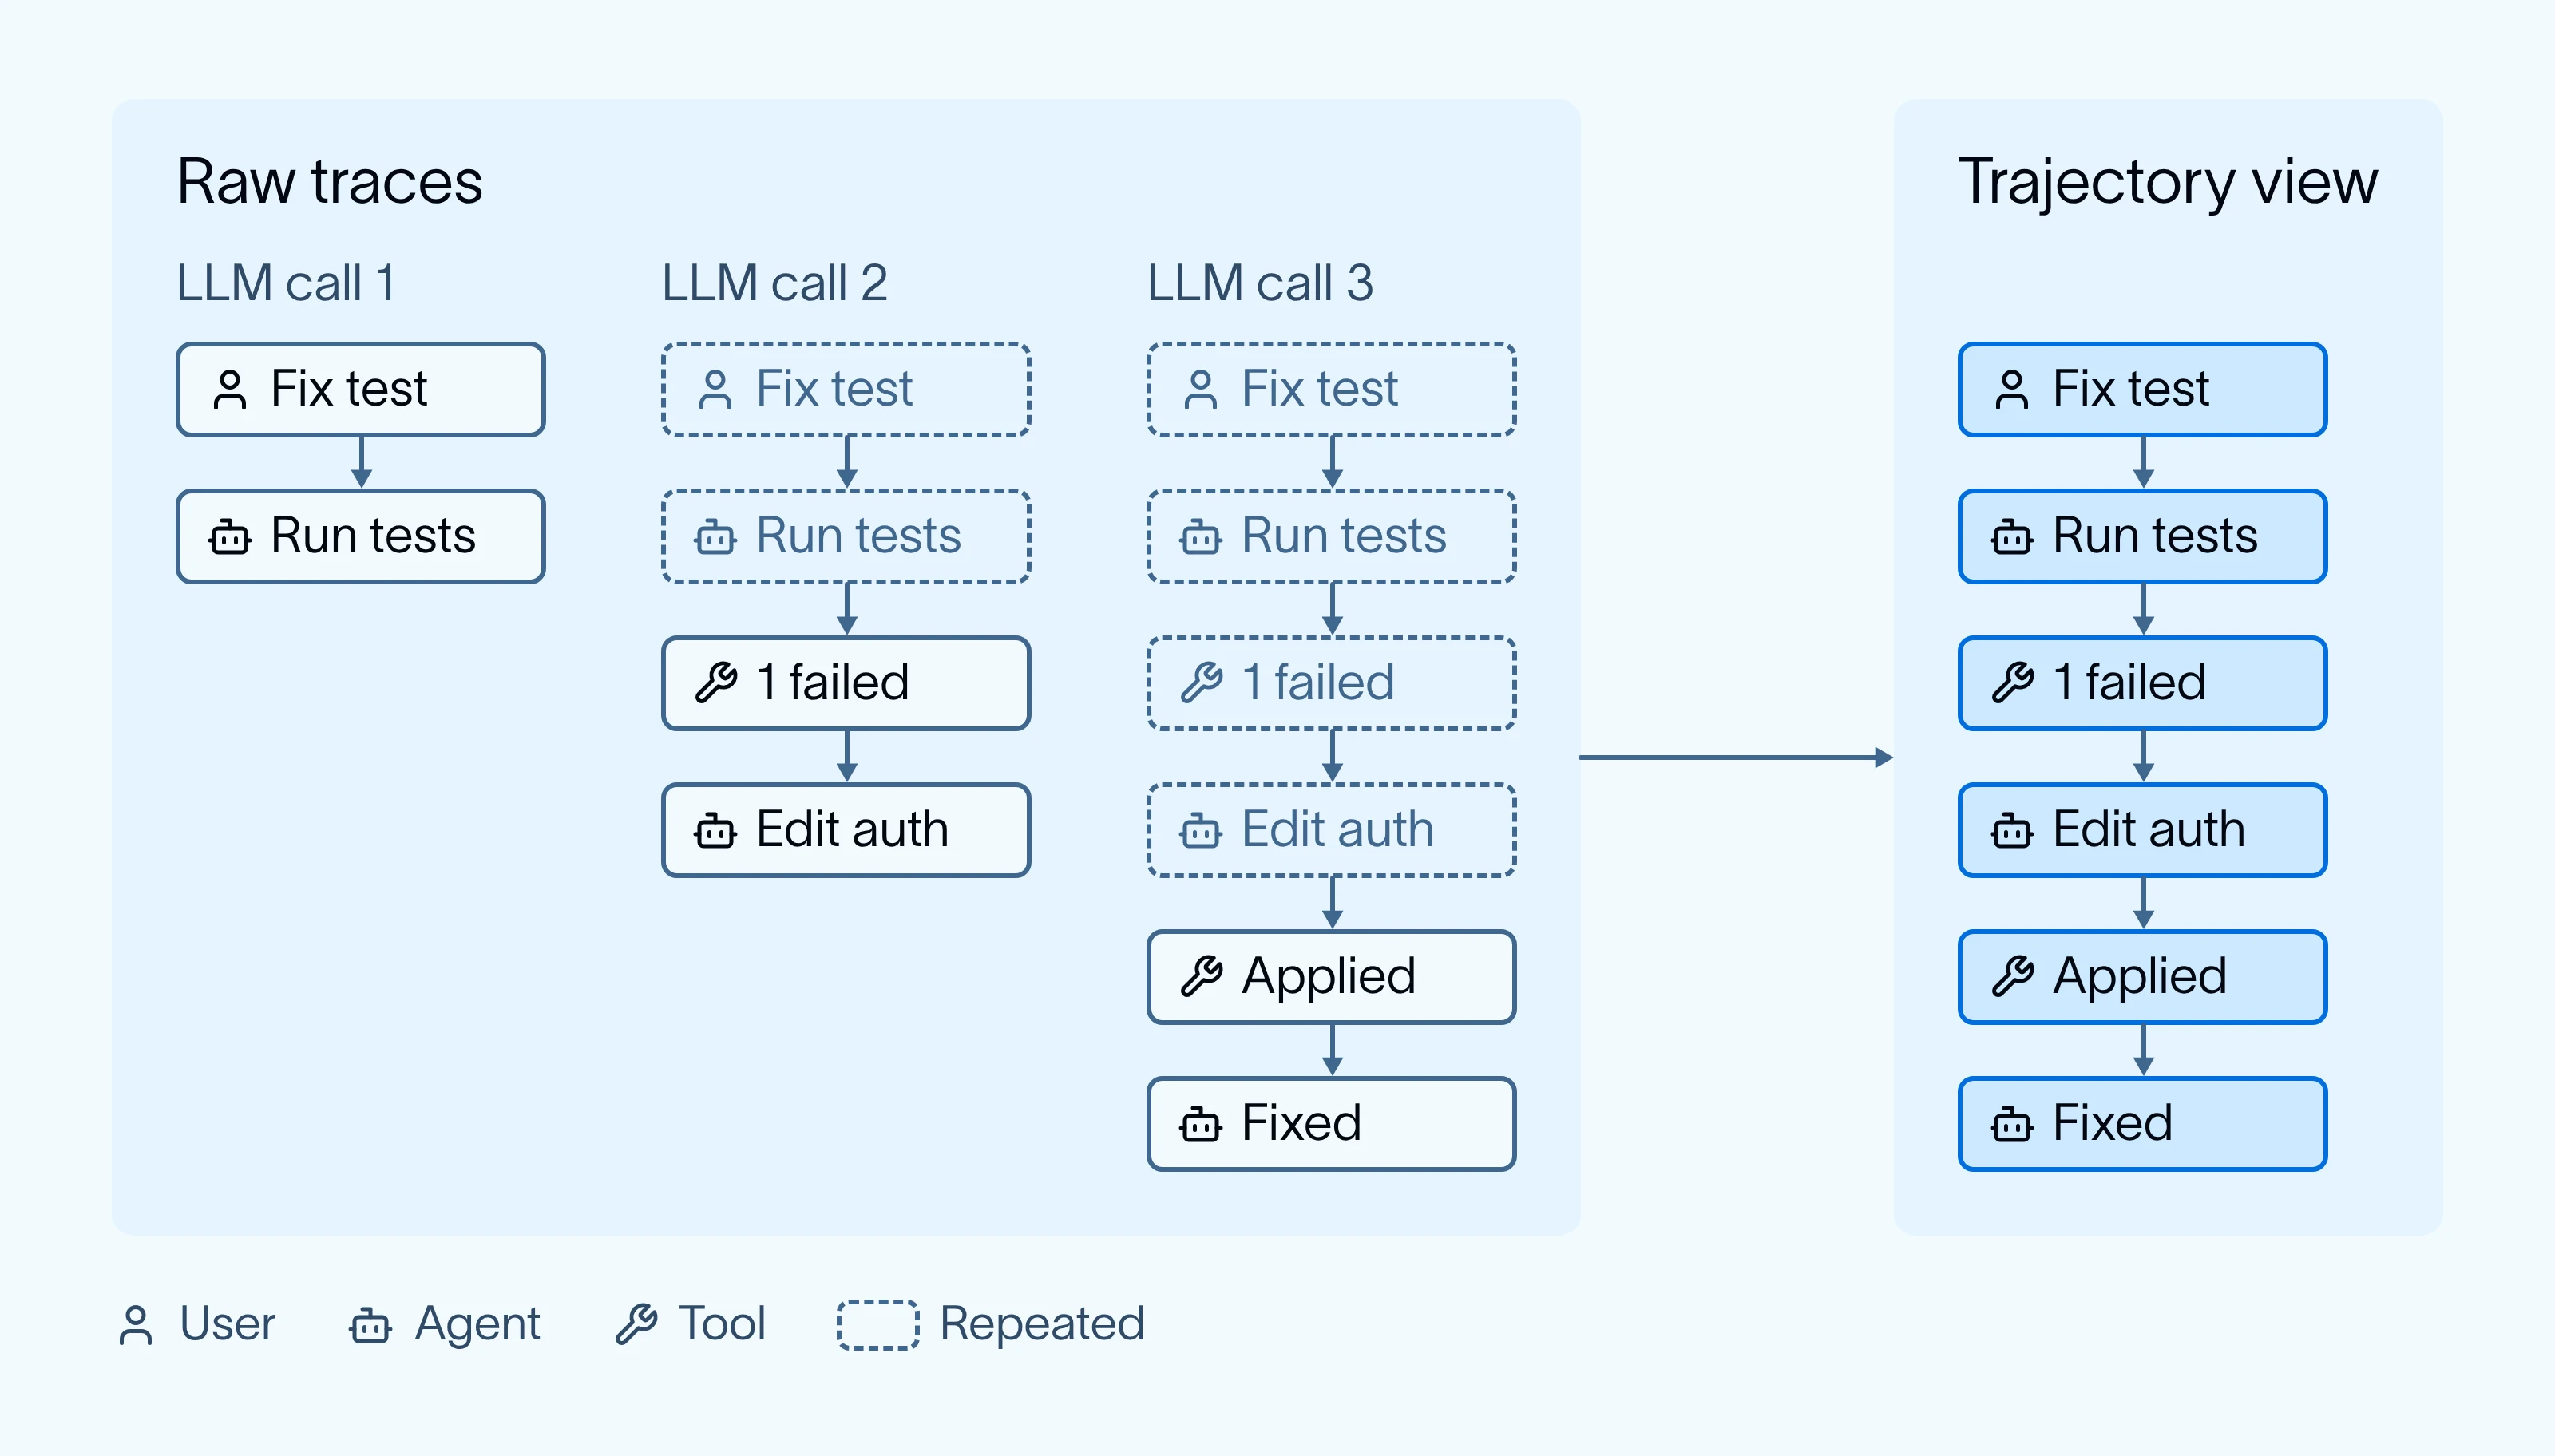
トレースはさまざまなソースから届きます:OpenAI SDKやAnthropic SDK、LangChain、LangGraph、Vercel AI SDK、OpenTelemetryなど。それぞれがメッセージを少しずつ異なる形で記録します。トレースには繰り返しも含まれます。エージェントはLLM呼び出しのたびに会話履歴を再送信することが多く、最初のメッセージがその後のすべての呼び出しに再び現れます。
SmithDBはこれらのトレースを、各セッションごとの 軌跡(トラジェクトリ) に変換します。軌跡とは、エージェントの作業を蒸留して示したもので、各メッセージ、ツール呼び出し、ツールの結果が1回ずつ列挙されます。SmithDBはトレースの到着に合わせてこれを構築し、サポート対象のすべての形式を同じ形状に整えます。
AI Searchは生のトレースではなく、軌跡(トラジェクトリー)を分析します。すべてのフォーマットが同じ軌跡の形状を持つため、1つの検索が異なるSDK上に構築されたエージェント全体で機能します。繰り返しのメッセージを除去することでコンテキストの肥大化が減り、検索が高速に実行されます。また、軌跡はセッション全体をカバーするため、「ユーザーがキャンセルしようとした」を検索すると、モデルはユーザーが何を求めたか、エージェントが何をしたか、会話がどのように終わったかを確認できます。
軌跡は依然として長い
重複の除去は役立ちますが、エージェントの軌跡は依然として長いものです。どのくらい長いのかを把握するために、私たちは次から150件のランダムな会話をサンプリングしました Open SWE(LangChainチームが毎日使用しているオープンソースのコーディングエージェント)から150件のランダムな会話をサンプリングしました。各タスクはシェルアクセス可能な独自のサンドボックスで実行され、作業をサブエージェントに引き継ぐことができるため、会話は大きくなります。
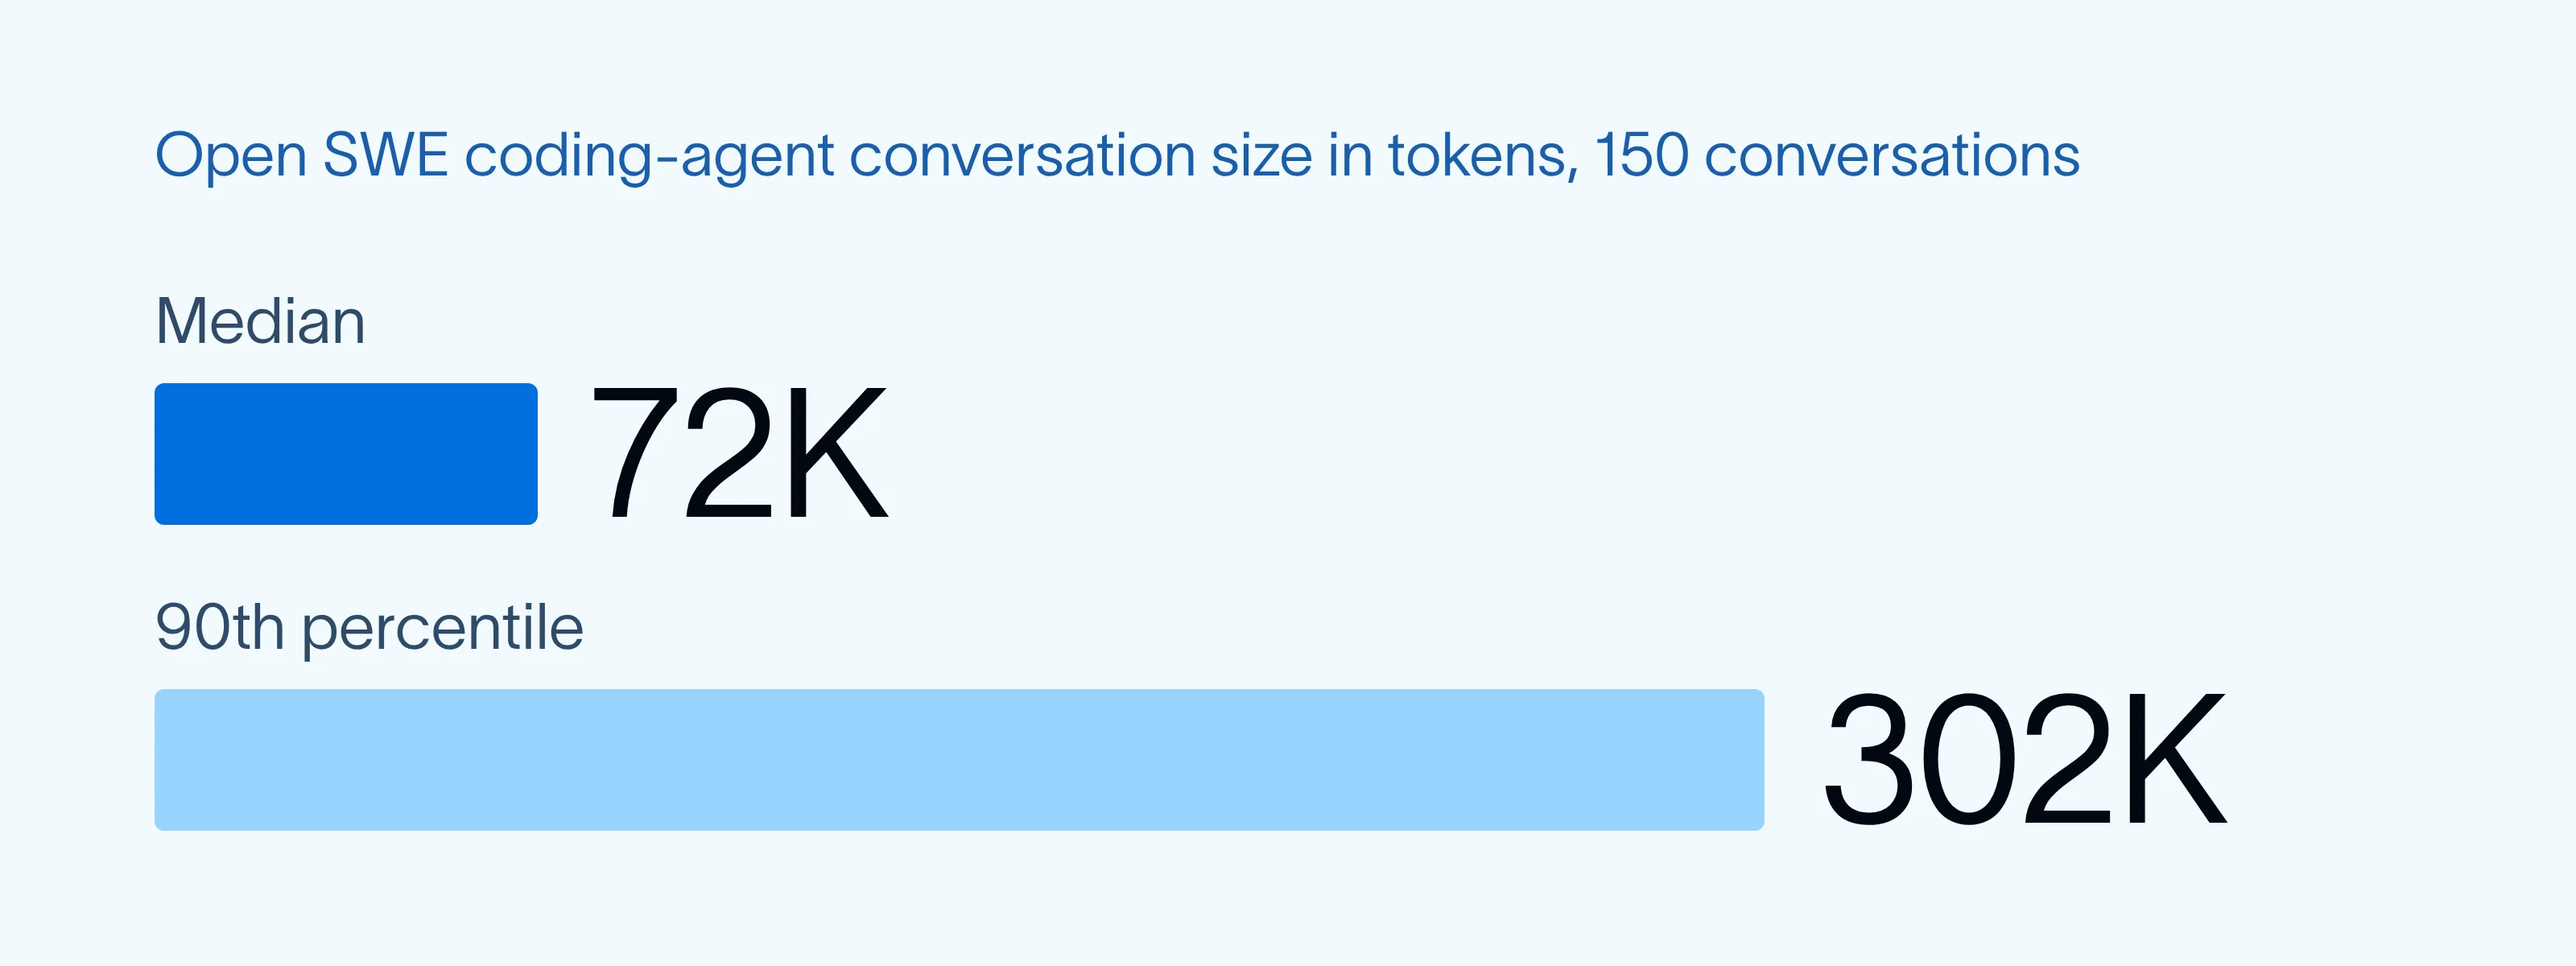
そのうちのいくつかは、これほど小さなサンプルでも1,000,000トークンを超えていました。まれな挙動を探すということは、大量の会話を読み通すことを意味するため、AI Searchはその規模の会話にしばしば遭遇し、すべてのトークンを読むことができません。
しかし、ほとんどの質問にこれらすべてのトークンは必要ありません。多くの質問は、ユーザーが何を尋ね、エージェントがどう答えたかに関するものです。会話の中央値では、72Kトークンのうち約2Kがユーザーのメッセージとエージェントの返信からのものでした。約85%はツール出力で、その大半はファイル読み取りとシェルコマンドでした。
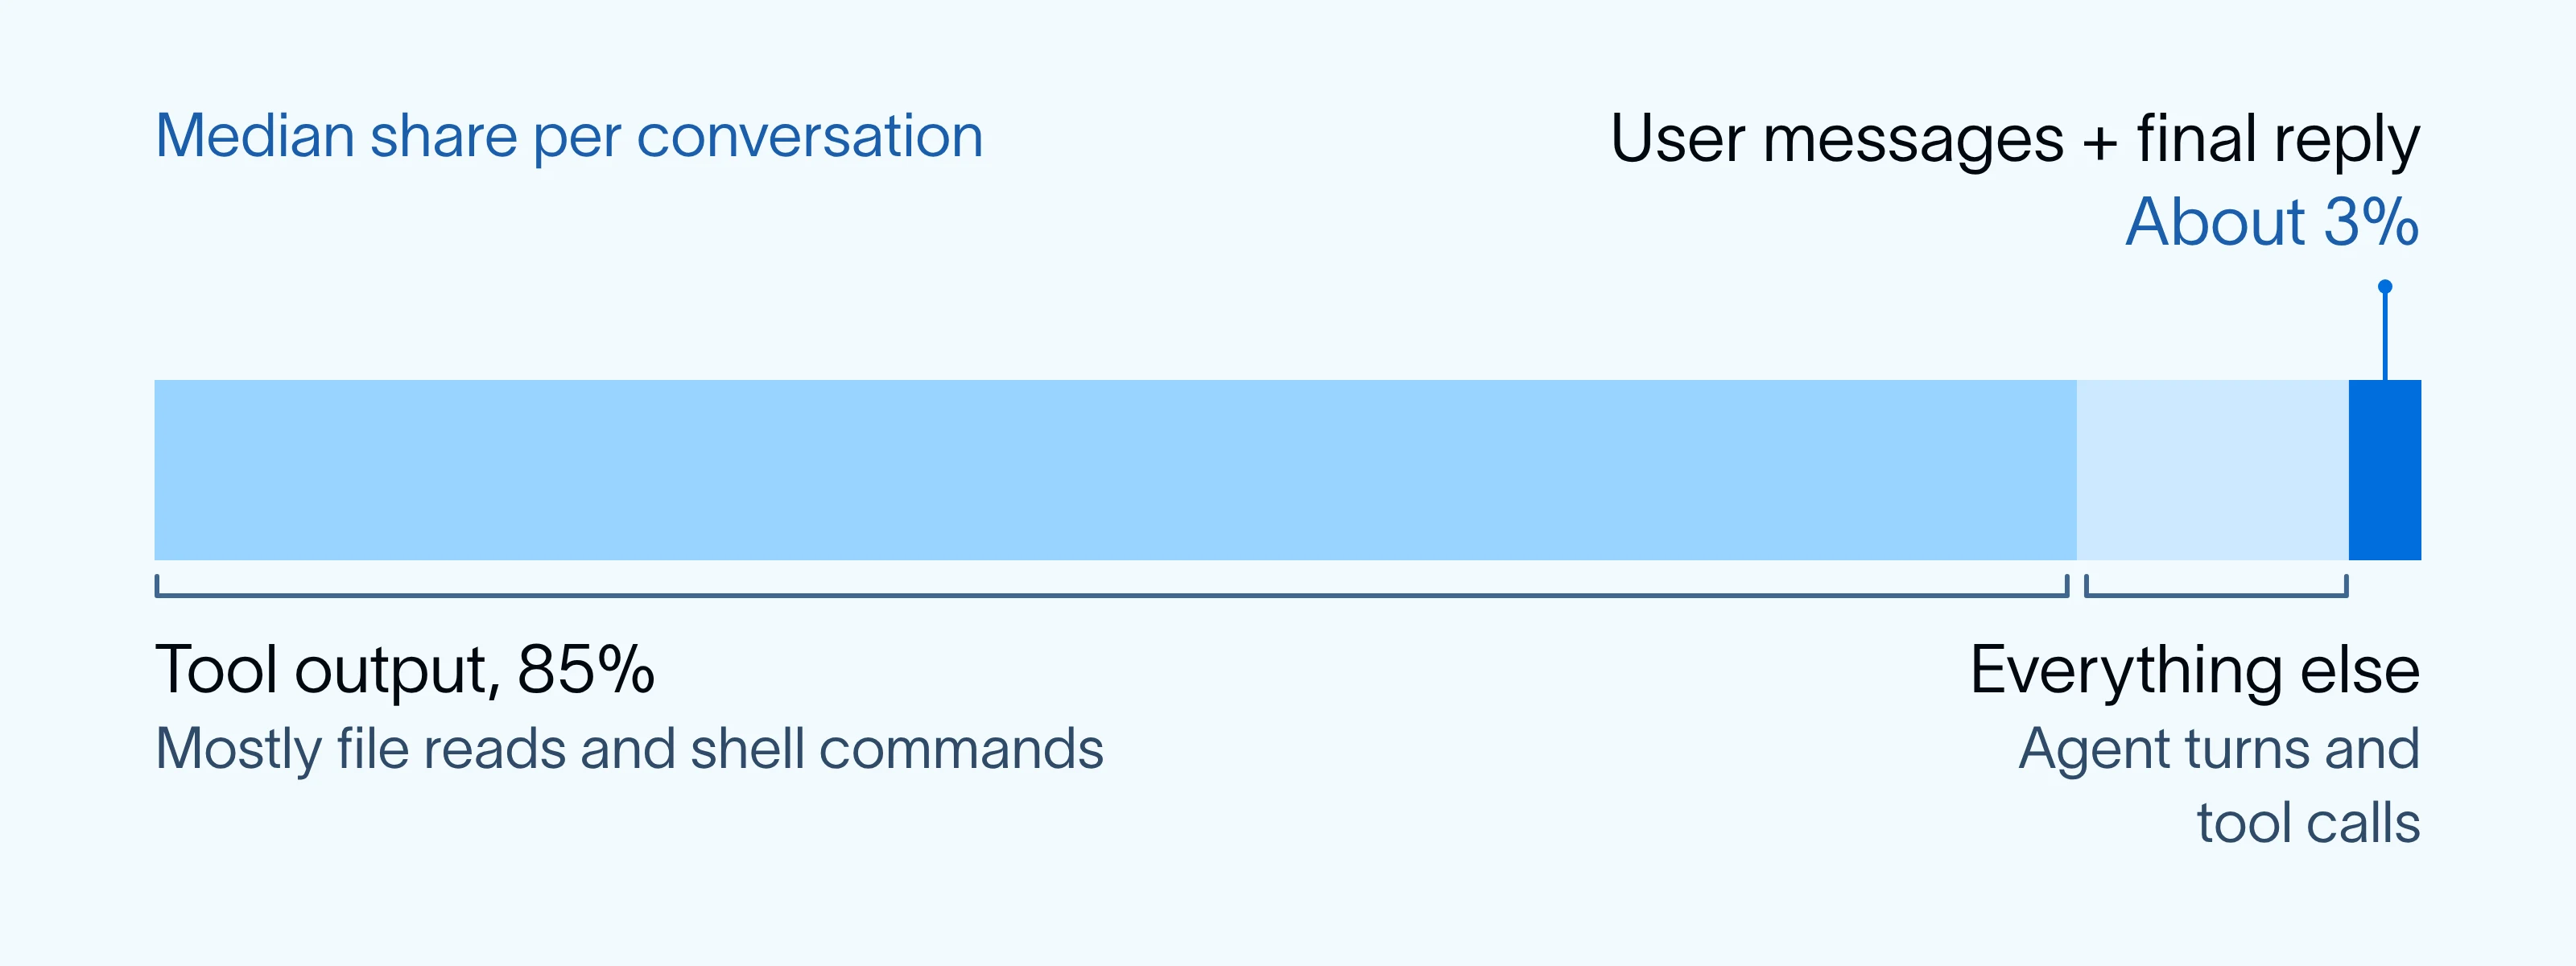
各軌跡には固定のトークン予算が割り当てられ、優先順位に従って埋められます。ユーザーメッセージとエージェントのユーザーへの返信が最初に入ります。残りの予算はその他すべて、つまり中間のAIメッセージ(エージェントの推論とツール呼び出し)、ツール結果、システムメッセージに割り当てられます。次のメッセージが部分的にしか収まらない場合は予算を満たすように切り詰められ、それ以降は破棄されます。
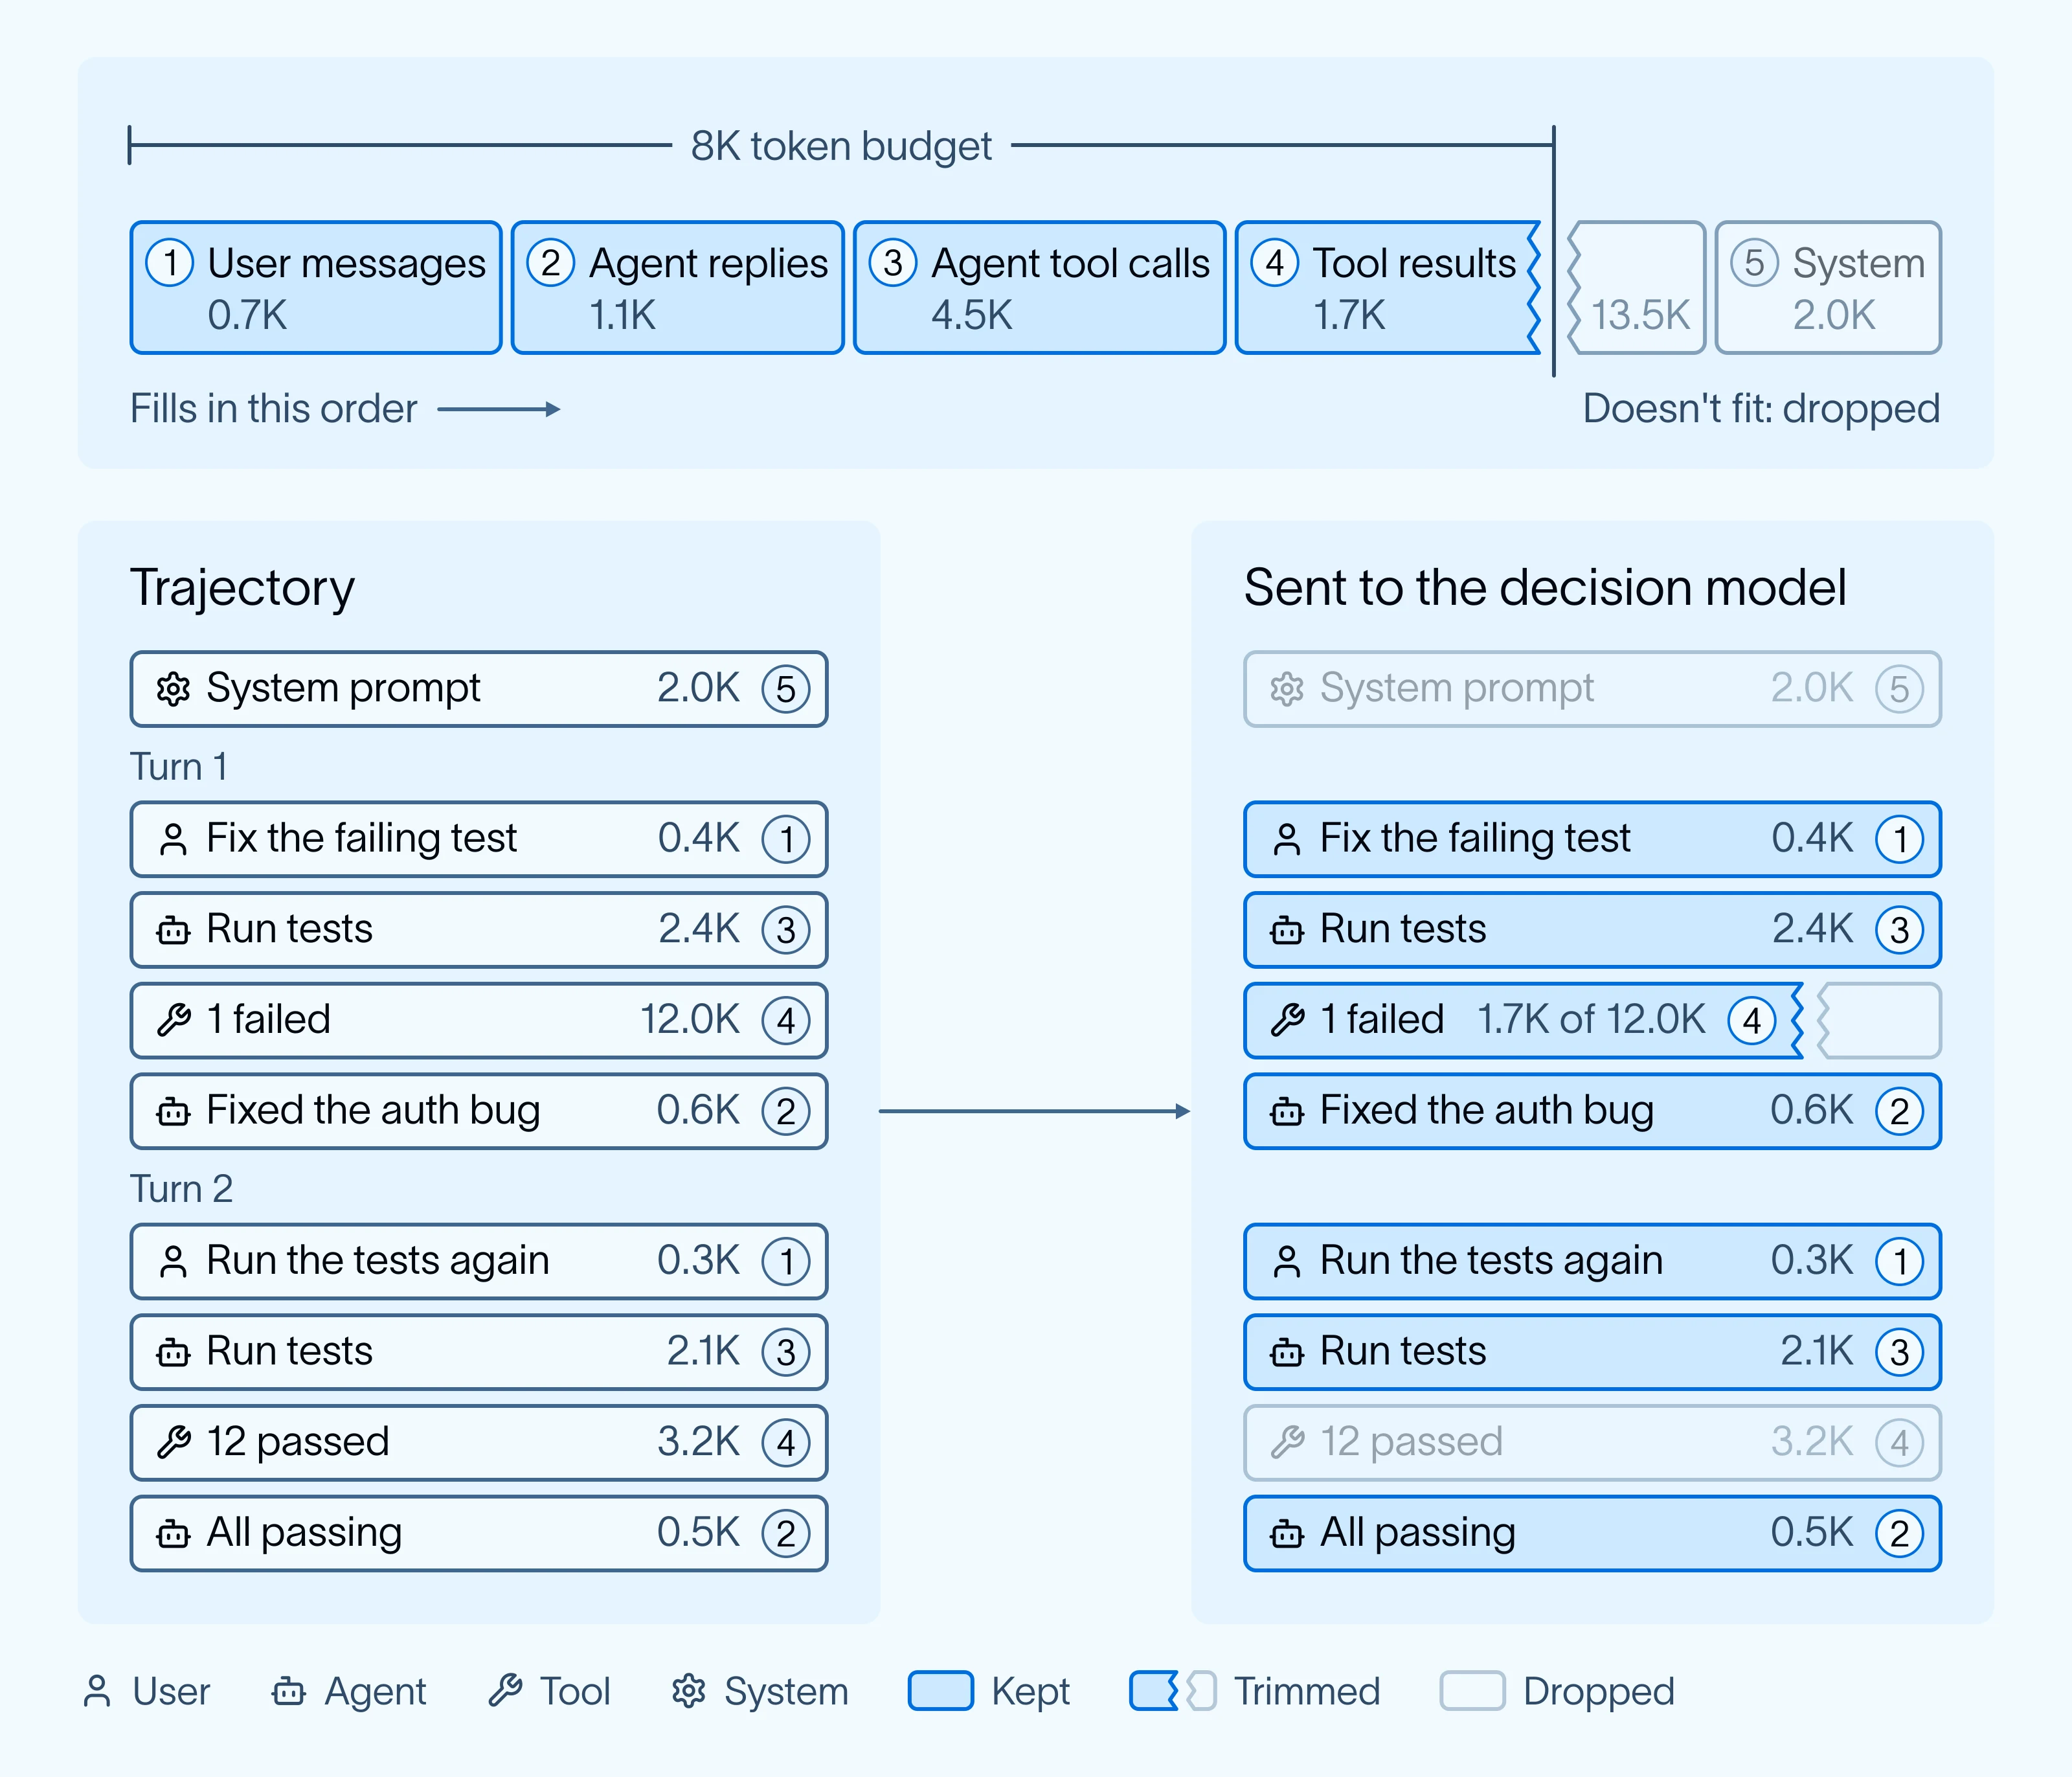
検索はスケールしても高速を保つ必要がある
SmithDBは大量のエージェントトレースデータを取り込み、スキャンできるように構築されています。検索を実行すると、構造化フィルタがまず候補を絞り込みます。その後、決定モデルが残りの各軌跡を説明内容と照合します。多くは並行して処理されます。モデルがあるバッチの軌跡をチェックしている間に、SmithDBはすでに次のバッチの取得と準備を行っています。一致は見つかり次第ストリーミングで返されるため、スキャン全体の完了を待つ必要はありません。
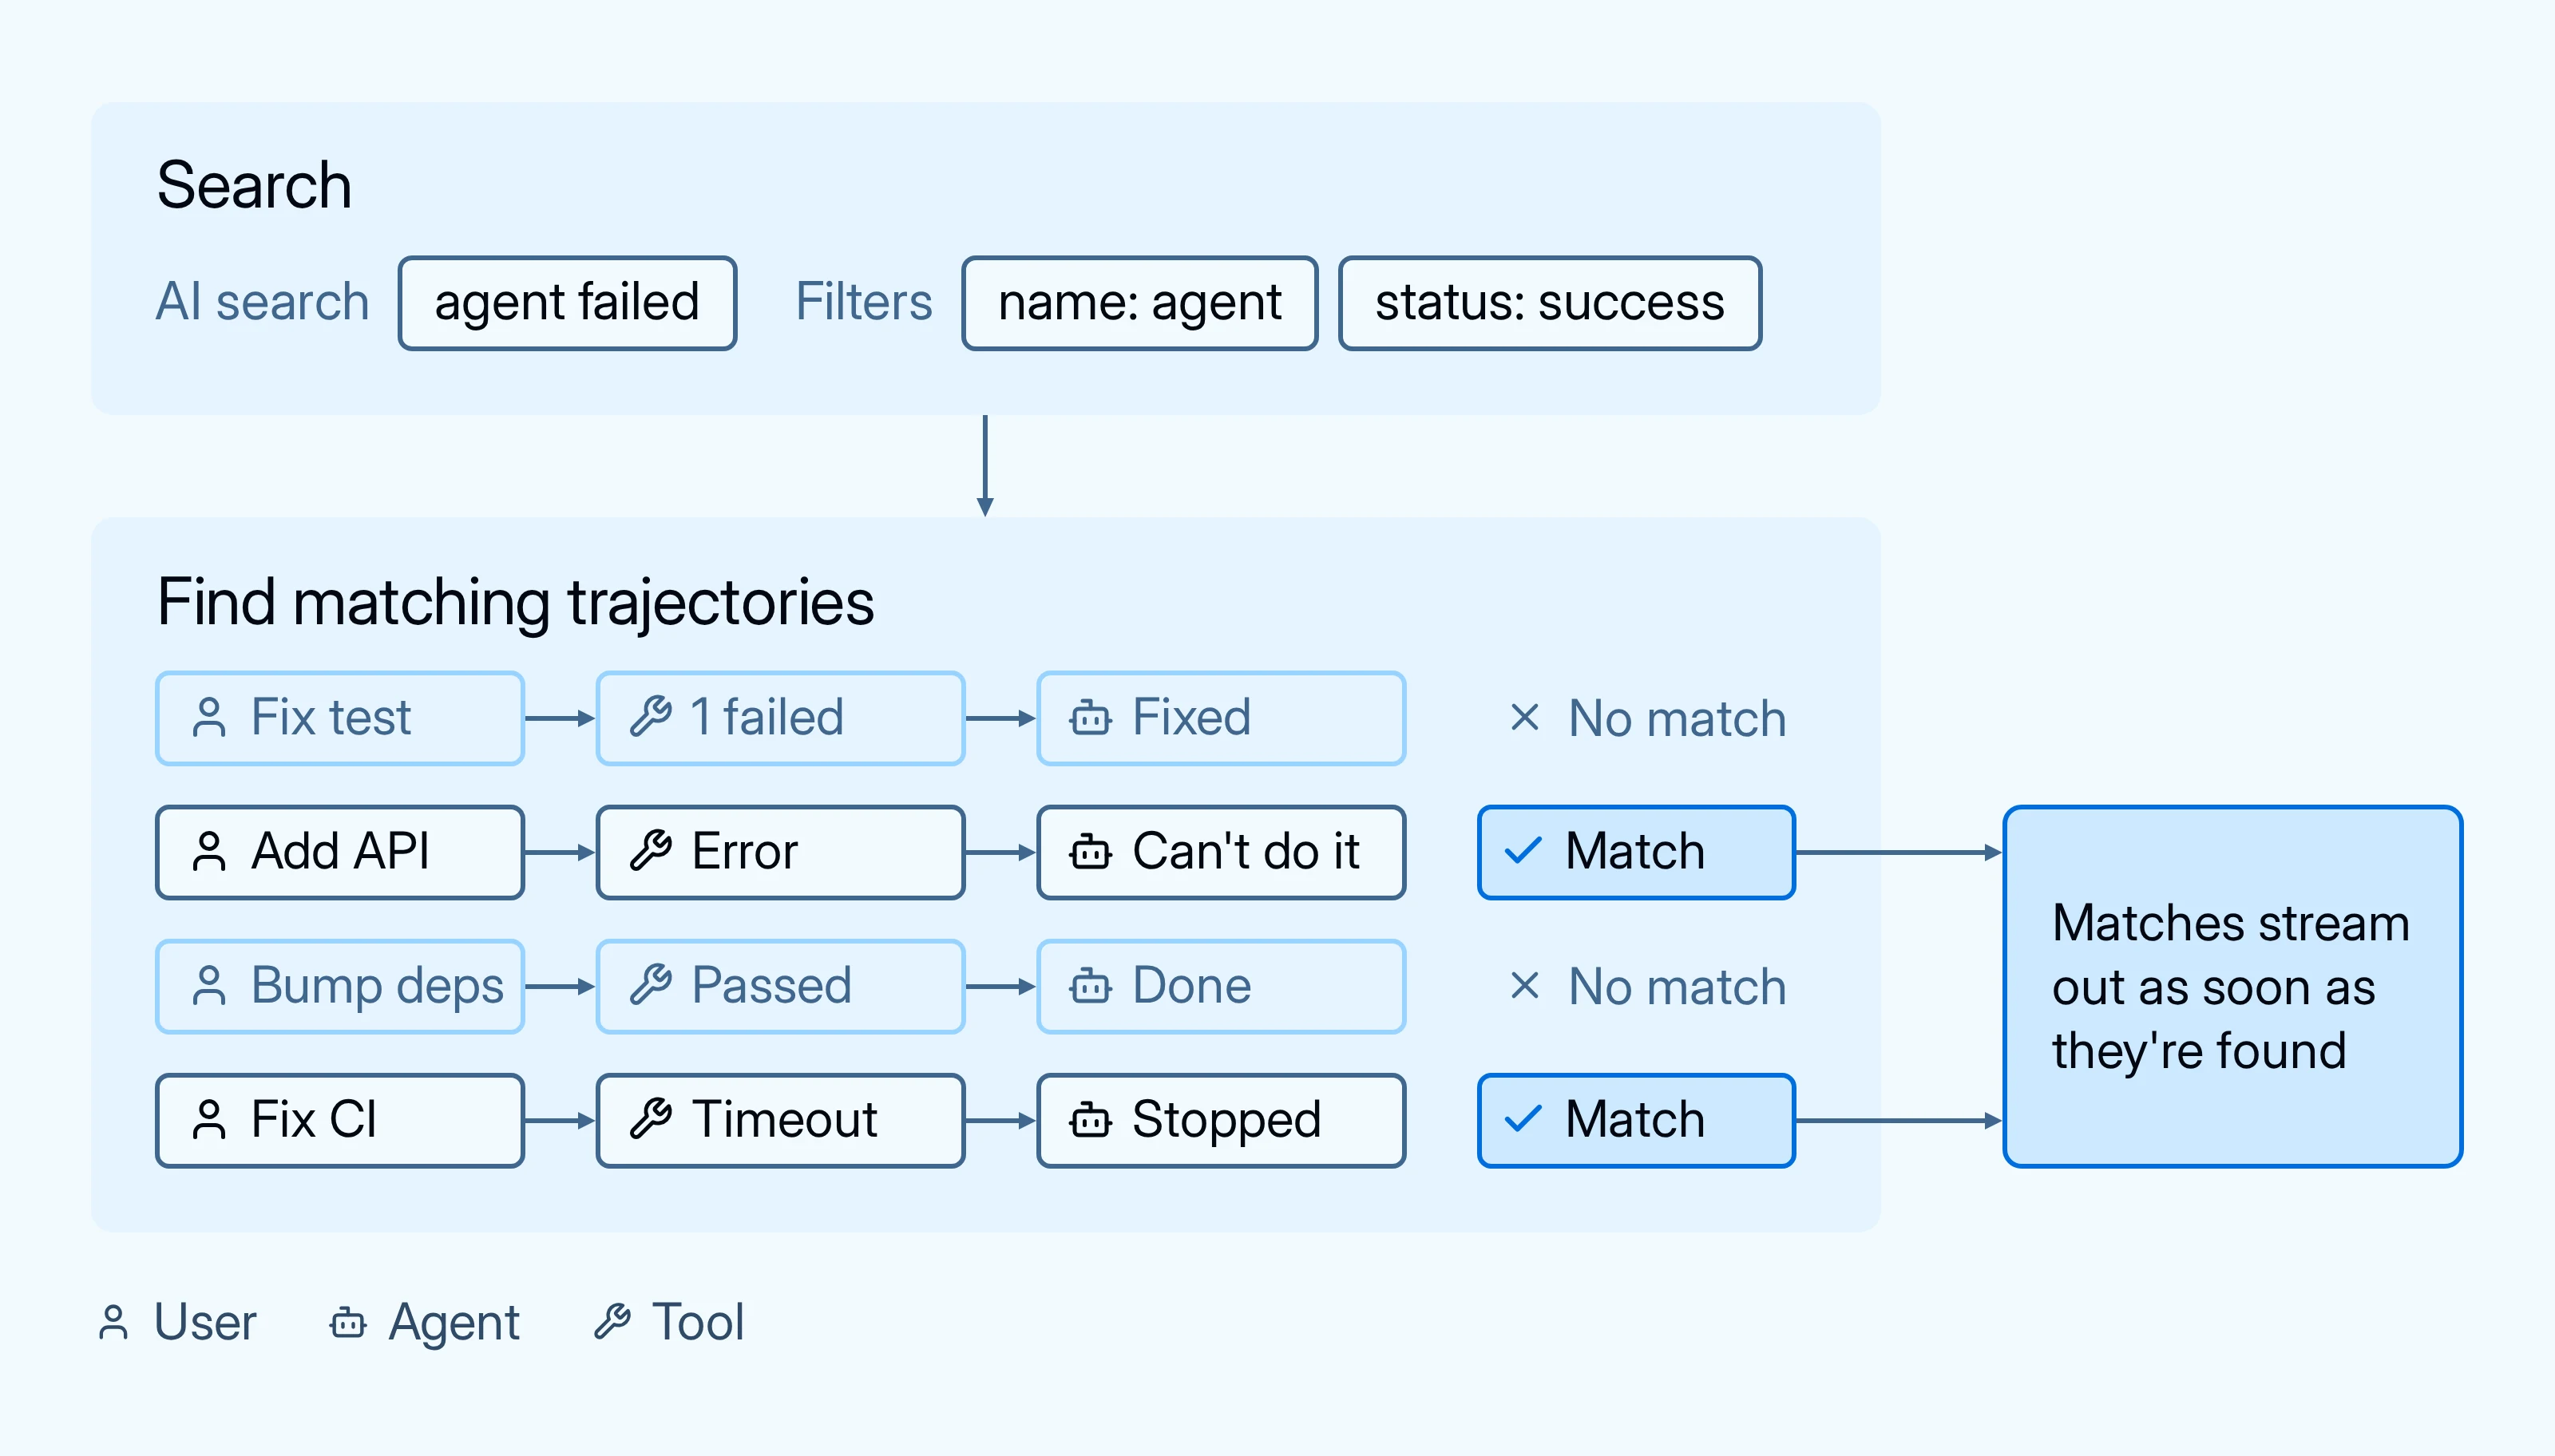
次のステップ
人々が最もよく尋ねる質問が何かを、私たちはまだ学習中です。分類が最も難しいのは、微妙な違いがある会話です。「ユーザーが諦めた」と「ユーザーは必要なものを得て離脱した」を区別することは、長い軌跡の中のわずか数ターンの違いに左右されることがあります。トレース上でチューニングされたモデルがより確実に区別できるかどうかを確認したいと考えています。
トークン予算は、答えがユーザーとエージェントの発言の中に見つかる場合にはうまく機能します。しかし、他の質問には別の証拠が必要です。エージェントがツールエラーを無視したことは、ツール結果にしか現れません。私たちは質問に基づいてコンテキストを選択する方法や、モデルが不確かな場合を示すシグナルを探索しており、それによってモデルがより多くのコンテキストで2回目のパスを実行できるようにすることを検討しています。
また、類似の結果をグループ化したり、共通点を要約したりすることで、単なる一致のリストを超えた体験を提供したいとも考えています。
はじめに
AI Searchは LangSmith Cloud のGCP米国、EU、APACリージョンでパブリックベータとして追加料金なしで利用可能です。組織管理者が設定で有効にすると、トレーシングページに表示されます。詳細は AI Searchドキュメント をご覧ください。どのような検索をしているかぜひお知らせください。