
Mixture-of-Experts(MoE)は、トークンあたりの計算量を低く抑えながら大規模言語モデル(LLM)の容量を拡張する、疎活性化アーキテクチャです。MoE の操作は総計算時間の大きな割合を占めるため、ここでの非効率はリクエストのレイテンシーとコストを直接的に押し上げます。したがって、カーネルエンジニアリングによる MoE 操作の最適化は、パフォーマンス向上の最大の機会をもたらします。
Fused MoE は MoE アーキテクチャにおける重要な最適化手法です。Fused MoE システムは、トークンルーティング、データシャッフル、専門のネットワーク計算を、GPU 上の単一のバッチ処理に統合します。これにより、ルーティングとエキスパート計算を別々の逐次ループ操作として実行することが置き換えられます。これにはレイテンシーの利点がある一方で、カーネル実装とデバッグ能力の面で複雑さももたらします。このアーキテクチャで高い GPU 利用率を達成するには、ハードウェア固有の最適化が必要です。
この記事では、Fused MoE モデル向けに実装したさまざまなカーネル最適化について説明し、この成果から皆様がどのように恩恵を受けられるかを示します。代表的な MoE モデルを主要な例として使用しました。
WGMMA 利用率向上のための Swap-AB
テンソル処理のスループットを最大化するために、NVIDIA Hopper アーキテクチャは、128 スレッドの協調ワープグループ全体で集合的に実行される Warp Group Matrix Multiply Accumulate(WGMMA)命令プロトコルに依存しています。このオペランドの非対称性は、本質的に命令セットアーキテクチャ(ISA)レベルの特性です。基盤となる wgmma.mma_async アセンブリ定義では、ハードウェアは並列スレッドマッピングトポロジを定義するために、行列の行次元(M)を一定のスケール 64 に固定しています。列次元(N)は高度に可変です。オペランド A はこの固定された M 次元に厳密にマッピングされ(レジスタまたは共有メモリを使用)、オペランド B は可変の N 次元にマッピングされます(共有メモリディスクリプタを通じて)。したがって、これらのオペランドスロットは構造的に交換不可能です。その結果、ピーク時のハードウェアタイル利用率はこれらの厳格な形状エンコーディングに支配され、計算実行レーンを遊ばせないようにするためには M 次元が 64 以上であることが求められます。
この構造的選好は、Hopper テンソルコアがメモリブロックを分割する方法に由来します。ハードウェアは、最初のオペランドのリーディングディメンションに対して固定された最小レイアウト形状を強制し、ブロックの高さを正確に 64 にロックします(M=64)。数学的な行列がこの主要スロットにおいて大きく連続したリーディングディメンションを持つ場合、Hopper の内部ハードウェアスケジューラは、物理的な計算グリッド全体にデータをきれいにマッピングし分散できます。
この構造的非対称性は、MoE ネットワークのデコードフェーズにおいて深刻なパフォーマンスボトルネックになります。標準的な MoE レイヤーでは、エキスパート計算を司る線形代数は、従来の行列記法を用いて次のように定式化されます:
A[M,K] x B[K,N] —> C[M,N]
ここで(M)はトークン行数(またはバッチサイズ)、(K)は隠れ特徴次元、(N)は広大なエキスパート出力次元を表します。
デコードフェーズでは、システムはユーザーシーケンスごとに一度に 1 トークンのみを処理します。その結果、バッチ空間またはトークン行サイズは極端に薄くなり、(M < 64)のプロファイルに落ちることが頻繁にあり、しばしば単一行(M = 1)まで低下します。この標準的な構造レイアウトでは:
行列(A)は細く断片化された水平ベクトルに変化します(例:1 x 4096)。
行列(B)(中核となるエキスパートの重み)は、大きく密な垂直ブロックのままです(例:4096 x 8192)。
行数(M)が非常に小さいため、行列(A)はオペランド A 用のハードウェアの固定された(64)行レイアウトバケットを物理的に満たすことができません。WGMMA 命令がこのレイアウト上で実行されると、物理的なテンソルコア容量の大部分が完全に飢えた状態になります。シリコンは空の空間スロットを処理するクロックサイクルを費やし、ハードウェア利用率の低下につながります。
標準的な密 LLM レイヤーでは、重み行列は静的で統一され、完全に連続しています。しかし MoE レイヤーでは、ワークロードは独立したサブネットワーク(エキスパート)の集団に分割されています。これにより、Hopper GPU の WGMMA 制約に極めて敏感になる、固有のメモリおよびレイアウトのボトルネックが生じます。標準的な密レイヤーでは、行列乗算はトークンベクトルと単一のレイヤー重み行列を乗算します。出力次元(N)はモデルの隠れサイズです(例:4096)。
Fused MoE カーネルでは、GPU は 1 つのエキスパートに対して乗算を行うだけではありません。各エキスパートに対して個別のカーネルを起動することを避けるため、アクティブなすべてのエキスパートに対して計算をグループ化し同時に実行します。標準的な密レイヤーでは、N は隠れサイズ(4,096)です。Fused MoE レイヤーでは、N は選択されたエキスパート数にエキスパートの中間サイズを掛けたものになります。 topk=8 ルーチンを実行するモデルでは、融合カーネル内の実効 N 次元は数万から数十万のパラメータに膨れ上がります。N 次元が小さなデコードトークンサイズ(M=1)と比べて極端に大きいため、レイアウトの非対称性は極限に達します。行列を転置することで、この大きな結合 MoE 次元を主要スロットに移動させ、標準的な密レイヤーでは達成できない規模のハードウェアプリフェッチを解放します。
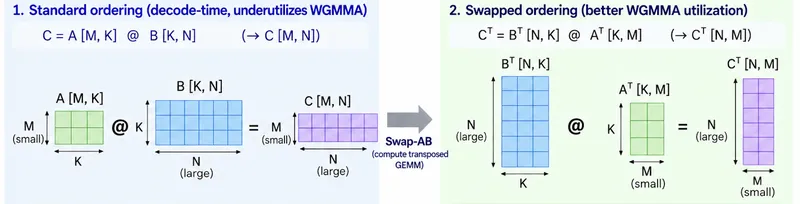
モデルの根底にある数学的整合性を変えることなくこのハードウェアのミスマッチを解消するため、我々は行列転置の代数的性質を利用しました:
BT[N,K] x AT[K,M] —> CT[N,M]
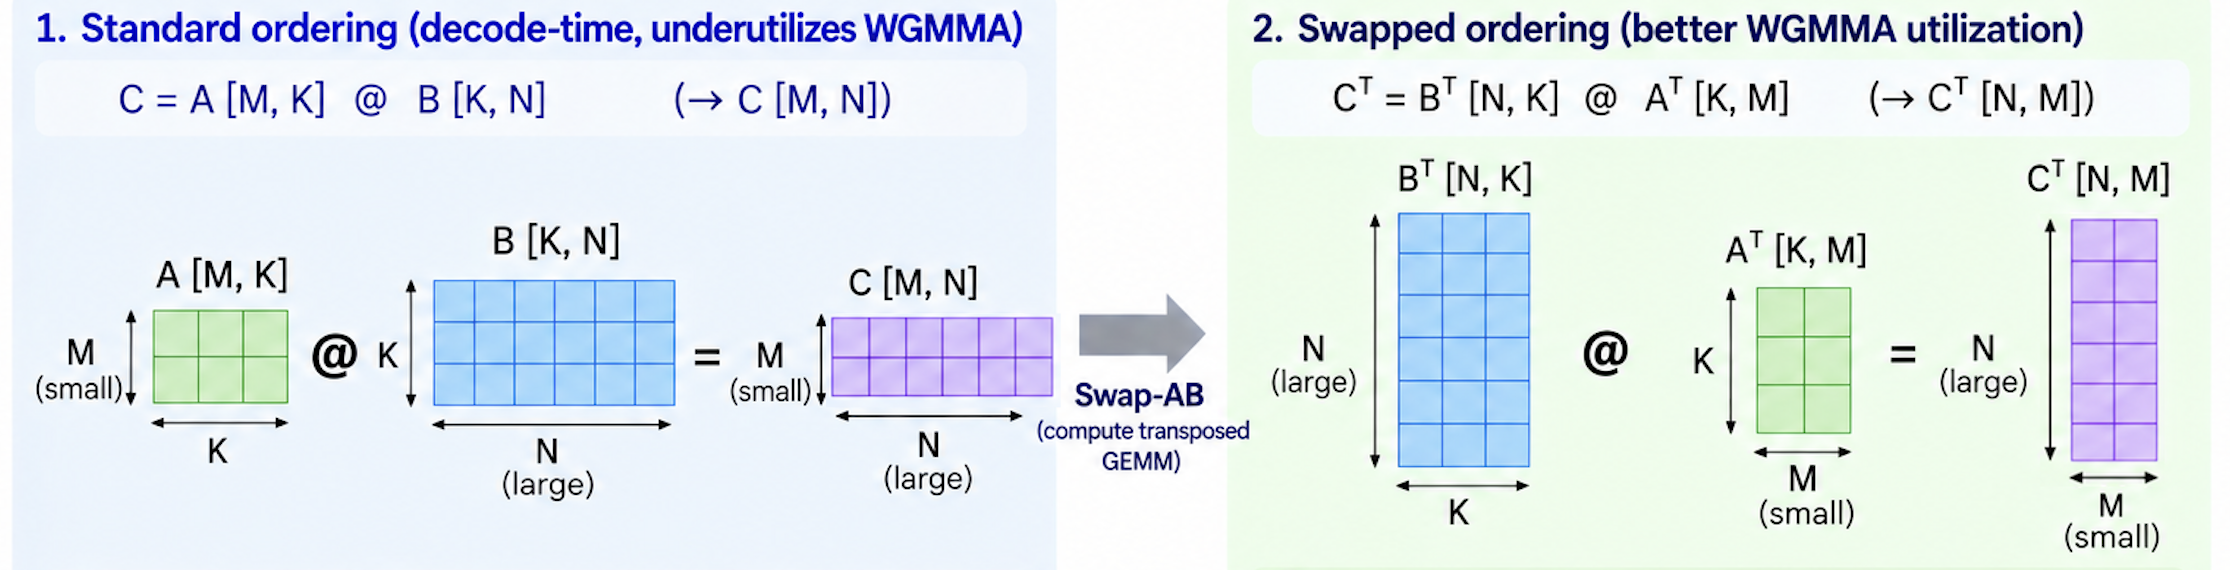
図 1: WGMMA 利用率向上のための Swap-AB
PTXアセンブリ層に到達する前に行列乗算をプログラム的に入れ替えることで、ソフトウェアをHopperシリコンの正確なトポロジに一致するよう再配置しました。この転置により、GPU上で2つの即時的なアーキテクチャ上の利点が生まれます。第一に、物理レイアウトを飽和させます。広大なエキスパート次元(N = 8192)が第1オペランドの位置(Bに昇格されます。T「)、(N)が大きいため、ハードウェアの必須の(64)行しきい値を容易に満たします。これによりTensor Coresは無駄な実行サイクルなしで最大の局所密度で動作します。第二に、非同期プリフェッチを有効化します。Hopperの専用ハードウェアコピーエンジンは、演算実行ブロックが起動する前に、共有メモリからレジスタへメモリアドレスを非同期的にプリフェッチできます。連続的で大きな重みブロック(Bを配置することでT) を先頭スロットに置くことで、これらのエンジンはデータレイアウトをスムーズに追跡でき、CPU の介入なしにコンピュートパイプラインを飽和状態に保てます。これにより、H200 上の大規模 MoE モデルでエンドツーエンドの出力スループットが 2〜4 パーセント向上しました。この最適化は vLLM にアップストリーム済みで、バージョン 0.24.0 以降で利用可能です。
FP8テンソル量子化のためのバックエンドルーティング
カーネルの内部構造を超えたところで、MoE計算をどのバックエンドが実行するかという選択は、パフォーマンスに大きな影響を与えます。vLLM MoEオラクルは、異なる量子化方式をTriton、FlashInfer+CUTLASS、またはその他のバックエンドにルーティングします。プロファイリングの結果、Hopper上のFP8テンソル量子化モデルでは、Tritonバックエンドがデフォルトよりも一貫して優れた性能を示すことが明らかになりました。 FLASHINFER_CUTLASS path.
Triton バックエンドが低並行性の MoE ワークロードにおいて CUTLASS を上回るのは、主に、硬直したフレームワークレベルの行列演算設定を、カスタムのオペレータレベルのレジスタ融合に置き換えているためです。CUTLASS は標準的な C++ テンプレート構造に依存しており、FP8 テンソルのスケーリング、行列乗算、エキスパートの集約を個別の数学的操作として扱います。一方、Triton バックエンドはこのパイプライン全体を 1 回のハードウェアパスに統合します。データはグローバルな高帯域幅メモリ(HBM)から正確に 1 回だけ読み出され、GPU の超高速なローカル SRAM レジスタと計算実行ファイル内で完全に処理されます。その後、最終的な行列の宛先へストリームバックされます。これにより、中間テンソルのスケーリング処理を何度も経由せざるを得ない場合に CUTLASS の性能を損なう、低速なグローバル VRAM の読み書きラウンドトリップが排除されます。
さらに、このレジスタレベルの融合は、可変トークンバケット化を中心に設計された動的スケジューリングレイアウトと具体的に組み合わされており、従来のコンパイルテンプレートにおける深刻な構造的欠陥を解決しています。CUTLASSは、密度が高く、大きく、予測可能な行列次元に対してネイティブに最適化されています。推論デコード生成フェーズ特有の流動的で極端に薄いバッチプロファイル(M < 64 または M = 1)に遭遇すると、デフォルトのブロックタイリングおよびスレッドマッピング構造は著しく非効率になります。その結果、深刻なワープの未活用や高コストなメモリパディングのオーバーヘッドが発生します。一方、Triton MoEバックエンドは、こうした小規模で断片化されたトークン配列を、アクティブなエキスパート重みの物理的境界にわたって動的にマッピングすることに優れています。これにより、非常に不安定なワークロードを極めて低いバッチサイズで処理する場合でも、ハードウェア内部のプリフェッチストリームとTensor Coreパイプラインを完全に飽和状態に保つことができます。
ルーティングポリシーの更新は、カーネルコードを一切変更しない純粋な設定変更です。それでも、次の結果が得られました。 エンドツーエンドのスループット10%の向上 H200上のFP8量子化fused MoEモデル向けの改善です。この改善はAWS Large Model Inference(LMI)v28コンテナで利用可能です。
Triton JIT再コンパイル除去
GPU推論における最も影響の大きいパフォーマンス障害の一つは、同時に最も気づきにくいものでもあります。それは、不要なカーネルの再コンパイルです。vLLMの多くのカスタムカーネルの基盤となるコンパイラフレームワークであるTritonは、デフォルトで整数引数を特殊化します。特殊化されたパラメータに対して未経験の値でカーネルが呼び出されるたびに、Tritonは新たなジャストインタイム(JIT)コンパイルを発生させます。シーケンス長やバッチサイズが絶えず変動するサービングワークロードでは、これが継続的なコンパイルオーバーヘッドの流れを生み、レイテンシ、特にTime to First Token(TTFT)を増大させます。
MoEモデルのサービングにおいて、 _fused_inv_rope_fp8_quant_per_head カーネル(fused rotary position embedding および FP8 量子化を担当)は、新しいごとに再コンパイルされていました num_tokens 値。追加 do_not_specialize 可変長パラメータへのアノテーションを削除することで、これらの再コンパイルを完全に排除し、TTFTを改善しました。 9パーセント H200 での8-way テンソル並列 (PR #42849)。
マルチGPUクラスタでは、すべての8基のGPUが完璧なマイクロ秒レベルの同期を保ちながらカーネルを実行しなければなりません。たった1基のGPUでもローカルの再コンパイルのために停止すると _fused_inv_rope_fp8_quant_per_head カーネルはローカルのトークンバッチ数が変化したため、残りの7基のGPUはアイドル状態で待機することになります。クラスタ全体での再コンパイルを排除することで、マルチGPU間の調整オーバーヘッドを平滑化し、ユーザーの最初の応答レイテンシを9パーセント高速化しました。ここでの原則は、コンパイラをファーストクラスの最適化対象として扱うことです。Tritonがどのように特殊化のセマンティクスを行うかを理解し、パラメータがデッドか可変かを認識することで、最小限のコード変更でレイテンシの改善を実現できます。
この最適化はvLLM本体にアップストリームしており、バージョン0.22.0以降で利用可能です。
結論
vLLMコミュニティとの協力を通じて、fused MoEモデル向けの複数のカーネル最適化を実装し、オープンソース化しました。これらの最適化は、Amazon SageMaker AIのLMI Deep Learning Containerに適用しています。これらの最適化を合わせることで、最大10パーセントのスループット向上と、最大9パーセントのTTFT短縮を実現しました。カスタムモデルホスティングを始めるには、以下をご覧ください。 Amazon SageMaker AIホスティングドキュメント.