
SpaceXAIのGrok 4.7がAmazon Bedrockで利用可能になりました。Amazon Bedrockは、複数のプロバイダーから基盤モデル(FM)を選択できるサービスです。SpaceXAIによると、Grok 4.7はより困難なタスクにより長く取り組むように訓練されており、自身の作業を検証すべきタイミングを判断できるそうです。これは、多くのステップにわたってタスクを遂行し、途中で得られた情報を検証しなければならないエージェントにとって最も重要な点です。
このように動作するエージェントは、単に情報を検索する以上のことが求められます。候補となる回答を形成し、それを学習した内容と照らし合わせて検証し、整合するまで洗練させる必要があります。Grok 4.7は、各応答の前に行う熟考の量を制御する reasoning effort 設定を公開していますが、エージェントのワークロードにとって実用的な問いは、どのレベルで実行すべきかということです。
この記事では、Grok 4.7上にツール呼び出しエージェントを構築し、単なる検索ではなく探索を必要とする3つのタスクについて評価します。タスクは、アラートから2つのサービスにまたがる障害を診断すること、相互に影響し合う制約の下でメンテナンスをスケジューリングすること、そして予算内で最適なマイグレーションのセットを選択することです。各タスクには、総当たり検証によって確認された、正確に1つの正解があります。すべての reasoning effort レベルで3つのタスクをそれぞれ6回実行し、合計72回のエージェント実行を行いました。
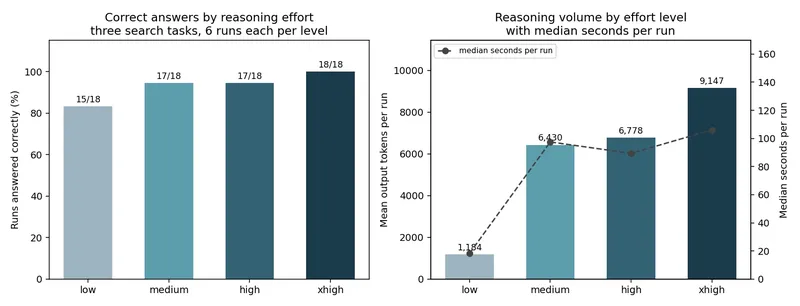
エージェントは72回の実行のうち67回で正解しました。 xhigh では18回すべて正解し、 low では出力トークンを約8分の1に抑えつつ18回中15回正解しました。これにより、リクエストごとに調整できる明確なトレードオフが得られます。この記事では、独自のタスクでそれを測定する方法と、本番環境で監視する方法を示します。
この記事では通貨ではなくトークン数で報告します。トークン価格は変動しますが、コストの算出元はトークン数であるため、トークンで表された測定値は有効性が保たれます。
SpaceXAIがGrok 4.7について報告している内容
SpaceXAIによると、Grok 4.7はGrok 4.6よりも大きなベースモデルを使用し、より難しいタスクの組み合わせを用いたより長期間の強化学習によって訓練されました。このタスクの組み合わせは、完了までに長時間を要する問題に重きが置かれています。SpaceXAIは、このモデルが自身の作業の検証と長いコンテキストの管理において優れていると報告しています。
SpaceXAIが公開しているベンチマーク結果もその方向性に沿っています。Grok 4.6に対する最大の改善は、単一ターンの回答ではなく持続的な作業を測定するカテゴリーに見られます。
| ベンチマーク | カテゴリー | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | 長時間のターミナル作業 | 20.3% | 37.6% |
| EEBench | 電気工学 | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | 法律業務 | 15.8% | 19.6% |
| CursorBench 4.0 | 長時間のコーディング | 40.4% | 46.3% |
| HealthBench Professional | 臨床推論 | 48.5% | 56.7% |
| AA Briefcase v1.1 | 長時間のオフィス業務 | 1,546 | 1,657 |
出典: SpaceXAI、Introducing Grok 4.7 (https://x.ai/news/grok-4-7)。スコアはモデル公開時点でSpaceXAIが公開したものです。
ベンチマークは、標準的なタスク全体でモデルがどのように性能を発揮するかを示します。実際のワークロードにとって有用な次のステップは、自分のタスクに似た形状のタスクで測定することであり、この記事の残りの部分ではその方法を解説します。
SpaceXAIは、Grok 4.7についてテキストおよび画像入力、テキスト出力に対応した500Kトークンのコンテキストウィンドウを公表しています。Amazon Bedrock上では、このモデルは設定可能な推論 effort、ツール呼び出し、構造化出力をサポートしています。
Amazon BedrockでGrok 4.7にアクセスする方法
Grok 4.7は bedrock-runtime エンドポイント上で実行され、 クロスリージョン推論 プロファイルを通じてアクセスされます。利用可能なプロファイルは2つあります:
| 推論プロファイル | ルーティング | 使用する状況 |
| us.xai.grok-4.7 | 米国地域内では | 米国でのデータレジデンシー要件がある場合 |
| global.xai.grok-4.7 | 商用AWSリージョン | 居住地の制約がなく、可能な限り最大の容量を求めている場合 |
クロスリージョン推論は、リクエストを複数のAWSリージョンにまたがってルーティングします。これにより、リージョンごとにキャパシティを管理することなく、より高いスループットを得られます。リクエストでは、モデルIDそのものではなく、いずれかの推論プロファイルを指定します。
このモデルはOpenAI互換のChat CompletionsおよびResponses API、そしてAmazon Bedrock Converse APIに対応しています。Converseでは、推論は次のように返されます。 reasoningContent 〜と並ぶブロック text ブロック。In inferenceConfig、設定 maxTokens 「のみに限定し、推論努力などのモデル固有のパラメータは」 additionalModelRequestFields.
現在サポートされているリージョン、サービスティア、およびトークン価格の最新の一覧については、Amazon Bedrock ユーザーガイドの Grok 4.7 モデルカードおよび Amazon Bedrock の料金ページ(https://aws.amazon.com/bedrock/pricing/).
前提条件
- Amazon Bedrockへのアクセス権を持つAWSアカウント、およびGrok 4.7のモデルアクセスが有効になっていること。
- Python 3.9 以降、および
openai,boto3、またaws-bedrock-token-generatorインストールされました。 - お使いの環境で設定済みのAWS認証情報。
お客様のAWS Identity and Access Management (IAM) アイデンティティには、次のものが必要です bedrock:InvokeModel 推論プロファイルとアカウントのデフォルトプロジェクトの両方で:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7またはglobal.同等のものです。arn:aws:bedrock:{region}:{account-id}:project/default.
両方のリソースをポリシーステートメントに含めてください。推論プロファイルに加えて、デフォルトのプロジェクト権限も必要です。
モデルに接続する
本番環境での利用には、既存のAWS認証情報から短期間のベアラートークンを生成することをお勧めします。そうすることで認証がIAMアイデンティティに紐付き、長期間有効なシークレットが保存されなくなります:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
推論トークンは出力トークンとしてカウントされ、それだけ消費されます。 max_completion_tokens 回答テキストが生成される前に適用されるため、両方のための余裕を持たせて上限を設定してください。推論中に上限に達すると、回答テキストなしでレスポンスが返されるため、エージェントコードで空のコンテンツをチェックし、それが見られた場合は上限を引き上げてください。私たちの実行では 32,768 トークンの上限を使用し、すべての effort レベルで十分な余裕がありました。
Grok 4.7 は 4 つの effort レベルをサポートしています: low, medium, high、および xhigh。effort レベルはモデルのバージョン間で変わることがあるため、リストをハードコードするのではなく、サービス側で確認する価値があります:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
推論を必要とするタスクの設計
多くのエージェント評価は勤勉さを試すものです。レコードを読み、フィルタリングし、合計する。そうしたタスクも価値がありますが、reasoning effort が何を貢献するかを見るには、探索を必要とするタスクでなければなりません。答えはデータから読み取れるものではなく、提案された上で検証されなければならないのです。
私たちは 20 個のサービスからなる合成環境を、7 つのツールを通じて公開して構築し、その上に 3 つのタスクを作成しました。すべてのタスクには正確に 1 つの正解があり、それぞれが簡単なヒューリスティックでは見つけられないように作られています。
| タスク | エージェントが行うこと | 推論タスクである理由 |
| two_fault_diagnosis | 2 つのサービスが 03:00 にサイレントに障害を起こし、他の 12 個のサービスがアラートを上げました。障害を起こした 2 つを特定してください | 失敗したサービスはアラートを発しないため、答えはアラートを発しているサービスの中にはありません。考えられる組み合わせは190通りで、そのうち観測されたアラートを正確に説明するのは1つだけです。 |
| maintenance_schedule | 4晩で8つのサービスにパッチを適用します。1晩2つ、10件未満の制約と「同じチームの2つのサービスが同じ晩を決して共有しない」というルールの下で行います。 | 2,520 通りの可能なスケジュールのうち、有効なのは1つ。チームのルールは、エージェントが調べる必要のあるデータに依存します |
| migration_budget | 予算内でリスク低減を最大化するように移行する候補を選定します。推移的な前提条件も含めて選びます。 | 実現可能な集合は53通り、そのうち最適は1つ。最良の比率から先に選ぶと、最適解より9ポイント届かない集合になる |
この種の測定を信頼できるものに保つための4つの実践があり、それらはほとんどのエージェント評価に当てはまります。
採点者が依拠するすべてのルールを列挙すること。 プロンプトがエッジケースを明示しないままにしていると、もっともらしい回答が誤りと採点される可能性があり、評価はモデルではなく仕様を測ることになってしまいます。たとえば、この診断プロンプトには、障害が発生したサービスがそれ自体ではアラートを発しないことが明示されています。
各タスクに解答が一つしかないことを証明せよ。 各環境は列挙できるほど小さかったため、何かを実行する前にすべての候補解答を確認しました。スケジュールについては、次の数行です。
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
必要な最終行を評価します。回答全体ではありません。 各プロンプトは、エージェントに対して次のような行で終わるよう求めています FINAL: auth, checkout。採点者はその行のみを読み取るため、判断理由を説明しながら他の候補についても言及する回答は、その結論に基づいて採点されます。
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
トラック形式を正確性とは別に扱う。 最終行が欠落していることは、誤った最終行があることとは異なるシグナルです。私たちの実行では、72件の回答すべてに採点可能な最終行が含まれていました。
ツールのパラメータを次の方法で制約します: enum 有効な値が分かっている場所であり、すべてのツール呼び出しが実在のリソースを対象とします:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
システムプロンプトは意図的に短くされており、エージェントに対して回答を提示する前に確認するよう求めています。
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
エージェントループは標準的なツール呼び出しループです。モデルを呼び出す際に reasoning_effort 設定し、返された各ツール呼び出しを実行し、その結果を対応するキーで追加します。 tool_call_id、そしてモデルがツールの要求をやめるまでこれを繰り返します。追跡 prompt_tokens および completion_tokens ループ全体を通すと、次のセクションで報告されるトークン数が得られます。
結果
各タスクを各努力レベルで6回実行し、合計72回実行しました。エージェントは67回正解しました。
| タスク | low | 中程度 | 高い | xhigh |
| two_fault_diagnosis | 5/6 | 6/6 | 6/6 | 6/6 |
| maintenance_schedule | 5/6 | 5/6 | 5/6 | 6/6 |
| migration_budget | 6件中5件 | 6件中6件 | 6件中6件 | 6件中6件 |
| 3つのタスクすべて | 18件中15件 | 18件中17件 | 18件中17件 | 18件中18件 |
| 実行あたり | low | medium | high | xhigh |
| 平均出力トークン数 | 1,184 | 6,430 | 6,778 | 9,147 |
| lowを基準とした出力トークン数 | 1.0x | 5.4x | 5.7x | 7.7x |
| 平均ツール呼び出し回数 | 17.2 | 18.7 | 17.8 | 18.1 |
| 経過時間の中央値 | 18秒 | 98秒 | 89秒 | 106秒 |
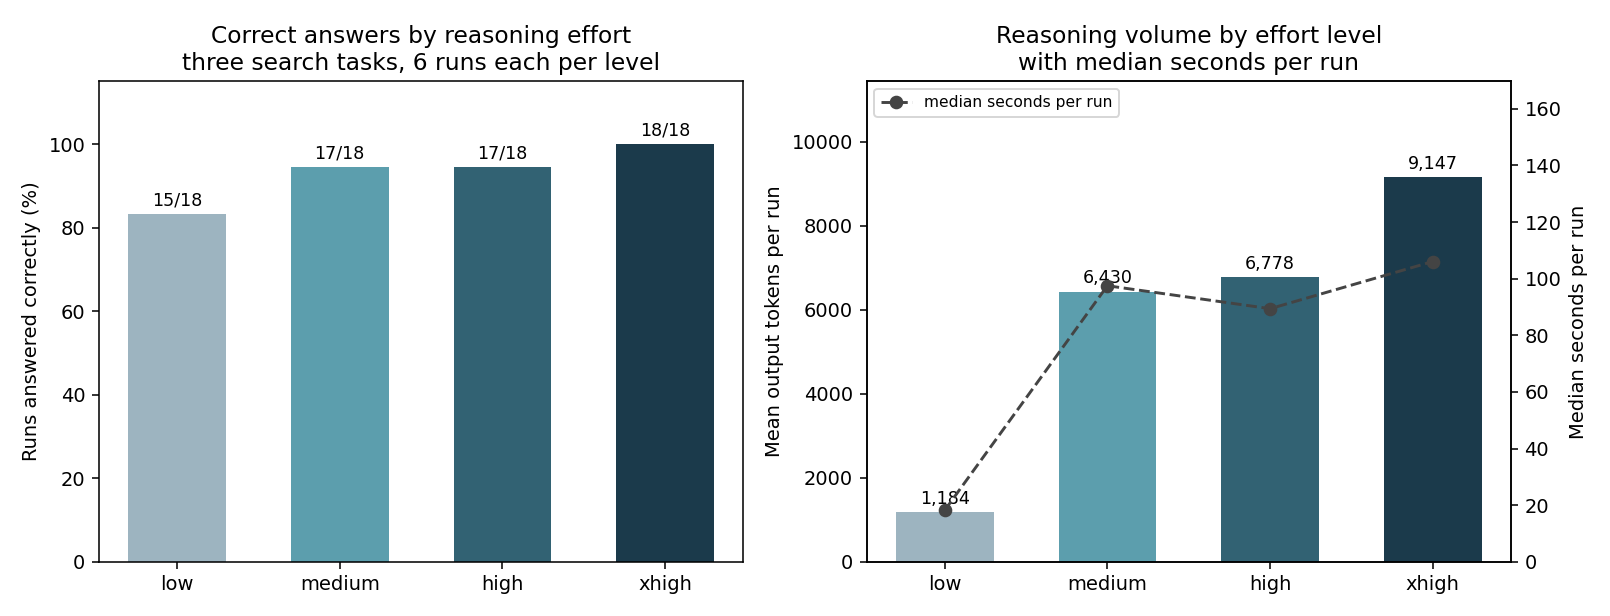
図1: 各推論努力レベルで正解した実行の割合(左)、および実行あたりの平均出力トークン数に実行あたりの秒数の中央値を重ねて表示(右)
3つの観察点。
xhigh すべての実行に正しく回答しました。 3つのタスクにわたる18件の実行はすべて、 xhighで正解しており、 medium そして high それぞれ18問中17問に正答しました。タスクとレベルごとに6回実行したため、レベル間の差は示唆的ではあるものの統計的に決定的なものではなく、方向性は3つのタスクすべてで一貫していました。
推論量(effort)が変えるのは、エージェントがどれだけ推論するかであって、どれだけ探索するかではありません。 ツール呼び出しは実質的に横ばいで、すべてのレベルで1実行あたり17.2から18.7の間でした。エージェントは努力の度合いに関係なく同じ事実を収集しており、変化したのはそれらにどれだけの推論を適用するかであり、出力トークンは1,184から low で9,147まで上昇しました xhigh.
low で9,147まで増加しました。 は優れたコスト対品質比を提供します。 lowでは、エージェントは18回の実行のうち15回を正しく回答し、使用した出力トークンはおよそ8分の1でした xhighの出力トークン約8分の1を使用して、18回の実行のうち15回に正答し、実行の中央値は18秒でした。わずかに低い完了率が許容できる場合や、回答が下流でレビューされる場合には、 low は効率的な選択です。すべての回答を初回で正確にする必要がある場合には、より高いレベルがより安全なデフォルトです。
努力の度合いが答えをどう左右するか
タスクは特定の種類の難しさを念頭に設計されており、それぞれの努力レベルがそれらにどう対処したかを見ることで、追加の推論がいつ価値を持つのかが明らかになる。
最適化。 移行タスクでは、選択肢を1つずつ順位付けするのではなく、組み合わせを検討することが報われます。個々の比率が最も良い候補を選ぶと、最適解より9ポイント劣る妥当な答えが得られます。At medium 以上の場合、エージェントは18回の実行すべてにおいて最適なセットを発見しました。
仮説検定。 診断タスクでは、候補ペアを双方向から検証する必要があります。すべてのアラートが説明され、沈黙を保ったすべてのサービスがその回答と整合していなければなりません。At medium 以上のバージョンでは、エージェントは18回の実行すべてで正しいペアを特定しました。
制約充足。 スケジューリング課題は、列挙された10個の制約と、参照した所有権データに依存するチームルールを組み合わせたものです。 xhigh すべての実行で有効なスケジュールを生成し、このタスクでは最上位レベルが最も明確な差を示した。
3つに共通するパターンは、追加の推論労力が最も価値を持つのは、単一の経路を結果までたどるというよりも、エージェントが複数の候補回答を互いに比較検討しなければならない場合だということです。
本番環境における推論のモニタリング
本番環境では採点対象となる既知の正解はありませんが、各実行で使用された出力トークン数やツール呼び出しの回数は把握できます。これらは有用な運用上のシグナルになります。
各水準における正しい実行は、推論量の明確な下限を確実に上回っています。すべての正しい実行は medium 以上のモデルでは最低でも1,739出力トークンを使用し、典型的な実行では数千トークンを使用しました。ツール呼び出しを一切行わない実行や、そのレベルとしては通常よりはるかに少ない出力しか生成しない実行は、レビュー対象としてフラグを立てる価値があります。
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
すでに評価済みの実行からタスク別・努力レベル別にベースラインを較正し、それを未評価の実行に適用してください。フラグは確認または再実行のきっかけとして扱ってください。At low、実行が短い場合は出力量はあまり当てにならないため、スポットチェックと併用してください。
システムプロンプトでエージェントに回答の検証を求めるのは、そのまま残す価値があります。ランをレビューする際にエージェントの推論を容易に追えるようになるからです。既知の正解が存在する場合には、自動採点と組み合わせ、品質がトランスクリプトとは独立に測定されるようにしましょう。
推論の労力の選択
これらの結果は、いくつかの実用的なルールを示唆しています。
タスクの種類に応じて努力を合わせましょう。 検索、最適化、または仮説の検証を伴うタスクは、次のことから最も恩恵を受けます。 medium 「以上。単一の経路をたどるタスクや、その答えが下流でレビューされるタスクは、次のレベルで効率的に実行できる」 low.
エージェントごとではなく、リクエストごとに effort を設定してください。 Effortはリクエストパラメータであるため、エージェントは計画や検証のステップをより高いレベルで実行し、ツールの結果を整形するといった機械的なステップは lowこれは、より高いレベルの信頼性の多くを、より低いトークンコストと組み合わせたものです。
自分のタスクについて、繰り返し測定してください。 1つの設定につき1回の実行では1つの観測結果しか得られません。各設定を何度か繰り返すことで、その一貫性がどの程度かがわかります。
推論量をモニタリングしてください。 実行あたりの出力トークン数とツール呼び出しを effort レベル別に追跡することで、その結果が使用される前に実行内容を早期に確認するシグナルが得られます。
この測定の限界
タスクと努力レベルごとに6回の実行。 3つのタスクにわたって一貫した方向性を示すには十分ですが、信頼区間を出すには不十分です。レベル間の差は参考程度に扱ってください。
合成環境。 ツールはコードで生成されたデータを読み取るものであり、これにより各タスクに正確に1つの答えが存在することを証明し、自動採点することが可能になっています。実際のツールはレイテンシー、部分的な結果、エラーを引き起こしますが、これらはいずれも本稿では検証していません。
分単位であり、時間単位ではない。 実行時間の中央値は18秒から、 low では106秒までの範囲でした xhighで106秒の範囲でした。これは長期的な作業を縮小した代理実験です。手法は転用できますが、絶対的な数値は転用できません。
1つのモデルバージョン、1つのリージョン、タスクごとに1つのプロンプト。 同じタスクでも言い回しが異なれば結果が変わる可能性があります。これこそが、すべてのルールを明示的に述べることが重要である理由の一部です。
トークン数であり、コストではない。 金額に換算するには、Amazon Bedrockの料金ページで推論プロファイルとサービティアの現在のレートを適用してください。GlobalプロファイルとUS Geoプロファイルでは料金が異なり、FlexおよびPriorityサービティアでは乗数が適用されます。
エージェントワークロードのための運用上の管理手法
リトライを組み込む。 大量の呼び出しを発行するエージェントは、リトライを設計の一部として扱うべきです。リクエストタイムアウトを設定し、リトライ可能なエラーのみをリトライし、ジッター付きの指数バックオフを行い、返された場合は Retry-After ヘッダーを尊重します:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
オンデマンドスループットは時間とともにスケールアップするため、新しい大容量ワークロードはフルレートで開始するのではなく、段階的に増やしてください。
実行の監査。 モデル呼び出しロギングは、リクエストとレスポンスのデータをAmazon Simple Storage Service (Amazon S3) またはAmazon CloudWatch Logsに書き込みます。これにより、後から確認したい実行の完全なトランスクリプトを取得できます。
大規模な推論量のモニタリング。 Amazon CloudWatchメトリクスはトークン使用量の集計ビューを提供します。ここで、前述のレベルごとのベースラインがアラーム設定可能なものになります。
エージェント間のコスト配賦。 AWS Cost ExplorerとAWS Cost and Usage Reportのコスト内訳は使用量をモデルごとに分類します。これをタスクごとのトークン数と組み合わせることで、単位経済性と総請求額の両方を把握できます。
コストと緊急度のマッチング。 サービスティアはリクエストごとに設定されるため、1つのデプロイで、夜間の分析はFlexティア経由で、インタラクティブなリクエストはPriorityティア経由で送信できます。より高いeffortレベルで実行されるワークロードでは、ティアの選択がコストをさらに調整するレバーになります。
ルーティングプロファイルの選択。 クロスリージョン推論は、長時間の実行が利用するキャパシティプールを広げます。Globalプロファイルは、選択した商用AWSリージョンから提供され、地理的ルーティングよりも通常トークンあたりの価格が低くなります。USプロファイルは処理を米国内に維持します。コストだけでなく、データレジデンシーの要件に基づいて選択してください。
クリーンアップ
この記事の例では、リクエストごとのトークン使用量を超えて課金対象のAWSリソースは作成されません。長期のAmazon Bedrock APIキーを生成した場合は、取り消されるまで有効であり続けるため、作業が完了したらAmazon Bedrockコンソールで削除してください。IAM認証情報から生成された短期トークンは、自ら期限切れになります。
テスト中にAmazon S3へのモデル呼び出しログを有効にした場合は、バケットを確認し、不要になったオブジェクトを削除してください。
まとめ
SpaceXAIは、より困難なタスクに長時間取り組み、自身の作業を検証すべきタイミングを判断できるようにGrok 4.7を訓練しました。検索を必要とし、単なる参照では済まない3つのタスクにおいて、エージェントは72回の実行中67回を正しく回答し、すべての実行で xhigh。推論effortはリクエストごとに設定できるため、エージェントの各ステップを、徹底性とトークンコストのトレードオフのどこに置くかを選択できます。
自身の評価に持ち込む価値のある3つのポイントがあります。証明可能な1つの答えを持つタスクを設計し、評価者が依存するすべてのルールを明示すること。実行を繰り返し、各構成の一貫性を確認すること。そして、effortレベルごとに出力トークンとツール呼び出しを監視し、品質測定に加えて運用上のシグナルを得ることです。
参考資料
- Introducing Grok on Amazon Bedrock
- Grok 4.7 is now available on Amazon Bedrock
- リージョン間推論でAWSリージョン全体にモデル推論リクエストをルーティングする
- Getting started with Amazon Bedrock
- Chat Completions API
- Amazon Bedrock pricing
- Introducing Grok 4.7 (SpaceXAI)