
セキュリティアナリストは、ドメイン固有のクエリ言語に深く精通していなくても、クラウドインフラストラクチャに関する迅速な回答を必要としています。 Orca Securityのツールは、900 を超えるクラウドモデル(Amazon Elastic Compute Cloud (Amazon EC2) インスタンスや Amazon Simple Storage Service (Amazon S3) バケットなど、Sonar が追跡するリソースタイプ)をカバーしています。このデータをクエリするには、正確なモデル名、ネストされた関係のナビゲーション、18 種類の演算子(equals や contains など、結果をフィルタリングするための比較関数)からの選択が必要でした。
これを解決するため、Orca Security は AWS と協力し、 Amazon Bedrock上に自然言語クエリエージェント Discovery AI を構築しました。Orca はクラウド、コード、AI に対するコンテキスト認識型のセキュリティを提供しており、Sonar はそのドメイン固有のクエリシステムで、ユーザーはデータグラフ全体を横断して検索、フィルタリング、探索を行うことができます。
本記事では、自然言語の質問を Sonar クエリに変換する Discovery AI のアーキテクチャと成果を紹介します。その結果、Orca は初期のベースラインと比較して、クエリコストを 90%、入力トークンを 93%、レイテンシーを 75% 削減しました。
自然言語と構造化クエリの橋渡し
Orca Security の Sonar クエリシステムは、複雑な関係を持つ 900 以上のクラウドインフラストラクチャおよびアプリケーションモデルをサポートしています。このデータをクエリするには、ユーザーは正確なモデル名を指定し、18 種類の演算子から選択し、クラウドプロバイダー間の親子階層をナビゲートする JSON オブジェクトを構築します。これを適切に行うには、Sonar スキーマへの深い精通が必要です。
この機能を構築するため、Orca チームは、平文のテキストから有効な Sonar クエリを生成できる自然言語インターフェースの構築に着手しました。
当初の概念実証では、最大の利用可能なモデルの単一のプロンプトに Sonar スキーマ全体を読み込みました。これには、900 を超えるモデル定義、すべてのリレーションシップタイプ、そして豊富なサンプルクエリが含まれていました。出力品質は高く(設計パートナーと内部ユーザーから好意的な反応がありました)が、本番規模では 3 つの重大な欠点が明らかになりました。
トークン消費が非効率で、ワークロードあたり約 2 million 入力トークンに達し、コストが増大しました。レイテンシーも高く、ワークロードあたりのエンドツーエンドの応答時間は約 60 秒でした。複雑なマルチモデルクエリでの精度も限定的で、ネストされたリレーションシップや複数条件のクエリには追加の調整が必要となることがよくありました。
Orca チームは、この概念が機能することを検証しました。次の課題は、本番環境に耐えうるだけのコスト効率、速度、精度を実現することでした。これに対応するため、Orca チームは、Amazon Bedrock を使用して 15 秒の応答時間で 1 日数千件のクエリを処理するソリューションを設計・展開しました。
ソリューションの概要
Orca は Discovery AI を、検索拡張生成 (RAG) とスキーマ認識型のクエリ構築を組み合わせた、Amazon Bedrock 上のハイブリッドソリューションとして設計しました。このシステムは、マルチステージのパイプラインを通じて自然言語の質問を有効な Discovery フィルタに変換し、各ステージには最も適した Amazon Bedrock モデルを割り当てています。
Orca が Amazon Bedrock を選んだのは、単一の API を通じてマルチモデルアクセスを提供し、別々の統合を管理することなく、パイプラインの各ステージに異なる基盤モデルを割り当てられるからです。また、Amazon Bedrock は AWS Identity and Access Management (IAM)、仮想プライベートクラウド (VPC) エンドポイント、AWS CloudTrail を通じて AWS のガバナンスコントロールを継承するため、Orca のセキュリティ要件を満たします。モデルに依存しないアーキテクチャだったため、パイプラインを再設計することなく、新しいモデルバージョンが利用可能になり次第、差し替えることができました。
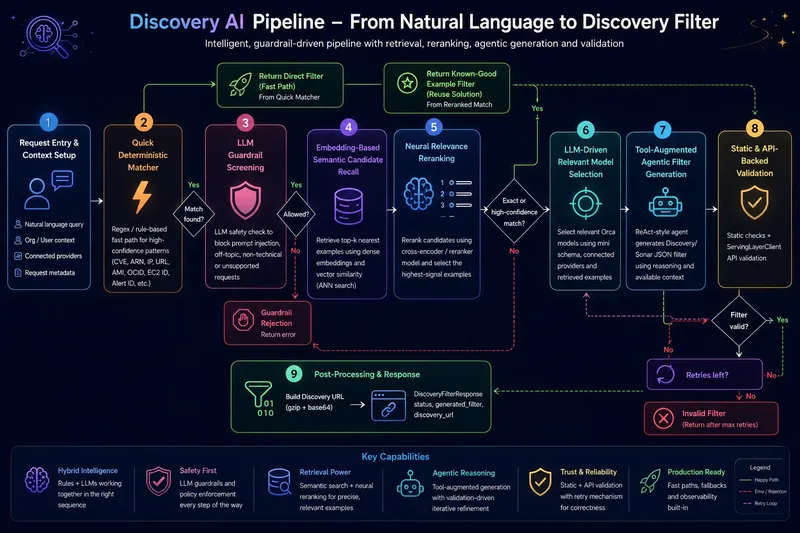
次の図は、9 段階のパイプラインアーキテクチャを示しています。
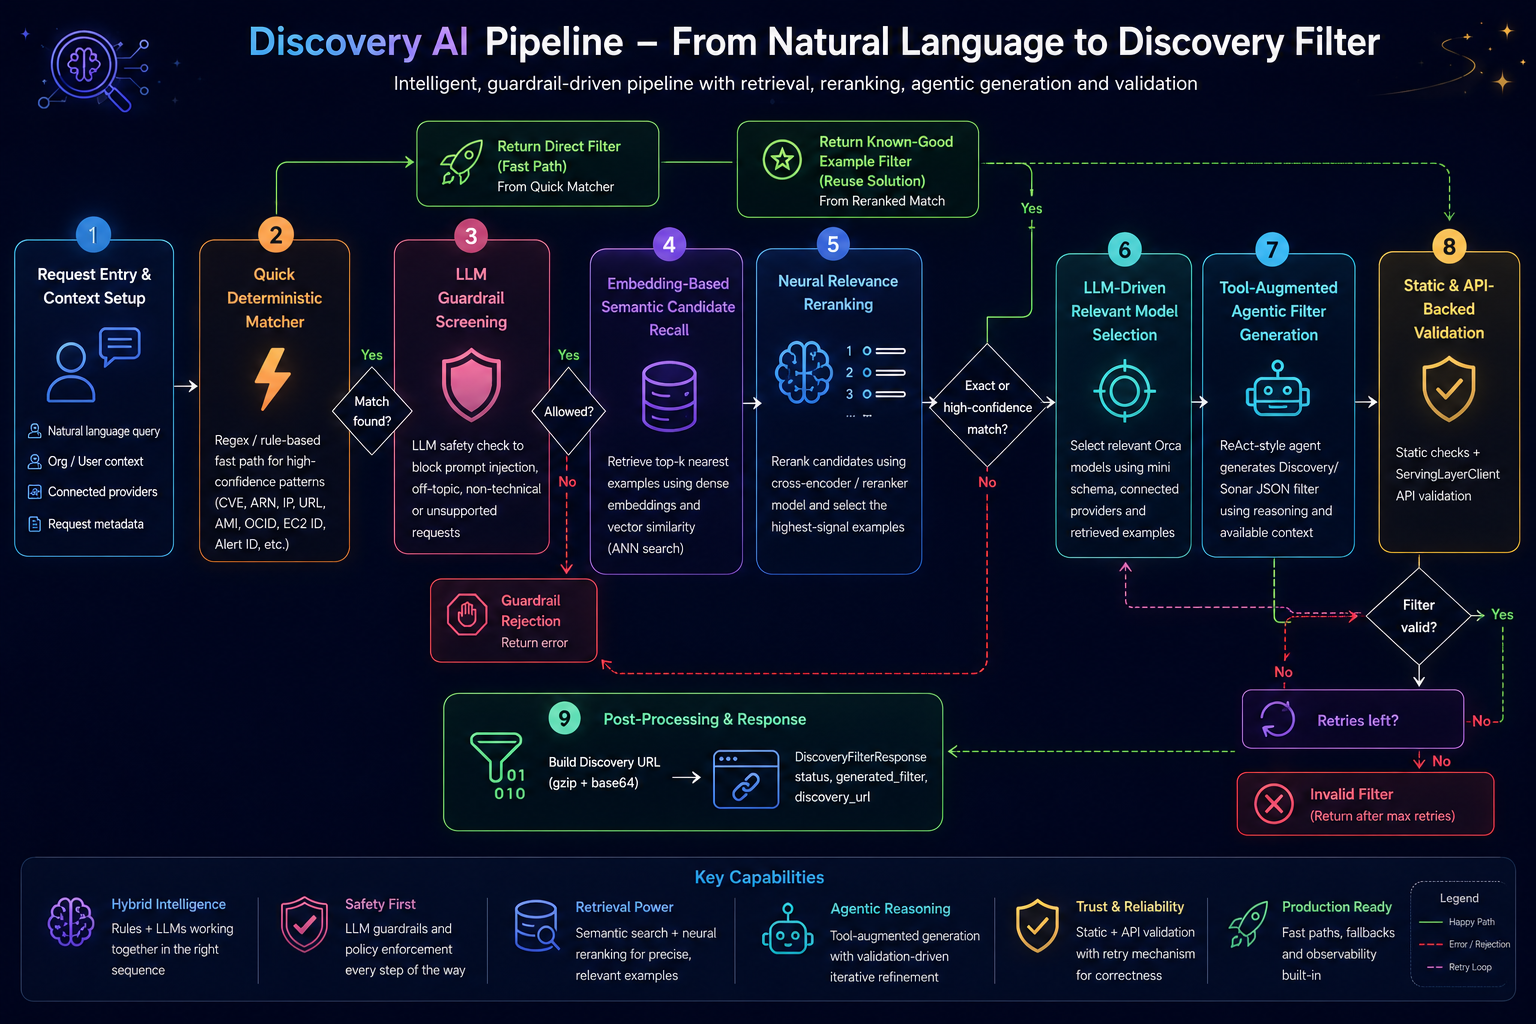
図 1:Amazon Bedrock 上の基盤モデルを使用して、自然言語入力から検証済みの Discovery フィルタクエリへのフローを示すマルチステージの Discovery AI パイプラインアーキテクチャ
Discovery AI パイプラインは、9 つのステップを通じて自然言語リクエストを検証済みの Discovery フィルタに変換します。
- リクエスト受付とコンテキスト設定:パイプラインは、ユーザーの自然言語リクエストを、ユーザーの組織、接続されたクラウドプロバイダー、リクエストメタデータなどの関連するコンテキストと組み合わせることから始まります。このコンテキストにより、パイプラインはリクエストを正確に解釈し、顧客の環境に合った Discovery フィルタを生成できます。
- クイック決定論的マッチャー:Quick Matcher は、IP アドレス、Common Vulnerabilities and Exposures (CVE)、ARN、ファイルハッシュ、Amazon Machine Image ID、Oracle Cloud Identifier、EC2 ID、URL、アラート ID などの構造化された入力を識別します。正規表現とルールベースのマッチングを使用して、高信頼度のパターンを検出します。マッチが見つかった場合、パイプラインは大規模言語モデル (LLM) の推論を使用せずに、高速パスを通じて事前定義された Discovery フィルタを返すことができます。マッチが見つからない場合、リクエストは次のステップに進みます。
- LLM ガードレールスクリーニング:Guardrail コンポーネントは、リクエストが安全で、関連性があり、技術的で、サポートされているものであるかを確認します。プロンプトインジェクションの試み、無関係なリクエスト、サポートされていない入力を、パイプラインの残りの部分に到達する前にブロックします。ガードレールチェックに失敗したリクエストは、適切なエラーとともに拒否されます。承認されたリクエストは、サンプル取得に進みます。
- 埋め込みベースのセマンティック候補リコール: パイプラインは、Amazon Titan Text Embeddings を使用して、関連する過去に検証済みのクエリ例を検索します。セマンティックな類似性に基づいて、ベクトルストアから最も近い 20 件の例を取得します。これらの候補により、パイプラインは類似した自然言語リクエストがどのように Discovery フィルターへ変換されてきたかの例を得ることができます。
- ニューラル関連性リランク: 取得された候補は、Amazon Bedrock 上の Cohere Rerank 3.5 を使用してリランクされます。現在のリクエストに最も関連する例を特定し、シグナルの高い上位 5 件の例を選択します。完全一致または高確度の一致が見つかった場合、パイプラインは既知の正常なフィルターを直接再利用できます。そうでない場合、リランクされた例は生成ステージに渡されます。
- LLM による関連モデル選択: モデル選択は、900 を超える Sonar モデルを、リクエストに関連する少数のセットに絞り込みます。適切なモデルを選択する際に、ユーザーのリクエスト、接続されているプロバイダー、取得された例を考慮します。選択されたモデルは、コンパクトなマイクロスキーマからより詳細なミニスキーマまで、適切なスキーマレベルで Generator に提供されます。これにより不要なコンテキストが削減され、生成がより効率的になります。
- ツール拡張エージェントによるフィルター生成: Generator はツール拡張エージェントを使用して、最終的な Discovery フィルターを構築します。選択されたモデルスキーマ、取得された例、ユーザーコンテキスト、利用可能なツールに基づいて推論を行います。エージェントは、ユーザーのリクエストの有効な表現に向かって作業する過程で、フィルターを反復的に改良できます。
- 静的および API による検証: 生成されたフィルターは、構文的および意味的な正しさについて検証されます。パイプラインはまず静的検証を適用し、次に Orca の Sonar API に対してフィルターを検証します。検証に失敗した場合、検証エラーは Generator に返され、エージェントがフィルターを修正して再試行できます。最大再試行回数に達しても有効なフィルターが生成されない場合、パイプラインは無効フィルターのレスポンスを返します。Generator はリランクされた例と選択されたスキーマに制約されます。静的検証は、すべてのモデル、フィールド、演算子をそれらのスキーマ定義に遡って解決します。各検証エラーは、問題のある要素を特定したうえでエージェントに返されるため、再試行は再推測ではなく再グラウンディングとなります。
- 後処理とレスポンス: Quick Matcher、既知の正常な例の再利用、エージェントによる生成のいずれかによって有効なフィルターが生成された後、パイプラインは最終レスポンスを準備します。チームは、各ステージの要件に基づいて、コンポーネントごとに Amazon Bedrock 上で異なる基盤モデルを割り当てました。 Anthropic Claude Haiku 4.5 は Model Selector と Generator を動かしています。これらのコンポーネントは、正確なクエリ構築のために強力な推論能力を必要とします。 Amazon Nova 2 Lite は Guardrail と Validator を担当しており、ここでは低コストでの高速推論が優先されます。Amazon Titan は Example Retrieval コンポーネントにおけるセマンティック検索のための埋め込みを提供します。Cohere Rerank 3.5 は取得された候補をリランクし、関連性を最大化します。AWS リージョンごとのモデル利用可否については、以下を参照してください。 モデル別のリージョン別利用可否.
例の取得における関連性と多様性の最大化
例の取得は、パイプラインにおける単独で最大の精度向上のレバーであることがわかりました。優れた例は、スキーマだけよりも効率的に質問を Sonar クエリへ変換する方法を Generator に教えるため、Orca チームは Amazon Bedrock 上で複数の取得戦略をベンチマークしました。各戦略は関連性、多様性、速度それぞれ異なる形でトレードオフを伴い、直接比較することでどの組み合わせが最も効果的かが明らかになりました。
Amazon Titan 埋め込みに対する純粋なトップ K セマンティック検索は高速に動作しましたが、近似重複の例を返しがちで、Generator に多様性をもたらせませんでした。Maximal Marginal Relevance (MMR) は多様性を改善しましたが、トップ候補が実際に正解である場合に関連性が犠牲になりました。より大きな候補セットを取得してからリランクする手法は、より広いプールから取り込み、リランカーを使用して最も関連性の高いサブセットを選択するものであり、これが勝利したアプローチへの道筋となりました。
勝利したのは、Amazon Titan 埋め込みを使用したトップ 20 最近傍検索でした。Orca はその後、これらの結果を Cohere Rerank 3.5 でリランクし、トップ 5 に絞り込みました。このアプローチにより、取得時点でカバレッジと精度のトレードオフを強制されることなく、Generator に小規模で多様かつ高度に関連性の高い例のセットを提供できます。
900 を超えるモデルのコンテキストへの読み込み
アーキテクチャを形づくった核心的な制約がありました。900 を超える Sonar モデルのスキーマをすべてのプロンプトに含めることは現実的ではありませんでした。長コンテキストモデルを使っても、そうすることでコストと精度の両方が劣化します。
Model Selector がこれを解決します。Anthropic Claude Haiku 4.5 上で動作する Model Selector は、各モデルのコンパクトでセマンティックにリッチな表現(名前、目的、主要フィールド、主要なリレーションシップ)を対象に動作します。ユーザーの質問が与えられると、Generator が実際に必要とするモデルのみを返します。Generator は、選択されたモデルおよびそれらを結ぶリレーションシップについてのみ、完全なスキーマ詳細を受け取ります。
評価手法
自信を持って反復するために、Orca チームはプロジェクトの早い段階で継続的な評価ハーネスを構築しました。このハーネスは、キュレーションされたデータセット、自動スコアリングレイヤー、スライスベースの計測アプローチを組み合わせており、チームはリリース前にすべての変更を信頼できます。これらの要素が一体となることで、評価は事後的な作業ではなく日常的なステップとなります。
厳選された評価データセットは、本番環境で見られる質問タイプ、モデルファミリー、複雑さの階層を網羅しているため、実際の利用状況を反映しています。LLM-as-judgeによるスコアリング層は、生成されたクエリを正確性、完全性、参照クエリとの意味的な等価性について採点し、チームに一貫した品質シグナルをもたらします。そしてこの測定手法では差分をスライスごとに分解するため、チームはリグレッションがどこで発生しているのか、何を修正すべきなのかを正確に特定できます。
プロンプト、モデル、検索パラメータ、または例へのすべての変更は、本番環境に展開される前にハーネスを通過します。
継続的な改善のためのドメイン専門家参画型ラベリングシステム
顧客環境の変化や新たな質問パターンの出現に伴って精度を維持するには、当初の強力な導入だけでは不十分でした。Orcaチームは、プロダクトマネージャー、サポートエンジニア、セキュリティ研究者向けに内部ラベリングツールを構築しました。このツールを使えば、クエリのフラグ付け、出力の修正、そして1回の操作で修正内容をサンプルバンクに反映することができます。さらに、このシステムは信頼度の低いマッチングサンプルしか持たない本番クエリを自動的に収集し、日次ラベリングのために適切なドメイン専門家に振り分けます。次のパイプライン実行時にCohere Rerank 3.5を通じて新しいサンプルが取得され、そのクラスの質問に対する精度は同じ瞬間に、デプロイなしで向上します。
「ラベリングUIは、長期的な品質のために行った最も重要な投資です。Discovery AIを静的なデプロイメントから生きたシステムへと変え、ドメイン専門家が通常のワークフローの中で継続的に改善できるようになりました。」
— Or Gabay、Orca Security AI担当ディレクター
エンドツーエンドのパイプラインオブザーバビリティと、プロダクト、エンジニアリング、顧客対応チームにまたがる共有ダッシュボードと組み合わせることで、このフィードバックループこそが、初回リリース後もDiscovery AIを改善し続ける原動力となっています。
結果
本番環境にDiscovery AIをデプロイした後、新しいソリューションはコスト、レイテンシ、精度のすべての面で当初のベースラインを上回る結果を示しました。入力トークンの使用量は93パーセント減少し、同等のワークロードあたり約2百万トークンから140,000トークンへと減少しました。全体コストは90パーセント低下しました。これは、トークン消費量の削減に加え、Amazon Bedrockを活用したステージごとのモデル割り当てによるものです。
レイテンシも改善され、エンドツーエンドの応答時間は約60秒から15秒へと75パーセント短縮されました。複雑なマルチモデルクエリにおける正確性も向上し、チームの評価ハーネスを通じて継続的に測定されました。
Discovery AIは2026年3月以降、本番環境で1日数千件のクエリを処理しており、社内の専門家と顧客からのフィードバックによって品質が検証されています。
結論
この記事では、Orca SecurityがDiscovery AIをAmazon Bedrock上に構築した方法を紹介しました。このソリューションにより、初期のベースラインと比較して、クエリコストが90パーセント、入力トークン使用量が93パーセント、レイテンシーが75パーセント削減されました。このソリューションは、いくつかの重要な技術を組み合わせたものです。具体的には、Cohere Rerank 3.5を使用したRAGベースの例文検索、Anthropic Claude Haiku 4.5とAmazon Nova 2 Liteを使った段階ごとのモデル割り当て、そしてAmazon Titanによるセマンティック検索が含まれます。さらに、継続的なhuman-in-the-loopのラベリングシステムが継続的な改善を提供します。この組み合わせにより、Orcaは動作するプロトタイプを、実行コストがより低く、より正確な本番環境レベルのソリューションへと転換することができました。
同様のソリューションの構築を始めるには、以下をご覧ください: Amazon Bedrock ファウンデーションモデル(FM)へのアクセスのため、 Amazon Bedrock上のCohere Rerank 検索最適化のため、および Amazon Titan embeddings向けに提供されています。Orca Securityのクラウドセキュリティツールの詳細については、 orca.security.
Orca Securityがフレームワーク全体でAIをどのように活用しているか詳しく知るには、以下をご覧ください。 OrcaがAIによってどのようにセキュリティ成果を向上させるか および Amazon Bedrock を含む、Orca がどのように AI の導入を保護するか.
本投稿で使用した手法の詳細については、次をお読みください: 関連記事 〜の上の AWS Machine Learning Blog.