テキスト アリーナバトルシーン:
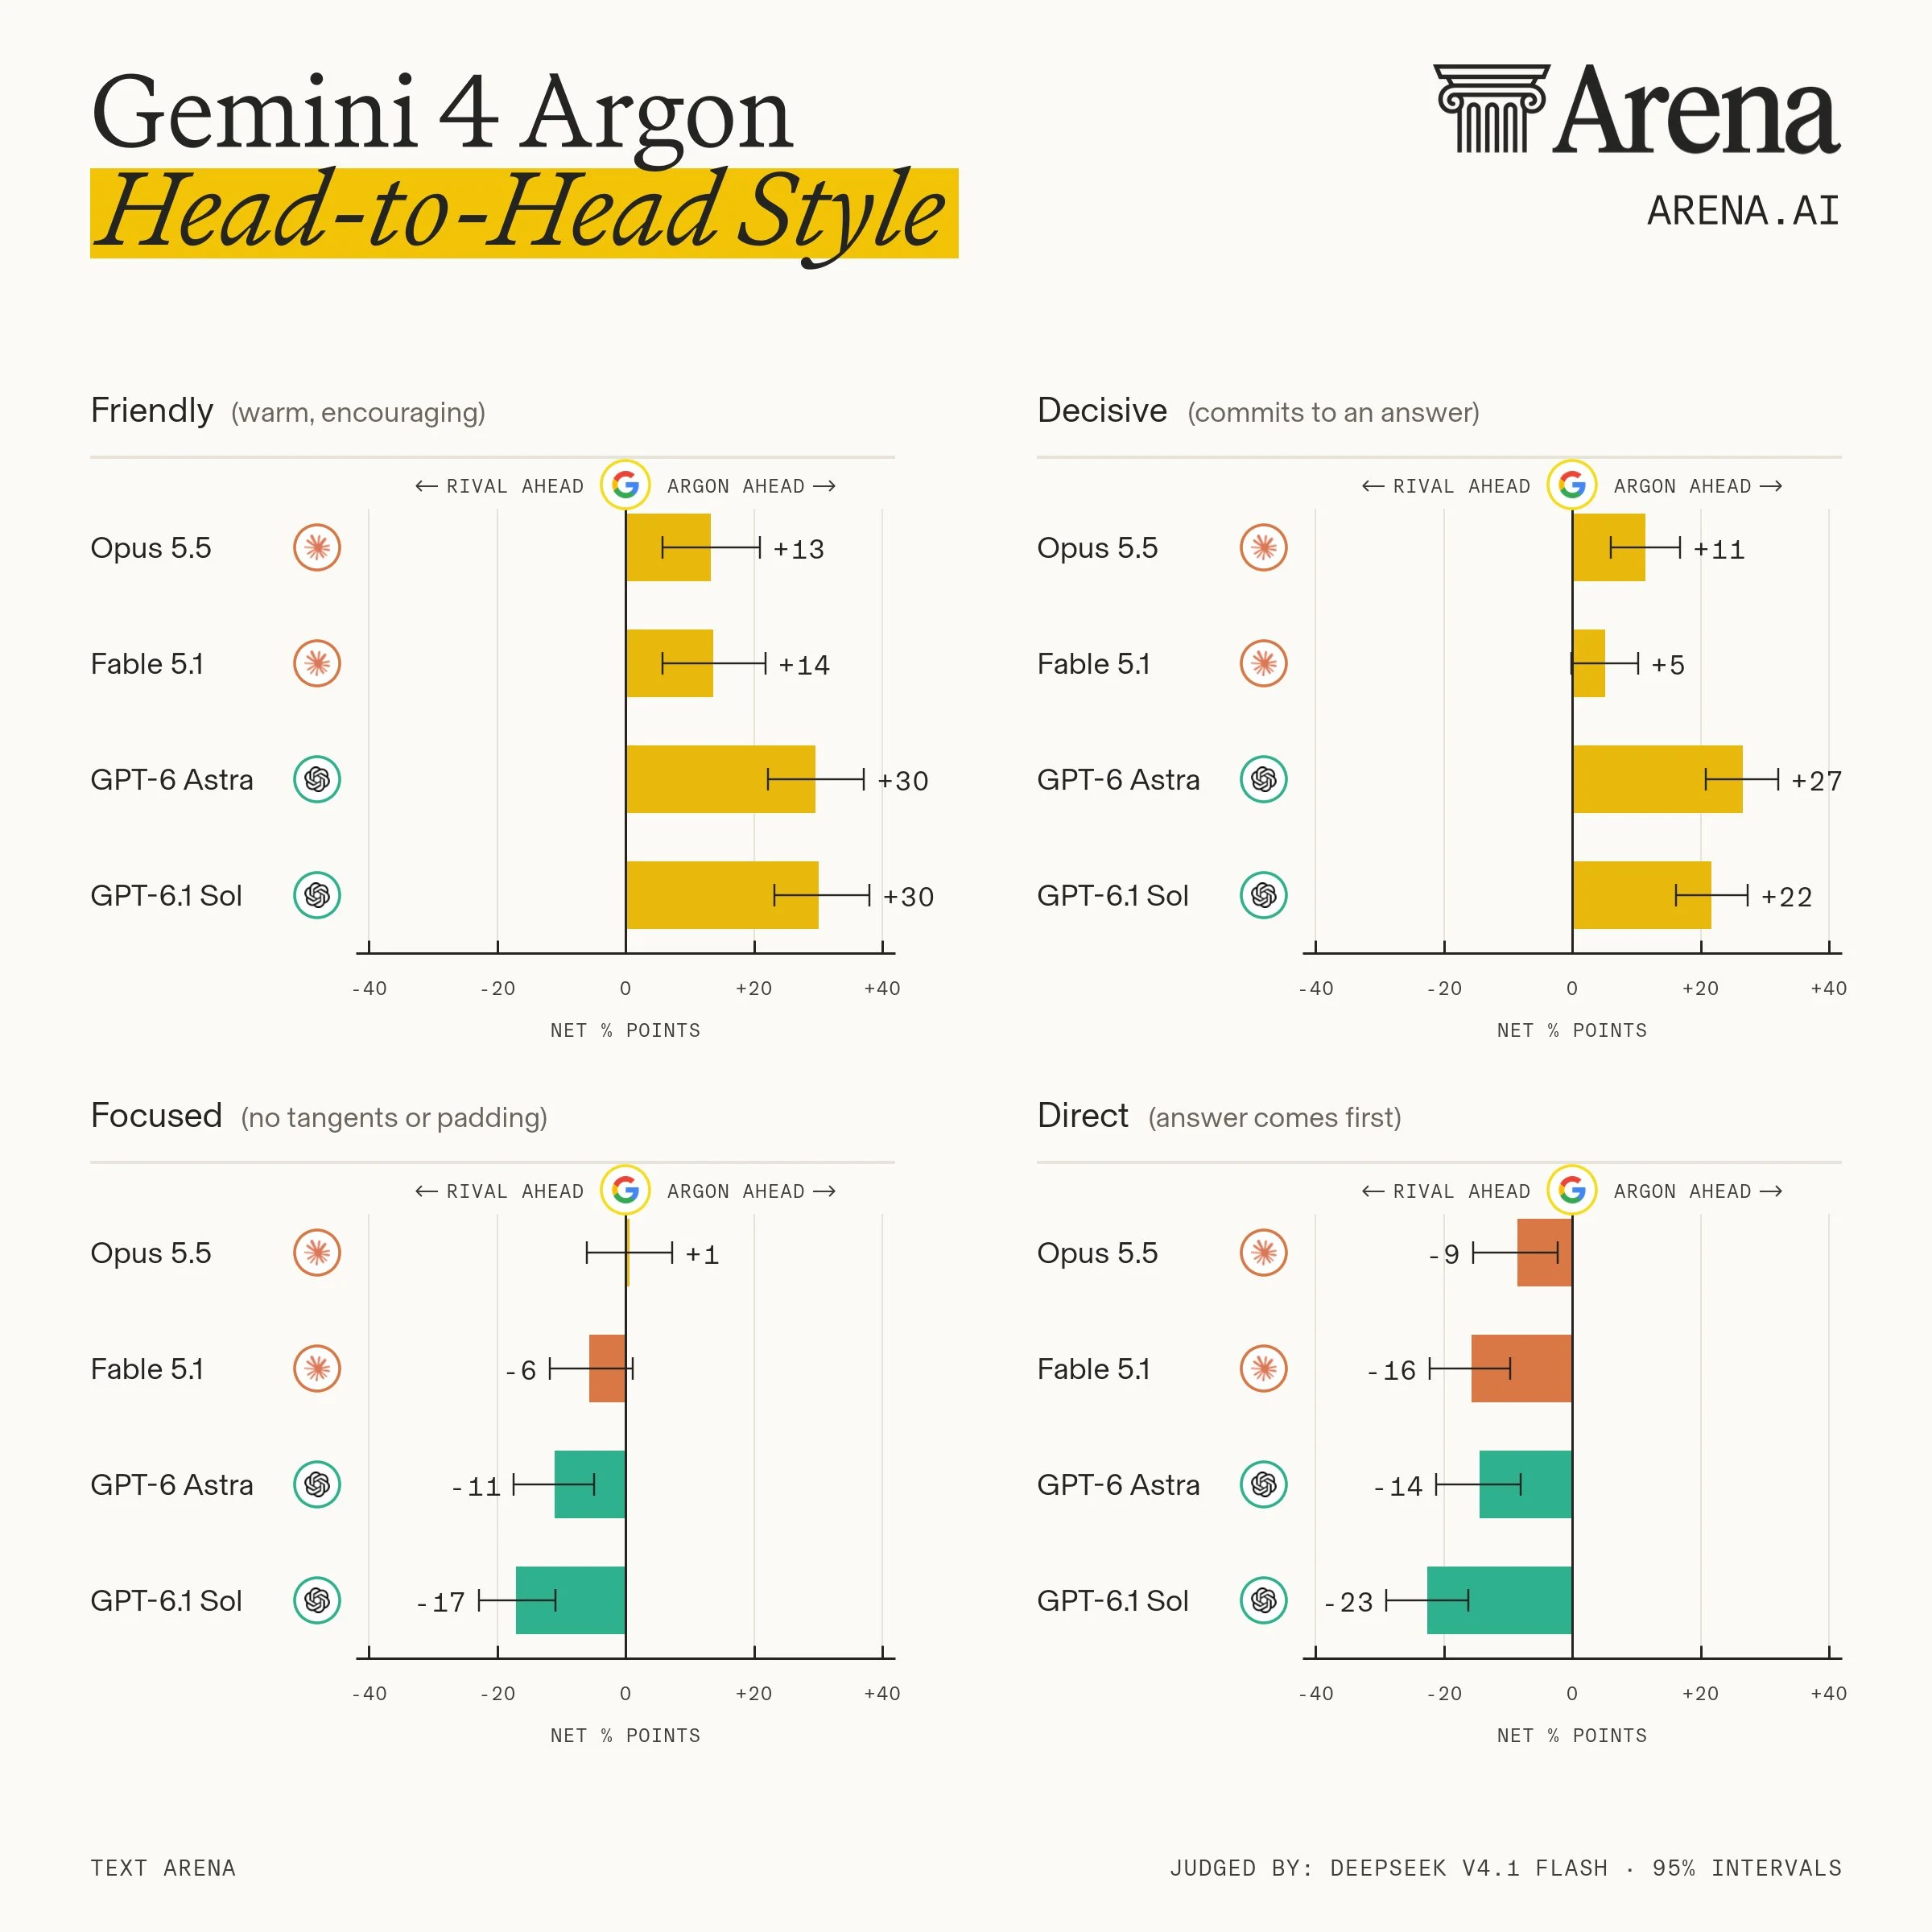
- @GoogleDeepMindの新しいリリースは、より親しみやすく、断固としています。温かく、励ましがあり、明確なトーンを保っています。GPT-6.1 Solに対して、AI審査員はアルゴンが55%優れていると評価し、Solはわずか25%でした。Opus 5.5に対しては、46%対32%です。
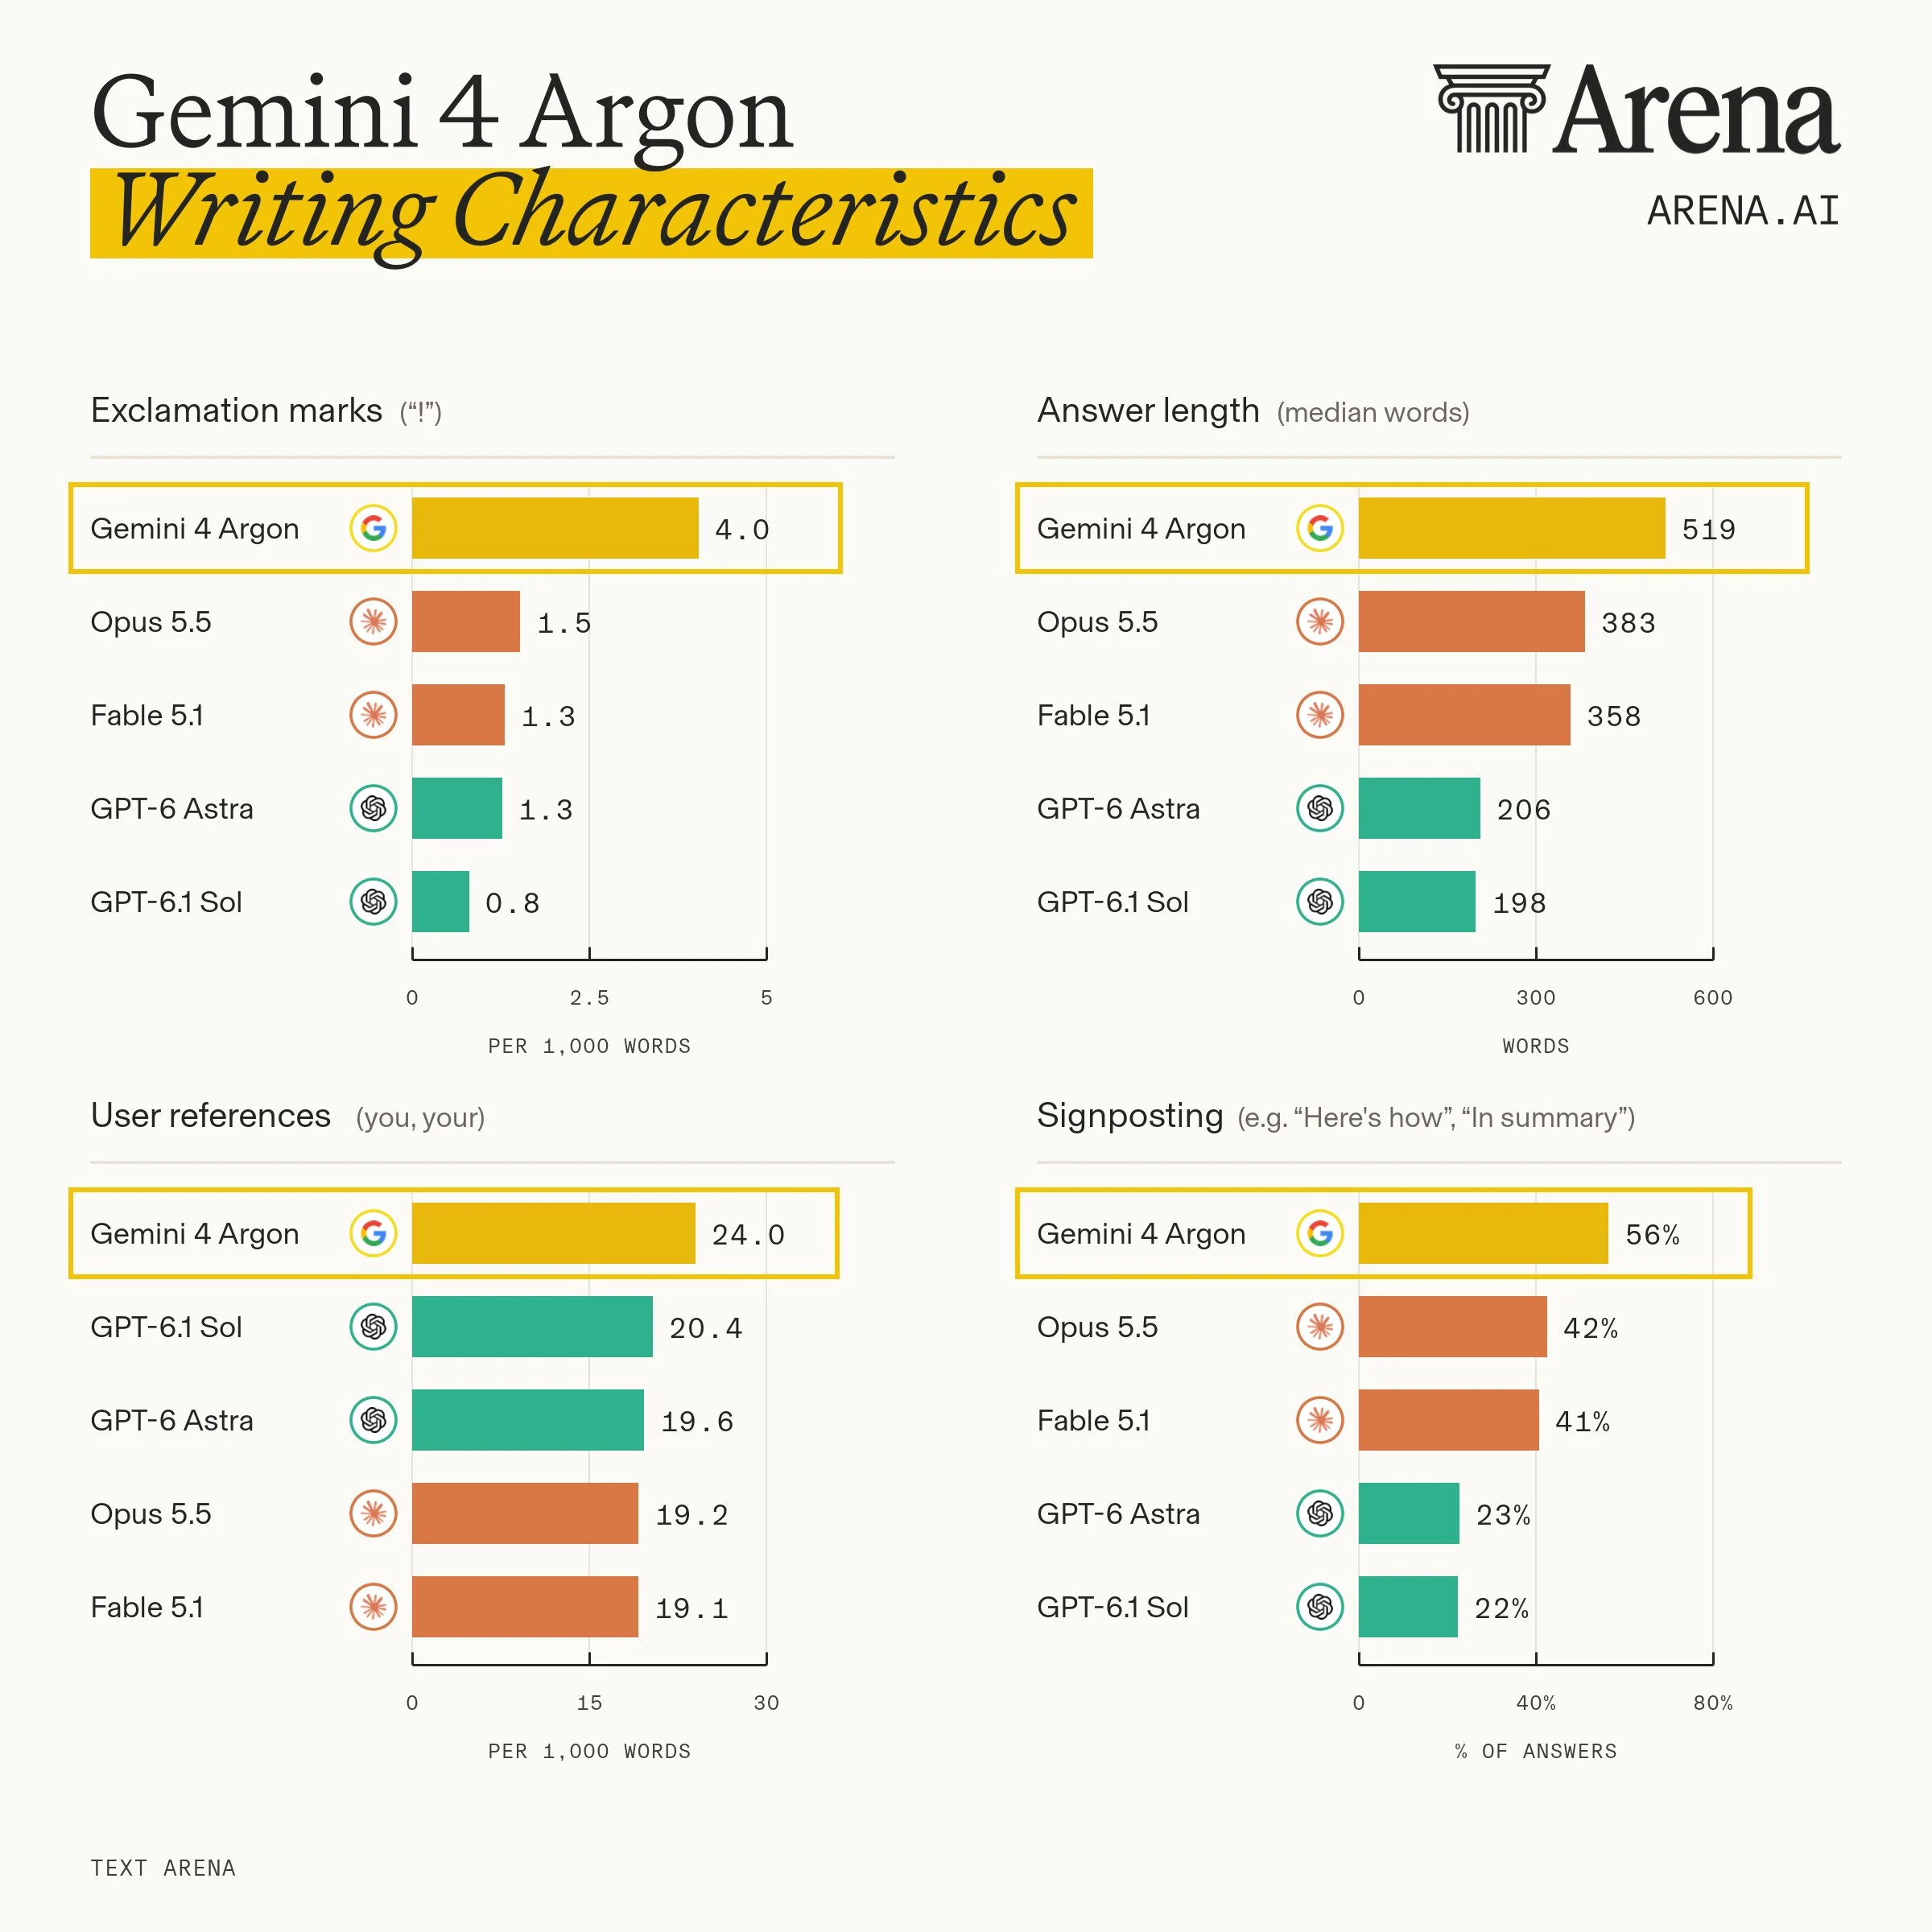
- より会話的なものになっている:モデルは話を逸脱することが多く、直接的ではない。競合モデルの回答は比較の32~37%でより直接的と評価され、Argonの回答は14~23%のみである。これは回答の長さにも反映されている:Argonの中央値の回答は519語であり、Claudeは358~383語、GPTモデルは約200語である。
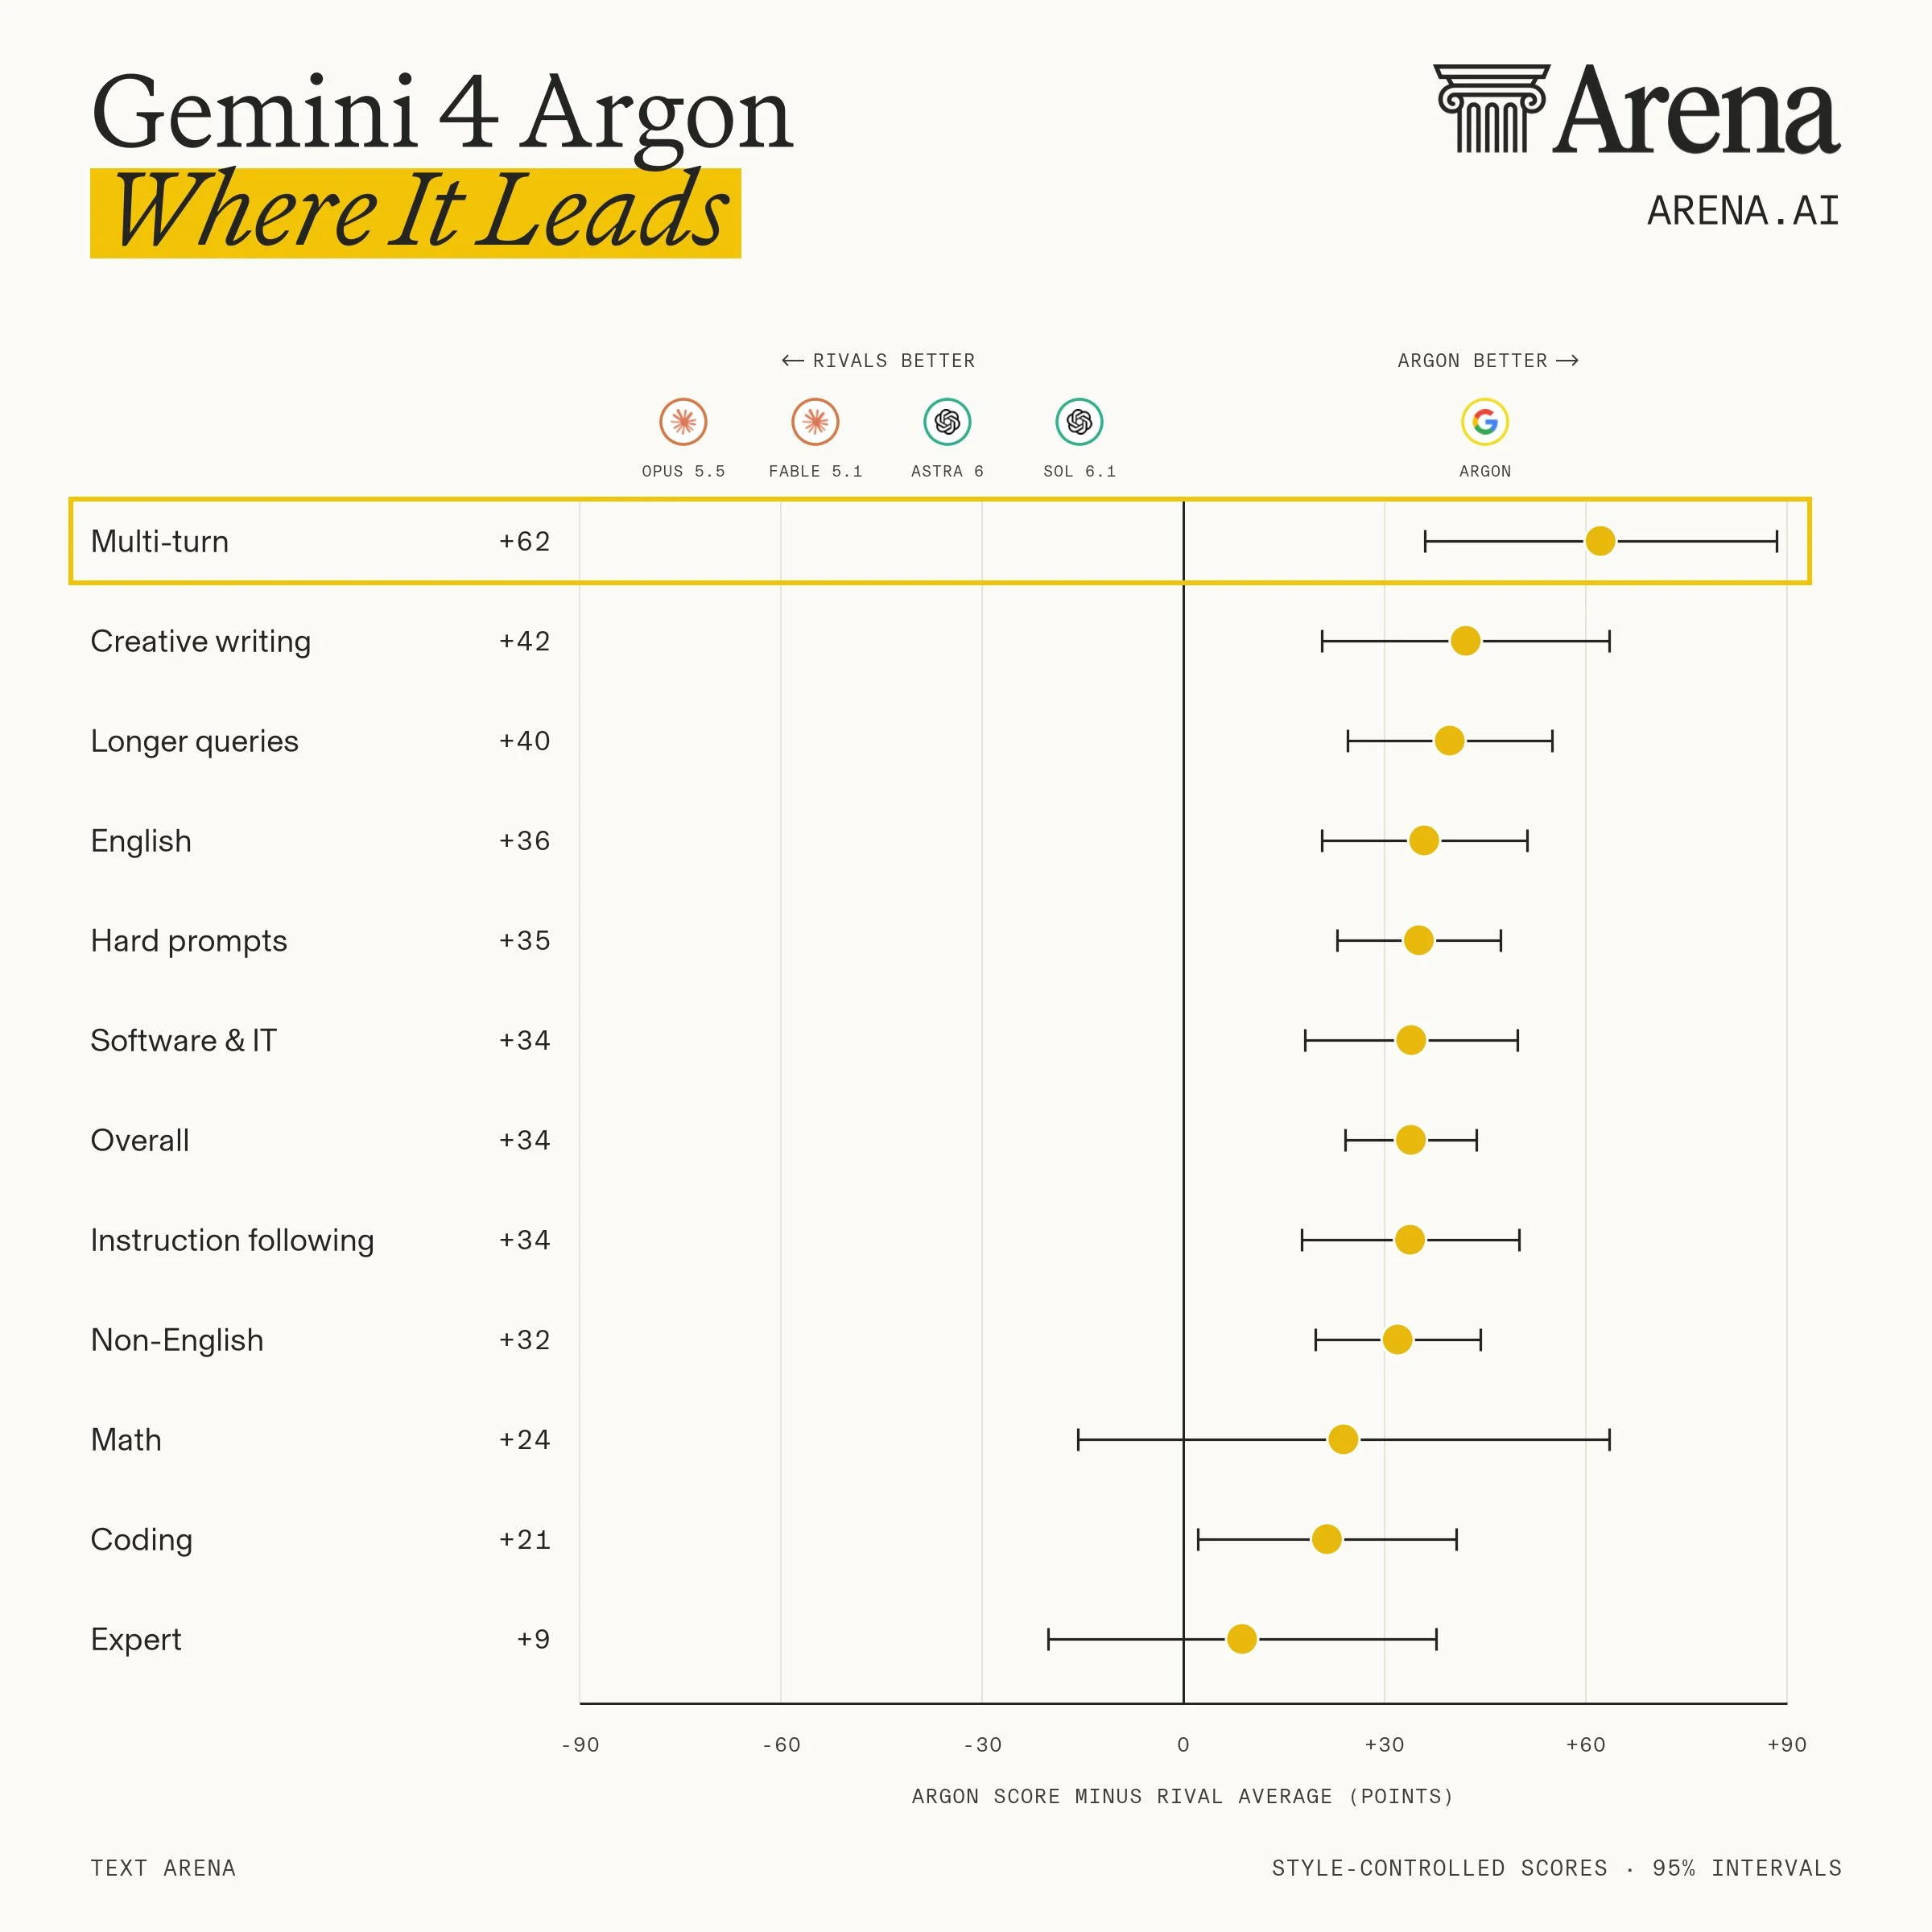
- これらの行動はユーザーの投票に現れます。アルゴンは、複数回のチャット(+62ポイント)、創作文書(+42)、長いクエリ(+40)といった、個性が最も重要なカテゴリーで最も強い優位性を持っています。
- その親しみやすいスタイルの最も明確な手がかりは、感嘆符の使用(Opus 5.5で約3回、GPT-6.1 Solで5回)、ユーザーへの言及(1,000語あたり24回、対して競合モデルは19〜20回)、そして指示文の使用です(回答の56%がそうで、Claudeでは41〜42%、GPTモデルでは22〜23%)。