
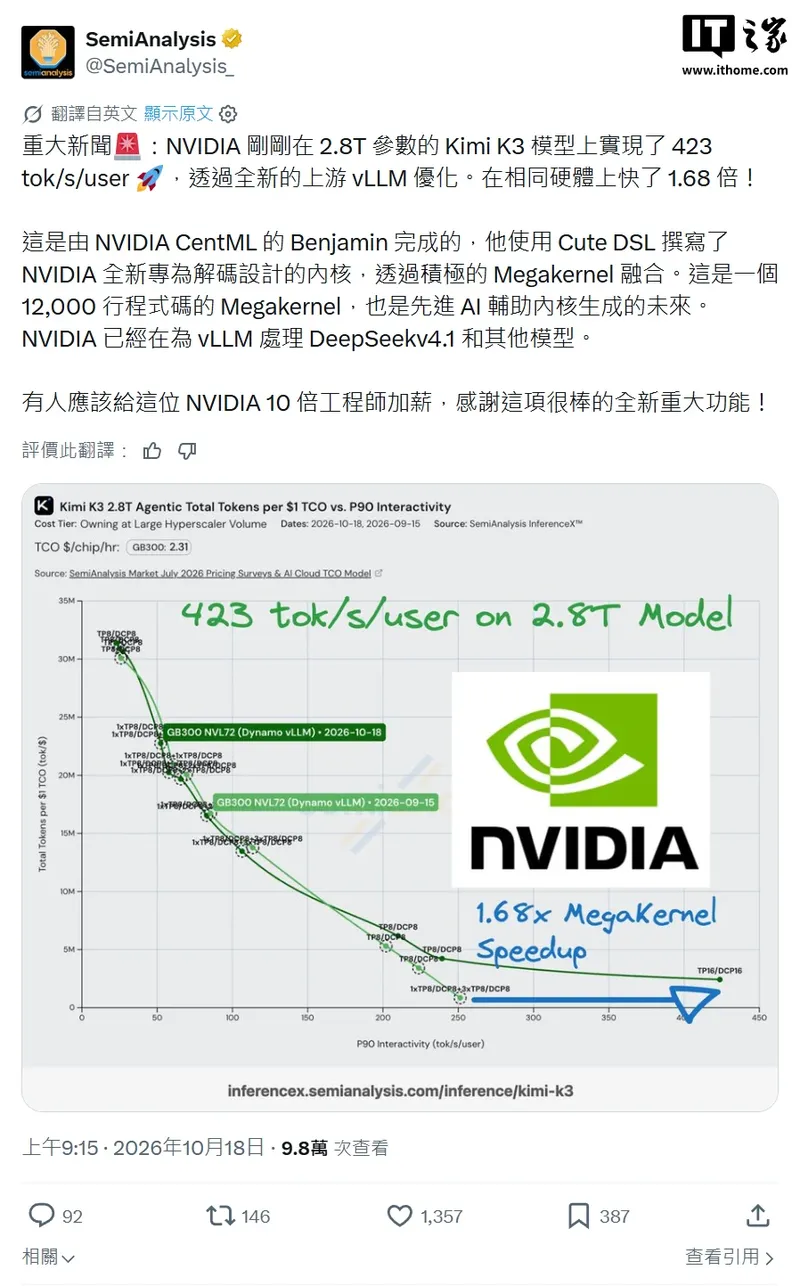
IT之家 10月18日の報道によると、調査機関SemiAnalysisが今日発表したところによると、NVIDIAは上流vLLM最適化を実施することで、2.8兆個のパラメータを持つKimi K3モデルを423 tok/s/user(ユーザーあたり毎秒毎のToken)の推論速度に達したとのことで、同じハードウェア(GB300 NVL72)の性能は1.68倍向上した。
報道によると、この最適化はニューラビアのCentMLエンジニア、ベンバンジムによって行われました。大規模なMegakernelの統合を通じて、Cute DSLを使用してニューラビアが新たに発表したデコーディング専用カーネルを作成しました。このMegakernelには1.2万行のコードが含まれています。これはAIが補助する高度な計算カーネルの未来の方向を示しています。ニューラビアによるKimi K3モデルの推論速度の最適化により、1.68倍の向上が達成されました。
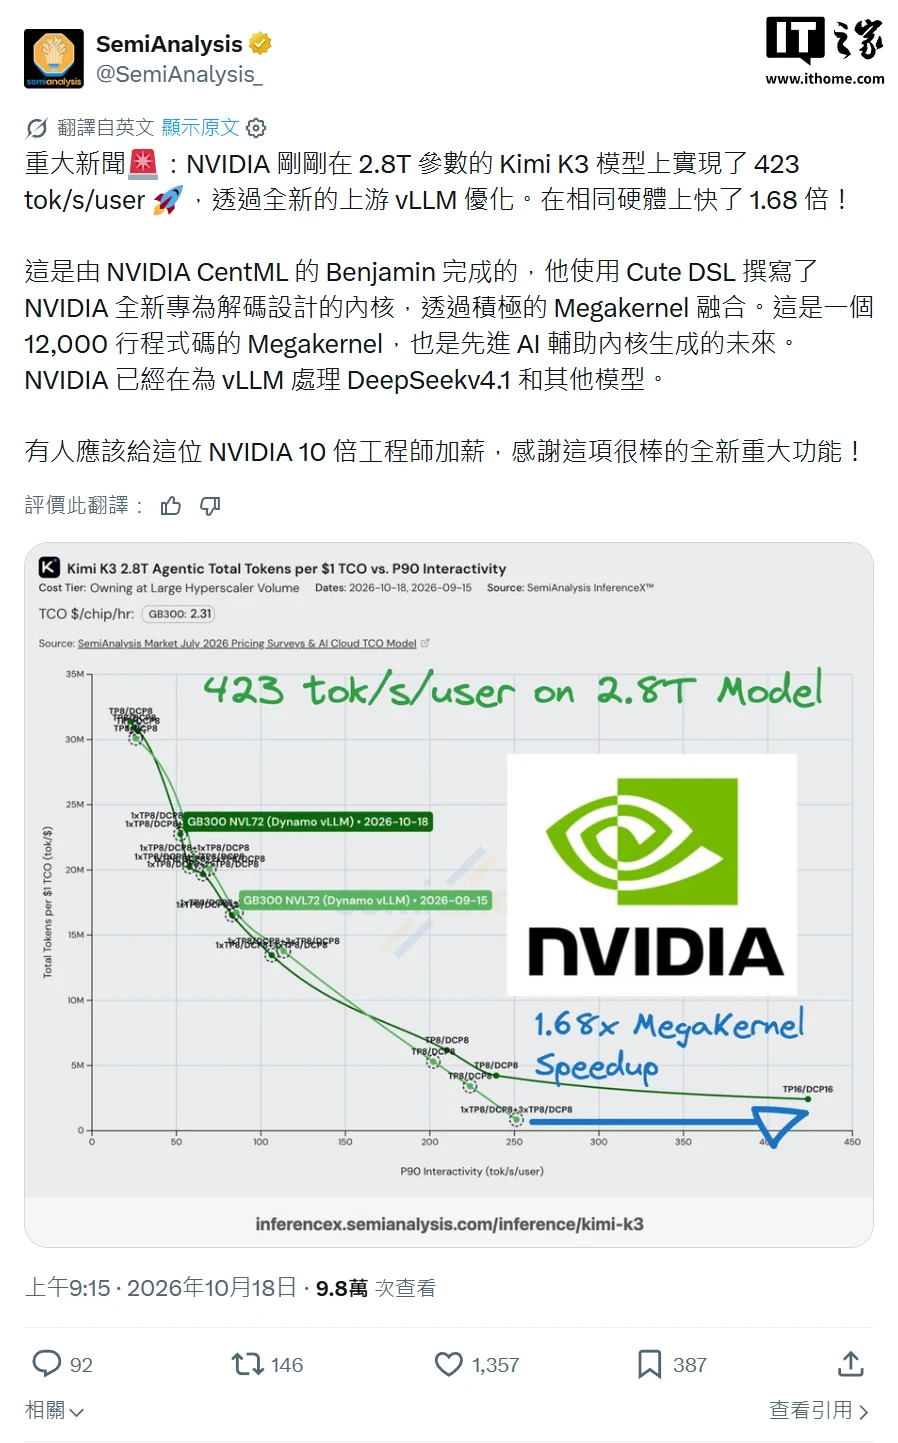
IT之家の観察によると、NVIDIAはこれに加えて、vLLM用のDeepSeek V4.1などの他のモデルの最適化も行っている。