
2026年のAIレースでは、興味深い方向転換が起きている。業界の注目がまだ大規模モデルのパラメータ、エージェント、汎用超知能に集中しているなか、ザッカーバーグはより手強い分野、すなわち生命システムに資金を投じた。
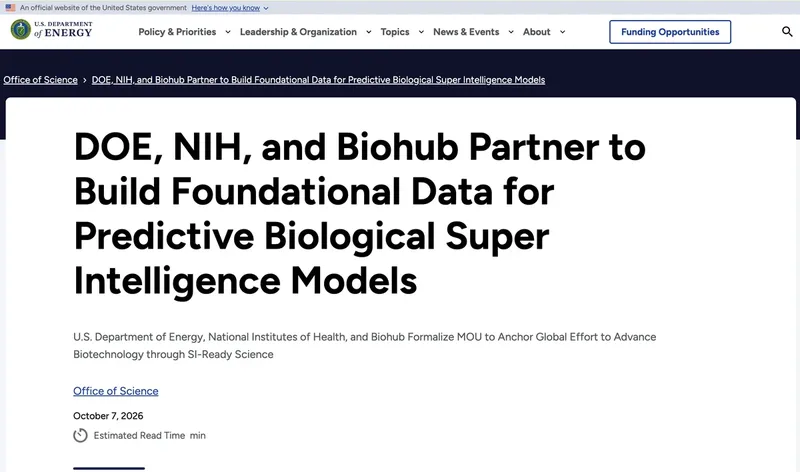
今年4月、ザッカーバーグと妻プリシラ・チャンが設立したBiohubは、仮想生物学プログラムを開始し、生物現象を予測できるAIモデルの訓練に使うため、5億ドルを投入してデータと実験能力を整備した。10月には、このプロジェクトはさらに拡大した。米エネルギー省、米国立衛生研究所(NIH)とBiohubが手を組み、生命予測モデルのデータ基盤を構築するもので、Meta、Google DeepMind、Isomorphic Labsも参加する。プロジェクト全体の約束投入額は合計18億ドルにのぼり、このうち米エネルギー省は今後5年間で5億ドル超を拠出し、NIHは蓄積してきた大量の生物医学データを開放する。
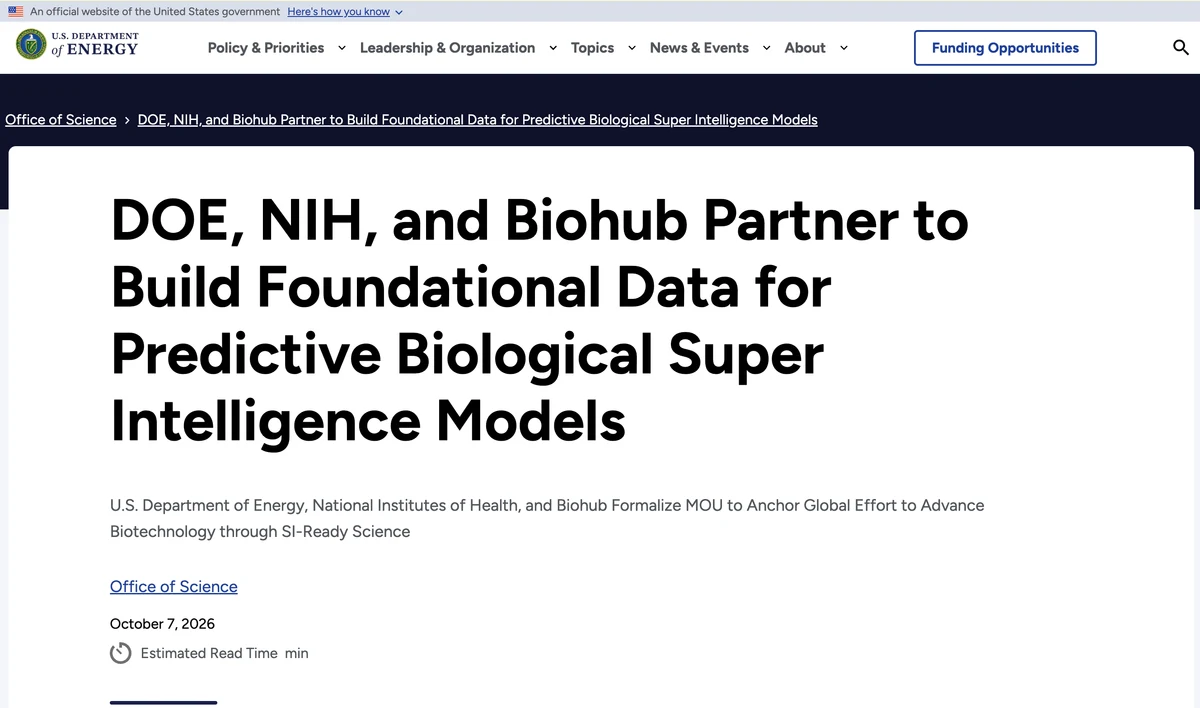
このプロジェクトの目標は非常にシンプルだ。生命の振る舞いを予測できるAIを作ることで、Biohubはこれを仮想生物学と呼んでいる。簡単に言えば、分子、遺伝子、細胞から完全な生命システムに至るまでの高精細なデジタル版を構築するということだ。研究者は将来、今のように大規模モデルに質問するのと同じように、コンピュータ内で生命について仮説を立て、介入をシミュレーションし、まずデジタル実験を終えてから、実験室で実際の実験を行えるようになる。
この取り組みは、ザッカーバーグが単にバイオ医薬品に期待しているだけではない。より深く見れば、生命科学がAI競争の第二の戦場になりつつある。汎用大規模モデルのレースはすでに資金投入が白熱し、計算資源、人材、資本のハードルはますます高くなっている。一方、生命システムの理解は、まだ形が定まっていないフロンティアだ。誰がAIに生命を本当に読み取らせることができれば、チャットボットよりもはるかに模倣困難な参入障壁を築ける。
AIは分子設計が得意だが、新薬開発は依然として困難
AIとバイオ医薬品の結合は目新しいものではなく、AIが産業化への期待を最初に寄せられた方向のひとつでもある。しかし十数年歩んできて、核心的な疑問が常に眼前に横たわっている。私たちは本当に新薬に近づいているのだろうか?
近年のAI創薬で最も目覚ましい成果は、基本的に分子レベルに集中している。タンパク質構造予測、候補分子スクリーニング、分子生成、薬物安全性予測、薬物標的相互作用などである。AIは一度に何千、何万もの候補分子を生み出すことができ、スクリーニング可能な化学空間を大きく広げており、効率向上は確かなものだ。
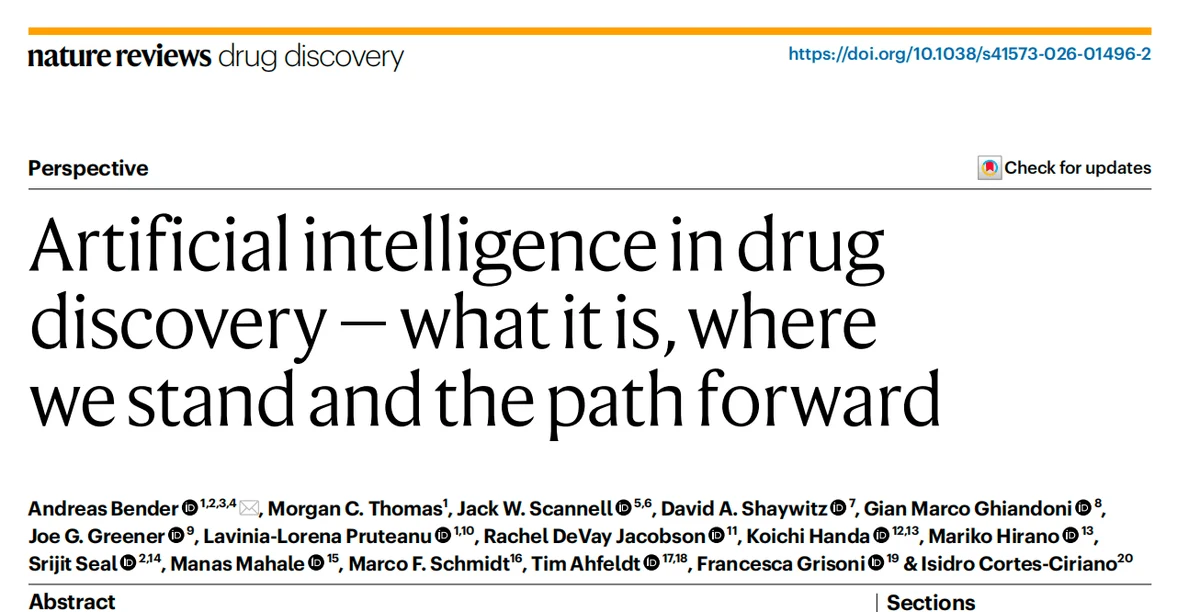
しかし、評価基準をモデルのスコアから、一つの新薬の上市成功に移すと、現実はそれほど楽観できるものではない。今年8月、『Nature Reviews Drug Discovery』が十数年にわたるAI創薬の発展を振り返る論文を発表した。各種のAIアルゴリズムは次々と登場しているものの、臨床的価値を本当に生み出せる成果は依然として限られているという。多くのAI創薬企業のプロジェクトは臨床前あるいは第1相、第2相臨床にとどまっており、第3相臨床に進んだプロジェクトは非常に少ない。
小分子生成の分野では、AIがタンパク質に結合できる分子を見つけやすいのは確かだが、これはあくまでリガンド設計であり、薬物設計ではない。標的に結合できる分子を見つけることと、人体内で安全かつ有効な薬を見つけることは、まったく別の話だ。
これこそ、業界が今最も省察すべき点である。私たちは過去、複雑な生命の問題を単純化してきた。AIは「どの分子がこの標的に結合できるか」という問いに答えるのが得意だが、新薬開発で本当に難しいのは、一連のシステム的な問いである。この標的はなぜ病気を引き起こすのか? 標的に介入した後、人体の生命システム全体にどのような連鎖反応が生じるのか? 同じ薬が、ある人には効き、ある人には効かないのはなぜか? 細胞や動物実験では良い結果が得られたのに、人体の臨床試験では失敗するのはなぜか?
薬物分子は孤立して作用するのではない。それが入り込むのは、遺伝子、タンパク質、細胞、組織、器官、免疫、代謝、さらに外部環境まで、すべての要因が相互に影響し合う動的で複雑なシステムだ。薬が成功できるかどうかは、まさにこのシステムの中に鍵がある。 ここから根本的な問題が生じる。もしAIが分子は理解できても、完全な生命システムを理解できないなら、新薬開発をどこまで進められるのか?
単点の分子モデルから、生命の世界モデルへ
これこそが、2026年のAI生命科学における核心的な変化を説明している。モデリングのスケールが、単一のタンパク質、分子あるいは細胞に限定されなくなり、上方へと延伸して、生命予測モデルの構築が始まっている。目標はもはやタンパク質構造の予測だけではなく、生命状態を記述し、システムが介入を受けた後の変化を予測し、細胞が撹乱に直面したときの反応をシミュレーションすること、すなわち業界で言う生命世界モデル。
である。大規模言語モデルは言語の法則を学び、物理世界モデルは物体の運動と空間の規則を学ぶが、生命世界モデルが向き合う規則ははるかに複雑だ。遺伝子変異がタンパク質発現を変え、タンパク質がシグナル伝達経路を制御し、シグナルが細胞状態を変える。細胞同士の相互作用が組織の微小環境を形成し、層層と上方へ、器官さらには人体に影響を及ぼす。生命そのものは静的なものではなく、成長し、老化し、代償を生じ、突然変異を起こし、外部からの介入に対して継続的にフィードバックする。
したがって、生命世界モデルは静的な生命百科事典ではない。その核心は、生命がどのように機能するかを解明し、ある変数が変更された後、システム全体がその後どう推移するかを予測することにある。
このモデルが実用化されれば、医薬開発におけるAIの位置づけは根本的に変わる。 旧モード:標的を与えられ、候補分子を高速に探索する。 新モード:ある疾患を与えられ、まず発症の根源を解明し、次にどの位置に介入すべきか、どの患者が恩恵を受けられるかを判断し、介入がもたらす全身の連鎖反応を予測する。 同じAIによる新薬支援でも、両モードが解決すべき問題はまったく異なるものになっている。
中国国内でも同時並行で布局:計算医学が国家計画に盛り込まれる
この転換は米国だけのものではない。中国国内のAI生命科学も、単点のアルゴリズムから全身性疾患のモデリングへと移行している。
今年9月、工業情報化部、発展改革委など10部門が『医薬工業発展「十五五」計画』を発表した。計算医学が初めてAI、量子コンピューティング、スーパーコンピューティングと並列に位置づけられ、医薬工業の今後5年間の重点技術方向に組み入れられた。AIとスーパーコンピューティングは強力な汎用計算能力を提供し、計算医学が解決するのは、こうした計算資源を生命システムにつなぎ、実際の疾患問題の解決に用いるにはどうすればよいかという課題である。
国内の哲源科技はまさにこの路線を進むチームだ。同社は単により大きな生物大規模モデルを訓練するのではなく、疾患そのものを中心に、ゲノム、細胞特徴、疾患メカニズム、患者データ、薬物介入情報を統合し、多層的な計算モデルを構築して、持続的な推演、訓練、検証が可能な生命世界モデル体系の構築を試みている。
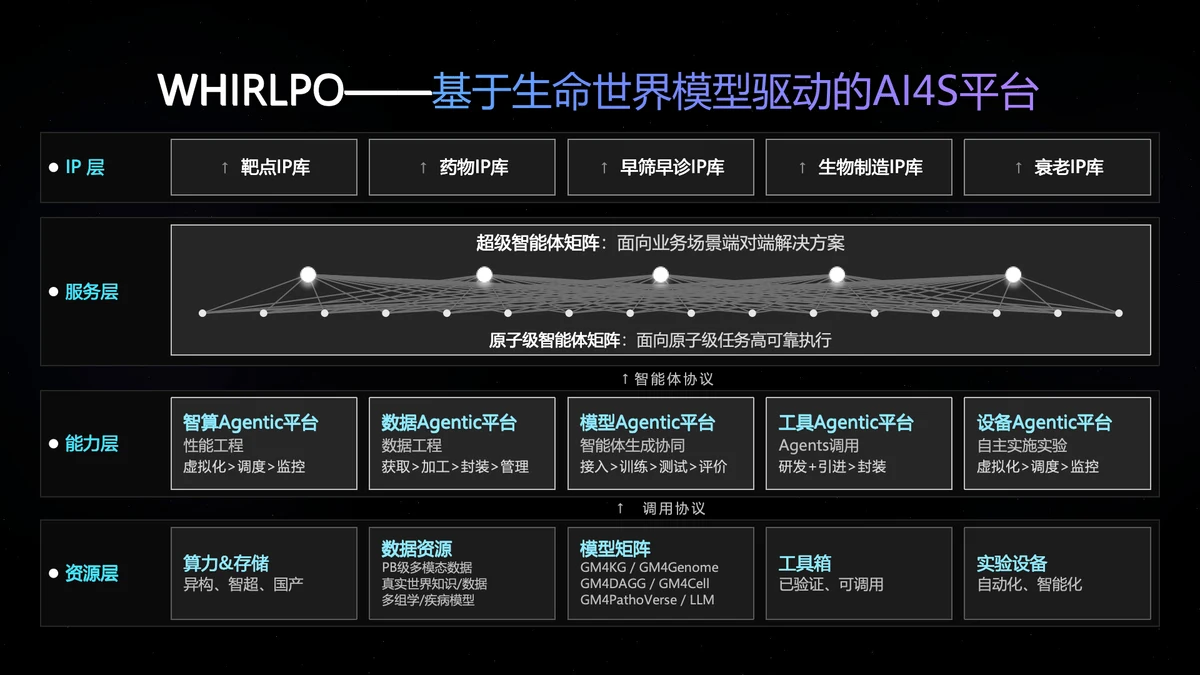
10月17日、哲源科技はWHIRLPO計算医学プラットフォームを発表した。これは独立した生物大規模モデルではなく、より基層的な工学上の難問を解決するものだ。もし生命世界モデルが次世代の生命科学のインフラであるなら、この種のモデルの訓練と運用を支える基盤(底座)が必要になる。
生命世界モデルの構築は、大規模言語モデルの訓練をはるかに超える難しさ
生命世界モデルの実用化の難しさは、 easily見くびられがちだ。 第一はデータの難題である。大規模言語モデルには膨大なインターネットテキストという養分があるが、生命分野には統一されたデータセットがない。ゲノム、単一細胞、空間オミクス、病理、画像、臨床データは供給源が分散しており、フォーマット、品質、観測スケールの差が極めて大きい。多くの高価値データは、専用の実験を行わなければ生み出せない。Biohubが投入する18億ドルの資金の大部分は、モデルの訓練そのものではなく、生物データの生産に使われている。
第二はマルチスケールモデリングの難題である。一つの大一統の生命モデルは存在しない。DNA変異、細胞状態、組織微小環境、人体疾患の研究には、異なるモデルの連携が必要だ。将来の完全な生命世界モデルは、おそらく単一の巨大モデルではなく、複数のモデル、ナレッジベース、ツールが協調して動作する複合システムになるだろう。
第三は異種計算資源の工学上の課題である。モデルの事前訓練、オミクス解析、疾患進化シミュレーション、デジタル患者の推演では、計算方式がそれぞれ異なるため、CPU、GPUなど各種の計算資源を柔軟に调度する必要があり、従来の大規模モデルがほとんど直面しない大規模科学計算の工学問題にぶつかることになる。
第四に、生命モデルは計算世界と実際の実験世界をつなげなければならない。言語モデルの回答が間違っていれば、そのまま再訓練すればよい。しかし、生命モデルが出した標的仮説は、実験室での検証に入れ、実験結果をもとにモデルを修正し、最終的には臨床の検証も受けなければならない。モデルの結論はコンピュータ内で自分勝手に整合しているだけではいけないのである。
WHIRLPO プラットフォームはまさにこの課題に狙いを定めている。異種コンピューティングリソース、多数の学生命データ、モデルマトリクス、研究ツール、インテリジェント Agent、実験検証のワークフローを統合し、モデル訓練から科学計算、ウェットラボでの閉ループ検証に至るインフラを構築する。簡単に言えば、哲源(Zheyuan)はモデルだけを作るのではなく、生命世界モデルのための生産基盤を築いているのだ。
AI 生命科学、インフラ競争の段階へ
2026 年、日米ではなく中国と米国の両地域で業界の共振が起きた。米国では、Biohub がエネルギー省、NIH、Meta、DeepMind と共同で、生命 AI に必要なデータ・計算資源・実験インフラを構築している。中国国内では、計算医学が十五五医薬計画に盛り込まれ、現地チームが生命世界モデルのエンジニアリングプラットフォームの構築を始めている。
一見独立した2つの出来事は、本質的には同じ判断を指し示している。AIライフサイエンスは、モデルの指標を競う段階から、インフラ競争の時代へと移行したという判断である。
これまで業界が競ってきたのは、誰のタンパク質予測がより正確か、誰の分子生成がより優れているか、誰が研究開発の特定の工程を高速化できるかだった。次の段階で競う核心は、大規模かつ高品質なライフサイエンスデータを獲得できるか、遺伝子、細胞、組織、人体という異なるスケールを跨いだモデリングができるか、複数のモデルを協調的にオーケストレーションできるか、モデルを実験との継続的なクローズドループ検証に組み込めるか、そして最終的に、AIがライフデータの処理から生命システムの理解へとアップグレードできるかである。
AI創薬の過去十数年、方向性は間違っていなかった。私たちがこれまで克服してきたのは、生命の問題の中で比較的計算しやすい部分にすぎなかった。分子は確かに重要だが、薬物が治療する対象は分子ではなく人間である。候補分子から人体で効果を発揮するまでの間には、完全で複雑な生命システム一式が横たわっている。
もし生命世界モデルが、言語モデル、物理世界モデルに続くAIの次の核心的方向性となるならば、将来最大のチャンスは、モデルの指標をわずかに更新するチームに属するとは限らない。本当に希少な資産は、また一つのバイオAIモデルではなく、AIが現実の生命世界に踏み出すことを可能にする完全なインフラ一式である。
本記事は哲源科技の提供により、量子位が許可を得て転載したものであり、見解は原著作者に帰属する。