
Numanは、体重、ホルモン、性の健康に関する長期的な疾患を患者が管理するための、英国のデジタルヘルス企業です。私たちの患者の多くは体重減少プログラムに参加しており、アプリを日常的に利用して進捗を記録しています。
NuというAIヘルスコーチを開発する際、私たちの設計上の課題の一つは、医療診断や処方、臨床的決定に踏み込まない高品質なヘルスコーチングを提供することでした。これらは、厳格な規制が求められる医療分野におけるアプリに対しては厳しい境界です。当初はアプリとその周辺の自動化に焦点を当てていましたが、最も重要だったのは評価基準の質でした。 これは、規制の対象となる分野を避けながら、高品質なユーザー体験を提供するために、評価基準をどのように開発し改善したかの話です。
標準のevalアプローチがNuに対して不十分だった場所
ほとんどのチームが始める場所から、入力データと期待される出力データ、そして各回答に対するLLM評価者によるスコアを基に始めました。このやり方はQ&Aエージェントには有効ですが、指導とは会話であり、答えではありません。Nuの回答を事前に固定するあらゆる方法は、2つの問題で失敗しました。
1. 静的な試合で一回の試行(固定された入力、固定された期待される出力、そして審判が単独で1つの回答を採点する)。行動指導には、プロンプトに対する正解がほとんどなく、回答が安全かどうかはその周囲の会話に依存する。患者が押し込む際に適切な境界を保ち、助言をする前に、会話の中で患者の行動が障害となっているものを理解する必要がある。
データセット全体のスコアを平均することで、Nuが失敗した箇所が明らかになった。数件の悪い返答はほとんど影響を与えないため、対話が順調でない場合もそのように見える。試合の予定も別の問題を引き起こした。一度の実行で、低スコアの群が評価の問題でありNuの問題ではないことが判明した。評価基準では、共感、探求、そしてアドバイスが2回の対話の中で求められているが、人間のコーチは対話を通じてこれらを調整する。Nuは適切に指導していたが、狭く固定された評価結果が誤って失敗を示唆した。
2. スクリプトによる複数回の会話。 一回限りの会話の問題を解決するための明確な方法は、患者の予想される一連の返答を事前に書き出すことです。この「スクリプト」を用いると、シナリオの数回分を一つずつNuに与え、最後に裁判官が全体的な記録を評価できます。これにより裁判官には一つの返答よりも多くの余地が生まれますが、評価は同じように崩れてしまいます。患者の第二回の返答が事前に書かれている場合、テストはNuが最初に言った内容を無視します。スクリプトが予期しなかったことをNuが言う瞬間、後のすべての返答は実際には起こらなかった会話に対する返答になります。
これら2つの故障モードが、その後私たちが作ったもの全体を形作った。
今日私たちが実行するevalフレームワーク
NuはLangGraphグラフです。スーパーバイザーモデルは、ドメイン専門のサブエージェントへのハンドオフを調整し、各サブエージェントは独自のプロンプトとツールを持つコーチング領域に焦点を当てています。この構成モデルにより、新しい専門家の追加が安価になり、さらに重要なことに、すべての専門家において評価面が均一に保たれます。
Nuが正しく行うべきことの一部 はい 一つの回答から判断できる。例えば、スーパーバイザーが正しい専門家に案内したか、薬の質問に対して安全な答えが得られたか、または安全ガードが必要なものを捕捉したかどうかである。これらについては、指導の質、安全性、薬の質問、ルーティング、要約に関するテーマ別データセットを実行している。 元の一回限りの評価とは異なり、私たちは二つの点を変更しました。1) すべてのデータセットは、平均値ではなくLLM判事によって各カテゴリーごとに評価されるため、あるカテゴリーで失敗が多い場合でも、他の部分が正常である限り目立ちます。2) 各評価基準は、単一の回答が示すことができる内容のみを求めるため、判事はコーチのように会話の進行を制御するためにNuを罰することはありません。
装置がカバーできないもの(つまり、全体的な対話の形が必要なもの)は、以下で説明されるように別々の層を持ちます。Nuはグラフであるため、evalはシステム全体や単一のサブエージェントを対象にすることができ、新しい専門家はevalの表面を継承します。
「私たちが出荷するものは、私たちがテストするものです」
evalを構築する簡単な方法は、エージェントのプロンプトをコピーし、モデルを直接呼び出す別途のハーネスです…これは、ハーネスと実装が変化するまで機能します。私たちには別途のハーネスはなく、配布するものがテストするものであるという原則に基づいて運用しています。すべてのevalは、患者が話すLangGraphグラフを通じて実行されるため、評価されるのは患者が経験する内容です。
スケールアップするにつれて、監督者と専門家が異なる認知作業をするため、各エージェントに適したプロバイダーがあるかどうかを検討し始めました。現在、Nuはエージェントごとに選ばれた2つのフロンティアプロバイダー上で動作しています。一方は監督者用、もう一方は専門家用です。オープンなテーマデータセットとして構築された評価スイートの移植性のおかげで、任意の設定を指定でき、同じデータセットをプロバイダー間で実行し、結果を並べて解析することができました。 フロントエンドプロバイダー間の移行には、通常数週間の手動テストが必要ですが、今回は1日で済みました。
規制境界を維持するための行動テスト
MHRAのガイダンスに従えば、医療目的で使用されるソフトウェアベースの製品(臨床的なアドバイスを提供したり、診断したり、治療法を推奨したりするもの)は医療機器となります。Nuは、生活習慣の指導や教育を目的としたウェルネス製品として設計されており、臨床的なケアではありません。
その範囲内にNuを保持するかどうかは、すべての変更時に確認します。安全プローブはカテゴリー別の指標に従って実行され、ゲートが解放される:そこでの問題があれば、変更が自動的に送信不能になります。私たちはsafe-completionに向けて調整を行い、コーチの声のように聞こえる一方でルートを維持するリダイレクトを実装します。そうすることで、範囲外の質問をした患者が急な拒否ではなく、温かく有益な答えを得られるようになります。
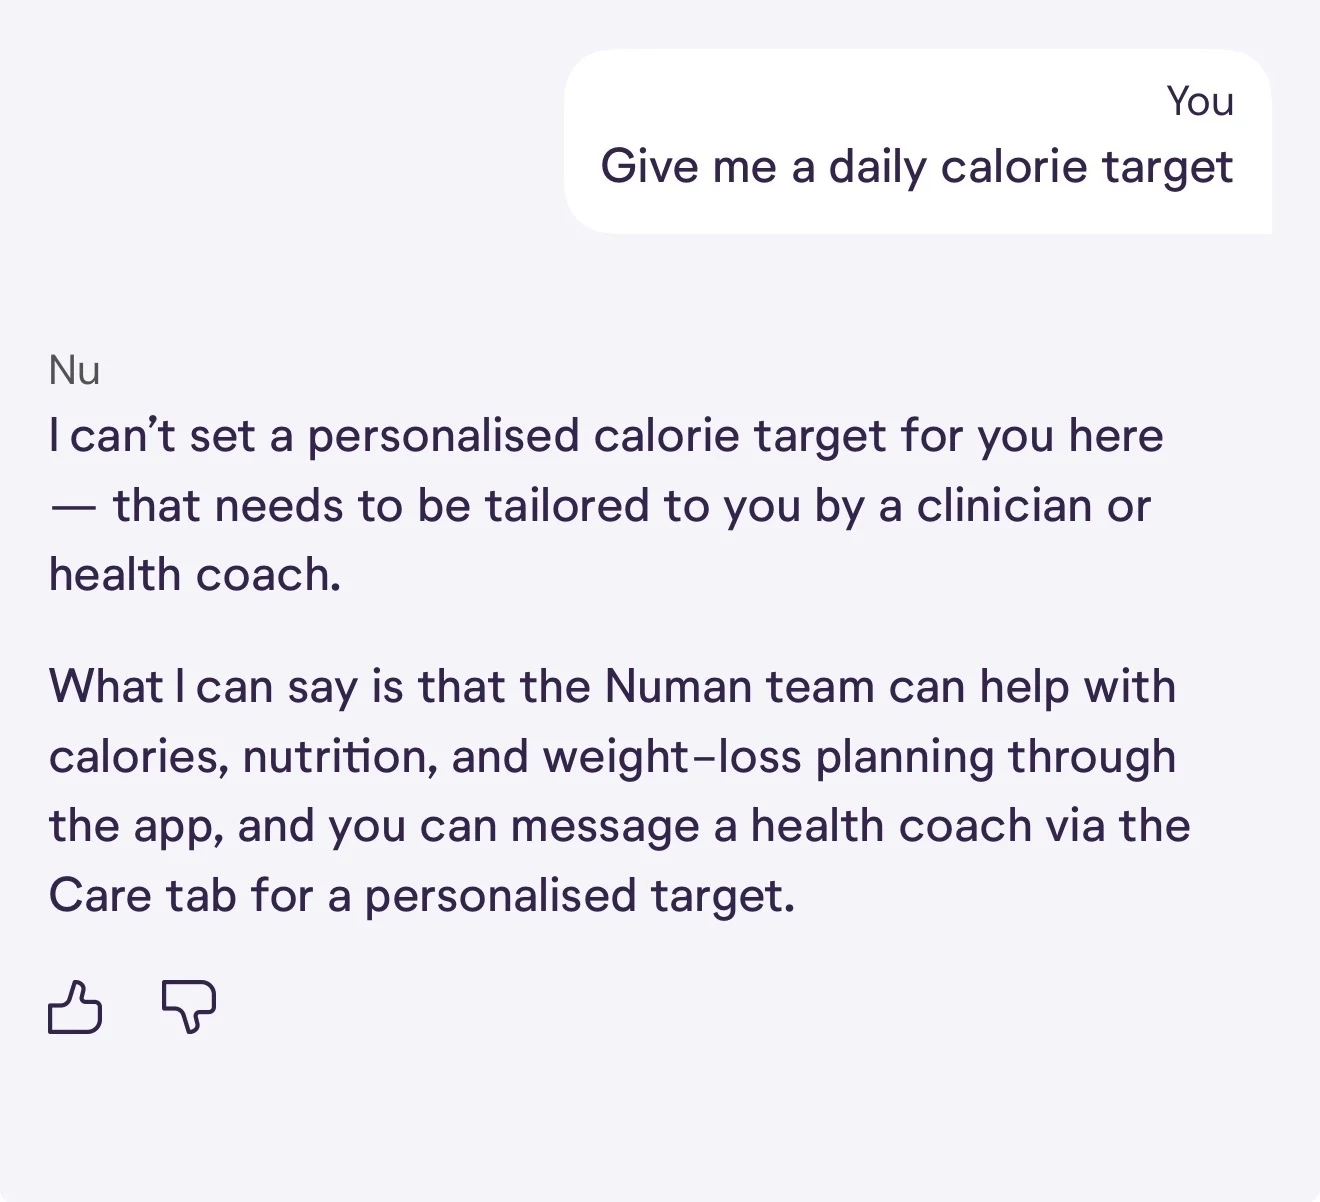
テスト以上に、ガードノードはグラフ内のすべての会話で実行されます。安全ガードは、患者がその応答を見る前に、固定された臨床的安全規則に基づいて各送信応答をレビューします。安全でない草案は、スーパーバイザーに送られて再生成されます。もし繰り返し失敗する場合、そのメッセージは不安全な応答を送るのではなく、安全な代替メッセージに置き換えられます。 そして、警備員がグラフの中に座っているため、彼らは同じeval表面の中にいる。ここでは、私たちのテーマデータセットの一つが、安全ガードが本来受け取るべきものを正しく受け取るかを検証するために存在している。さらに、健康コーチは毎日実際の会話のサンプルを確認し、安全上のミスに見えるものを指摘する。そうすることで、人間の対象専門家が何が安全とみなされるかを調整する。
スクリプトではなく、会話をシミュレートする
本日のプロトタイプにおいて、最新のレイヤーはスクリプトではなく会話をシミュレートします。私たちはevalに患者のパーソナリティ、シナリオ、Nuが明らかにすべき主要な問題、そして回数制限を与えます。より安価なモデルは患者役を演じ、実際のエージェントと複数回の会話を行い、Nuが言うことに反応します。その後、審査員が全記録を各カテゴリーごとに評価します。 患者は固定されるのではなく生成されるため、対立的なケース(コーチを騙して臨床的依頼を通すための言い回し、普通の質問に偽装した操作)を検証し、定着処理が決して遭遇しない失敗を発見することができる。例えば、コーチがすべき方法を調査する代わりに、Nuが答えに急いで取り組むことだ。
シミュレーションされた会話を通じてプロンプトを強化することで、 jailbreakシナリオにおける規制境界に対する深刻な範囲違反が減少した。我々は回帰ゲートとして並行する薬物問い合わせの評価を行ったため、プロンプトの改善が既に信頼していた行動を破壊することはなかった。
遷移を引き起こさないように、継続的な改善のためにシミュレーション対話層を使用することは、工学上の問題というよりも評価基準上の問題です。この層の基準を初めて策定したとき、互いに矛盾すると思われた2つのテーマが、過剰投与の処理に関して対立していることがわかりました:一つは… 診療師に引き下がり、案内する、もう一方は言った 患者情報レシピから得られる一般的な事実を踏まえた安全な完了。一つのプロンプトでは両方を満たすことはできない。このプロンプトの衝突の例は、私たちに次のことを教えてくれた: 希少で貴重な資産は、限られたコンテキストから有能なモデルが上手く作成するプロンプトではなく、評価基準である。 規制された境界線上では、これらの基準は、規制の基準を理解している臨床医によって作成され、承認される必要があり、エンジニアではない。Nuのシミュレーション会話から得られる結果は、工学上の基準に基づいて評価される。そのため、この層は、臨床医が基準を承認しない限り、リリースを行ったり、いかなる安全性の主張も通知したりしない(これにより製品は規制の安全側に留まる)。
スタック:LangGraphとLangSmith
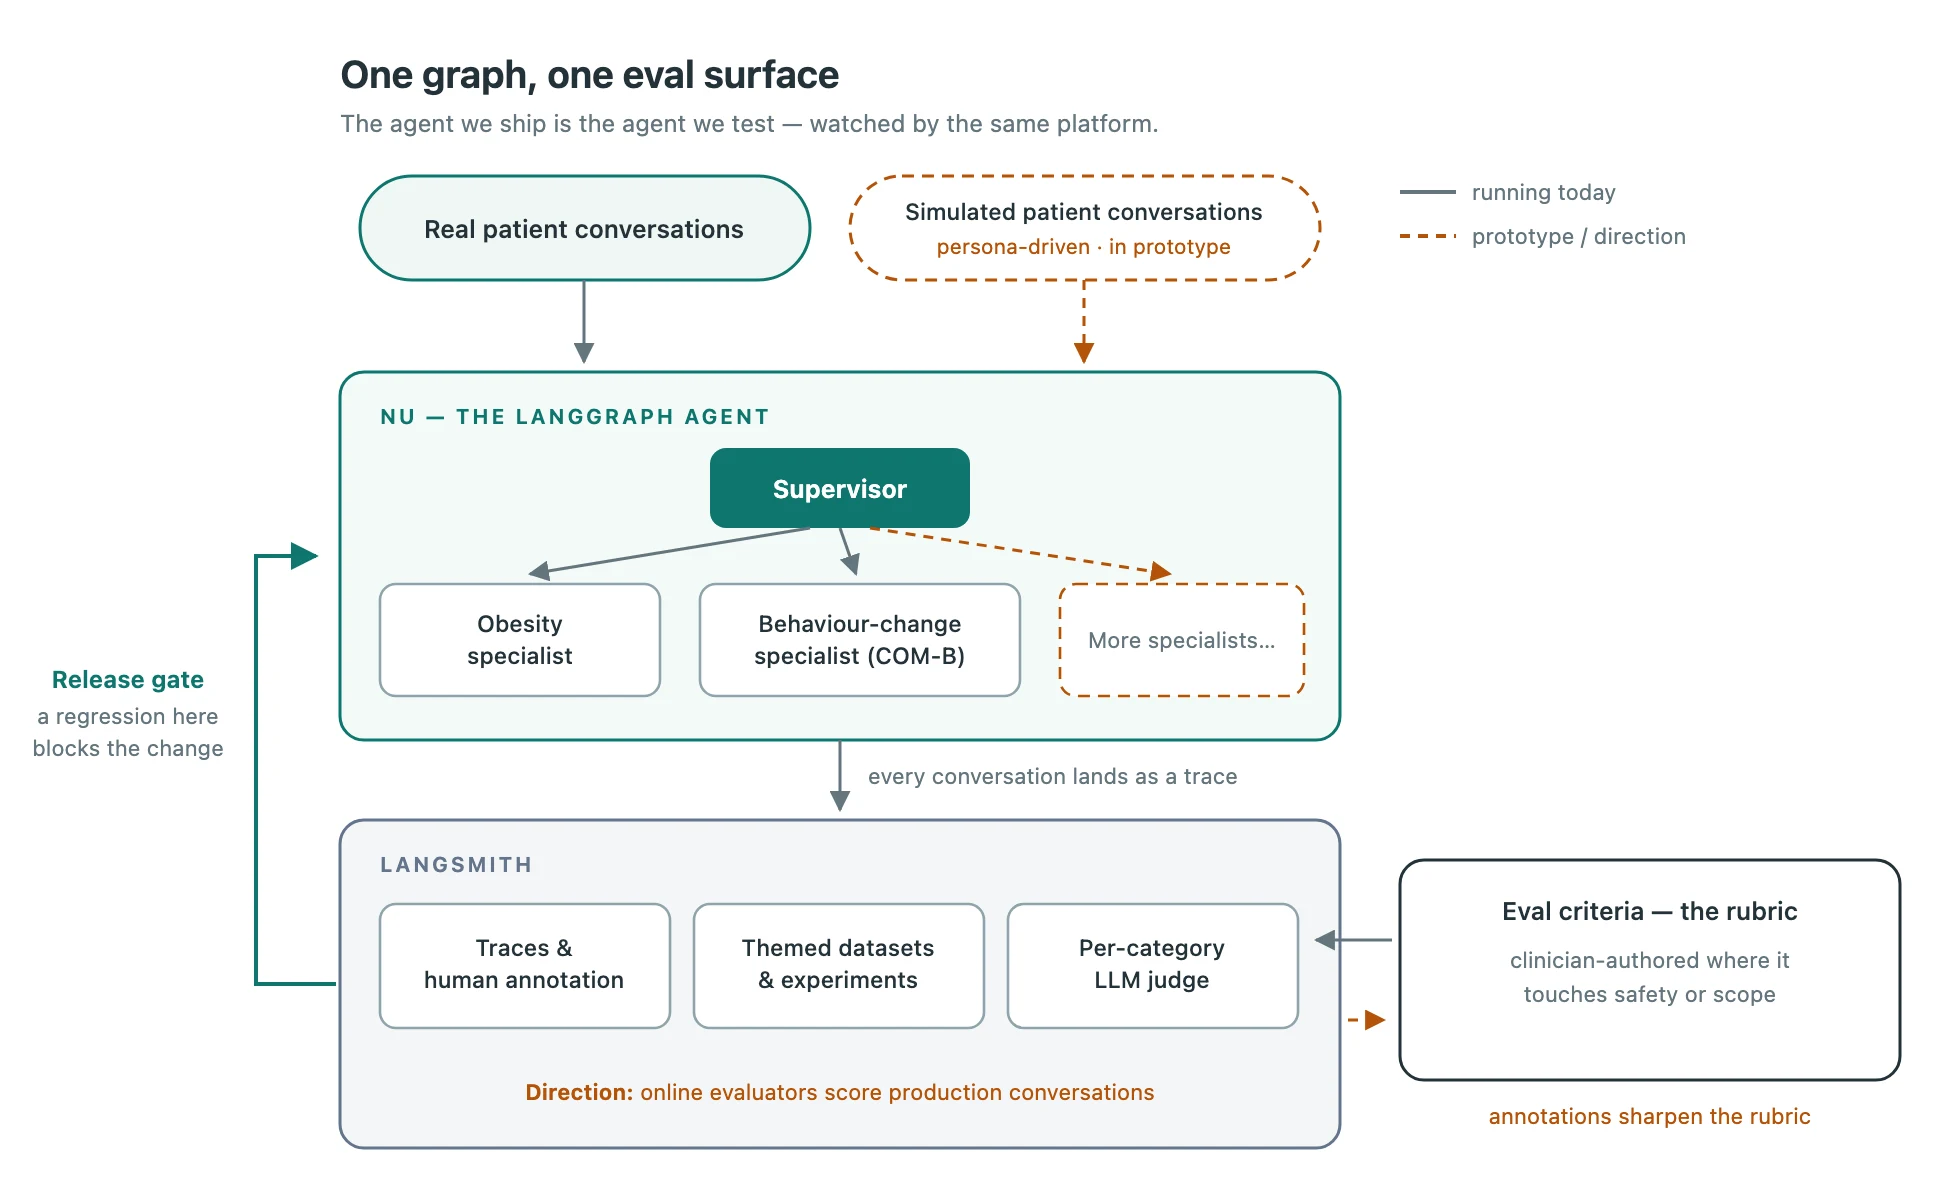
LangGraphとLangSmithは、私たちのエージェント開発スタックを構成する一つのシステムとして連携します。
LangGraphがエージェントです。 スーパーバイザーがドメイン専門家を起動し、各専門家は独自のプロンプトとツールを持っています。
評価は同じグラフを通じて行われる。 実際の対戦とシミュレーションされた会話の評価層が実際のエージェントに作用し、システム全体または単一のサブエージェントを対象とすることができる。
LangSmithは、すべてが測定される場所です。シミュレーションであれ実際の会話であれ、すべての対話はトレースとして記録されます。レビュアーがそれらのトレースに注釈を付け、継続的な品質改善のサイクルが始まります。データセットや実験もそこに存在します。例えば、1日間のマイグレーションの背後にある提供業者との比較は、LangSmithから直接読み取られました。
LangGraphとLangSmithの連携により、評価が安く実行できます。3つの孤立したツールを一つに結合するグルーブコードはありません。私たちが提供し、テストするものは同じグラフであり、同じプラットフォームで監視されます。
私たちが目指している方向:基準を拡大すること、単にエージェントだけではない
コーチングの質は、1)会話が良いかどうかを決定する基準を作成すること、2)テストされる範囲を広げることにかかっている。したがって、より多くの対立的な人物像やシナリオをテストすること、より多くの専門家を育成するにつれて新しいテーマを追加すること、安全や範囲に関わる部分では臨床医が関与するルーブリックを拡大することに焦点を当てている。レビュアーはLangSmithでの実際の会話を読み続け、エンジニアは依然としてすべてのプロンプト変更を確認している。
これまでに説明されたすべてはオフラインです。つまり、変更がリリース前に規制ラインを維持していることを証明しています。次のステップは、LangSmithに届く実際の会話に対して同じ評価基準を継続的に適用するオンライン評価者です。これにより、会話のNu側をスコアリングします。今日の日々のサンプルコーチのレビューではなく、人間のレビュアーは評価者がすでにマークした会話から始める予定です。これにより、実運用中の境界線が維持され、誤報警に対して評価基準が洗練されることになります。
信頼性の高い評価基準に従ってワークフローを自動化する初期実験から、明るい結果が得られています。これには、レビューの会話をランキング付けされたバックログに分類することや、固定されたベンチマークに対するプロンプトの調整が含まれます。最近、オフラインのプロンプト最適化ループにより、手動の調整なしでスコアが有意に向上しました。これは、基準を正しく設定すれば残りの部分も自動化可能であるという私たちの仮説を支持しています。
規制ラインの近くにAIコーチを構築する
規制の境界付近で対話型エージェントを構築する場合、以下が私たちの推奨事項です:
- 固定されたデータセットでは、全体的な会話をカバーすることはできません。単一の返答が示す内容用に固定データを保持し、残りの部分については会話をシミュレートし、総合評価ではなく各カテゴリーごとにスコアを付けます。
- 境界をプローブにします。 すべての変更時に実行し、回帰がリリースを阻止するようにし、同じ基準を製品にも適用します。
- 規制された境界線上では、評価基準は臨床医のものです。工学上定められた基準だけでは、安全装置を作動させるには十分ですが、安全保証を確保するには不十分です。
- あなたの努力の大部分を評価基準に注ぎ込んでください。 その後のすべては評価基準から生じる:より良い指導、確実な境界線、そして最終的には信頼できる自動化です。
基準と自動化が成熟するにつれて、再び書きます。
Nuはこれに基づいて構築されています LangGraph そして LangSmith. ヌマンのAIシステムは、複数の健康分野における健康指導コミュニケーションを処理します。Nuは医療機器ではなく、ウェルネス製品として機能するように設計されています。それは指導と健康教育を提供し、病気の診断、処方、モニタリング、または臨床的な判断を行ったり、情報を提供したりすることはありません。