
vLLMは、大規模言語モデル(LLM)のオープンソースの推論・サービスエンジンです。LLMの推論には2つの異なる段階があります。1つは入力プロンプトを処理しキーと値のキャッシュを構築する「プリフィル」であり、もう1つはそのキャッシュを利用して一つずつトークンを生成する「デコード」です。これらの段階には、計算資源、メモリ、スケーリング特性が異なります。プリフィル-デコード(P-D)分散処理では、これらを別々のエンジンインスタンスで実行することで、各段階が独立してスケールされ、最適化されるようになります。これにより、負荷下でのリソース利用効率、スループット、遅延が改善されます。しかしながら、トークン生成が始まる前にキーと値のキャッシュをプリフィルインスタンスからデコードインスタンスに移動する必要があり、効率的なキャッシュの移動が「最初のトークン到達時間(TTFT)」に重要となります。
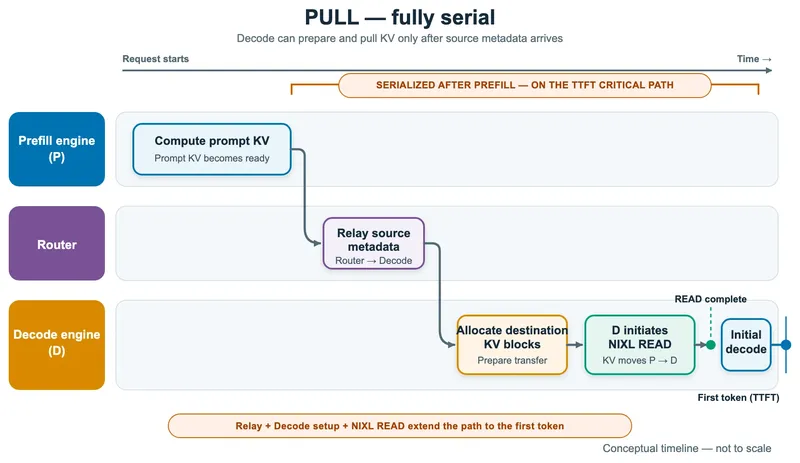
vLLMがこの転送を行う方法の一つは、NVIDIA Inference Xfer Library(NIXL)connectorを通じてである。このconnectorは、AWS Elastic Fabric Adapter (AWS EFA、AWS内のサーバー間で使用される低遅延RDMAネットワーク)のようなRemote Direct Memory Access(RDMA)をサポートするインターネットを介してKVブロックを移動させる。サポートされているインスタンスタイプにおいて、AWS EFAはGPUDirect RDMAおよびNeuron Direct RDMAをサポートする。したがって、NIXLはホストメモリを中継することなく、GPUまたはAWS Trainiumデバイスのメモリ間でKVブロックを直接転送することができる。NIXL connectorのデフォルトモードはpull-basedである:PrefillインスタンスがプロンプトKVキャッシュを計算する後、ルーターはprefillブロックIDを含むソースメタデータをデコードインスタンスに伝達する。その後、デコードインスタンスは宛先ブロックを割り当て、NIXL転送を準備し、PrefillインスタンスからKVブロックを引き出すNIXL READを開始する。これらの調整と設定ステップがPrefillの後、デコードが始まる前に順次行われるため、以下のタイムラインに示されるように、TTFTのクリティカルパスが延長される。
図1:プルモードKV転送タイムラインで、ルーター中継、デコーディング側の割当、およびNIXL READが最初のトークンへのパス上で順次実行される
この記事では、プッシュベースのNIXLコネクタについて紹介しています。これにより、事前充填後の転送調整と設定が重要なパスから外れるようになります。vLLMを使用して分割された事前充填/デコード推論を行う場合、プッシュモードはTTFTとTPOTを減少させることで、特に高いリクエストレートでアプリケーションの応答性を向上させることができます。
Amazon Elastic Compute Cloud(Amazon EC2)のP5enインスタンスをEFAで接続した1P1D展開によるベンチマークでは、Qwen3-32Bモデルにおいて、プルモードと比べてTTFTが最大3倍、時間あたり出力トークン数(TPOT)が最大30%向上しました(性能データセクションを参照)。結果はワークロードと設定に依存します。
EFAを利用して接続されたAWS Trainiumインスタンスクラスター上でこの機能を構築し、検証した後、vLLMにアクセラレーターに依存しない機能として提供しました。ここでの結果は、EFAを使用したAmazon EC2 P5en(GPU)クラスターから得られたもので、その効果がGPUにも及ぶことが示されています。この記事では、プッシュベースのアーキテクチャ、転送フロー、スレッドモデル、性能結果、およびベンチマークを再現する方法について説明しています。
プッシュベースのKV転送
このセクションでは、プッシュベースの設計について説明します。そのアーキテクチャ、転送プロトコル、そしてKV転送を重要なパスから外すためのスレッドモデルについても述べています。
アーキテクチャの概要
プッシュベースの転送は、2つの理由でTTFTとデコードスループットを向上させる。
- それは、プロデューサーとコンシューマの作業を重ね合わせることで、pullモデルのシリアルライズ化を解除する。デコードインスタンスは、プロデューサーがKVを計算している間に、事前にそのターゲットブロックを登録する。そして、プロデューサーのブロックが準備されるとすぐに転送が開始され、コンシューマ側のID発見の往復が必要なくなる。これにより、最初のトークンへの道筋からその往復がなくなる。
- それにより、転送設定時間がデコードインスタンスから外れる。その設定は事前入力の側面とバックグラウンドスレッドで実行される。NIXL記述子を準備し、転送を送信するため、デコードインスタンスは遅延が重要なトークン生成段階でその時間を費やすことがない。
効果としては、TTFTが低くなり、デコードインスタンスでの出力トークンスループットが高くなる。
プッシュコネクタは3つの要素を管理する。デコードインスタンスは目標ブロックを事前に登録し、プレフィルインスタンスは各リクエストに対応して転送を行い、専用のバックグラウンドスレッドがエンジンのフォワードパスループからKVの書き込みを行う。以下の図は、これらの要素がどのように連携しているかを示している。
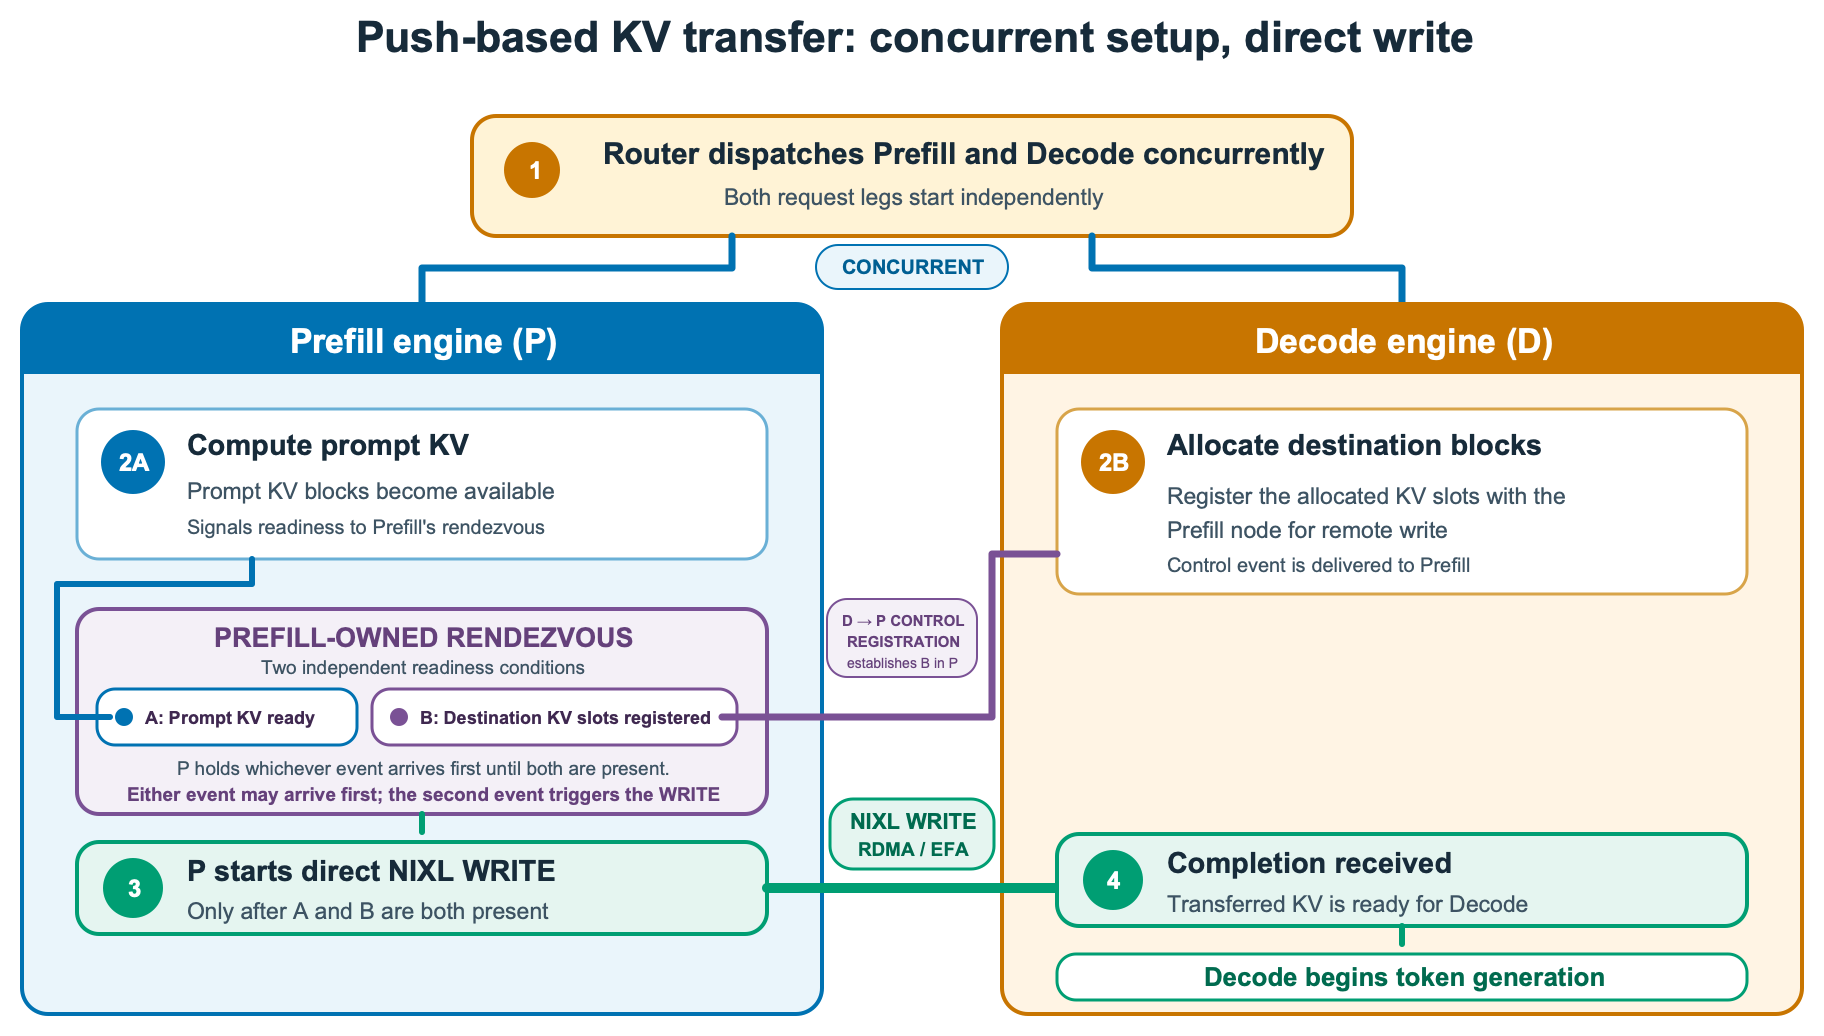
図2:プッシュベースのKV転送アーキテクチャ。デコードインスタンス、プレフィルインスタンス、およびバックグラウンド転送スレッドがどのように連携するかを示している
実装詳細
プロトコルには3つの論理的なステップがあります。
1. 登録(デコード側)。 リモートのプリフルが必要な要求に対して、デコードインスタンスがローカルブロックを割り当てるとき、プリフルインスタンスがKVを書き込むべき場所、つまり自身の識別情報と割り当てられたブロックの位置を記述した登録情報を準備する。同じエンジンステップ内で、ワーカーはこの登録情報をNIXL通知としてプリフルインスタンスに送信する。登録が割り当て時刻に行われるため、コネクタはプリフルインスタンスがプリフルを完了する前に、宛先ブロックを知っている。
2. Rendezvous(プレフィル側) デコーダからの登録とプロデューサー上でのプレフィル完了は、どちらか一方の順序で到達することがあり、コネクタが両方を処理します。登録が先に到達した場合、プロデューサーは自身のプレフィルが完了するまでそれを保持します。プレフィルが先に完了した場合、プロデューサーは登録が到達するまでリクエストのブロックを保持します。どちらかのイベントが後になりますが、その時が転送を引き起こします。コネクタはIDによってリクエストをペアリングし、一致したアカウントは再発行されたリクエストを正しく対応させ、先取りされたり再試行されたりしたリクエストも関連付けます。
3. 転送(プレフィル側)。リクエストがマッチすると、プロデューサーはデコーダインスタンスと接続を確立し(既に存在しない場合)、NIXL WRITEを発行してKVブロックを直接デコーダの登録されたメモリにコピーする。各宛先のテンソル並列ランにアドレスを付与する。プロデューサーと消費者は異なる内部ブロックレイアウトを使用することがある。転送時には、各側がブロックの位置を自身の物理的なレイアウトにマッピングし、両側で異なるブロックサイズが可能になる。各WRITEには完了通知が含まれ、データが到着した際にNIXLがデコーダインスタンスに送信する。デコーダは、各プロデューサーランが書き込むごとに1つずつの通知をカウントし、期待されるすべての通知が届いた後にのみKVを受け取る。その時点でリクエストはデコードへ進む。
スレッドモデル
プッシュコネクタは、各プレフィルワーカー上に専用のバックグラウンド転送スレッドを使用することで、モデルの実行とKV転送の準備を分離します。リクエストの開始時に、デコードメインループは宛先KVブロックを割り当て、プレフィルインスタンスに登録します。同時に、プレフィルメインループがプロンプトKVキャッシュを計算します。 目的地登録とプロンプトKVが準備された後、プレフィル主ループはKVブロックをバックグラウンドスレッドに渡し、すぐにモデルの実行に戻ります。
背景スレッドはNIXL接続を確立するか再利用し、リクエストのKVブロックIDをメモリ記述子にマップし、連続するブロックをより大きな転送領域に統合し、NIXL WRITEをデコードインスタンスに送信します。NIXLが転送を完了すると、デコードインスタンスに完了通知を送信し、その後トークン生成が開始されます。 記述情報の準備と転送の提出を、遅延が重要なメインループから外すことで、リクエストごとの作業がモデルの実行を遅らないようにする。以下の図は、1つのリクエストに関するメインループとバックグラウンドスレッドのハンドオフを示している。
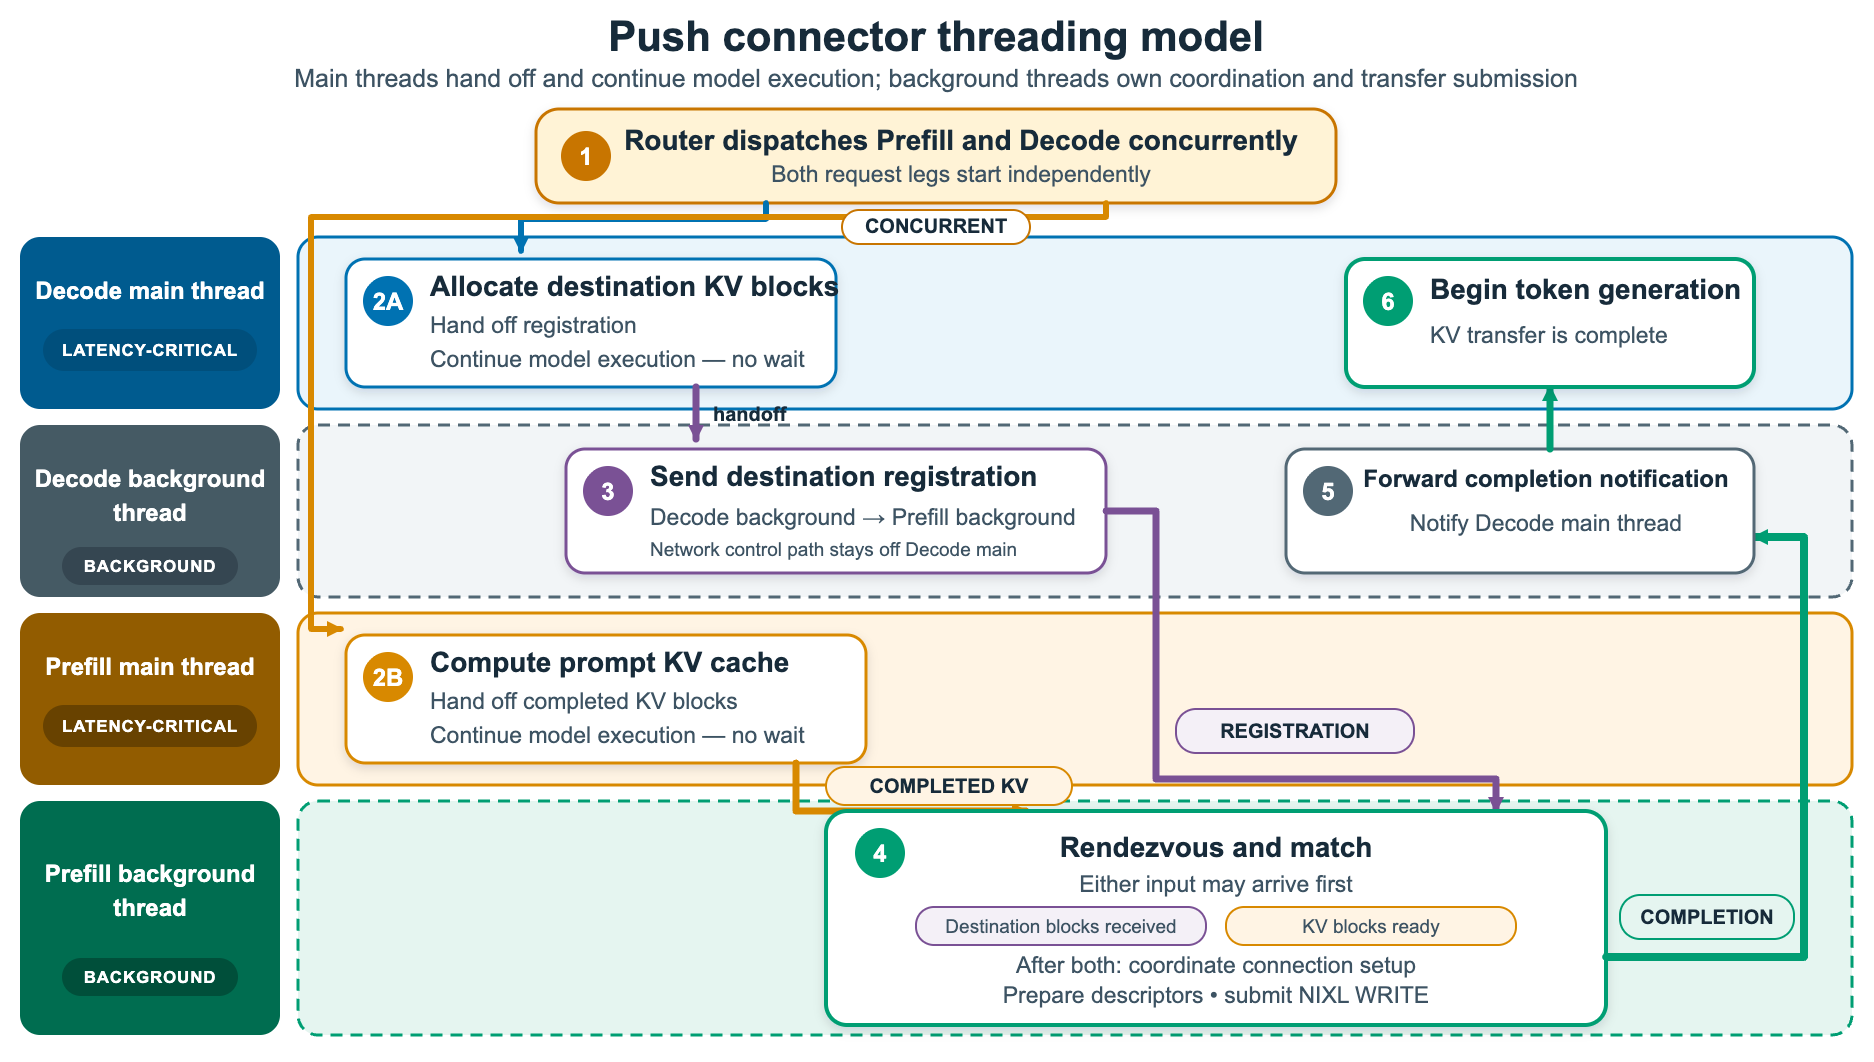
図3:プッシュベースのスレッドモデルにおける、単一リクエストに対するメインループとバックグラウンドスレッドのハンドオフ
プルとピューのタイミング比較
以下の図は、前節で説明したプルとパス・トランスファーの流れを要約し、TTFTに与える影響を明らかにしています。両モードとも同じNIXLおよびEFA/RDMAデータパスを使用していますが、プルは事前充填後のメタデータ中継とデコード側の設定を行い、パスはデコード側の設定と事前充填を重複します。その結果、パスではこれらの操作が事前充填後のクリティカルパスから除外され、デコードが早く開始できます。
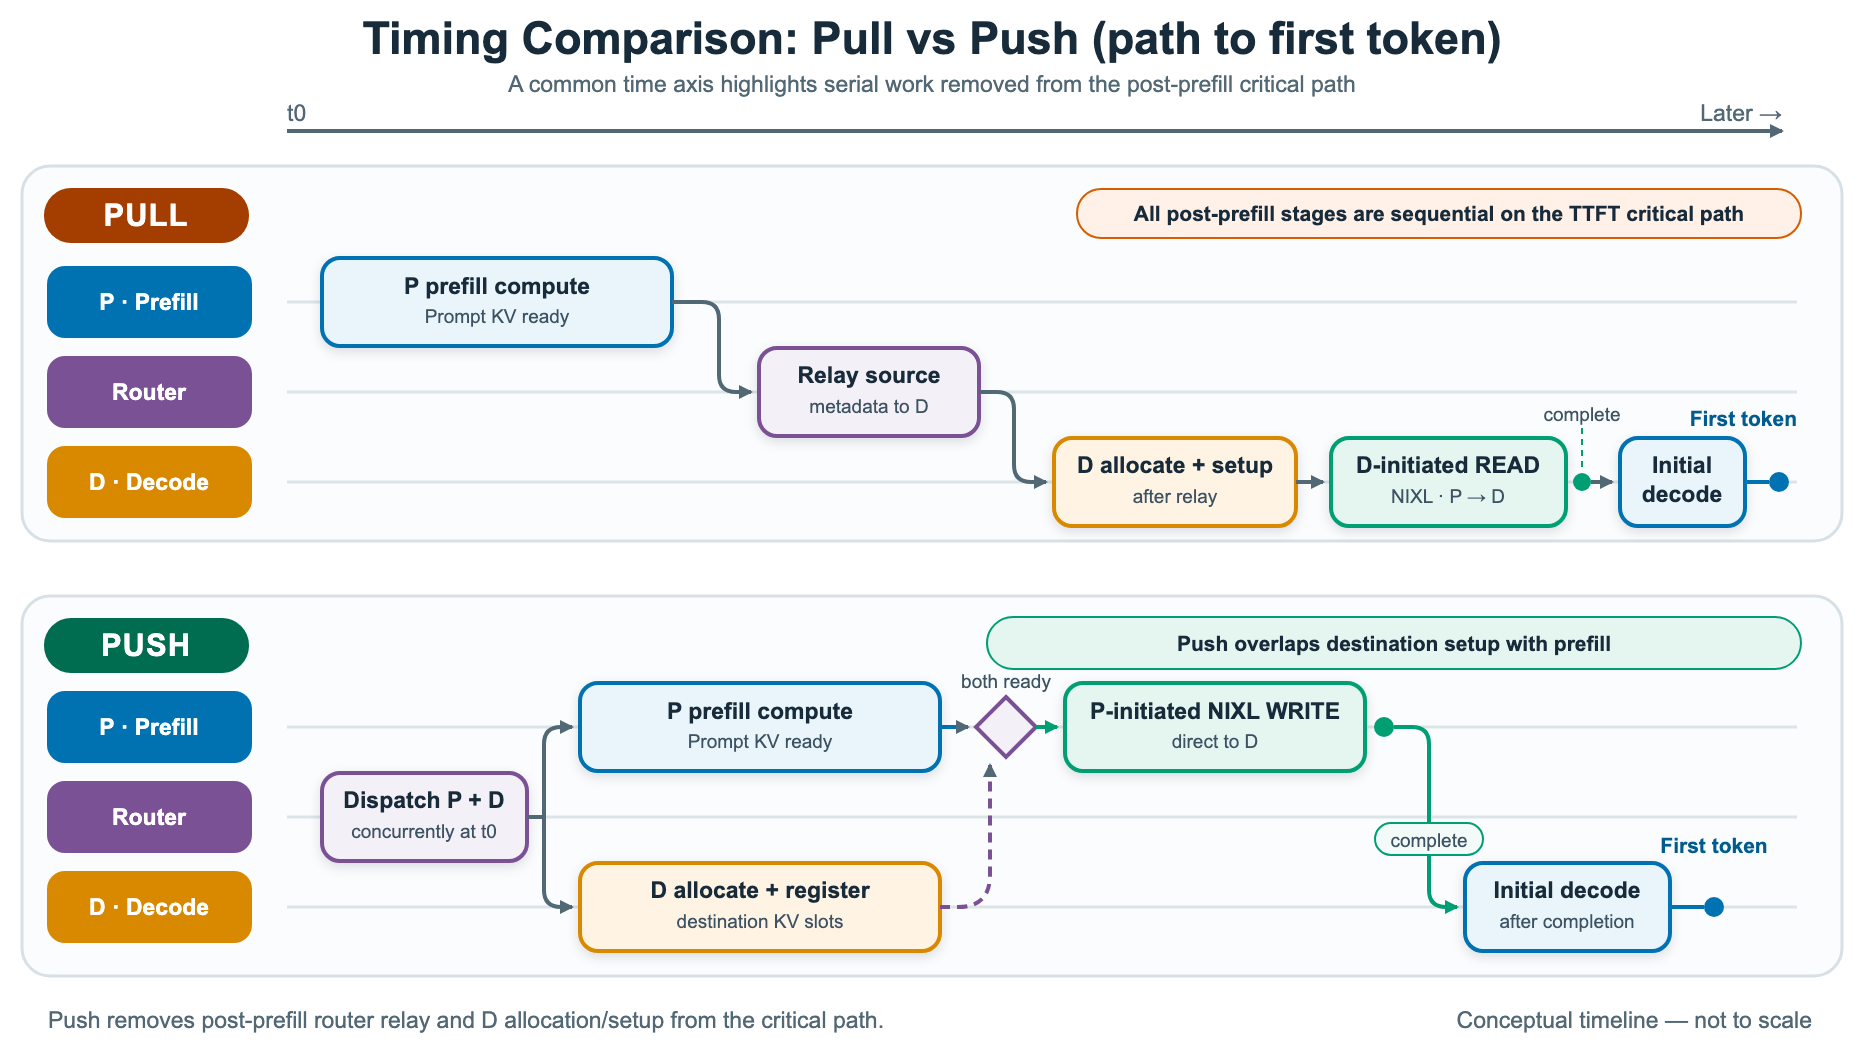
図4:プルとパススの転送フローを比較し、パススがデコード側の設定とプリフィルを重ねる様子を明らかにする
2つのモードにはルーティングにおけるトレードオフも伴います。プルモードでは、プリフィルが完了した後にルーターがデコードインスタンスを選択することができ、負荷に応じたルーティングやサービス品質管理においてより高い柔軟性が得られます。プッシュモードでは、早期にデコードインスタンスを選択するため、宛先の設定がプリフィルと重なることができます。 対して、同等の負荷下では、プリファイルインスタンスはKVブロックをより早く解放できる。なぜなら、プロンプトKVと目的地登録が準備された瞬間に転送が開始されるからだ。
パフォーマンスデータ
評価には、Amazon EC2 P5enインスタンスを使用し、EFAを介して接続された1P1D展開においてQwen3-32Bモデルを使用した。P→D転送性能を独立して測定するために、--no-enable-prefix-cachingを指定することで、前処理キャッシュ機能を無効にするベンチマーク設定を行った。この設定により、各リクエストにおいてデコードノードが前処理ノードから完全なKVキャッシュを取得する。そうでない場合、重複するプロンプトがデコードノードのローカルキャッシュを再利用し、転送を回避することになり、誤った比較結果を生じる可能性がある。
以下のチャートは、プッシュモードとプルモードのKV転送におけるTTFTを比較したものです。入力長を1k~16kにし、1秒あたり1~8クエリの要求率を設定しました。負荷が低く、プロンプトが短い場合、両モードはほぼ同じ性能を示します。QPSと入力長が増加すると、プルモードは急激に低下し、8 QPS、16kの場合で約1,744 msに達します。一方、プッシュモードは約540 msで、3倍程度低い値になります。 ギャップが生じるのは、プルモードではデコードワーカー内でNIXL記述子をインラインで、エンジンループ内で同期して処理されるため、作業が停止してトークン生成が滞るからです。プッシュモードでは、それをバックグラウンドスレッドに移動させ、重要なパスから外します。
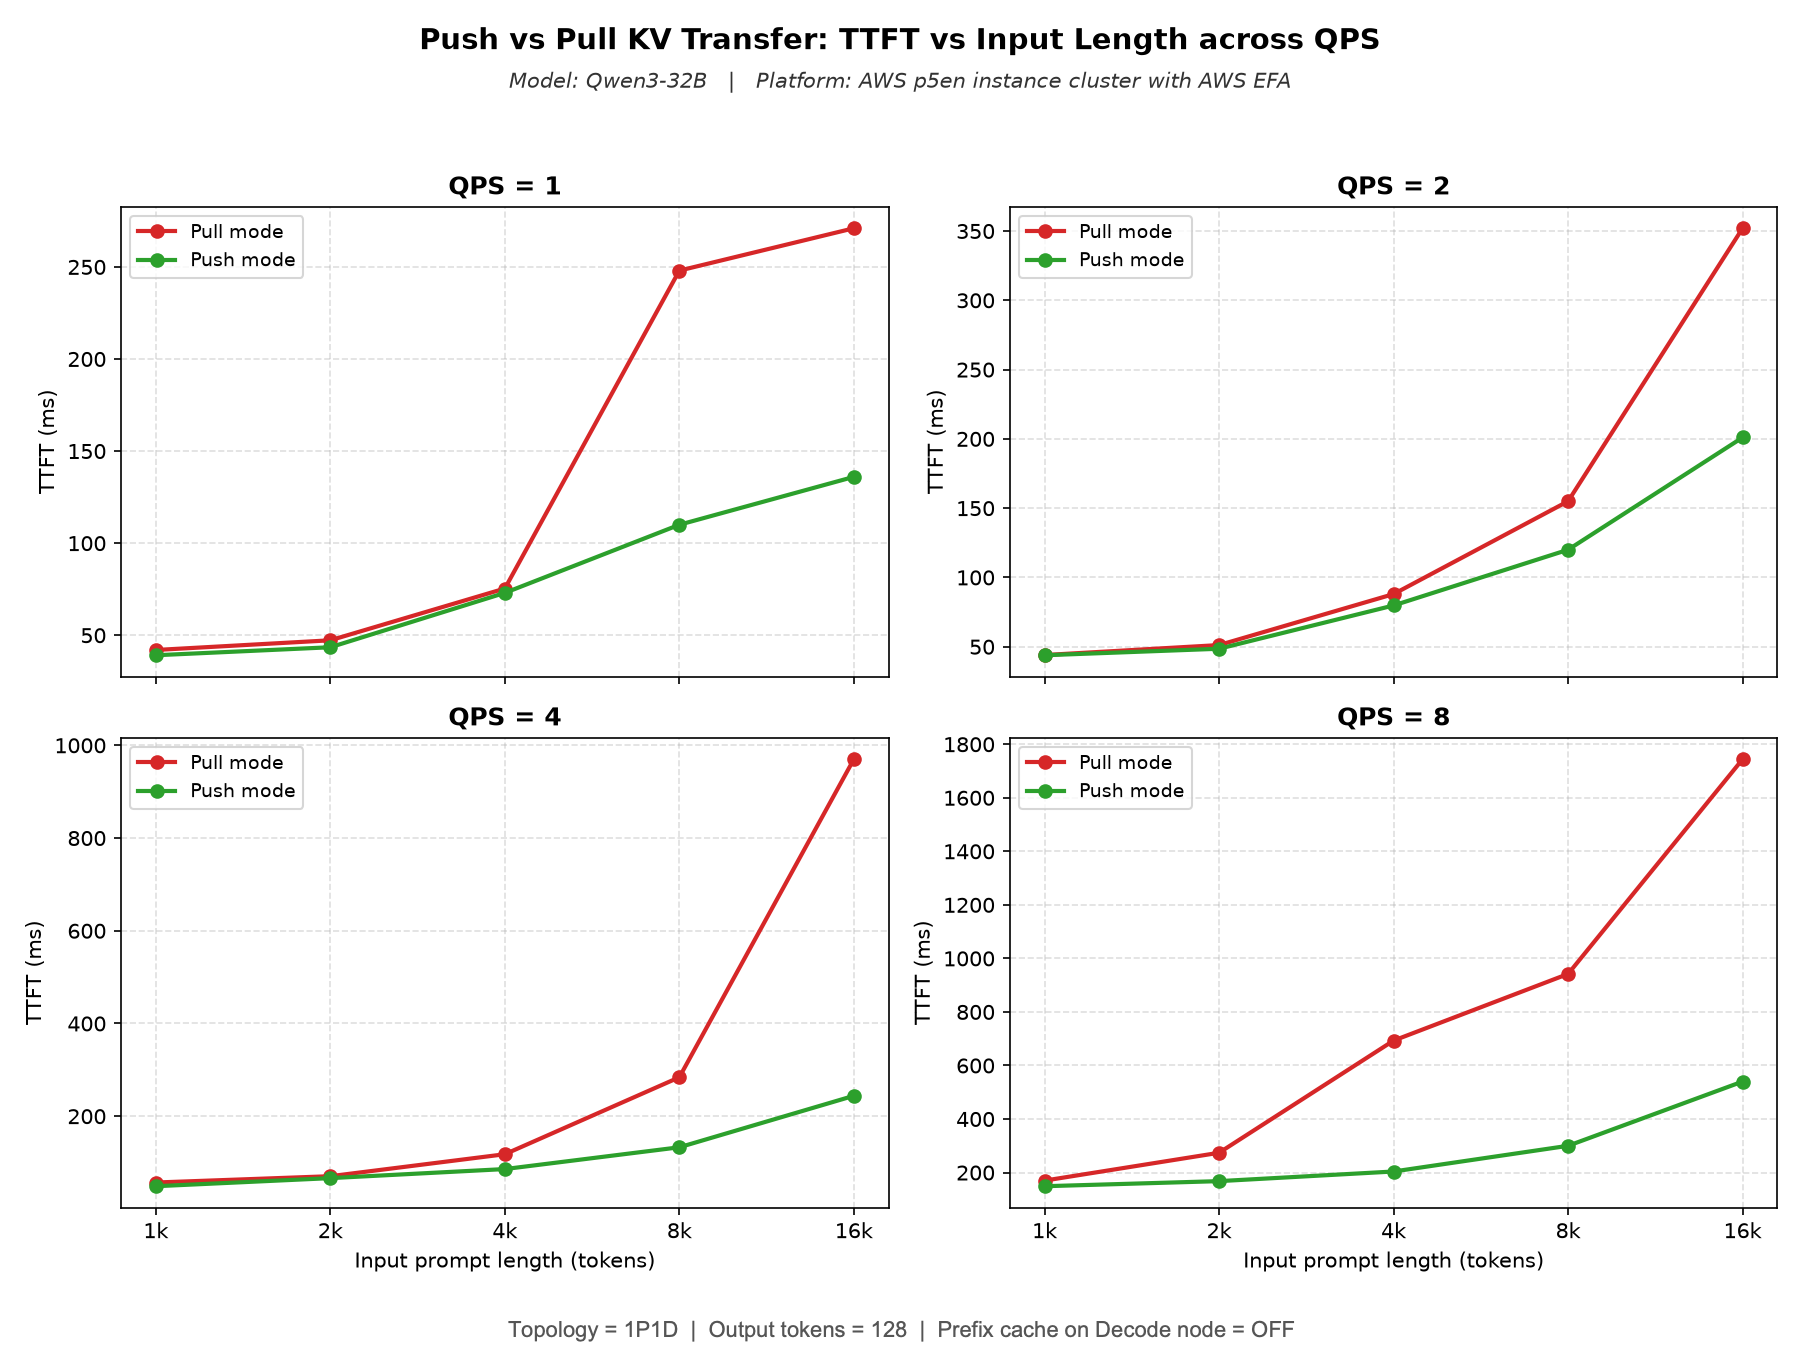
図5:入力長とリクエスト率の異なる場合におけるプッシュ型TTFTとプル型KV転送の比較(1P1Dトポロジー、128出力トークン、デコードノードでのプレフィックスキャッシングを無効)
このチャートは同じ条件下でのTPOTを示しています。パターンはTTFTと同じです。軽い負荷では、プッシュとプルが約5.6~5.8 msで近い値になります。負荷や入力長が増加すると、4~8 QPS、16kの場合でプルは約10.4 msに達し、一方でプッシュは約7 msを維持します。その理由は、プッシュがデコードワーカーの記述子準備と転送提出を解放するためです。トークン生成には不足がなく、したがって高い並行処理や長いコンテキスト下でも、各トークンあたりの遅延は一定に保たれます。
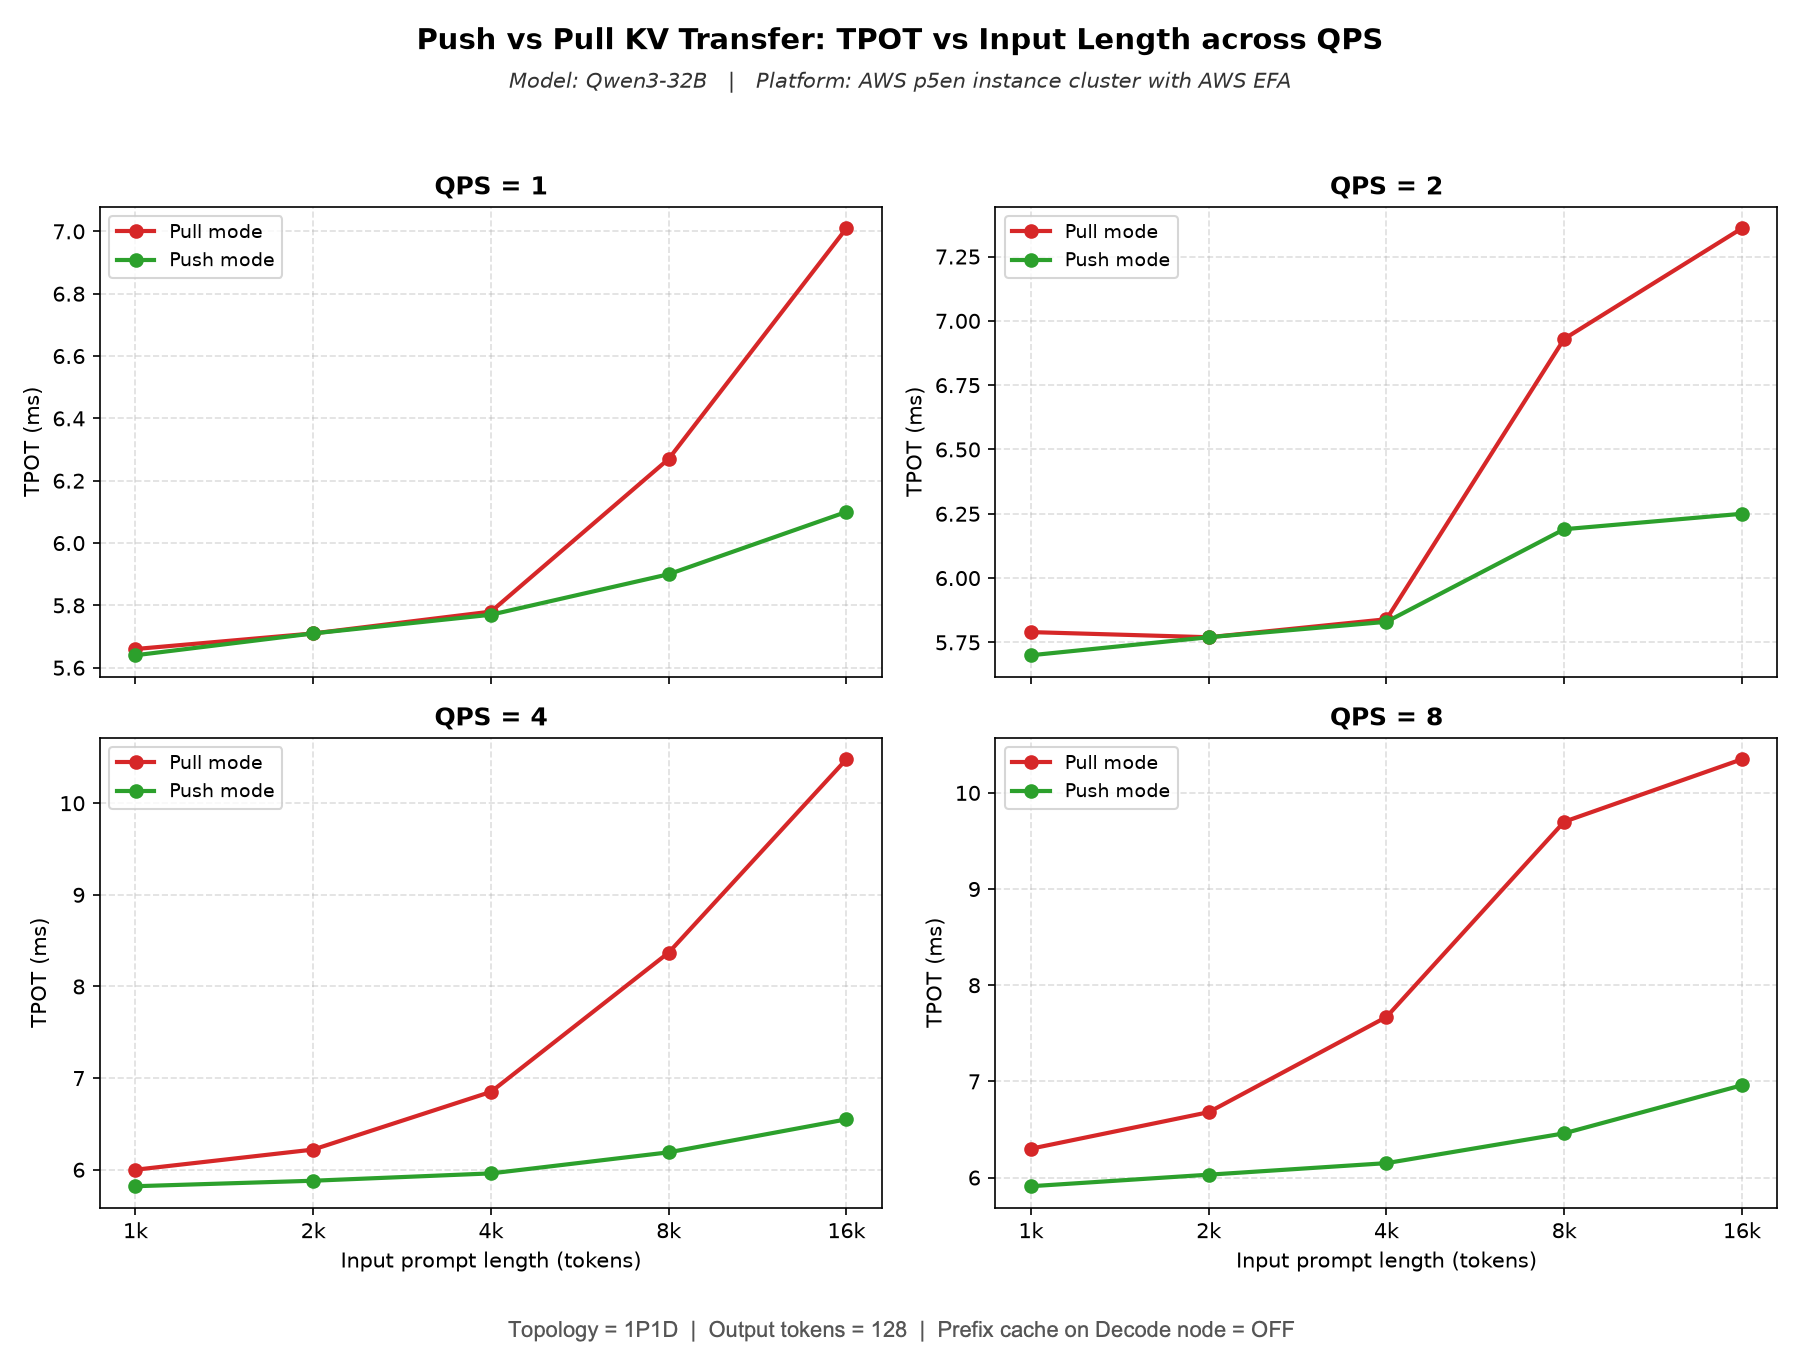
図6:入力長とリクエスト率の異なる場合における、プッシュ型TPOTによるプル型KV転送との比較(1P1Dトポロジー、128出力トークン、デコードノードでのプレフィックスキャッシングを無効)
ベンチマークを実行する方法
私たちの1P1Dベンチマーク構成を再現するには、EFAで接続されたAmazon EC2 P5enインスタンスを使用する1つのプレフィルノードと1つのデコードノードが必要です。詳細はReproducing our resultsガイドの詳細な指示を参照してください。このガイドでは、環境設定、vLLMプレフィルサーバーとデコードサーバーの起動、ベンチマークの実行、結果の収集について説明しています。この機能は他のサポートされる構成でも動作しますが、性能結果はハードウェア、モデル、ワークロード、ネットワーク設定に依存して変わります。
結論
この記事では、プッシュベースのKVコネクタが、事前フィルタリング計算とデコード側のブロック割り当ておよび登録を重ね合わせる方法を示しました。これにより、事前フィルタリング後のルーター往復処理やデコード側の転送設定が重要なパスから除外されます。その結果、特に高いリクエストレートでTTFTとTPOTが低減します。 Amazon EC2 P5enインスタンスをEFAで接続し、1P1D方式で実施したQwen3-32Bベンチマークにおいて、プッシュモードではTTFTが3倍、TPOTが30%向上することが確認された。結果はワークロードや設定によって異なる。プッシュモードを使用するには、プリフィルとデコードサーバーを同時に設定する必要がある。 NixlPushConnector 代わりに NixlConnector.
早期のデコードノード選択が許容され、低いTTFTが優先される場合は、プッシュベースのコネクタを選択してください。双方向KV転送が必要なワークロードや、負荷に応じたルーティングのためにデコードインスタンスの選択をプリフィル後に行う場合は、プルベースのコネクタがより適しています。vLLMはプッシュおよびプルベースのKVコネクタを両方サポートしているため、デプロイに最適な方法を選択できます。
将来の改善として、背景のNIXLスレッドモデルをプルモードコネクタに導入し、NIXLの設定を重要なパスから外すことで、プルモードワークロードが同じ最適化を享受できるようにすることを検討しています。この点について調査するため、プルリクエストを開設しました。
関連リソース
謝辞
この機能の維持において、vLLMコミュニティの支援に感謝します。