
音声がAIにおけるファーストクラスのモダリティとなるにつれ、Deepgramのモデルは音声認識(speech-to-text)、音声合成(text-to-speech)、音声エージェントに及んでいます。これらのモデルは現在、200,000人以上の開発者と1,400の組織に対して、年間何千兆にも及ぶオーディオトークンを処理しています。顧客はDeepgram APIを通じてこれらを利用するか、Amazon SageMaker AIを含む自社環境で実行しています。
Deepgramにとって、サービングの効率は所与のインフラ予算でどれだけのオーディオを処理できるかを左右します。大量のバッチワークロードはこの予算に大きな圧力をかけるため、各アクセラレータ時間をどれだけ効率的に使えるかが、同じフリートで提供できるオーディオの量を決めます。そのため推論効率は自然なターゲットとなり、DeepgramはAWSのAIチップにその改善を求めました。彼らはAWSと協力し、コンタクトセンターの分析や医療トランスクリプションといったオフラインのバッチワークロード向けに、Nova-3音声認識モデルをAWS Trainium2に搭載しました。
この取り組みは、DeepgramがNova-3を標準的なPyTorchコードとして提供することから始まりました。数か月にわたり、DeepgramとAWS Forward Deployed Engineering (FDE) チームはNova-3を AWS Trainium2 のPyTorch再構築に移植し、新しいハードウェア向けにチューニングしました。最終的な構成では、1つのAmazon Elastic Compute Cloud (Amazon EC2) trn2.3xlargeインスタンス上で8つのモデルレプリカを実行します。Deepgramのオフラインのスループット重視のバッチワークロードにおいて、このセットアップはDeepgramが運用していたコンピュートオプションよりも、1ドルあたり11〜70パーセント多くのオーディオを処理しました。この測定には評価時点のインスタンス価格を使用しました。これらの改善により、Deepgramは効率的にスケールし、より優れたモデルを開発し続け、より低い価格で顧客に提供できるようになります。これらの利点は、Amazon SageMaker AI上の自社の仮想プライベートクラウド (VPC) でDeepgramモデルをセルフホストする顧客にも及びます。そこでは、DeepgramとAWSが引き続きセットアップの容易さ、信頼性、オブザーバビリティの向上に取り組んでいます。
本投稿では、Trainium上での推論最適化の全工程を walk through します。すなわち、AWS NeuronソフトウェアスタックへのNova-3の移植、それに続くカーネルレベルのチューニング、Deepgram自身のモデルサーバーがTrainiumを呼び出せるようにするデータ並列のRustランタイム、そしてバッチ文字起こしで測定したスループットとコストの結果です。
ネイティブPyTorchによるTrainium2向けNova-3の最適化
標準的なPyTorchコードから出発し、私たちはTorchNeuron(Neuron CompilerのネイティブPyTorch統合)を使用しました。これはイーガー実行と torch.compileの両方をサポートします。まずNova-3をTrainium2上でイーガーモードで実行し、どの演算がCPUにフォールバックしたかを確認し、その後 torch.compileでコンパイルしました。コンパイルされたパスでは、すべてのモデル演算がTrainium2上で実行され、CPUフォールバックは検出されませんでした。
私たちはエンコーダーとデコーダーを torch.compileを使用して別々の静的シェイプのグラフとしてコンパイルしました。その過程全体を通じて、数値精度を2つのレベルで確認しました。CPUに対するレイヤーレベルの出力の一貫性と、Deepgramのリファレンス値およびターゲットに沿っていなければならないエンドツーエンドのWord Error Rate (WER) です。
その動作するベースラインから、私たちはいくつかのレイヤーを、Neuron Kernel Interface (NKI) で書かれた事前構築済みリファレンスカーネルのコレクションである公開NKI Library (NKILib) の融合カーネルに置き換えることで最適化を開始しました。これらのカーネルは、融合QKV投影、融合フィードフォワードネットワーク (FFN) レイヤー、depthwise 1Dコンボリューションなどの演算をカバーしました。
私たちはスループット、ひいてはコスト効率を最適化し、Deepgramのオフライン推論ワークロードをターゲットとしました。スループットは、1秒あたりに処理される絶対的なオーディオ量ではなく、ベースライン構成に対する相対的な向上として報告され、スループットを最大化するバッチサイズを見つけるためにバッチサイズ1〜128を調べました。
Neuron ExplorerとNADによるカーネルレベルのチューニング
カーネルの有効化は最適化のフライホイールの第一歩にすぎません。NKIカーネル(カスタムまたはNKILibから)を有効化し、ワークロードをプロファイリングし、その後、既存のカーネルをチューニングするか、プロファイリングの洞察に基づいて新しいカーネルに置き換えます。このサイクルはパフォーマンス目標が達成されるまで繰り返されます。各ステップで、Neuronスタックの異なる部分が作業を加速します。NKILibはドロップイン置換カーネルを提供し、Neuron ExplorerはNeuronワークロードのプロファイリングに最適なツールであり、Neuron Agentic Development (NAD) ツールキットはそのプロファイリングスキルとカーネル作成スキルを通じて、プロファイリング分析とカーネルチューニングを高速化します。
私たちの場合、NKILibカーネルで大部分がカバーされ、プロファイリングによって手書きカーネルがより良い性能を発揮できる箇所が明らかになりました。そのたびに、NADのプロファイリングスキルがNeuron Explorerのプロファイルから根本原因への道を開き、NADのカーネル作成スキルが置換カーネルの作成に役立ちました。
| レイヤー | 判明したことと変更内容 | 向上 |
| FFN | リファレンスカーネルのタイリングスケジュールでは、トークンタイルごとにオフチップメモリから投影重みの全セットを再読み込みしていたため、トークン数が増えるにつれてメモリ帯域幅がスループットを制限していました。私たちの手動チューニングカーネルは各重みタイルを一度だけ読み込み、複数のトークンタイルにわたって再利用し、重みの読み取りをオンチップの計算とパイプライン化します。 | バッチサイズ96でリファレンスカーネルと比較して2.0倍のレイテンシー低減 |
| Depthwise conv1d | 実験的なNKILibカーネルはこの演算を暗黙の一般行列乗算 (GEMM) として扱っており、Tensor Engineの利用率が低いままでした。私たちはそれをVector Engine上のブロードキャスト乗加算ループとして書き直し、エンジンの完全な利用率に到達しました。これはVector Engineの低いピークスループットを十分に相殺するのに足りるものでした。 | バッチサイズ96においてリファレンスカーネル比1.5倍の高速化 |
| Conv2d | モデルのconv2d層はコンパイルのボトルネックに直面していました。バッチサイズ32を超えると、これらの層が原因でモデルを単一のグラフとしてコンパイルできませんでした。NKILibにはconv2dカーネルがなかったため、NKIでゼロから作成しました。このカーネルは、前述のフライホイールに従い、プロファイラの知見をもとに数回の反復を経て、32を超えるバッチサイズを可能にしました。 | バッチサイズ≤32の畳み込みモジュールで最大50倍 |
Rustによるデータ並列ランタイム
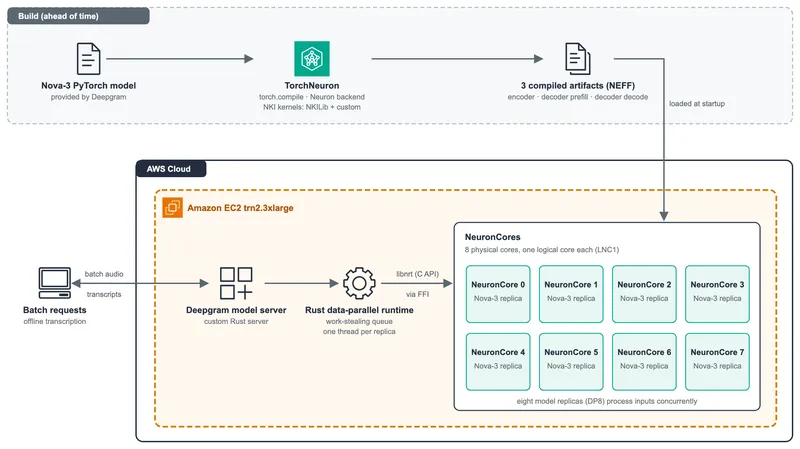
各Trainium2デバイスは8つの物理NeuronCoreを備え、デフォルトでは4つの論理NeuronCore(LNC2)として公開されます。各Nova-3モデルインスタンスは1つの物理コアに余裕を持って収まるため、論理コアあたりの物理コア数を1つに削減しました(LNC1)。この構成により、Trainium2デバイスあたり8つのモデルレプリカ(DP8)をホストできます。入力は並行して処理され、デバイスあたりのスループットを最大化します。データ並列ランタイムは、レプリカごとに1スレッドを持つワークスティーリングキューによって駆動されます。
Deepgramの本番サービングスタックはRustで書かれているため、Nova-3をTrainium2へ移植するにはモデルのコンパイル以上の作業が必要でした。サービングパスでPythonやPyTorchなしで実行できなければなりませんでした。そこで私たちは、Rustが共有のワークスティーリングキューを通じてモデルレプリカを調整する軽量ランタイムを構築しました。Cのレイヤーが、事前にコンパイルされたNeuron Executable File Format(NEFF)をNeuron Runtime API(libnrt)を通じて直接ロードおよび実行します。このランタイムはDeepgramのサービングアーキテクチャに直接統合されており、テストしたすべてのバッチサイズにおいてリファレンスのトークン列を正確に再現しました。
このランタイムを、マルチスレッド(MT)およびマルチプロセス(MP)のPythonデータ並列ランタイムとベンチマーク比較しました。MPベースラインと比較して、RustランタイムはPythonインタプリタのオーバーヘッドを完全に排除します。MTベースラインと比較して、さらにグローバルインタプリタロック(GIL)による逐次化を緩和するため、同時に動作するワーカースレッドからのディスパッチ呼び出しが単一プロセス内で競合しなくなります。Nova-3は各オーディオチャンクに対して一連の小さなデコーダ呼び出しを行うため、低バッチサイズではホスト側のディスパッチがボトルネックになるため、これらの利点は重要です。したがって、スループットの改善はそこで最も大きく、スループットを最大化するバッチサイズにおいても有意です。そこでは、RustランタイムはマルチプロセスのPythonベースラインに対して7.5%のスループット向上を達成しました。
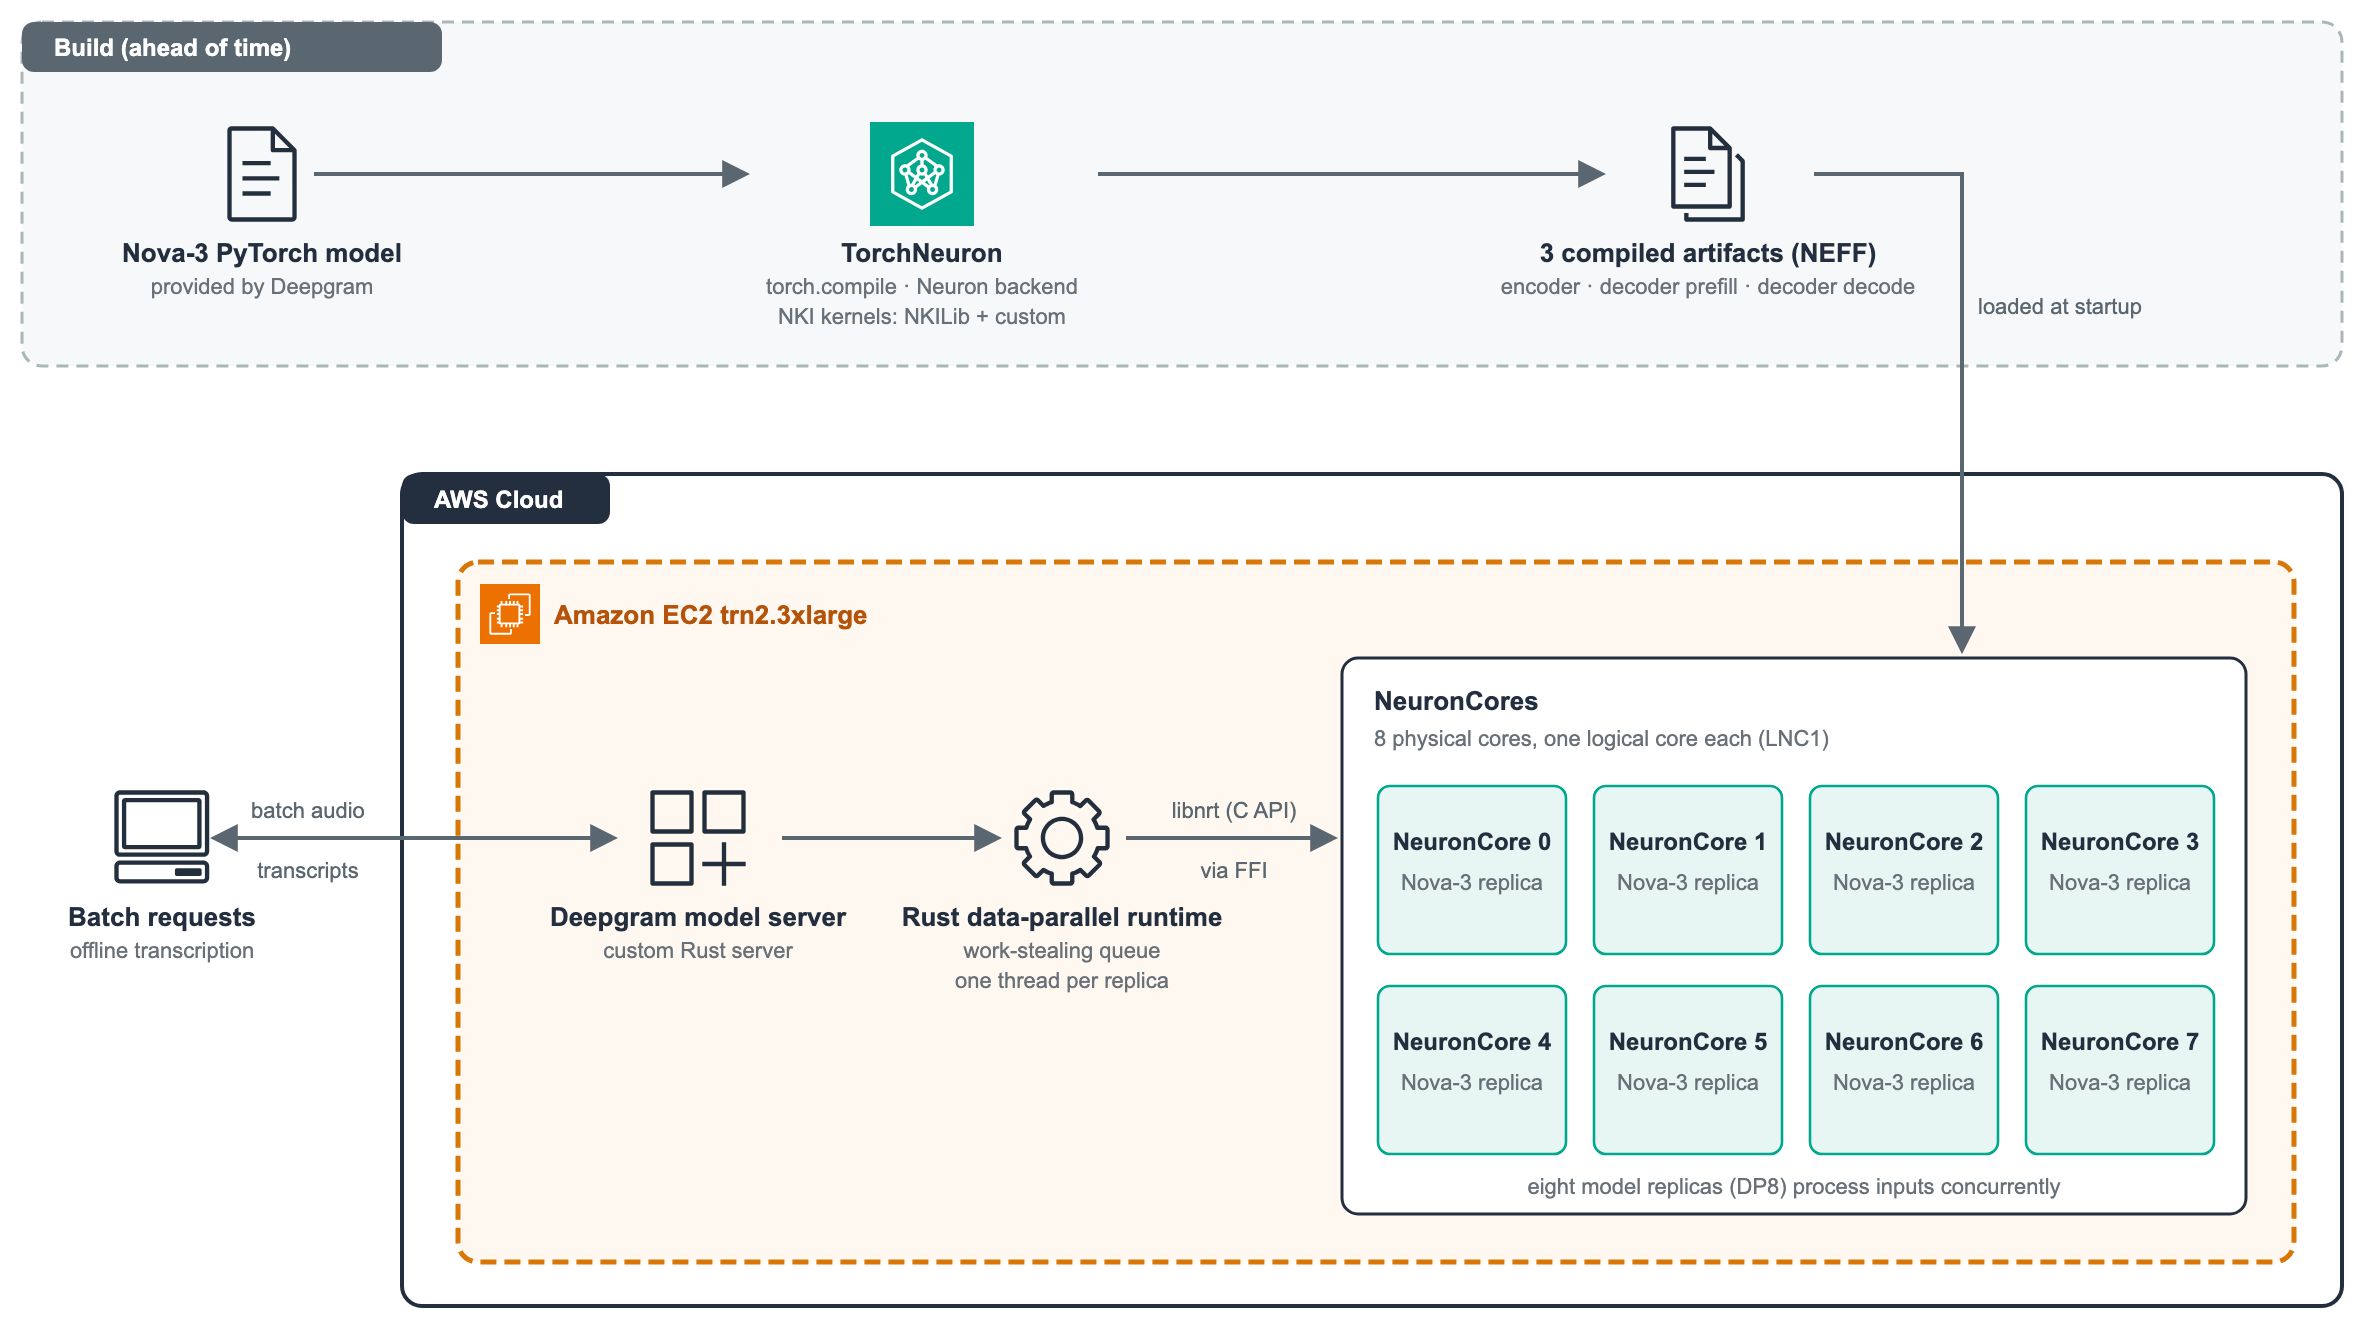
図1:AWS Trainium2上のDeepgram Nova-3。事前コンパイルされ、Rustから提供される
コスト削減の効果
私たちは、ドルあたりで処理されるオーディオ量として価格性能比を測定しました。Deepgramのオフラインのスループット指向バッチワークロードにおいて、シングルデバイスのTrainium2構成(trn2.3xlarge)は、Deepgramがこれまで使用していたコンピューティングオプションよりも、ドルあたり11〜70%多くのオーディオを処理しました。
結論
本記事では、AWS Trainium向けのネイティブなPyTorchフレームワーク統合を提供するTorchNeuronを使用して、DeepgramとAWS FDEがNova-3の音声テキスト変換PyTorchモデルをTrainiumハードウェアに移植した方法を示しました。私たちは、NKILibの事前構築済みカーネルで層を直接置き換えることでパフォーマンスを向上させました。次にNeuron Explorerを使用してパフォーマンスを評価し、Neuron Agentic Development(NAD)のプロファイリングスキルを用いてプロファイリングデータを照会し、パフォーマンスのトラブルシューティングを加速しました。これらの知見をもとに、NADのカーネル作成スキルを使用してカーネルのソースコードを適応させました。最後に、RustからNeuron Runtime APIを呼び出す、AWS Trainium向けの軽量なRustデータ並列ランタイムを構築しました。この構成はオフラインのスループット指向シナリオにおけるコスト削減を実証し、AWS TrainiumがDeepgramの推論ワークロードにとって実用的かつ効率的な選択肢であることを検証しました。
ご自身のモデルでこのアプローチを試すには、まず AWS Neuronドキュメントから始めてください。コンパイラ、ランタイム、およびサポートされているフレームワークを網羅しています。 Neuron Kernel Interface(NKI)ガイド では、本記事で説明したカーネルの書き方を説明しており、 NKIサンプルリポジトリ には私たちが出発点としたリファレンスカーネルが収録されています。 Neuron開発者ツールのドキュメント では、Neuron ExplorerやNeuron Agentic Developmentを含む、ここで使用したプロファイリングおよびエージェント的ツールについて説明しています。インスタンスサイズと価格については、 Amazon EC2 Trn2 Instancesを参照してください。同様の移植の計画についてサポートが必要な場合は、AWS Forward Deployed Engineeringにお問い合わせください。