30の特性と21の特徴における言語モデルの性格を評価する新しいベンチマークであるAA-PersonalityBenchを発表します
2つのモデルは同じように正確な答えを出すことができても、使い方によって大きく異なると感じられます。AA-PersonalityBenchはその違いを測定し、さまざまな使用場面でどちらを使うべきかを人々が理解できるようにします。創作活動のような使用場面では想像力が求められるかもしれませんが、法的な使用場面では直接的な表現が求められるかもしれません。私たちは900個の精選された質問に対するモデルの答えを評価し、主観的な人格特性や客観的なコミュニケーション特性を計算するプログラム的な方法を判断します。
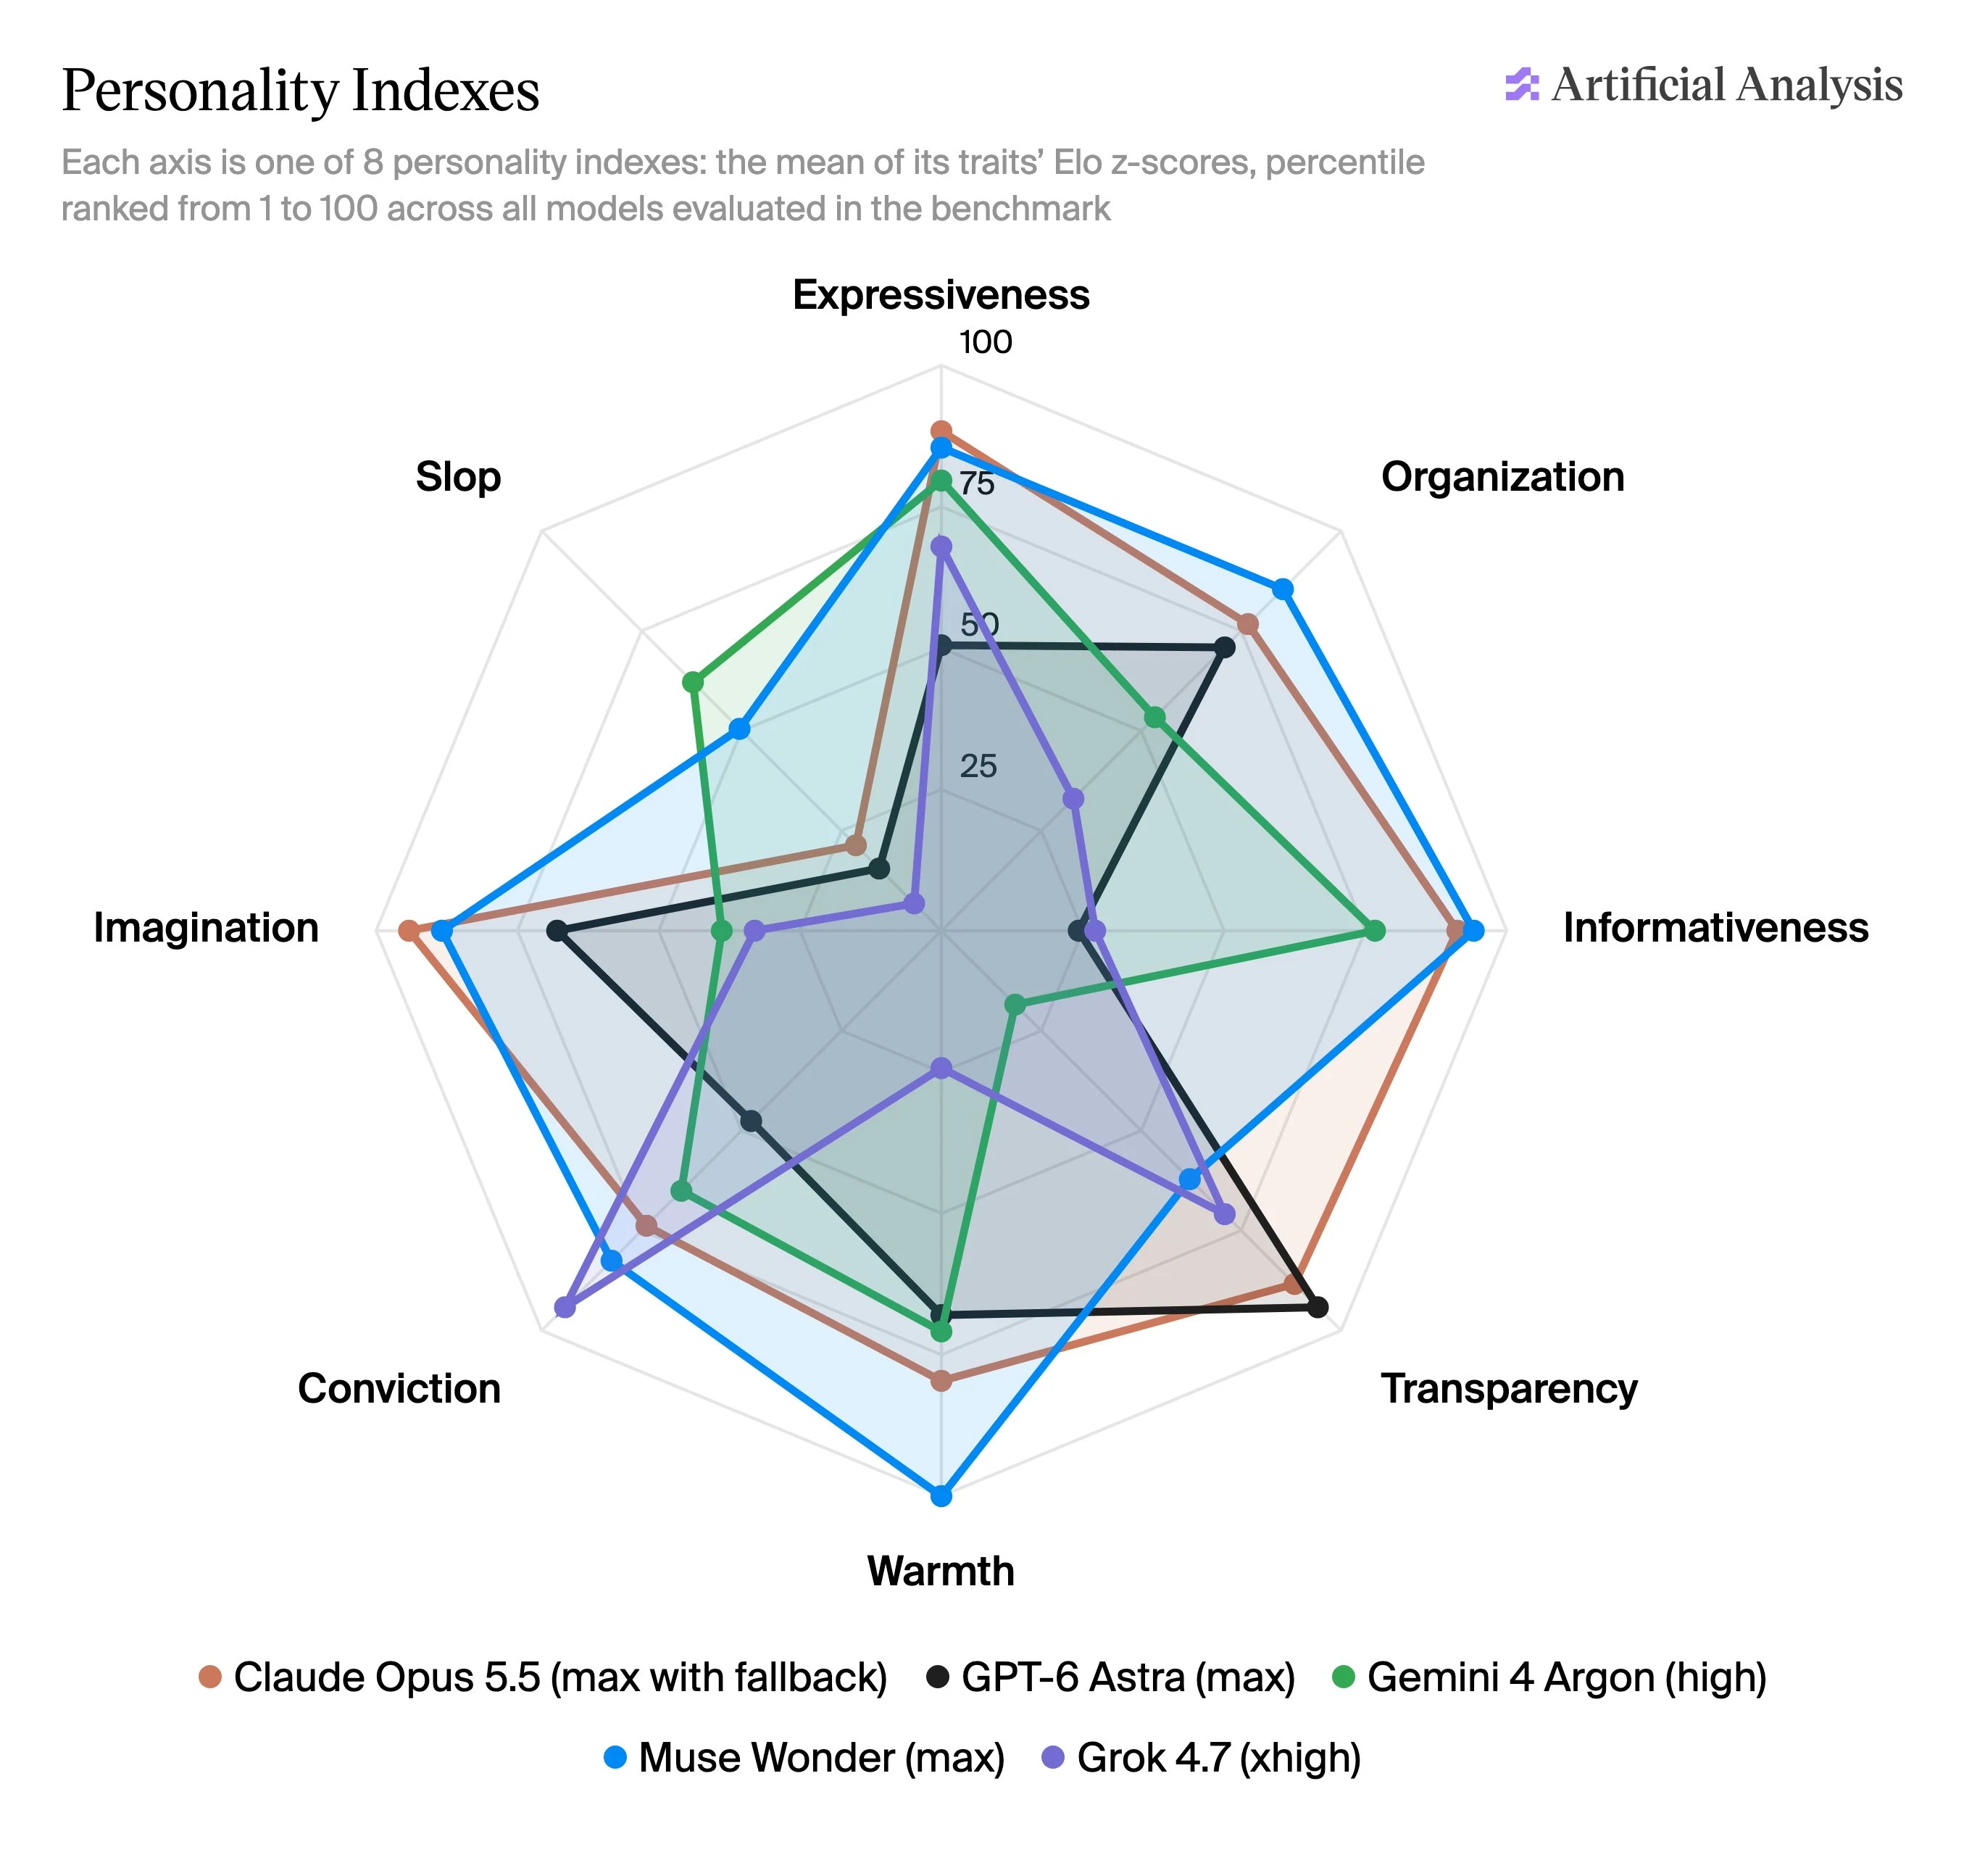
性格特性と指数。30種類の性格特性(例:雄弁、実用的、お世辞を言う)があり、これらを8つの集計された性格指数にまとめます。それは、表現力、組織性、情報性、透明性、温かさ、信念、想像力、無駄な部分です。各特性には30の専用質問が設定されており、モデルの回答はLLM審査員のパネルによってペアで比較されます。その後、各特性と性格のエロスをZスコアとパーセンタイルランクで評価します。
8つのパーソナリティ指数で最も強い表現を持つモデル:
➤ 表現力:Claude Fable 5.1、GLM-5.3、GLM-5.3-Flash
➤ 組織化:DeepSeek V4.1 Flash、Step 5 Preview、Inkling
➤ 情報性:Muse Spark 1.3、Claude Fable 5.1、Muse Wonder、Claude Opus 5.5
➤ 透明性:Claude Sonnet 5.5、Claude Fable 5.1、GPT-6 Astra
➤ 温かさ:Muse Wonder、Muse Spark 1.3、Claude Fable 5.1
➤ 信念:Claude Fable 5.1、DeepSeek V4.1 Flash、Grok 4.7
➤ 想像力:Muse Spark 1.3、Claude Opus 5.5、GLM-5.3
➤ 無駄:Llama 4 Maverick、GPT-4o、K2 Horizon
コミュニケーション特性。平均文長、絵文字の使用、エムダッシュの使用など、21種類のコミュニケーション特性があり、これらを長さ、構造、句読点、強調という4つのカテゴリーに分類します。これらの特性はすべてのモデルの応答をプログラム的に計算します。
➤ 長さ:Qwen3.8 27Bは、1回の応答あたり約1,030語で、GPT-6 Lunaの270語のほぼ4倍です
➤ 構造:Nemotron 3 Ultraは、1回の応答あたりほぼ3つの表を使用するのに対し、ほとんどのモデルは1つも使用しません
➤ 句読点:GLM-5.3は、1回の応答あたり7つのエムダッシュを平均して使用するのに対し、Claude Opus 5.5、Sonnet 5.5、Haiku 5.5はほとんど使用しません
➤ 強調:K2 Horizonは、1回の応答あたり2つ以上の絵文字を平均して使用するのに対し、ほとんどのモデルはほとんど使用しません