
従来、vLLMサービスのGPU数を変更するには、モデルレプリカ全体を追加または削除するか、異なるGPU数でエンジンを再起動する必要がありました。モデルが大きくなるほど各レプリカはより多くのGPUを必要とするため、レプリカ単位のスケーリングでは、ますます大きな単位でGPUが追加・削除されることになります。DeepSeek V4 Proを16基から20基のGB200 GPUにスケールさせるためにvLLMを再起動すると、 197秒 間サービスが停止しました(詳細は パフォーマンスセクション を参照)。この間、高価なGPUが割り当てられたまま、トークンを生成することはありませんでした。
最初のElastic EPの投稿 では、実行中のDEPデプロイメント(データ並列アテンションとエキスパート並列MoE)に対して、vLLMが再起動なしでGPUを追加・削除できることを示しました。再起動は避けられましたが、新しいワーカーの初期化、拡張された通信グループの準備、モデル重みのロード、カーネルのウォームアップとCUDAグラフキャプチャの再実行の間、サービスは再構成の全過程で停止していました。DeepSeek V4 Proのベンチマークでは、この一時停止は, vLLMが実行中のDEPデプロイメント(データ並列アテンションとエキスパート並列MoE)にGPUを追加または削除する方法を、再起動なしで実現できることを示しました。再起動は回避できましたが、新しいワーカーの初期化、拡張された通信グループの準備、モデルウェイトのロード、カーネルのウォームアップとCUDAグラフキャプチャの再実行といった処理の間は、再構成全体を通じてサービスが停止していました。DeepSeek V4 Proのベンチマークでは、この一時停止は 16基から20基へスケールアップする際に100秒かかり 16基へのスケールバック時に56秒 16基へスケールバックする際に56秒かかり パフォーマンスセクション を参照)。本投稿では、非同期準備と).
NIXL EP によって、ほぼゼロダウンタイムでElastic EPの再構成を可能にした方法を説明します。同じベンチマークで、ダウンタイムを 16基から20基へのスケールアップ時に0.82秒 16基から20基へスケールアップする際に0.82秒 16基へのスケールバック時に1.96秒 16基へスケールバックする際に1.96秒トポロジ準備とサービス提供のオーバーラップ
vLLMの再構成フローを、バックグラウンド準備と短いコミットの2つのフェーズに再編成しました。既存のワーカーは、別個のバックグラウンドスレッドを使用して、対象の通信の準備とウォームアップ、モデル重みの転送、実行関連情報(自動チューニング結果など)の参加ワーカーとの同期を行い、その間も現在の通信グループとCUDAグラフでリクエストの処理を継続します。並行して、参加ワーカーは初期化を行い、モデル重みを受信し、通信とGPU実行の準備をします。コミットフェーズでは、vLLMはスケジューラを一時的に停止し、準備されたトポロジを有効化して、サービス提供を再開します。これらの変更は
vLLMの再構成フローを、バックグラウンドでの準備と短いコミットという2つのフェーズに再編成しました。既存のワーカーは、現在の通信グループとCUDAグラフを使い続けてリクエストの処理を継続しながら、別個のバックグラウンドスレッドで対象の通信の準備とウォームアップを行い、モデルウェイトを転送し、(自動チューニング結果などの)実行関連情報を参加するワーカーと同期します。並行して、参加するワーカーは初期化を行い、モデルウェイトを受け取り、通信とGPU実行の準備をします。コミットフェーズでは、vLLMはスケジューラを短時間一時停止し、準備済みのトポロジをアクティブ化して、サービスを再開します。これらの変更は と prepare/commit最適化 で導入されました。.
準備は4つの主要タスクをカバーします:
- 参加ワーカーを初期化する。 プロセスを開始し、モデルと実行のためのストレージを割り当てる。
- 通信を準備する。 対象の通信グループをセットアップし、EP コミュニケーターを拡張します。
- モデルの重みを転送します。 必要な重みを、既存ワーカーから参加ワーカーへ NVLink または RDMA 経由で転送します。
- 実行を準備します。 参加ワーカー上で、必要なコンパイル、カーネルのウォームアップ、チューニングのセットアップ、および CUDA グラフの構成を完了します。
コミットフェーズの後、非同期の Expert Parallel Load Balancing(EPLB)により、新規ワーカーはアテンションの処理を開始し、既存ワーカーはエキスパート計算を処理できます。その後、EPLB がバックグラウンドで拡張されたグループ全体にエキスパートを再配置します。
主な課題は、リクエストを処理中のワーカーに関与させたり、その処理を中断させたりすることなく、通信と GPU 実行を準備することです。
EP 通信をその場で拡張する
NIXL EP 以前は、vLLM で利用可能だった EP 通信バックエンドは固定メンバーシップを使用していました。各インスタンスは特定のランク集合に対して作成されるもので、ランクの追加や削除には新しいインスタンスが必要でした。そのインスタンスをバックグラウンドで作成できたとしても、2 つの問題が残ります。
第一に、古いインスタンスと新しいインスタンスは、メモリ登録、IPC ハンドル、RDMA キューペア(QP)を含む、それぞれ独立した通信バッファやその他のリソースを必要とします。両方のインスタンスを稼働させ続けると通信メモリの使用量が増加し、既存リソースを再利用するのではなくセットアップを繰り返すことになります。
第二に、EP コミュニケーターを切り替えると、EP 通信カーネルが使用するバッファと通信状態が変わります。これにより、以前キャプチャされた CUDA グラフが無効化され、提供を再開する前に再キャプチャが必要になります。そのためには、保持されるすべてのワーカーにわたって、多数のバッチ形状に対するウォームアップとグラフ構成を繰り返す必要があります。我々の DeepSeek V4 Pro ベンチマークでは、非同期の準備を行った場合でも、コミットフェーズ中にウォームアップとグラフの再キャプチャを行うと、提供が一時停止しました。 スケールアップ時に 58 秒 および スケールダウン時に 44 秒.
これらの問題を解決するために、我々は Elastic EP のために特別に作られた EP 通信ライブラリである NIXL EPを設計しました。これは、同じ NIXL エージェント、バッファ、および接続を再利用しながら、ランクをその場で追加・削除します。既存のワーカーが提供を継続している間に新しいピアを接続でき、新たな接続と登録が必要なのは参加するピアだけです。さらに NIXL EP は、キャプチャ済みの EP ディスパッチおよびコンバインのエントリを再構成後も有効に保つため、保持されたワーカーは既存の CUDA グラフを再利用できます。
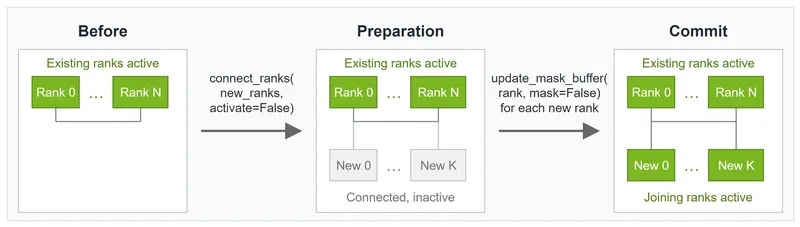
準備段階では、vLLM のバックグラウンドスレッドが参加するピアをアクティブ化せずに接続します。その後、コミットフェーズで準備済みのピアを、コミュニケータを置き換えることなくアクティブ化します。
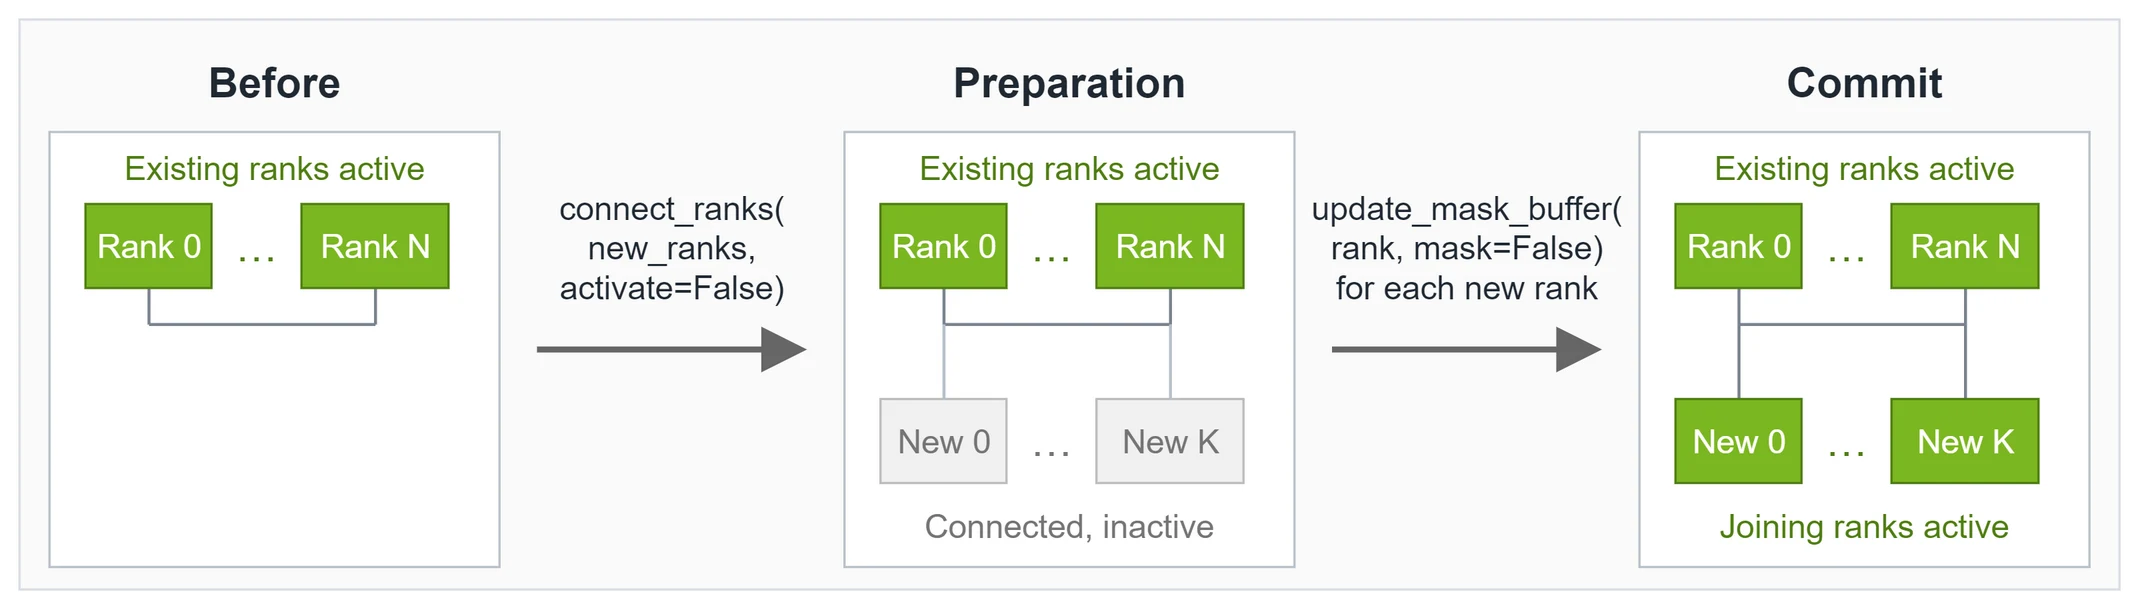
図 1. 新しい EP ピアの接続とアクティブ化。緑のランクはアクティブ、灰色のランクは接続済みだがマスクされています。コミットフェーズでは、エージェントやバッファを置き換えることなく新しいピアがアクティブ化されます。
vLLM は引き続き、ターゲットトポロジー用に新しい DP コーディネーショングループと EPLB グループを作成しますが、 それらの通信はキャプチャされたモデルのフォワードパスの外側で実行されるため、それらへの切り替えは CUDA グラフを無効化しません。
既存ワーカーで CUDA グラフを維持する
CUDA グラフは GPU 操作を記録するもので、vLLM は CPU から各操作を繰り返し起動することなくフォワードパスを再生できます。キャプチャされたカーネルノードには、その起動構成と引数値(入力テンソルおよび出力テンソルへのポインタを含む)が含まれます。メモリの内容は再生の間に変化しうりますが、記録されたポインタは有効であり続けなければなりません。これらの要件は、 CUDA グラフ実行コントラクト.
の一部です。vLLM は バッチ形状や実行モードごとに個別のグラフをキャプチャし 、各キャプチャの前にウォームアップフォワードパスを実行します。
キャプチャされた CUDA グラフを維持するには、コミュニケータオブジェクトを生かしておくだけでは不十分です。NIXL EP は、再構成を跨いでカーネルの起動構成、グラフから見える通信引数、入出力テンソルのアドレスも安定に保ちます。そのカーネルは、インプレースで更新可能なデバイス状態からアクティブグループのメンバーシップを読み取ります。
また、再構成を跨いで周囲の計算カーネルのキャプチャされた引数、起動構成、入出力テンソルのアドレスを安定に保つよう vLLM を変更しました:
- 再構成時に異なるアクティブ EP サイズ向けに作り直すのではなく、保持されたワーカーの fused-MoE 実行オブジェクトを再利用します。
- キャプチャされたエキスパートカーネルが使用し続けられるよう、グラフから見えるワークスペースおよびディスパッチ出力のアドレスとレイアウトを再構成を跨いで安定に保ちます。ディスパッチ出力はエキスパート計算への入力としても機能します。そのアドレスやレイアウトが EP サイズに応じて変化すると、キャプチャされたエキスパートカーネルは古いポインタとオフセットを使い続けることになります。
- エキスパートルーティングテンソルの基盤ストレージを保持し、マッピングをインプレースで更新します。これにより、EPLB はキャプチャされたカーネルが使用するテンソルを移動することなく、マッピングの内容を変更できます。
これらの変更により、保持されたワーカーはスケールアップ後もスケールダウン後も 既存の CUDA グラフを再利用 できます。
参加ワーカーを独立して準備する
既存ワーカーには維持すべきグラフがあります。参加ワーカーにはありません。
参加ワーカーは通常、EP のディスパッチとコンバインを伴うモデルのフォワードパスを実行し、他のワーカーとバッチ情報を交換することで準備を行います。これらのステップは他のワーカーの参加を必要としますが、既存ワーカーは現在のトポロジーで実際のリクエストをすでに処理しています。
NIXL EP により、各参加ワーカーはウォームアップとグラフ準備の間、すべてのリモート EP ピアを一時的にマスクできます。EP 通信に対してアクティブなのはそのワーカーのローカルランクのみです。また、これらの準備パスが他のワーカーからの DP バッチ情報を待機しないよう vLLM を変更しました。これにより、参加ワーカーは既存ワーカーの参加を必要とせずにダミーバッチを実行し CUDA グラフをキャプチャできます。
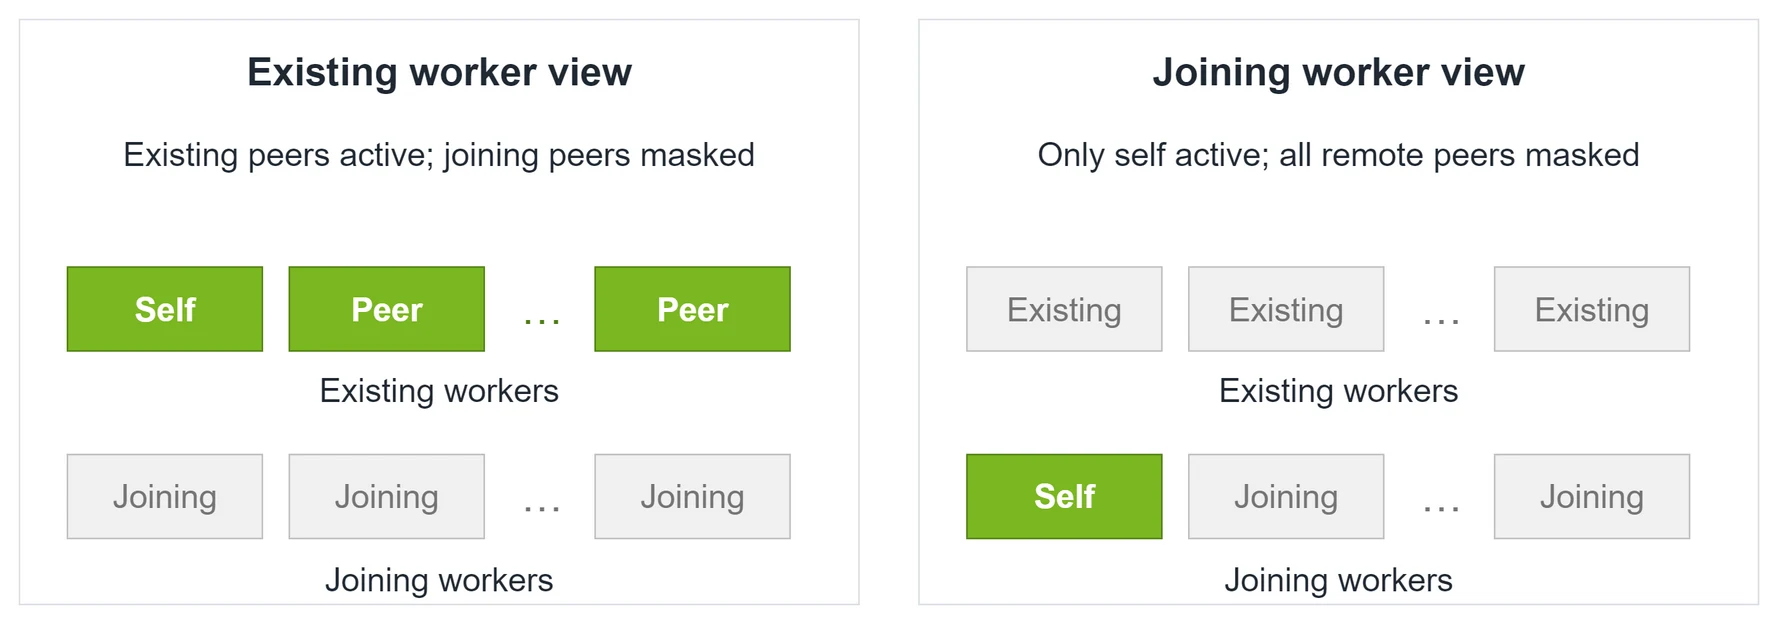
図 2. 緑のランクは EP 通信に対してアクティブ、灰色のランクはマスクされています。既存ワーカーは共に処理を行う一方、各参加ワーカーは準備のためにすべてのリモート EP ピアをマスクします。
キャプチャ後、NIXL EP はグラフを無効化することなくピアを再アクティブ化できます。参加ワーカーは、拡張されたグループの一員として処理を開始する際に、ローカルでキャプチャしたグラフを再利用します。
DeepSeek V4 Pro でのパフォーマンス
本セクションのすべての実験では、GB200 GPU 上で TP=1、DP/EP サイズ 16 および 20 で DeepSeek V4 Pro GB200 GPU上で、TP=1、DP/EPサイズ16および20で実行しました。モデルの重みは、共有Lustreストレージ上にsafetensors形式で事前ダウンロードしており、デフォルトの --load-format autoを使用してロードしました。測定ではウォーム済みのカーネルコンパイルキャッシュ(Triton、TileLang、および FlashInfer)を使用しました。
スケールアップとスケールダウンのタイミング
この表は、どのステージがサービス一時停止中に実行され、どのステージが既存のワーカーがサービスを提供し続ける一方でバックグラウンドで実行されるかを示しています。
| ステージ | A: ブロッキング | B: 非同期準備 | C: 非同期準備 + グラフ再利用 |
|---|---|---|---|
| 参加するワーカーの初期化 | サービス一時停止中 | バックグラウンド | バックグラウンド |
| ターゲットとの通信を準備 | 提供を一時停止 | バックグラウンド | バックグラウンド |
| モデルの重みを転送 | 提供を一時停止 | バックグラウンド | バックグラウンド |
| 参加するワーカーでのウォームアップとグラフキャプチャ | 提供を一時停止 | 提供を一時停止 | バックグラウンド |
| 既存のワーカーでのウォームアップとグラフキャプチャ | 提供を一時停止 | 提供を一時停止 | 不要(既存のグラフは有効なまま) |
| ターゲットのトポロジーを有効化 | 提供を一時停止 | 提供を一時停止 | 提供を一時停止 |
構成Cはサポートされる NIXL EP のみでサポート.
- ダウンタイム: 実際に観測される提供の中断。処理中のリクエストが進行を停止し、新しいリクエストが受け付けられなくなる期間。
- 合計時間: 準備を含むスケーリング操作全体の所要時間。
この2つの時間は別々に測定されます。
| 指標 | A: ブロッキング | B: 非同期準備 | C: 非同期準備 + グラフ再利用 |
|---|---|---|---|
| 16~20 GPUs: ダウンタイム | 99.62 秒 | 58.04 秒 | 0.82 秒 |
| 20から16 GPU: ダウンタイム | 56.25 s | 44.07 s | 1.96 s |
| 16から20 GPU: 合計時間 | 99.72 s | 97.27 s | 92.34 s |
| 20から16 GPU: 合計時間 | 56.21 s | 51.46 s | 9.32 s |
すべての構成で数値の正しさの検証に合格しました。これには、参加するすべてのワーカー上での検証も含まれます。
GPUを追加しながらSLOを維持する
DeepSeek V4 Proを16 GPUで提供し、その後、着信リクエストレートを毎秒約8から16リクエストへと徐々に増加させました。同じ11,391リクエストのシナリオを3つのデプロイに対して再生しました。1つは16 GPUのまま、1つは20 GPUで再起動、もう1つはNIXL EPを備えたElastic EPを使用して20 GPUにスケールしました。サービスレベル目標(SLO)は、ローリングp95の最初のトークンまでの時間が5秒未満であることでした。
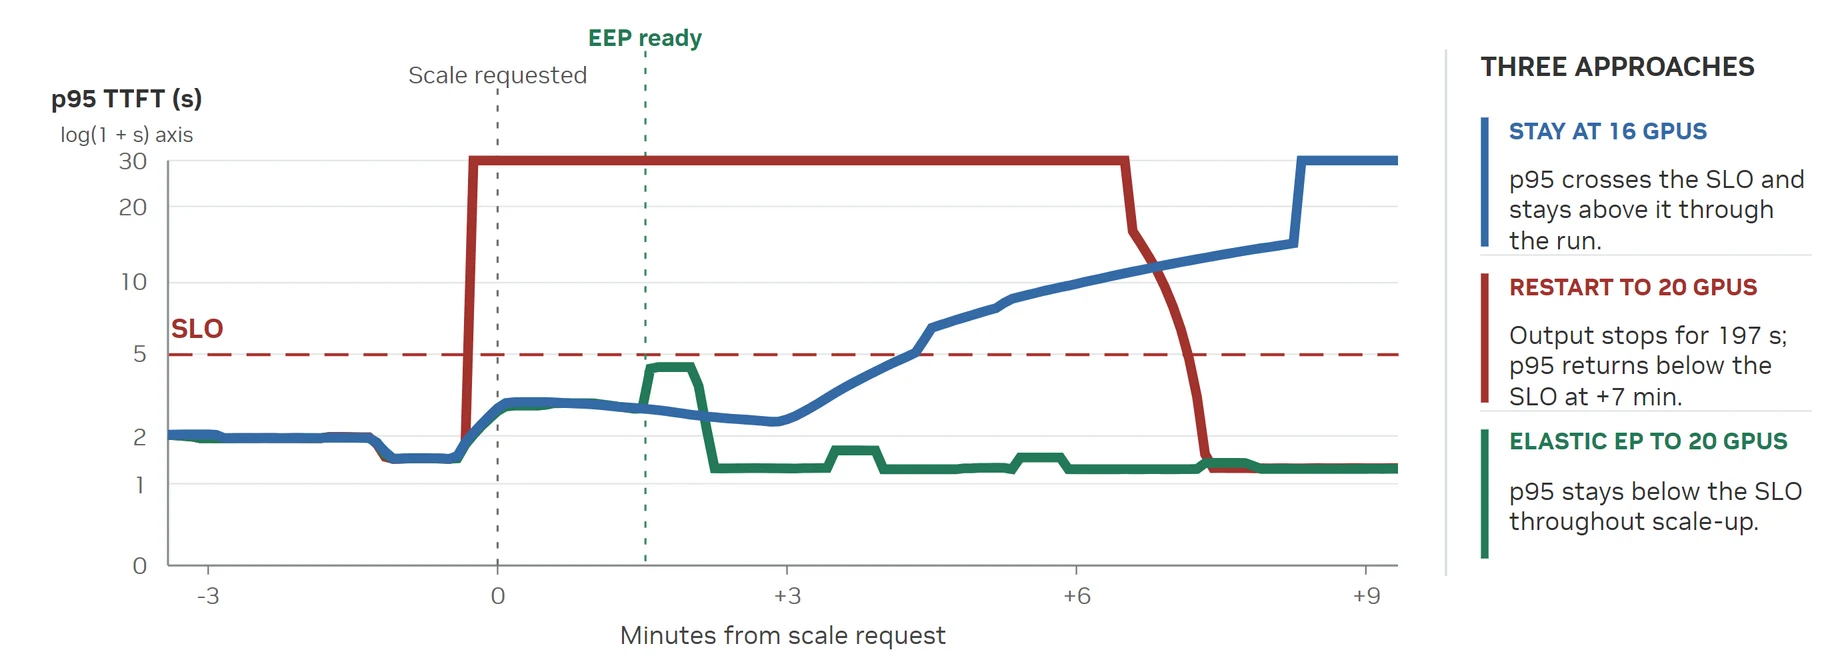
図3. リクエスト負荷の増加に伴うエンドツーエンドの提供。曲線は30秒のローリングp95の結果を示し、失敗したリクエストには測定されたTTFTではなく30秒のペナルティが割り当てられています。
- Elastic EPは11,391件すべてのリクエストを完了し、シナリオ全体を通じてSLOを下回り続けました。
- 準備中、Elastic EPは静的な16 GPUデプロイの提供性能と同等であり、バックグラウンドでの準備による目に見える劣化はありませんでした。
- スケーリング後、Elastic EPは回復した20 GPUデプロイの性能と同等であり、スケール後の目に見える劣化はありませんでした。
Elastic EPを試す
バックグラウンド準備、CUDAグラフの再利用、および参加するワーカー上での独立したグラフキャプチャは、すべて最新の vLLM および NIXL リリースで今日すぐに利用可能です。pipでインストールし、Elastic EPの使用を開始してください。
完全な使用例については、 cuda_graphs_heavy_nixl_ep vLLMのElastic EPテストのケースを参照してください。この例には、サーバー設定とスケーリングAPI呼び出しが含まれています。リクエストを送信しながら2 GPUから4 GPUへ、そして元に戻すスケーリングを行い、準備中の提供状況と各リサイズ前後のモデル精度を確認します。
次に来るもの
Dynamo Snapshotでウォームなワーカーを復元する
私たちは長いサービス中断を実質的に解決しました。次の課題は、新しい容量をより早く準備することです。私たちは統合を計画しています Dynamo スナップショット これにより、後から参加するワーカーが初期化済みのプロセスと CUDA 状態を復元でき、コンパイル、カーネルのウォームアップ、グラフ構築、その他の起動処理を繰り返さずに済みます。
ターゲットトポロジー向けの通信は、スナップショットから復元されないため、別途準備する必要があります。チェックポイントストレージから大規模なモデルの重みを復元する処理が復元時間の大半を占める可能性があるため、既存ワーカーからの Elastic EP の GPU 間の重み転送を維持する計画です。
NIXL EP で最先端の EP 通信を実現する
私たちは、Elastic EP とフォールトトレランスを完全にサポートしながら、NIXL EP による最先端の dispatch と combine のパフォーマンスを目指しています。近日予定されている NIXL EP のパフォーマンス更新は、その目標に向けた次のステップです(詳細は NIXL EP ロードマップ RFC).
Elastic EP を Dynamo および llm-d のオーケストレーションに接続する
エンジンレベルの機能が整ったので、次のステップは、オーケストレーターのオートスケーラーから Elastic EP を利用できるようにすることです。この統合に向けた取り組みは、すでに vLLM、Dynamo、llm-d の各コミュニティを横断して進められています。
これらの取り組みには、 vLLM の外部ロードバランサーに関する作業 や Dynamo の Elastic EP 提案.
大規模に推論を実行している場合は、Elastic EP を試し、ワークロードや運用要件を共有していただければ幸いです。推論インフラを構築している場合は、vLLM Elastic EP および NIXL EP への貢献を歓迎します。Elastic EP を本番環境で動かしましょう。
謝辞
- Red Hat の Tyler Michael Smith 氏と Sage Moore 氏に、この作業を通じて多大なフィードバックと綿密なレビューをいただき感謝します。
- 準備期間中のサービング性能に関する取り組みに対し、NVIDIA の Linoy Geva 氏に感謝します。
- NIXL EP への取り組みに対し、NIXL チーム全体に感謝します。
- Dynamo における Elastic EP のサポートへの取り組みに対し、Tzu-Ling Kan 氏、Julien Mancuso 氏、および Dynamo チーム全体に感謝します。