
TorchNeuronは、AWS Trainium上でのPyTorchの新しいネイティブバックエンドを提供します。Transformers、Diffusers、Kernelsがネイティブにサポートするため、Trainium上でモデルを実行したり、HF hubで共有したりすることがこれまでよりも容易になります。
TorchNeuron
TorchNeuronは、Trainiumの新しいバックエンドを提供するPyTorchプラグインであり、eagerモード、torch.compile、FSDPやTPのようなネイティブ分散APIのサポートが可能になります。
TorchNeuronについてさらに詳しく知るには、PyTorchのブログをご覧ください。
2026年10月20日から、TorchNeuronはパブリックベータとして利用可能になります。研究者や開発者はpip install torch-neuronxを使ってインストールすることができます。
新しいバックエンド、HFライブラリ内のネイティブインターフェース
現在までに、AWS TrainiumおよびInferentia上でのHugging Faceの体験――それぞれ、コスト効率の高い大規模なトレーニングと推論のために設計されたAIチップである――は、optimum-neuronを通じて実現されている。このライブラリはtorch-neuronxパッケージに依存しており、これはPyTorch XLAを基盤としている。当時は自然な選択であったが、コンパイラのように考える必要があった。即時実行ではなくレガシティテンソル、静的形状のみ、グラフの破断ごとに再コンパイルが必要だった。Optimum Neuronはその複雑さを隠すために存在し、モデリングクラス、トレーナーなど、カスタムコードを維持していた。
TorchNeuronはこれを変更します。PyTorchに直接統合され、neuronをネイティブデバイスとして提供し、Eager実行、PyTorch自身の分散プリミティブ(DTensor、FSDP2)、およびtorch.compileが利用可能です。
Hugging Faceライブラリについては、Trainiumは他のデバイスと同様に機能します。Transformers、Diffusers、Accelerate、PEFT、TRLは、他のアクセラレーターで使用するのと同じクラスやスクリプトを使って直接実行できます。今以降、NeuronユーザーはOptimum Neuronを利用する代わりにこれらのライブラリを直接使用することを推奨します。
Transformers
推論
Transformersでは、さまざまなモデルに対してテキスト生成がネイティブにサポートされています。TorchNeuronを使用すると、最もよく使われている100のテキスト生成モデルアーキテクチャの89%が標準でサポートされており、Optimum Neuron v0.4.5では46%のみがサポートされていました。コード内でdevice_map=neuron引数を指定するだけで、モデルがNeuronデバイスに移動します。
以下は、テンソル並列性を利用したテキスト生成の例です。これにより、Neuronインスタンスから最大限の利益を得ることができます。Neuronでは頻繁な再コンパイルを防ぐために、生成時に静的キャッシュを使用することが強く推奨されることに注意してください。
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
トレーニング
NeuronがPyTorchのネイティブデバイスとなった今、Trainium上でのトレーニングには、他のアクセラレーターと同様にHugging FaceライブラリであるTransformers、Accelerate、PEFT、TRLが使用されます。専用のトレーナーやNeuron特有のモデルコードのフォークは必要ありません。標準的なTRLフィネケイングスクリプトは、わずか数個のNeuron特有の設定を加えるだけでTrainiumインスタンス上で実行されます。
TRLのSFTTrainerを基に構築された監視下でのファインチューニングスクリプトです。以前にGPU上でTRLを用いてモデルをファインチューンしたことがある場合、このスクリプトは見覚えがあるはずです。
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser


def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

    # Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()


if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
並行処理はTransformersによって自然に処理されます。DistributedConfigをmodel_init_kwargsに、テンソル並列(TP)とFSDPのサイズを記述します。SFTTrainerはそれをfrom_pretrainedに渡し、モデルの重みが読み込まれる際にシャード化されます。Trainerはモデルがすでに分散されていることを知っており、再びラップすることはありません。--fsdpフラグやAccelerate FSDPの設定は必要ありません。
スクリプトの中でTrainiumに関連するものは何もありません。同じコードはどんなハードウェアでも動作します。Trainium上で実行する際には、いくつか注意すべき点があります。
- 静的形状。このスクリプトは
torch.compileでの自動的な動的形状の生成を無効にし、包み込みパッキング方式を用いて最大2048個のトークンまでのシーケンスを生成する。TRLが1.16以上の場合、Neuron上のバッチは128個のトークン倍にパディングされ、入力形状の数が制限される。コンパイルされたグラフは同じ形状で後続のステップに再利用される。 torch.compileを有効にしています。--torch_compile trueを指定するだけで十分です。Trainiumインスタンスでは、torch.compileがデバイスを検出し、Neuronバックエンドを自動的に選択します。その他の設定は不要です。- 非同期重量負荷の解除。 Transformersに内蔵されている非同期重量負荷機能はNeuronではサポートされていないため、現時点では
HF_DEACTIVATE_ASYNC_LOAD=1で無効にしています。
以下のコマンドはtorchrunを使ってトレーニングを開始し、NeuronCoreごとに1つのプロセスが実行されます。TP_SIZEとFSDP_SIZEは並列化の構成を指定し、その積がプロセスの数となります。ここでは4 x 8 = 32で、--nproc_per_nodeと一致します。32のプロセスは4 x 8のグリッドを形成します。テンソル並列化では各層をTPグループの4つのコアに分割し、FSDPではパラメータ、グラディエント、オプティマイザー状態を8つのTPグループに分散します。
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
8個のTrainium2チップ(32個のNeuronCores)で実行しました。これはtrn2.48xlargeインスタンスの半分です。
トレーニングを完了し、trainer.save_modelが標準のTransformersチェックポイントを作成します。その中にはNeuronに関連するものは何もありません。Hugging Face Hubに直接プッシュして、他のハードウェアで読み込むことができます。
Diffusers
推論
Diffusersライブラリの多くのパイプラインは、eagerモードおよびコンパイルモードでTorchNeuronと互換性があります。FLUX.1-dev、FLUX.2、Qwen-Image、Qwen-Image-2.1、H3も、Neuronデバイスを最大限に活用するためにテンソル並列性に対応しています。以下は、TPをどのように使用できるかを示す例です。
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
このコードを次のように実行できます:NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py.
ますます多くのパイプラインがTPと互換性を持つようになるでしょう。好きなパイプラインが互換性がない場合は、このガイドに従ってそのサポートを追加することができます。
カーネル
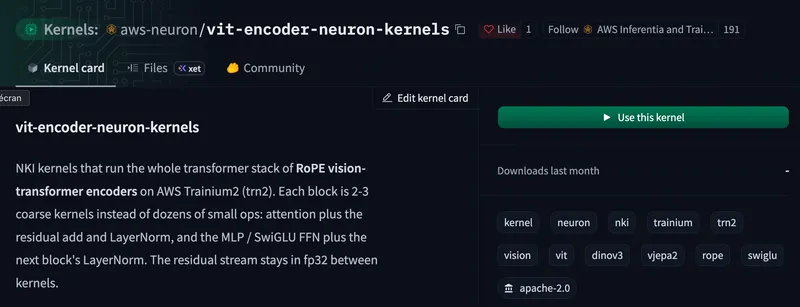
Neuronチームのkernelsもぜひご覧ください。NeuronのkernelsがHub上で次々と利用可能になり、モデルの実行を高速化します。 Neuronのkernelsは、操作を最適化するための制御を低くするNeuron Kernel Interface (NKI)を使用して作成できます。この方法により、ユーザーは独自のカスタム操作を実行し、Hub上で共有することができます。
例えば、このカーネルを使用することで、Trainium上でビジョン・トランスフォーミングモデルの速度をx2.4倍まで向上させることができます!

謝辞
TorchNeuronに関する作業や、HF統合を可能な限り良くするために私たちのフィードバックに対して迅速に対応してくれたAWSチームに特別な感謝をします。