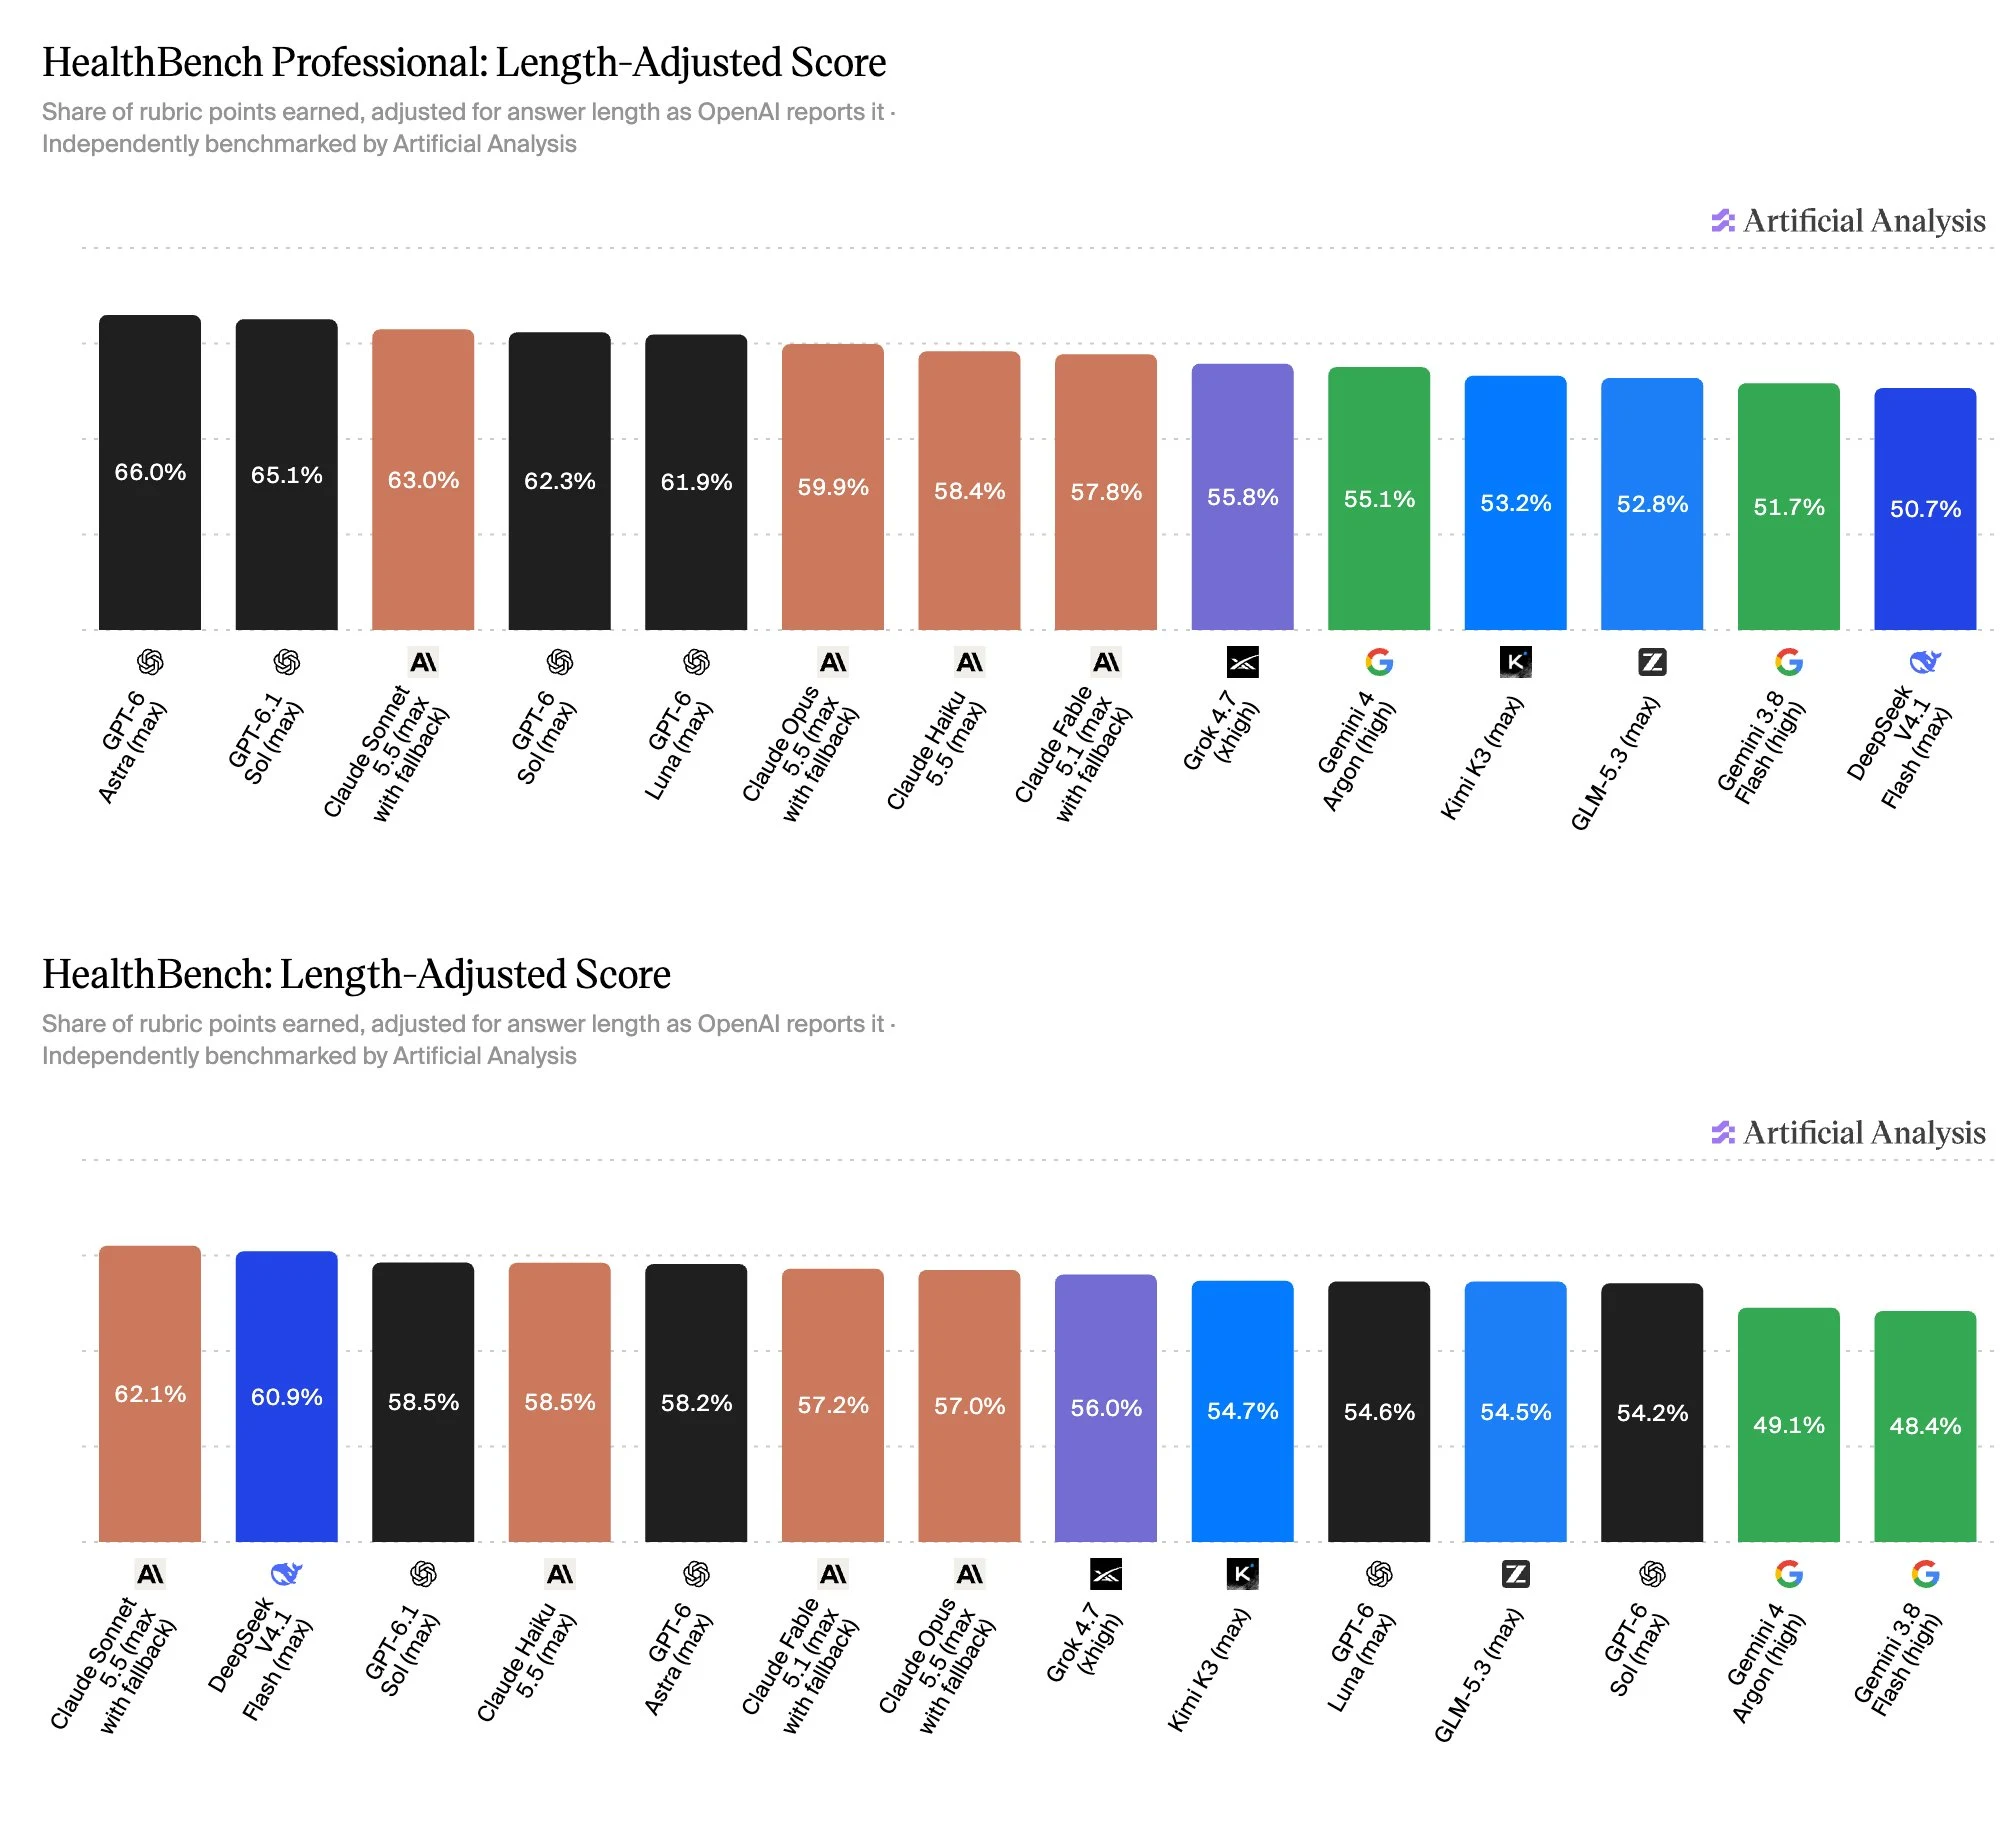
HealthBenchとHealthBench Professionalのリーダーボードを開始します。これらは、AIモデルが実際の健康に関する会話でどのように反応するかを評価するベンチマークです
HealthBenchとHealthBench Professionalは、@OpenAIが提供するベンチマークであり、医師が作成した基準に基づき、現実的な健康に関する会話に対するモデルの応答を評価します。
HealthBenchは、日常的なユーザーと医療従事者による5,000件の健康に関する会話を対象にモデルをテストしています。緊急対応からグローバルヘルスまで、7つのテーマを網羅しており、各評価基準は正確性、完全性、コミュニケーションの質、文脈理解、指示遵守の5つの軸のいずれかに属します。HealthBench Professionalは525件の会話からなるより小規模なセットで、HealthBenchとは異なり、すべて医師による会話です。 これらは相談、執筆、研究のタスクを含み、モデルに挑戦するための対立的で難しい会話も含まれます。
OpenAIが報告する生のスコア(評価項目のポイント獲得率)と、長さ調整されたスコアの両方を報告する。長さ調整されたスコアは、2,000文字を超える回答のスコアを下げ、短い回答のスコアを上げる。OpenAIの元の実装に従って、回答はGPT-5.4(低)(HealthBench Professional)とGPT-4.1(HealthBench)によって評価される。
HealthBench Professionalの主要結果:
➤ GPT-6 AstraとGPT-6.1 Solがランキングトップに:GPT-6 Astra(最大値)は長さ調整後のスコアで66.0%を記録し、GPT-6.1 Sol(最大値、65.1%)と同等であり、Claude Sonnet 5.5(フォールバック時の最大値、63.0%)よりも優れています。
➤ OpenAIモデルが全体のスコアおよびタスクあたりのコストのパレートフロントを形成する:パレートフロントはGPT-6 Luna(最大、61.9%、タスクあたり$0.004)からGPT-6 Sol(最大、62.3%、$0.036)、GPT-6.1 Sol(最大、65.1%、$0.047)まで、そしてGPT-6 Astra(最大、66.0%、$0.27)で構成される。GPT-6 Luna(最大)のスコアは、GPT-6 Astra(最大)より4ポイント低く、コストの2%未満である。
➤ Claude Opus 5.5とClaude Fable 5.1は最も大きな長さのペナルティを受ける:どちらも回答あたり平均で約5,900文字で、2,000文字の閾値のほぼ3倍であり、調整後には11点以上を失う。Claude Opus 5.5(フォールバックを使用した最大値)は最も高い生のスコア(71.4%)を持つが、6位に下がる(59.9%)。GPT-6 Sol(最大値)だけが平均して2,000文字以下(約1,600文字)であり、スコアが上昇する唯一のモデルである。
HealthBenchの主要結果:
➤ Claude Sonnet 5.5はHealthBenchで最高:Claude Sonnet 5.5(フォールバックを使用した最大値)は、長さ調整済みスコアで62.1%を記録し、DeepSeek V4.1 Flash(最大60.9%)やGPT-6.1 Sol(最大58.5%)を上回りました。
➤ GPT-6 Luna、DeepSeek V4.1 Flash、Claude Sonnet 5.5のスコアとタスクあたりのコストのパレートフロントライン:GPT-6 Luna(最大)はタスクあたり0.002ドルで54.6%、DeepSeek V4.1 Flash(最大)はタスクあたり0.005ドルで60.9%のスコアを記録する。Claude Sonnet 5.5(フォールバック機能付き)の平均タスクあたりコストは0.08ドルで、約1ポイントのスコア向上に対してDeepSeek V4.1 Flashより約16倍高くなる。
➤ 短い回答は完全性を犠牲にしてコミュニケーションの質を求める:HealthBenchの評価項目は5つの軸のうちの1つに分類される。完全性とは、回答がすべての重要な情報を含んでいるかどうかを指し、コミュニケーションの質とは、明確で構成が整っており、適切な長さと詳細度であるかどうかを指す。GPT-6 Sol(最大)は最も短い回答(約1,000文字)を書き、最も高い生のコミュニケーションの質スコア(81%)を持つが、最も低い完全性スコア(34%)を持つ。 クロード・ソネット5.5(フォールバック時の最大値)が完全性で首位です(63%)