
允中 凹非寺より
量子位 | 公衆号QbitAI
汎用モデルからパーソナライズされた知能へと、人工知能の競争は長期的な学習と専属能力の蓄積へと拡大しつつある。
通衍霊智は、パラメータ化学習と継続的な進化を核とするPersonal AIを模索し、個人や組織がAIを使用する過程で、徐々に自らの知的資産を蓄積できるようにしている。
ここ数年、大規模モデルは能力の限界を突破し続けており、ますます多くの企業がAPI、ナレッジベース、Agentを通じて、AIを研究開発、投資調査、運営などの基幹業務に導入し始めている。
しかし、AIが実際の業務に携わる時間が長くなるにつれ、新たな問題が浮上し始めた:企業が毎日生み出す大量の業務経験は、モデルに一時的に呼び出されるだけなのか、それとも徐々に自社のAI能力として蓄積できるのか?
世界のテック企業はすでにこの方向を模索し始めている。
OpenAIはDreamingによってChatGPTの長期記憶を改良し、過去のやり取りを総合して、ユーザーの好み、プロジェクトの背景、長期的なニーズをよりよく理解できるようにした。Metaが発表したMuseは、パーソナライズされた理解と自律的な実行をさらに組み合わせ、Personal Agentを質問への回答から実際のタスクの遂行へと前進させている。
長期記憶であれ主体的な実行であれ、共通して浮かび上がる傾向がある:AIは、すべての人に向けた汎用ツールから、特定のユーザーに向けた長期的な知能サービスへと発展しつつあるのだ。
北京通用人工知能研究院産業プラットフォームCEOの李未氏は次のように考える:「基盤モデルが強力であればあるほど、パーソナライズされた知能が発揮できる役割は大きくなります。私たちが期待しているのは、新しい技術分業です。先進的な基盤モデルが共有の汎用能力を提供し、パーソナライズされたモデルは長期的なインタラクションと継続的な進化学習を通じて、さまざまな主体のニーズに合った専属能力を徐々に形成していきます。」
注:通衍霊智は、北京通用人工知能研究院(BIGAI)体系の科学研究の蓄積と産業化リソースに依拠し、企業および個人に向けた継続的に自己進化する専属モデル(Personal AI)の研究開発に注力している。パーソナライズされたモデルの訓練、継続学習、基盤となる計算能力の最適化を通じて、専門知識と業務経験を、持続的に進化可能な専属の知的能力として蓄積することを推進している。
パーソナライゼーションが業界全体の関心事となると、技術的な模索もモデルの内部へと向かい始めた。
ユーザーの情報を記憶するだけでなく、AIは個人や組織が長年培ってきた経験を本当に学べるのか?これらの能力は使用とともに継続的に更新でき、基盤モデルを切り替えた後にも保持できるのか?専属モデルの数が増え続けるなか、訓練と実行のコストはどう管理すべきなのか?
通衍霊智は技術の方向性をRecursive Self-Improving Personal AI(再帰的自己進化型パーソナライズ知能)に絞り、上述の問題に対する体系的な解決策を提供することを試みている。
北京通用人工知能研究院体系の科学研究と産業リソースを基盤に、同社は既存の汎用モデルの上に、軽量なパーソナライズパラメータで各主体の専属能力を担わせ、継続学習の仕組みと計算資源のスケジューリング技術を組み合わせることで、モデルが長期的な使用の中でユーザーに継続的に適応できるようにすることを選んだ。
この技術体系の目標は、個人、プロジェクト、企業がそれぞれ完全な汎用大規模モデルを訓練しなくても、自らのニーズに合い、継続的に進化できる専属の知能を徐々に構築できるようにすることである。
長期記憶からモデルの学習へ、パーソナライゼーションがパラメータ層へ
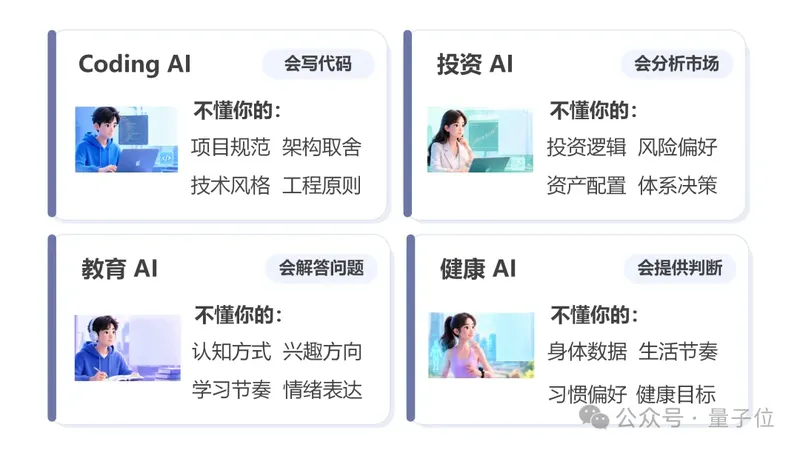
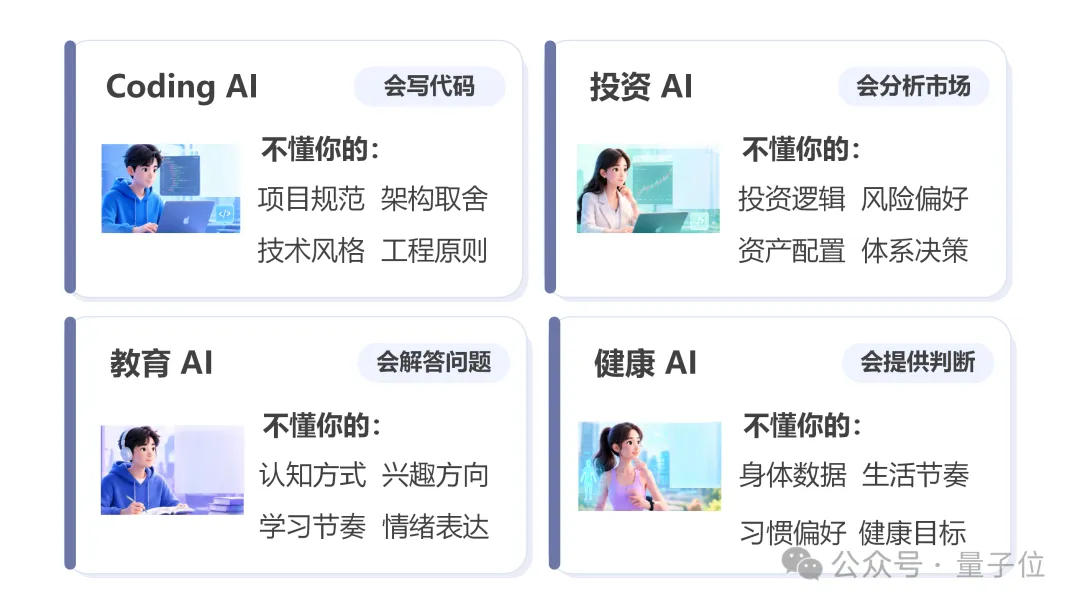
同じCoding Agentを使っても、異なる開発チームが得られる結果には明らかな差が生じることがある。
成熟したソフトウェアシステムには、独自のアーキテクチャ原則、技術規範、過去の制約があるものだ。ベテランのエンジニアは、どのモジュールを安易に変更してはならないかを知っており、技術的に最適な解よりも安定性を優先すべき場面も心得ている。
こうした経験の一部はドキュメントに記録されているが、多くは長期にわたるコードの修正、方式の議論、プロジェクトの実践の中に散らばっている。
同様の状況は、金融投資調査や企業運営などの分野にも存在する。汎用モデルは市場を分析し、業務プロセスを理解することはできるが、各チームが長年形成してきたリスク許容度、意思決定の習慣、仕事の進め方は、継続的な協働を通じてしか徐々には習得できないことが多い。
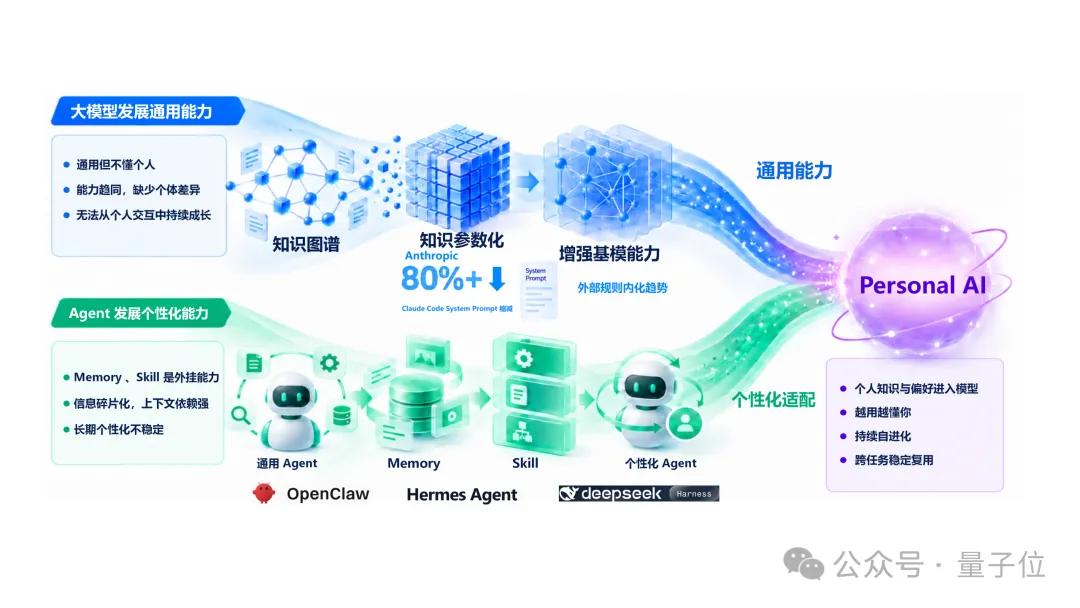
現在、AIは主にPrompt、RAG、Memory、Skillなどの仕組みによって具体的なシーンに適応している。これらはそれぞれ、命令による制約、知識検索、状態の保存、能力の再利用といった役割を担い、企業が大規模モデルを応用する上で重要な構成要素となっている。ただし、この種の仕組みは主にモデルの外部で情報を組織しており、モデル自体のパラメータは通常、一度の業務インタラクションによって変化することはない。
パーソナライゼーションのニーズが情報取得から長期的な行動パターンへと広がるなか、パラメータ化学習がもう一つの技術的選択肢を提供する。
通衍霊智は、共有基盤モデル(Base Model)とパーソナライズパラメータ(Personal Parameters)を組み合わせたアーキテクチャを採用している。基盤モデルは汎用的な知識と推論能力を提供し、異なる個人、プロジェクト、企業は軽量なPersonal LoRAによってパラメータの適応を行い、検証済みの専門的な選好や行動特性を段階的にモデルへと溶け込ませていく。
従来の業界別モデルが主に業界間の能力差の解決を扱っていたのと比べ、この路線はさらに、同じ業界・同じタスクにおける利用者間の差異に注目する。例えば、同じソフトウェア開発でも、二つのプロジェクトは全く異なるエンジニアリング規範を必要とするかもしれない。同じ投資調査でも、チームごとに独自の評価基準やリスク規律を持つ。
これは、ナレッジベースや長期記憶の価値が失われるという意味ではない。動的な知識は依然として検索が必要であり、タスクの状態は依然として記録が必要であり、長期的な実践の中で繰り返し現れる比較的安定した行動パターンは、さらに訓練によってパラメータ化された能力へと転換できる。
これによりパーソナライゼーションは、「モデルにユーザーに関するより多くの情報を把握させること」から、「モデルがユーザーのニーズにより適合した能力を形成すること」へと段階的に拡張されていく。
通衍灵智のCEOである謝枭楠は次のように述べた。「企業のAIへの需要は、汎用能力の獲得から専属能力の蓄積へと移りつつある。同じ種類の汎用インテリジェンスサービスはますます多くの企業が利用できるようになるが、真の差を生むのは、自社が長年培ってきた専門的判断や物事の進め方をモデル能力として蓄積できるかどうかであり、永遠に『資料調べ』のレベルにとどまることではない。」
モデルを実務の中で成長させる鍵は、信頼できる学習メカニズムの構築である
専用パラメータを持つようになると、新たな課題が生まれます。モデルがどのように価値ある経験を継続的に吸収し、学習過程での誤りの蓄積を回避するのかという点です。
企業がAIを日常的に使用すると、大量のフィードバックが生まれます。開発者はコードを受け入れたり修正したりし、営業担当者は顧客とのコミュニケーション戦略を調整し、投資マネージャーはリサーチの結論を修正します。これらの行動にはすべて潜在的な学習シグナルが含まれています。しかし、単発のフィードバックが必ずしも長期的な法則を代表するとは限らず、一度の成功した判断も、同じ戦略がすべてのシナリオに適用できることを意味するわけではありません。
やり取りの記録を選別せずにそのまま訓練に使用すると、モデルは偶然の選好を強化し、さらには本来の能力を損なう可能性さえあります。そのため、継続学習には、有効なフィードバックを識別し、更新効果を評価し、モデルの挙動変化を制御できる仕組みの構築が必要です。
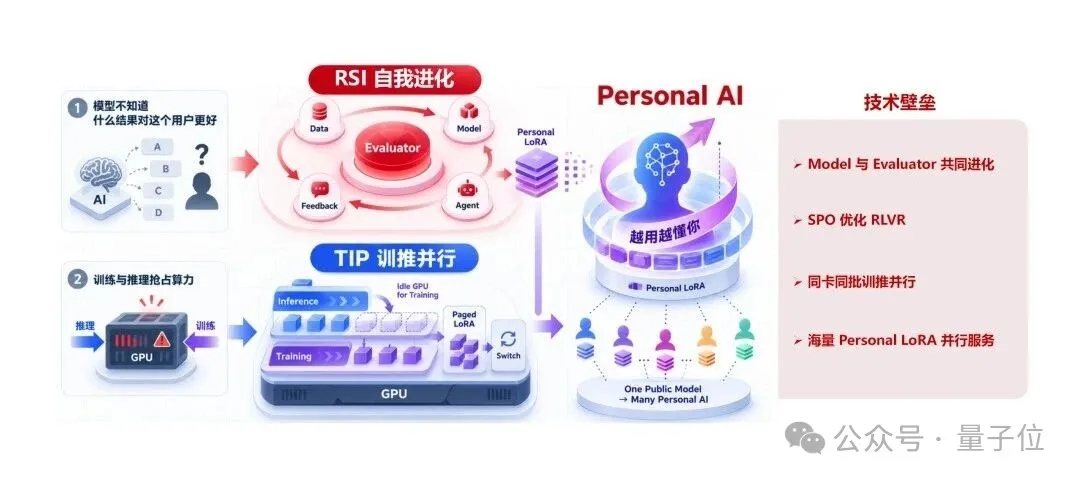
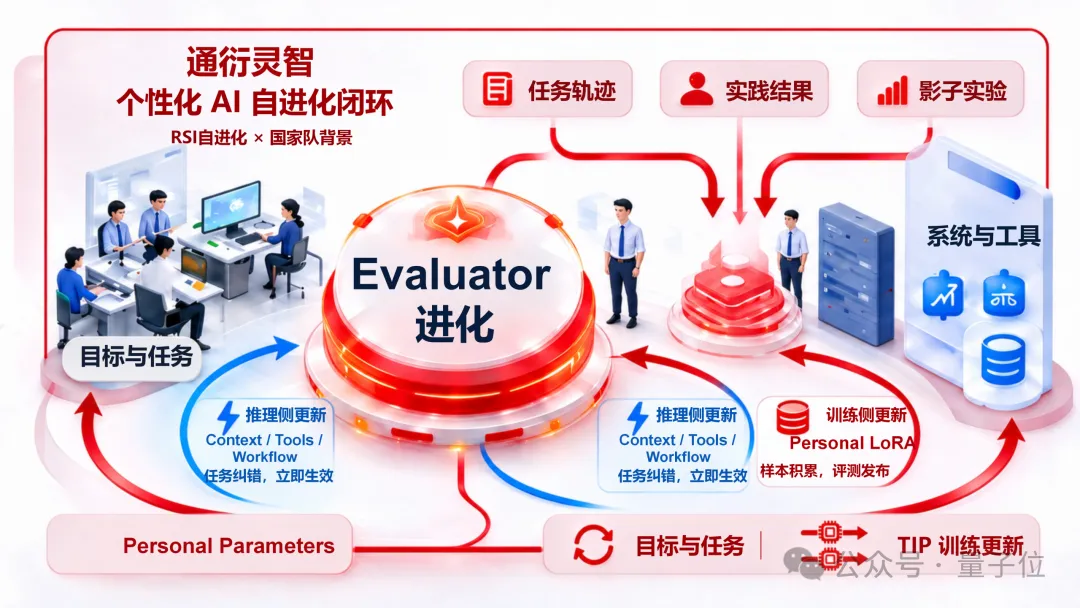
通衍霊智(トンイェンリンジー)はこのニーズを踏まえ、RSI(Recursive Self-Improvement、再帰的自己改善)技術を研究開発し、モデルと評価器の協調的な反復によって継続学習フレームワークを構築しています。
このフレームワークでは、業務運用で生じたタスク軌跡、人手による修正、実際の結果がまず候補学習データとなり、Evaluatorが具体的なユーザーや企業の評価基準に基づいてフィードバックを選別・判断し、有効なサンプルをPersonal LoRAの増分更新に使用します。
更新後のモデルはさらに評価を受け、元のバージョンとのタスク性能を比較する必要があります。事前に設定した要件を満たす更新のみがサービスに投入され、異常な結果はバージョン管理とロールバックの仕組みによって処理されます。
同時に、モデル更新の実際の効果をEvaluatorの改善に逆に活かすこともでき、システムは学習データの選別方法と評価基準を徐々に最適化していきます。
ソフトウェア開発を例に挙げると、システムはコードレビューの記録を利用して、ある種の修正がなぜ繰り返し受け入れられたり拒否されたりするのかを分析し、その後のタスクを通じてモデルが関連するエンジニアリング要件を本当に習得したかを検証できます。有効なフィードバックが蓄積され続けることで、モデルにはチームが長期的に形成してきた働き方に徐々に適応する機会が生まれます。
この仕組みには、壊滅的忘却、フィードバック汚染、モデルドリフト、更新の安定性といった技術的課題が関わります。通衍霊智は、現在RSIの中核技術路線と製品アーキテクチャはすでに確定しており、関連モジュールはエンジニアリングを進めているものの、完全な自動化クローズドループは依然として継続的な研究開発段階にあると述べています。
通衍霊智のCTOである儲兵兵氏は、訓練の過程で、ユーザーが「拒否」をクリックしただけで直ちにモデルの訓練に使うことは決してなく、導入したEvaluatorがまずこのフィードバックに学習価値があるかを判断すると述べています。一度のフィードバックはあくまでシグナルであり、繰り返し現れるパターンのみが真に学習になり得ます。モデル更新後には、旧バージョンと同じ一連のタスクで再実行して比較し、向上が確認されればリリースし、退化していればロールバックすることで、進化の安全性と効率を確保します。
長期的に見れば、モデルが実際の業務で安定して学習できるようになれば、企業は繰り返しの設定や集中型訓練の作業を削減できる可能性があり、AI能力は業務の発展とともに段階的に更新されていきます。
専用モデルの大規模化に向けて、計算リソースのコストが現実的な課題に
パーソナライズモデルの商用化にはもう一つ現実的な制約があります。それはコストです。
もし一家の企業が将来、数百の職位、数千のAgentに対して異なるモデルパラメータを維持し、同時にこれらのモデルの継続訓練とオンラインサービスをサポートする必要があるなら、従来の独立訓練・独立デプロイ方式は高い計算・管理コストをもたらします。多数の個人ユーザーにサービスを提供するプラットフォームにとっては、リソース効率の重要性はさらに高まります。
そのため通衍霊智は、AIインフラをPersonal AIの重要な構成要素と位置づけ、訓練と推論の協調スケジューリング、および大量のパーソナライズパラメータのGPUメモリ管理を中心に最適化を進めています。
このうち、TIP(訓練推論並列)は主に訓練とオンライン推論の間のリソース配分問題を解決します。従来のアーキテクチャでは通常、モデル訓練と推論サービスを別々に管理しますが、継続学習はこの2種類のタスクがモデルの実行過程で頻繁に交互に行われることを意味します。
通衍霊智は同一カード・同一バッチでの訓練推論並列、非同期勾配累積などの技術により、オンラインサービスを保障する前提で利用可能な計算能力を活用してパーソナライズパラメータの増分訓練を実行し、独立した訓練リソースプールによる追加コストを削減することを試みています。
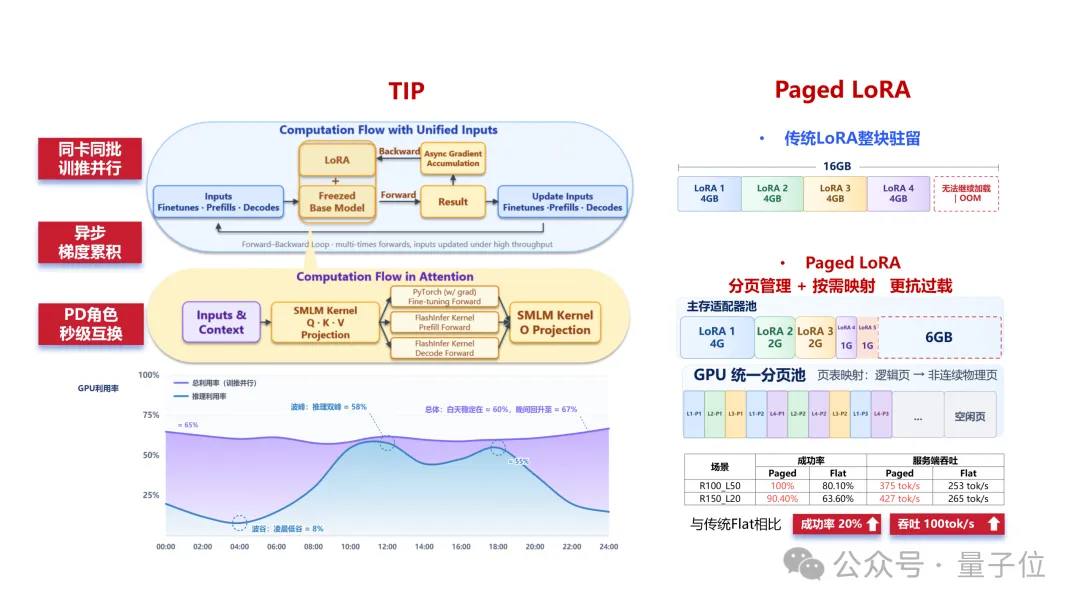
Paged LoRAは、大量のAdapterが同時に実行される際のGPUメモリ管理問題に対応します。従来の方式では比較的大きな固定単位でメモリを割り当てることが多く、モデル数やアクセス頻度の変化に伴い、リソース利用の不十分さや応答レイテンシの変動が生じやすくなります。Paged LoRAはページング管理とオンデマンドマッピング機構を採用し、異なるPersonal LoRAがベースモデルとGPUメモリをより柔軟に共有できるようにします。
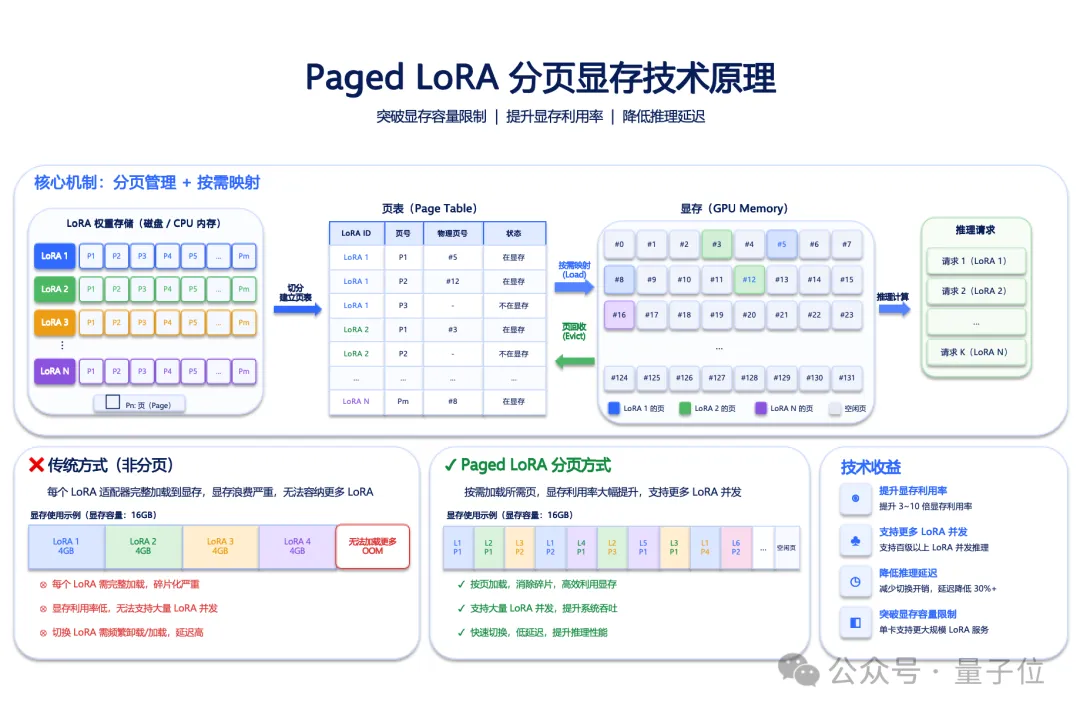
完了した段階的テストでは、通衍霊智はQwen2.5-72B-InstructとNVIDIA H800 GPU 8枚を使用し、Paged方式と従来のFlat方式のLoRAメモリ予算をいずれも5.79GBに統一しました。LoRAリクエスト比率が1%から30%のテスト負荷において、Paged方式は応答レイテンシとロングテール性能の面で一定の優位性を示しました。
テストでは同時に、LoRAリクエスト比率が50%まで上昇すると、頻繁なパラメータのスワップイン・スワップアウトが依然として性能低下を引き起こすことも明らかになりました。チームは非同期ロード、ホットパラメータのプリフェッチなどの方向で最適化を継続しており、関連技術のより広範な本番環境での性能はさらに検証を要します。
儲兵兵氏はさらに、ベースモデルの推論コストは下がっているが、Agentの呼び出し頻度とパーソナライズ訓練の需要は増加していると述べています。継続学習システムに対しては、一度のモデル呼び出しの価格だけを見るのではなく、長期的な訓練・更新・サービスの総合コストを見る必要があり、経済性が合理的であってこそ、この種のサービスはより広範なユーザーをカバーできるのです。
通衍霊智にとって、基盤となる計算能力の最適化はパーソナライズモデルの長期的運用に資するものです。RSIによって継続学習を推進し、さらにTIPとPaged LoRAによって訓練および同時実行サービスのリソース効率を改善することで、同社は専用モデルの利用ハードルを段階的に下げ、高コストなカスタムサービスからより広範な実用化へと進むことを目指しています。
モデルは入れ替わり変わっていく中、知的能力はどう長期的に蓄積・維持されるのか?
ベースモデルの能力、価格、デプロイ方式が変化し続ける中、企業は将来複数のモデルを同時に使用する可能性もあれば、業務の必要に応じて技術基盤を交換する可能性もあります。
AIが日常業務に深く関わるようになると、モデル切り替えに伴うコストは、インターフェースやシステム適合だけに限定されなくなります。企業はさらに、これまで大量の時間をかけて蓄積した訓練データ、作業習慣、人手によるフィードバック、評価基準が、新しいモデル環境でも引き続き役割を発揮できるのかを考える必要があります。
通衍霊智は、共有ベースモデルとパーソナライズ能力の階層化を通じて、単一のモデル基盤への企業の長期的依存を低減することを目指しています。
言うまでもなく、異なるベースモデルの構造とパラメータ空間は本質的に互換性があるわけではなく、Personal LoRAは通常、モデルを跨いで直接再利用できません。しかし、企業がすでに蓄積した業務データ、訓練サンプル、タスク軌跡、評価体系は、新しいモデルの適合と訓練に引き続き使用でき、専用能力を一から構築し直す作業量を削減できます。
この考え方は、企業が自らのモデル評価基準を確立し、汎用指標に完全に依存せず、実際の業務パフォーマンスに基づいて異なるベースモデルを比較する機会をもたらします。
モデルの切り替えと同様に重要なのは、長期的に蓄積されたデータやモデルの成果をどう管理するかという点です。
通衍霊智の製品設計では、共有ベースモデル、企業の業務データ、パーソナライズパラメータが異なる階層に分割されており、データ利用、モデル適合および関連成果の管理に技術的基盤を提供します。具体的なデータ権利、知的財産権、モデル成果の帰属については、契約、認可およびデータガバナンスの仕組みを通じて明確にする必要があり、技術階層化そのものが自動的に法的所有権を生み出すわけではありません。
このアーキテクチャが提供する可能性は、企業がAIを継続的に使用しながら、相対的に独立した訓練データ、評価体系、パーソナライズモデル能力を段階的に形成し、将来のモデル更新や切り替えの際にもこれらの蓄積を引き続き活用できるようにすることです。
個人にとっても同様です。長期間形成された知識構造、専門経験、作業上の好みが、効果的に保存され、新しい知能システムへの適合に継続的に活用されれば、その価値はもはや特定の製品や一回限りのサービスだけに限定されるものではなくなります。
謝梟楠(Xie Xiaonan)氏はさらに、モデルの基盤を切り替えたことで蓄積がゼロに戻ることを企業は心配する必要はないと考えている。本当に企業に属するのは、長期にわたって蓄積された業務データ、タスクの軌跡、人間によるフィードバック、評価体系であり、これらの資産は新しいモデルの上で再適応させることができ、ゼロからやり直すものではない。モデルは切り替えられても、企業の経験がそれに伴ってゼロになってはならない。
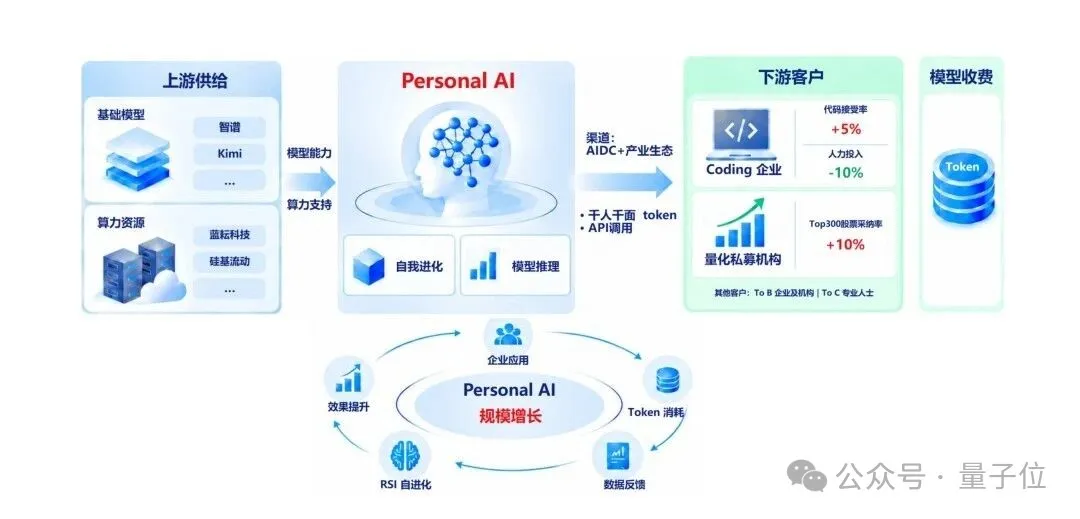
ビジネスモデルの観点から見ると、Personal AIはここから注目に値する一つの方向性を示唆している。AIサービスの価値は、即時のタスク遂行から、さらにユーザーの長期的な知的資産の蓄積へと拡張することができる。
技術の進歩から価値の共有へ、知能を真に人に奉仕させる
人工知能は、知識と生産能力が形成されるあり方を再定義しつつある。
過去、個人の経験は主に自身の認知と実践の中に保存され、企業の専門能力は従業員、制度、業務システム、組織の協働の中に分散していました。AIが社会の生産と日常生活にますます深く関わるようになるにつれ、これらの本来分散していた知識と経験は、体系的に整理され、学習され、再利用される機会を得るようになり始めています。
しかし技術力が向上し続ける一方で、より深い問題についても考える必要がある。
ユーザーが継続的にインタラクション、修正、ビジネスフィードバックを提供し、AIシステムをより知的なものへと進化させる場合、こうした投入が生み出す長期的価値は、どのようにして個人や組織自身に還元されるべきなのだろうか。
従来のプラットフォーム型AIサービスは、主にユーザーに即時的なモデル能力を提供するものであり、ユーザーの利用行為がプラットフォームの製品改善に役立つこともあります。一方、Personal AIが探求しているのは、ユーザーがサービスを利用すると同時に、自身の知識、経験、判断によって形成される専用の知的資産を徐々に蓄積できるようにし、AIを長期間利用する価値が継続的に蓄積されていくことです。
この蓄積がもたらす意義は、パーソナライズ効果の改善にとどまらない。
について個人にとって、専門経験は長期的に活用できるデジタル能力へと徐々に転換され、異なるツールや異なる作業環境の中で自身の蓄積を活かし続けることが可能になる。
について企業对于企业而言、長年形成された業務手法や組織の知識が、専用モデルを通じて保存・継承される機会が生まれ、重要な経験が人材の流動や技術の交代によって失われるリスクを減らすことができます。
これらの能力が異なる基盤モデル間で再適用できるようになれば、個人や組織もより十分な技術の選択肢を得ることができ、自らのニーズに応じてモデルを評価、採用、入れ替えることが可能になり、単一プラットフォームへの長期的な依存を低減できる。
企業は必ずしも自社専用の汎用大規模モデルを再トレーニングする必要はないが、徐々に自社自身のインテリジェンス能力を一式保有できる機会を ought に持つべきである。
これはまた、通衍灵智が提唱する「人間本位のパーソナライズドインテリジェンス」を体現するものでもある。彼らの見方では、人工知能の発展は、利用者により大きな自主権を持たせ、個人や組織が長期にわたって蓄積してきた知識・経験・判断を尊重し、保存し、継承させるとともに、技術進歩が生み出す価値をより広く利用者に還元するものであるべきだという。
最後に、李未氏は、AIの普惠とは、より多くの人が先進的なモデルを使えるようにすることだけでなく、より多くの人がAIを通じて自らの能力を積み上げ、発展させられることをも意味すべきだと述べた。技術進歩の成果をより多く、人の成長、企業のイノベーション、社会の生産性の向上へと転換させること、これこそが通衍霊智の考える「人間本位」である。
北京通用人工知能研究院の体系的な研究蓄積を基盤として、通衍霊智(トンイエン・リンジー)はこの理念をパラメータ化学習、持続的な進化、基盤となる計算アーキテクチャの中に具体化しつつある。
関連技術は引き続き研究開発と産業での検証を必要とするが、それが指し示す長期的価値にはより広範な社会的意義がある。すなわち、先進的な人工知能の能力を、個人の発展、組織の成長、社会の生産性向上を持続的に支える基盤として徐々に定着させることである。
より長期的な視点から見れば、人工知能は人類の知識を絶えず吸収し、自らの能力を持续的に高めるシステムであるだけでなく、人類が知識を蓄積し、経験を伝承し、能力を拡張するのを助ける重要なインフラにもなるべきである。
汎用知能が徐々に社会全体で広く得られる基礎的能力となったとき、真に期待できるのは、一人ひとり、すべての組織が技術の進歩の中で自らの長期的な蓄積を築き、それらの能力を選択し発展させる余地を持てることである。
AIは人の関与によって賢くなるだけでなく、AIの普及によって人がより多くの能力を身につけられるようにもなるべきである。技術進歩の成果はモデルやプラットフォームの中に蓄積されるだけでなく、個人の成長、組織の発展、社会の進歩を支える持続的な力として蓄えられるべきである。
*本稿は量子位の許諾を得て掲載したものであり、見解はすべて原作者に帰属する。