
HealthBench と HealthBench Professional:現実的な健康関連会話におけるモデルの評価
私たちは、AI モデルが現実的な健康関連会話でどのように応答するかを評価する 2 つのベンチマーク、HealthBench と HealthBench Professional のリーダーボードを公開します
HealthBench と HealthBench Professional は OpenAI のベンチマークで、現実的な健康関連会話に対するモデルの応答を、医師が作成したルーブリックに基づいて採点します。
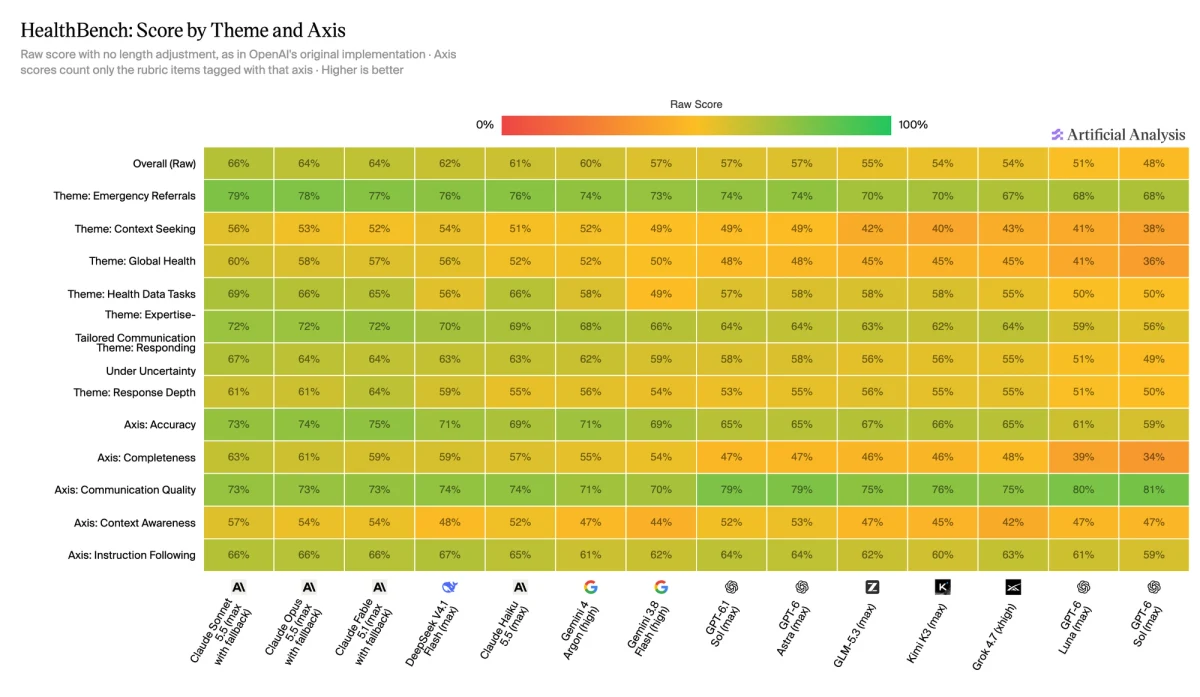
HealthBench は、一般ユーザーや医療従事者との 5,000 件の健康関連会話を用いてモデルをテストします。会話は、緊急の紹介からグローバルヘルスまで 7 つのテーマを網羅し、各ルーブリックの基準は、正確性、完全性、コミュニケーション品質、状況認識、指示遵守の 5 つの軸のいずれかに分類されます。HealthBench Professional は 525 件の会話からなる小規模なセットで、HealthBench とは異なり、すべて臨床医との会話です。これらは診察、文章作成、調査のタスクをカバーし、モデルに試練を与えるよう設計された敵対的で困難な会話を含みます。
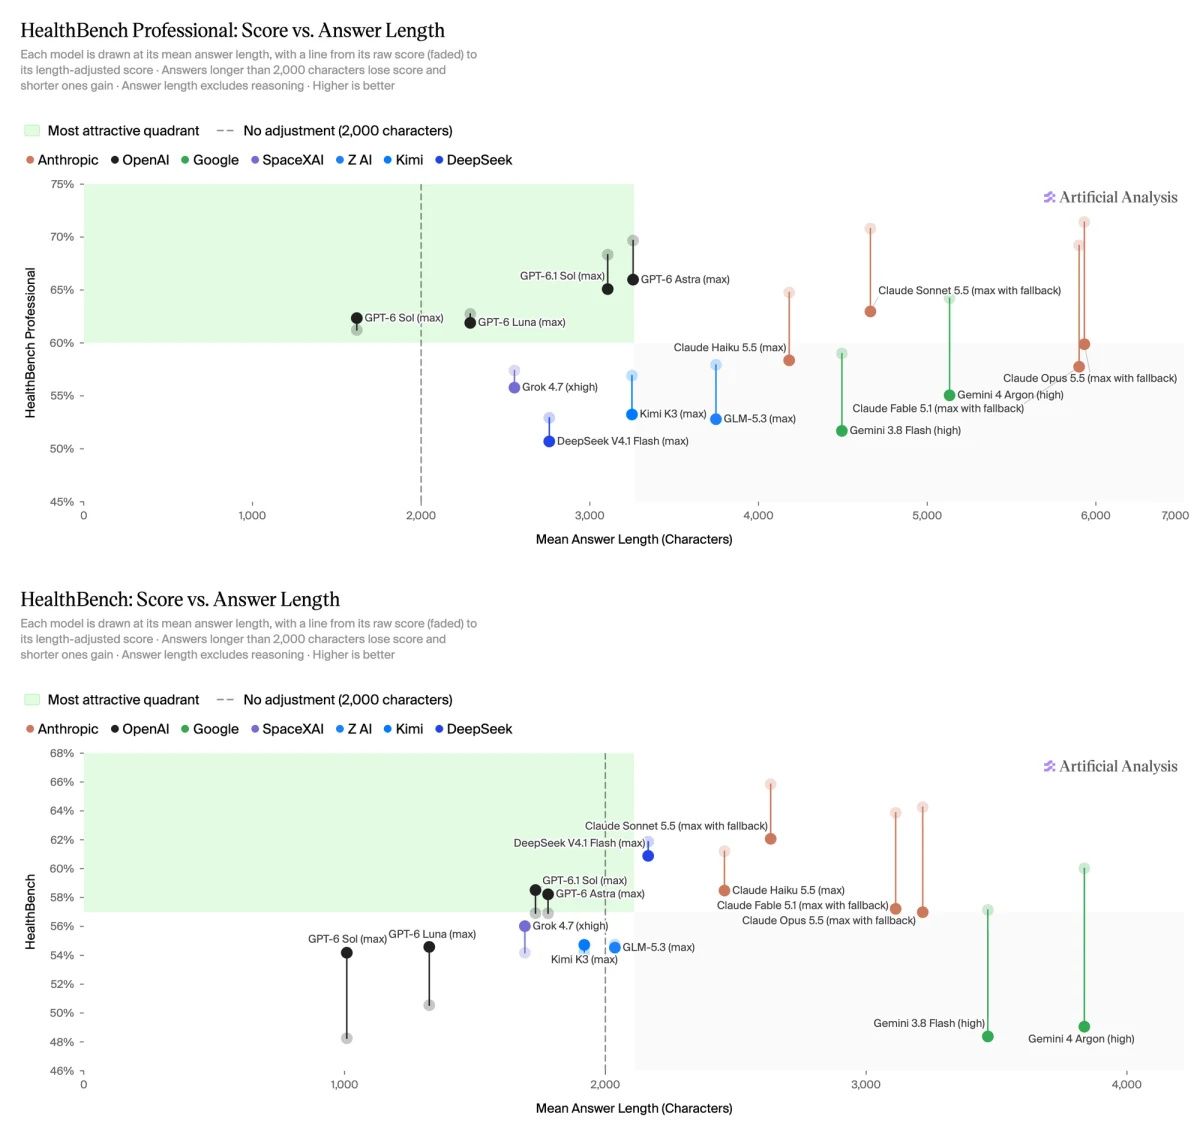
私たちは、生のスコア(獲得したルーブリックポイントの割合)と、OpenAI が報告している長さ調整済みスコアの両方を報告します。長さ調整済みスコアは、2,000 文字を超える回答のスコアを引き下げ、より短い回答のスコアを引き上げます。OpenAI の元の実装と同様に、回答は GPT-5.4 (low)(HealthBench Professional)および GPT-4.1(HealthBench)によって採点されます。
HealthBench Professional の主な結果:
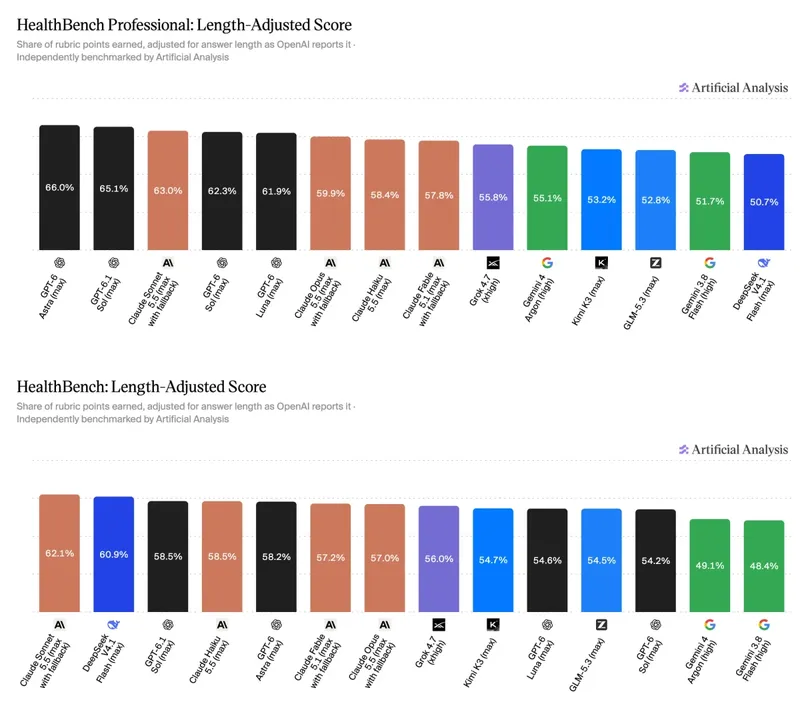
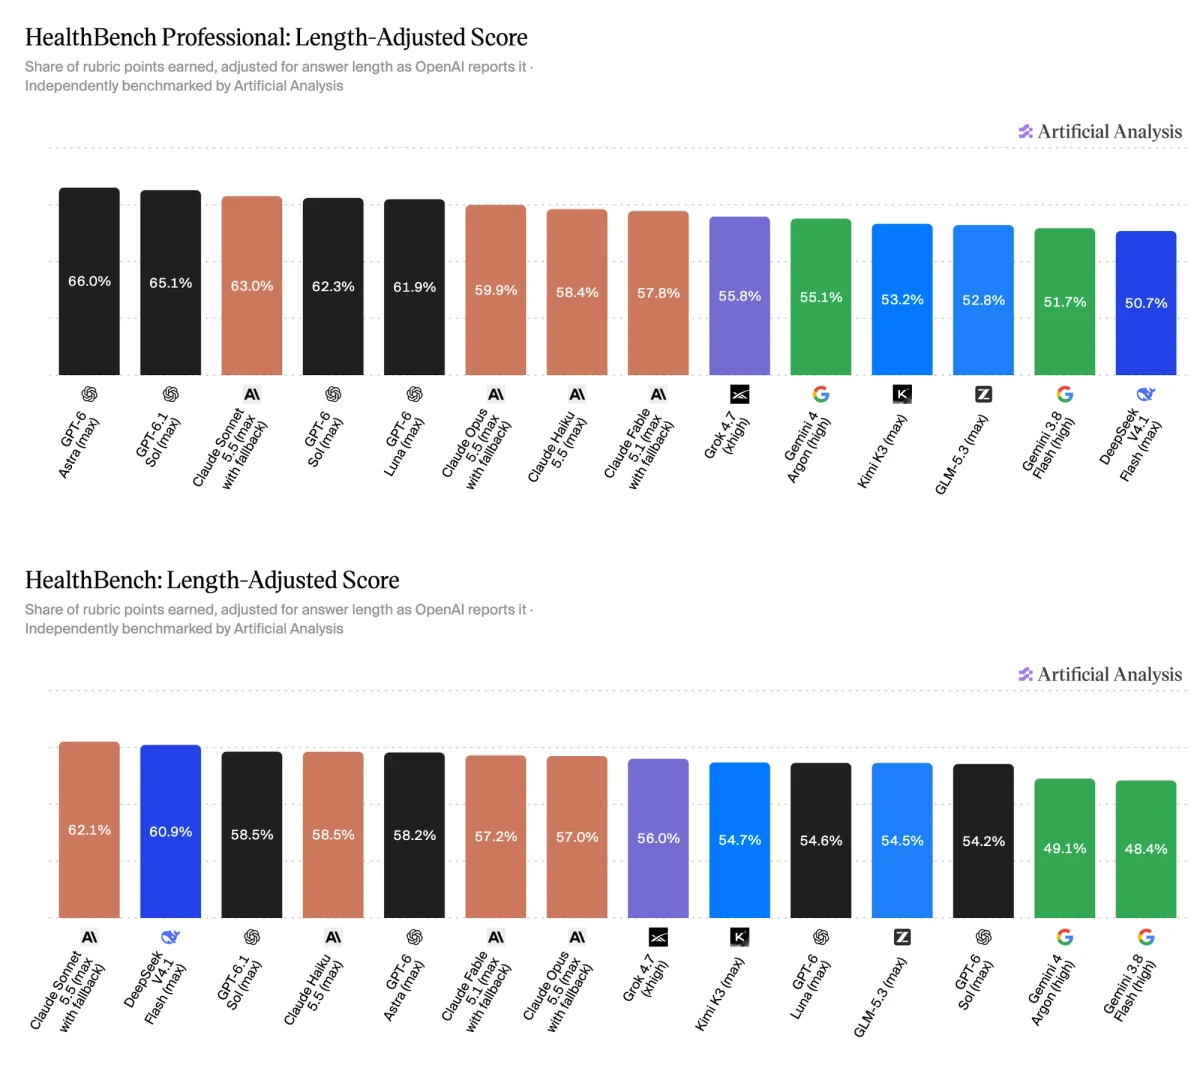
➤ GPT-6 Astra と GPT-6.1 Sol がリーダーボードの上位を占めます: GPT-6 Astra(max)は長さ調整済みスコアで 66.0% を獲得し、GPT-6.1 Sol(max、65.1%)に匹敵し、Claude Sonnet 5.5(max with fallback、63.0%)を上回ります
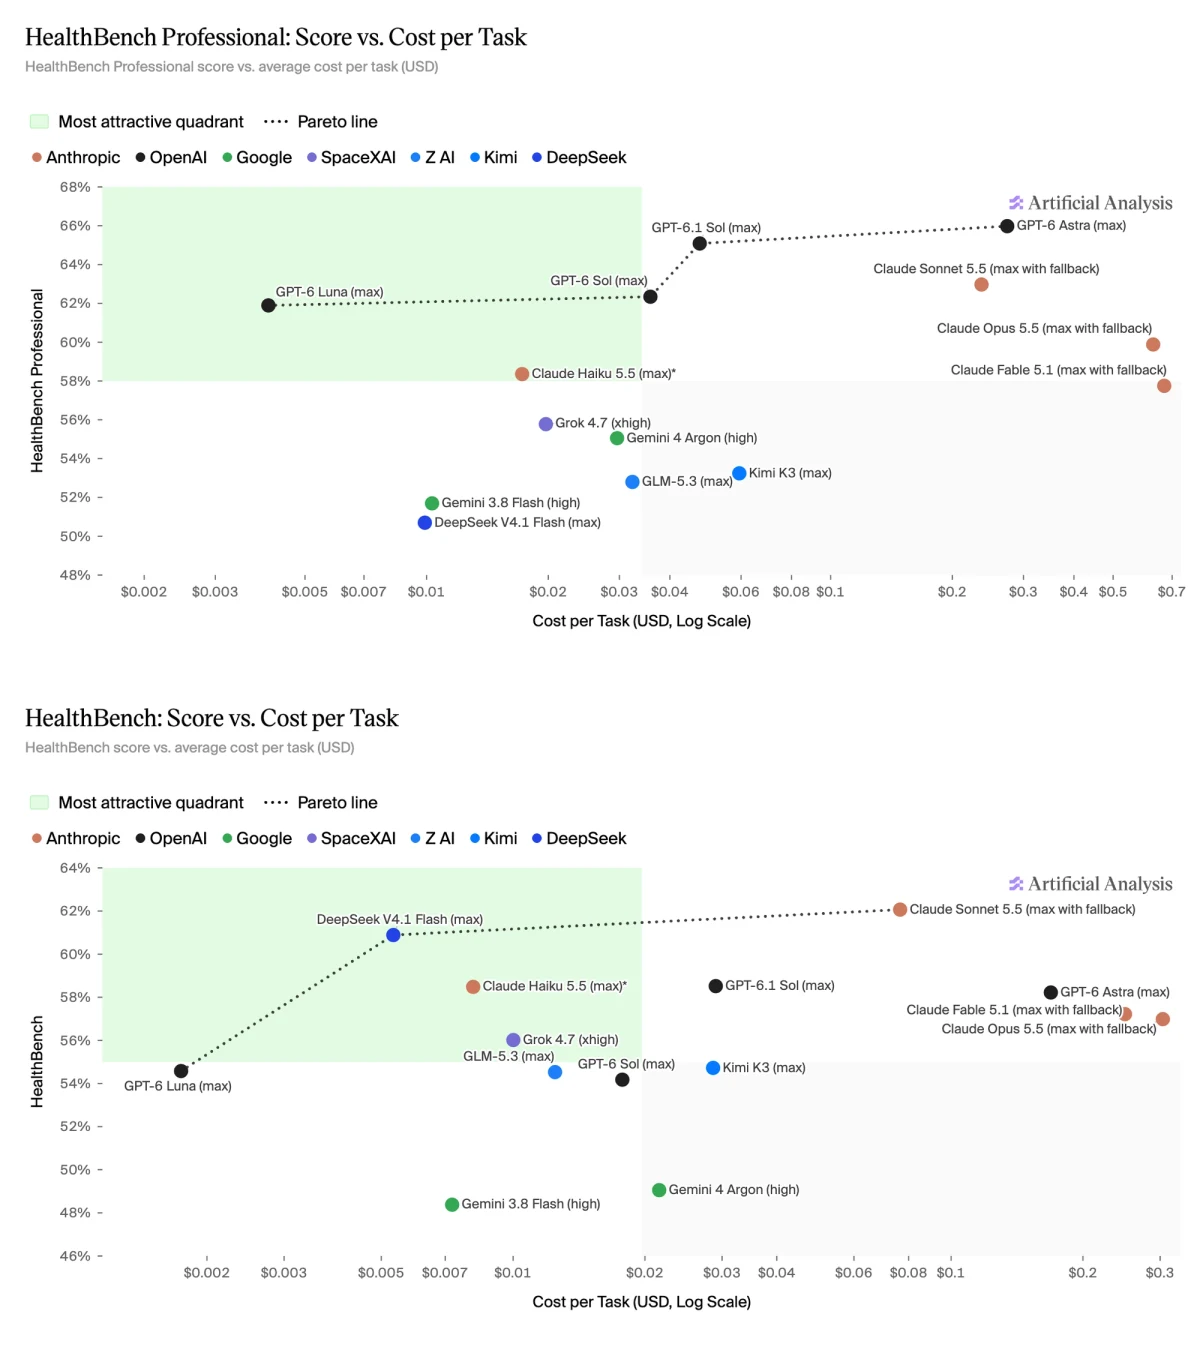
➤ OpenAI のモデルがスコア対タスクあたりコストのパレートフロンティア全体を構成します: パレートフロンティアは、GPT-6 Luna(max、61.9%、タスクあたり $0.004)から、GPT-6 Sol(max、62.3%、$0.036)、GPT-6.1 Sol(max、65.1%、$0.047)を経て、GPT-6 Astra(max、66.0%、$0.27)までで構成されます。GPT-6 Luna(max)は、GPT-6 Astra(max)より 4 ポイント低いスコアながら、コストはその 2% 未満です
➤ Claude Opus 5.5 と Claude Fable 5.1 が最大の長さペナルティを受けます: 両モデルとも回答あたり平均約 5,900 文字で、2,000 文字のしきい値の約 3 倍に達し、調整後に 11 ポイント以上失います。Claude Opus 5.5(max with fallback)は最高の生スコア(71.4%)を持ちますが、6 位(59.9%)に落ちます。GPT-6 Sol(max)は平均 2,000 文字未満(約 1,600 文字)の唯一のモデルであり、スコアが上昇する唯一のモデルです
HealthBench の主な結果:
➤ Claude Sonnet 5.5 が HealthBench の首位に立ちます: Claude Sonnet 5.5(max with fallback)は長さ調整済みスコアで 62.1% を獲得し、DeepSeek V4.1 Flash(max、60.9%)と GPT-6.1 Sol(max、58.5%)を上回ります
➤ GPT-6 Luna、DeepSeek V4.1 Flash、Claude Sonnet 5.5 がスコア対タスクあたりコストのパレートフロンティアを形成します: GPT-6 Luna(max)はタスクあたり $0.002 で 54.6%、DeepSeek V4.1 Flash(max)はタスクあたり $0.005 で 60.9% のスコアを獲得します。Claude Sonnet 5.5(max with fallback)のタスクあたり平均コストは $0.08 で、DeepSeek V4.1 Flash の約 16 倍のコストでスコアは約 1 ポイントの向上にとどまります
➤ 短い回答は完全性をコミュニケーション品質と引き換えにします: HealthBench の各ルーブリック項目には、5 つの軸のいずれかがタグ付けされています。完全性は、回答に重要な情報がすべて含まれているかを確認し、コミュニケーション品質は、回答が明確で、構造が整っていて、適切な長さと詳細度になっているかを確認します。GPT-6 Sol(max)は最短の回答(約 1,000 文字)を書き、最高の生のコミュニケーション品質スコア(81%)を持ちますが、完全性スコアは最低(34%)です。Claude Sonnet 5.5(max with fallback)は完全性(63%)で首位に立っています
完全なリーダーボードについては、こちらをご覧ください:
➤ HealthBench Professional: https://artificialanalysis.ai/evaluations/healthbench-professional
➤ HealthBench: https://artificialanalysis.ai/evaluations/healthbench