
Macでモデルを実行したり、計算の主要な加速ツールとしてMPSを使用したりする場合、PyTorch 2.15には楽しみがたくさんあります!FP8がMPSで利用可能になり、言語モデルのデコードが線形層やsoftmaxを通じてより速くなる。また、新しいMetalカーネルが音声、映像、トレーニングワークロードにおける高コストな部分を処理します。
私たちが何者かについて簡単に言うと、私たちはHugging FaceのPyTorchチームです。私たちはPyTorch全般に貢献しており、特にMPSバックエンドに焦点を当てています。その目的は、MacをPyTorchモデルの実行やトレーニングを行うための第一級の場所にすることです。2026年の初めには、たとえ小さなモデルであってもMPS上で実行する場合、非対応の操作、パフォーマンスの落ち込み、予期しないメモリ増加を克服する必要がありました。 Hugging Face Hubから実際のモデルを言語、画像、動画全体で実行し、MPSが不足している部分を見つけ、PyTorchの上流で修正する。MPSGraphを専用のMetalカーネルに置き換えることで、ますます頻繁に修正が行われる。この記事の多くは、PyTorchのメンテナーとコミュニティの貢献者と共に行ったその作業の成果である。
TL;DR
- FP8がMacに登場:
float8_e4m3fn値をBF16の半分のスペースで保存し、CUDA/CPUでサポートされているスケールされた行列乗算やその他の操作を利用できます! - MoEモデルは2.14より5~6.5倍も速くデコードできます: Qwen3.6-35B-A3BはM3 Ultra上で9.4トークン/秒から61.3トークン/秒に向上しました。これは、専用のデコードパスを持つネイティブのグループ化matmul、より少ないGPU-CPU同期、そしてより速いtop-kルーティングによるものです。
- すべてのLLMでトークンあたりの時間が短縮される:単行線形層は特殊な行列ベクトルカーネルを使用し、語彙上でのsoftmax処理は約8倍速い。
- GPU上のより多くの線形代数:複合LU法と三角解法、小さな行列の逆行列の処理が高速化され、QR分解も高速化されます。
- 音声、ビデオ、トレーニングも注目を集める:畳み込み、パディング、ドロップアウト、後向き補間、削減のためのより速い方法。Wan2.2のビデオVAE解像度は、270 GiBから8 GiBのメモリでピークを迎える。
- Pythonからのより多くの制御:公開されたMPSストリームと、より信頼性の高いイベントタイミング。
- 更新された要件: MPSは今やmacOS 15以降が必要です。PyTorch 2.15ではPython 3.11以降が必要です。
- 2.16の概要: Metalに全精力を注ぎ、MPSGraphからMetalへの移行が増え、LLMのデコードが高速化されます。
これがあなたにとって意味すること
transformers、diffusers、ComfyUIのようなツールを使ってMac上でモデルを実行する場合、2.15が実際にどのように変更されるかというと、以下の通りです:
- はるかに高速なローカルLLMです。専門家モデルの混合型モデルは、2.14よりも5~6.5倍速くデコードします。
torch.compileを使用したM3 Ultra上で、Qwen3.6-35B-A3Bは9.4トークン/秒から61.3トークン/秒へ、LFM2.5-8B-A1Bは23.6トークン/秒から123.6トークン/秒へ向上します。densifyモデルも恩恵を受け、線形層の処理が速くなり、サンプリング時のsoftmax処理が8倍速くなります。さらに詳細は - メモリに収まるビデオ生成。 Wan2.2のタブレット型VAEを使用してビデオを復号化することで、ドライバーのメモリが270 GiBに達しました。現在は約8 GiBでピークになります。さらに詳細
- Qwen-Image-2.1を使用した画像編集の修正。 2.14では、Qwen-Image-2.1 VAEエンコーダがMPS上で画像を無意識に破損させ、画像編集ワークフローが崩れました(ComfyUIで報告されました)。同じパディング変更によって問題が解決され、エンコード・デコードの一連の処理でCPUの29.95 dB PSNRに達し、10.06 dBから改善されました。
- Mac上でのFP8ウェイトです。 FP8テンソルはBF16のメモリの半分を使用し、
F.scaled_mmによってGPU上で直接乗算されます。さらに詳細は
内容
- 始める方法
- FP8がMPSに導入される
- より速い言語モデル解読
- 線形代数が強化される
- 畳み込み、パディング、およびトレーニング
- Softmaxと減算
- ビデオデコードに必要なメモリ使用量がはるかに少ない
- MPSストリームによるより多くの制御
- MPSでさらに多くの操作が実行可能です
- PyTorch 2.16のお試し見積もり
- まとめ
はじめの手順
macOS 15以降およびPython 3.11以降が搭載されたApple siliconのMacが必要です(2.15互換性マトリックスを参照してください)。OSが古すぎるか、Metal GPUが利用できない場合、MPSの利用可能性チェックがその理由を示します。
別の環境でリリース候補を試すには:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu
FP8がMPSに登場する
FP8は、Mac上でメモリを節約する別の方法です。PyTorch 2.15では、MPS上でtorch.float8_e4m3fnテンソルが追加されました。これは、各値に1バイトを使用し、FP16やBF16のストレージ量の半分です。
これらのテンソルをF.scaled_mmと掛けられます。この値はテンソル単位および行単位のスケーリングを両方サポートします。以下は、各テンソルに1つのスケールを適用した小さな例です:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
言語モデル解読の高速化
すべてのLLMにはプレフィル段階とデコード段階があります。デコードの過程で、新しいトークンは一つの行としてモデルを通過するため、大きな行列乗算が行列ベクトル積に変わります。PyTorch 2.15は、このステップで重要となる密接な線形層とミックス・オブ・エキスパート層の両方の層を高速化します。
線形層
MPSは2.14以降、torch.mm用にGEMVカーネルを使用していますが、F.linearは依然としてMPSGraphを通過します。PyTorch 2.15ではそれらをF.linearに接続するため、共通の[1, 1, hidden_size]デコーディング入力は直接これを使用し、有効なバイアス追加は融合される形で行われます。実際のモデルから得られた96個のBF16層形状において、1.23倍の幾何平均スピードアップが得られます。最も大きな効果は、MoEモデルのゲートなどの小さなプロジェクションに現れます。旧手法ではメモリ帯域幅の大部分が無駄になっていました。大規模な層やLMヘッドは既に帯域幅の制限に近くなっていたため、1倍程度の値で推移します。
専門家の混合層
エキスパートの混合層は、各エキスパートに異なる数のトークンを送信する。グループ化されたmatmulは、これらの不均一なグループを一つの操作で処理し、2.15によりMPSにネイティブ実装が得られる。
2.14では、grouped matmulはグループオフセットをCPUにコピーし、グループごとにループ処理を行った。新しいMetalカーネルは、利用可能なMetal Performance Primitivesを使用し、別の場合は個別のMetalパスを使用して、GPU上で直接オフセットを読み取る。デコード中によく見られる小さなグループについては、自身のカーネルも使用される。
例えば、64個のトークンを16個、32個、16個のグループに分けることができます:
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
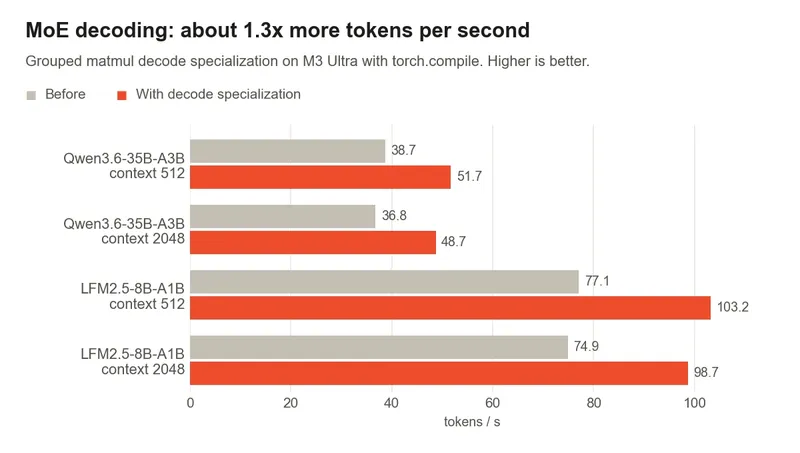
デコードカーネルは、トークンスループットに直接表示されます。 M3 Ultra with torch.compileMoEモデルは約 1秒あたり1.3倍のトークン:

線形代数が力を得る
複素数値計算
複雑なテンソルを扱うのがより簡単になります。complex64 LU分解、LU解法、三角形解法は今やMPS上で実行可能になりました。これにより、複素数行列式などの操作やグラディエントも利用できるようになります。以下はGPU上で直接解かれた小さなシステムです:
import torch

a = torch.randn(8, 8, device="mps", dtype=torch.complex64)
a = a + 8 * torch.eye(8, device="mps", dtype=torch.complex64)
b = torch.randn(8, 2, device="mps", dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)
print((a @ x - b).abs().max().item())
小さな行列とより大きな問題
小さなマトリックスには高速なカーネルも必要です。カメラのジオメトリや画像変換においては、4×4までのFP32マトリックスのバッチが、因数分解と解く処理を組み合わせた単一のMetalカーネルで逆变换される。より大きな問題にも注目が集まっています:QRの更新制限、および三角形の解き方により、その作業の大部分が効率的なマトリックス乗算に変わります。
ゲート化されたDeltaNetワークロードには、専用の高速経路が提供され、16 × 16、32 × 32、64 × 64 FP32三角システムのバッチにおいて、少なくとも8つの右側が存在します。
SVDは数値の極端な状況においてもより堅牢です。今では非常に小さい単位値、非常に大きい、または非常に小さい入力の大きさ、そしてfull_matrices=Trueでベースの完成を正しく処理できるようになりました。これにより、擬逆行列や最小二乗法の結果がより信頼性が高くなります。
畳み込み、パディング、トレーニング
音声モデル、ビデオデコーダ、トレーニングループには、それぞれ高コストな処理が必要です。このリリースでは、これらのうちいくつかにMetalを通じた新しいアプローチが提供されます:
| 操作 | 2.15で何が変更されますか |
|---|---|
conv1d フォワード |
専用カーネルがMPSGraphを代替し、短い出力のためのim2col-plus-matmulパスも用意されている。音声やストリーミングモデルの形状に役立つ。 |
| 定数パディング | Metalカーネルへの移行により、タッチングビデオVAEデコードにおける無制御なドライバーとメモリの増大が解消される(詳細は下記)。 |
| 反射と複製パディング | より高速で、バックワード正確性を解決した新しいメタル実装。 |
| オフ・オブ・プレイスドロップアウト | nn.DropoutとF.dropoutは、既存の融合カーネルを使用するようになりました。 |
| バックワード upsampling | 金属集約核がMPSGraphのサイズ変更グラデュエントパスに代わる。 |
Channels-last conv2d バックワード |
高コストなストリーデッドアクセスを利用するNCHWグラフの代わりに、効率的なチャネル最後尾パスを使用する。 |
Softmaxと減算
2.15ではトークンサンプリングもより速くなります。softmaxとlog_softmaxは、専用のMetalカーネルで実行されるようになりました。特に大きな語彙数が最も恩恵を受けます:[1, 128256]行のロジットに対するFP32のsoftmaxでは、57 µsから7 µsに短縮され、MPSGraphバージョンよりも約8倍速くなりました。この速度向上は、他の一般的な語彙サイズでも同様に得られます:

ビデオデコードに必要なメモリ使用量が大幅に少なくなる
このリリースで最も顕著な結果は、定数パディングの変更によるものです。Wan-AI/Wan2.2-TI2V-5B-DiffusersでのVAEデコードでは、28個のタイルを完全にデコードする間に8,764回のパディングが行われました。Metal上でのパディングにより、ピーク時のドライバーメモリは約270 GiBから8 GiBに減少しました。

| メモリ指標 | MPSGraph padding | 金属パッド |
|---|---|---|
| 現在のテンソル割り当てピーク | 4.422 GiB | 4.095 GiB |
| アロケーターが予約したピーク | 8.070 GiB | 8.070 GiB |
| 総合的なドライバー・メモリピーク | 270.135 GiB | 8.108 GiB |
MPSストリームによるより多くの制御
今では、Pythonから直接、どのMPSストリームで作業を行うかを選択できます。torch.mps.Streamおよびtorch.mps.streamのコンテキストマネージャーがこのインターフェースを提供し、Tensor.record_streamにより、割り当て者が別のストリーム上でのテンソルの使用を追跡できます。
別のストリームに作業を送信し、結果を読み込む前に同期するという小さな例です。
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
MPSでさらに多くの操作が可能
現在、MPS上でさらにいくつかの操作が実行される:torch.frexp、torch.logspace、torch.takeおよびTensor.put_、torch.heaviside、torch.special.laguerre_polynomial_l、および無符号整数比較。logspaceは、複数の要素を持つ整数やブール出力をサポートしていない。
注意:正確性の修正も行われました。スケールされたドットプロダクトのアテンションに関するMPS数学実装が、今ではバッチおよびヘッドブロードバッティングを正しく処理できるようになりました。
PyTorch 2.16のささやかな概要
2.16の作業は既に順調に進んでいます。以下の変更点の中には、mainに反映されたものがあり、nightliesで利用可能です。他の変更点はまだ審査中であるため、リリース前に詳細が変更される可能性があります。
高速なLLMデコード処理
モデルのデコードパスにMPSGraphオペレーションが含まれなくなると、GPUはCPUがすべてのカーネルをエンコードするのを終えた後にのみトークンを処理し始めます。PyTorch 2.16では16カーネルごとにコマンドバッファをコミットするため、CPUが残りのエンコーディングを行っている間にGPUは作業を開始します。2048トークンのコンテキストでコンパイルされたBF16のデコードについては:
| モデル | 前に | 後で | 変更 |
|---|---|---|---|
| LFM2.5-8B-A1B | 108.8トークン/秒 | 126.0トークン/秒 | +16% |
| Qwen3.6-35B-A3B | 52.9トークン/秒 | 62.8トークン/秒 | +19% |
| Qwen3.8-27B | 12.1 トークン/秒 | 12.6 トークン/秒 | +4% |
Attentionは完全にMetal上で実行される
スケールされたドット・プロダクト・アテンションはMPSGraphを完全に廃止するというものです。すべての形状はMetalカーネルで実行され、デコード用の専用ベクトルカーネルと、新しいmacOSバージョンでの半精度付近補完用のMetal Performance Primitivesが利用されます。以前はMPSGraphに頼る必要があった形状が最も恩恵を受けます。M5 Pro上では、グループ化クエリアテンションを用いたデコード(32クエリヘッド、8 KVヘッド、ヘッドの次元80、4Kコンテキスト)は465µsから65µsに、ヘッドの次元40で4K×4Kの付近補完は42msから6msに改善されました。
MPSGraphからMetalへの移行の詳細
MPSGraphからの移行が続いています。バッチノーマル化前向きと後向きが進行中です。一方でMSE損失(小さな入力に対して12倍の速さ)やstd_meanおよびvar_mean(4倍の速さ)、そしてbincountはすでに実装されています。bincountは最も劇的です:ほとんどの値が一つのバイナリに属する場合、400万個の整数を数えるのに6.8秒かかっていたものが、今では0.5ミリ秒で済みます。
より小さなインストール
バンドルされたシェーダーは、デフォルトでMetal 3.1用にビルドされます。Metal 4版は、必要なカーネルのみをコンパイルされます。これによりlibtorch_cpu.dylibのサイズが約25%減少し、384 MiBから287 MiBになり、より高速なmatmulsとネイティブFP8行列乗算を備えたMetal 4.1シェーダーの基礎が築かれます。
まとめ
PyTorch 2.15はMac上でFP8を利用可能にし、densifyモデルやMoEモデルの高速LLMデコードを実現し、GPU上での線形代数処理が向上し、MPSGraphから専用のMetalカーネルへ移された操作が多数追加されました。リリース候補版を試してみてください!
私たちの次のステップは何か
- さらに多くのMPS:2.16では、すべての注意をMetalに向けます。また、操作はMPSGraphから行い続けます。
torch.compile: グラフの断絶を解消する作業を行っており、より多くのモデルが全段階でコンパイルされるようになっています。- あなたのアイデア:PyTorchで何を他に取り組むべきか?何かが遅い、機能しない、または壊れている場合、MPSでも他の場所でも、GitHubでIssueを開くして私たちに知らせてください。
この仕事の大部分をレビューしてくれた Nikita Shulga、Kurt Mohler、および Aaron Gokaslanに、心から感謝します。また、このリリースでMPSに貢献してくれた全員にも感謝します。