ChatGPT Images 2.5 を紹介します
ChatGPT Images 2.5 は、あなたのアイデア、スケッチ、参照写真を、よりパーソナライズされ、洗練された、あなたのアイデアをより的確に反映した画像へと変換するお手伝いをします。
AIのニュース、出典、日時をひとつの場所で。
ChatGPT Images 2.5 は、あなたのアイデア、スケッチ、参照写真を、よりパーソナライズされ、洗練された、あなたのアイデアをより的確に反映した画像へと変換するお手伝いをします。
OpenAIは、学生、教育者、ジャーナリスト、ニュース組織に向けたツール、研修、パートナーシップにより、ジャーナリズムへの支援を拡大しています。
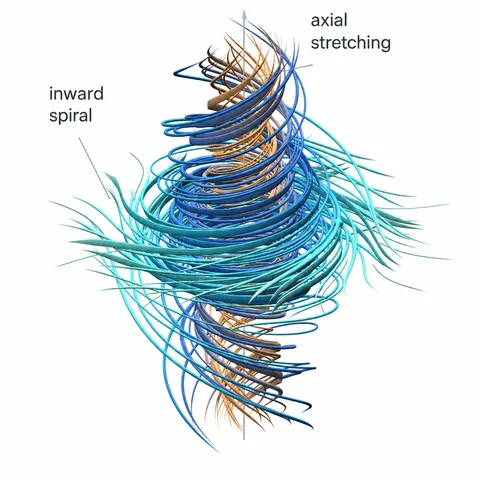
Navier–Stokesミレニアム賞問題に対するAI生成の解法を、解説とLeanによる形式的証明とともに公開します。
生成AIがティーンの発達、ウェルビーイング、安全に与える影響に関する独立研究を支援するOpenAIの500万ドル助成プログラムに今すぐ応募してください。
1PasswordのエンジニアはCodexを活用して新機能や社内ツールを迅速に構築し、厳格なセキュリティポリシーを維持しながら本番環境対応レベルに到達しています。
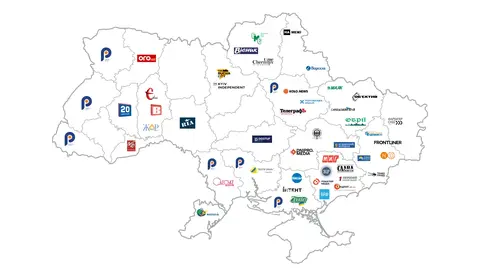
OpenAI、AIRPPU、WAN-IFRAは、ウクライナのニュース機関がイノベーション、レジリエンス、独立したジャーナリズムを強化するためのAIプログラムを発表しました。
OpenAIの内部では、コーディングエージェントがAI研究を作り変えつつあります。エージェントの利用状況、実験の速度、タスクの複雑さ、そして研究の加速に関する初期データをご覧ください。
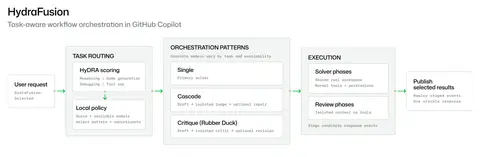
管理されたオフライン評価において、HydraFusionの選択的コーディングワークフローは、評価されたOpus 5ベースラインと同等かそれを上回りながら、推定ワークフローコストを削減しました。現在、GitHub Copilotでリサーチプレビューとして利用可能です。投稿「Project HydraFusion: マルチモデルオーケストレーションによるフロンティア品質」は、The GitHub Blogに最初に掲載されました。
GitHub Copilotアプリで並列エージェントを実行する方法を学び、それが怖いと感じられなくなり、強力だと感じ始める瞬間を体験してください。投稿「初心者向けGitHub Copilotアプリ: 複数のエージェントを同時に実行する」は、The GitHub Blogに最初に掲載されました。
OpenAIが「Daybreak for Frontline Defenders」を発表。10億ドルの取り組みにより、不可欠なサービスへのフロンティアサイバーAI、トレーニング、サポートのアクセスを拡大します。
LegoraはGPT-6 Astraを用いて41件のドキュメントを数分でレビューし、仕込まれた4つのエラーをすべて検出し、この財務レビューワークフローでパフォーマンスを約40%向上させました。
GPT-6 Astraを活用し、Playcoは1つのグレーボックス基盤から3つのテーマ別ゲームプロトタイプを構築し、従来のモデルに比べて手動修正が50%減少したと報告しています。
GPT-6 Astra を発表します。これは私たちのこれまでで最も知的で、最も整合性の取れたモデルであり、コンピュータ操作、コーディング、サイバーセキュリティ、科学の各分野で最先端の能力を備えています。
過去数年のAgent評価のパターンは、おおむね目標が与えられ、モデルが限られたターン数の中でできるだけ達成するというものだった。例えば迷路の中で宝を見つける、レポートを1本产出する、あるいはコードの一部を修正するといったものだ。そしてモデルの性能も、納品物の品質やタスクの完了度に基づいて評価され、こうした評価には往々にして明確な自然終了状態がある。 現実世界の長期的タスクのほとんどには明確な自然終了状態がない。例えば天気予測、株式取引、商業経営などだ。ネットショップがとある午前に「経営完了」になることはないように、先月積み上げた在庫、一昨日に交渉した価格、昨日のプロモーション活動はすべて
我々は Qwen-Drive-1.0 を提案する。これは事前学習段階で 3D 知覚と視覚的質問応答を統合し、さらに運動計画へと拡張した初の自動運転視覚言語基盤モデルであり、しかも全過程を通じて事前学習済み VLM アーキテクチャを変更せずに保つ。モデルはネイティブマルチモーダルの Qwen3.5-4B を基盤とし、2 つの外部モジュールを追加する。BEV 知覚ヘッドは明示的で検査可能な 3D プローブとして、3D 物体検出、意味的 Occupancy 予測、BEV 地図分割を統合的に実行する。計画エキスパートはフローマッチングに基づいて将来の自車軌跡を生成する。段階的な訓練を通じて、我々は汎用 VLM の自動運転能力を著しく向上させ、3D 知覚、運転視覚的質問応答、運動計画のタスクにおいてその実現可能性を検証し、統一された自動運転視覚言語モデルを形成し、運転シーンへの適応に新世代の VLM 基盤を提供する。