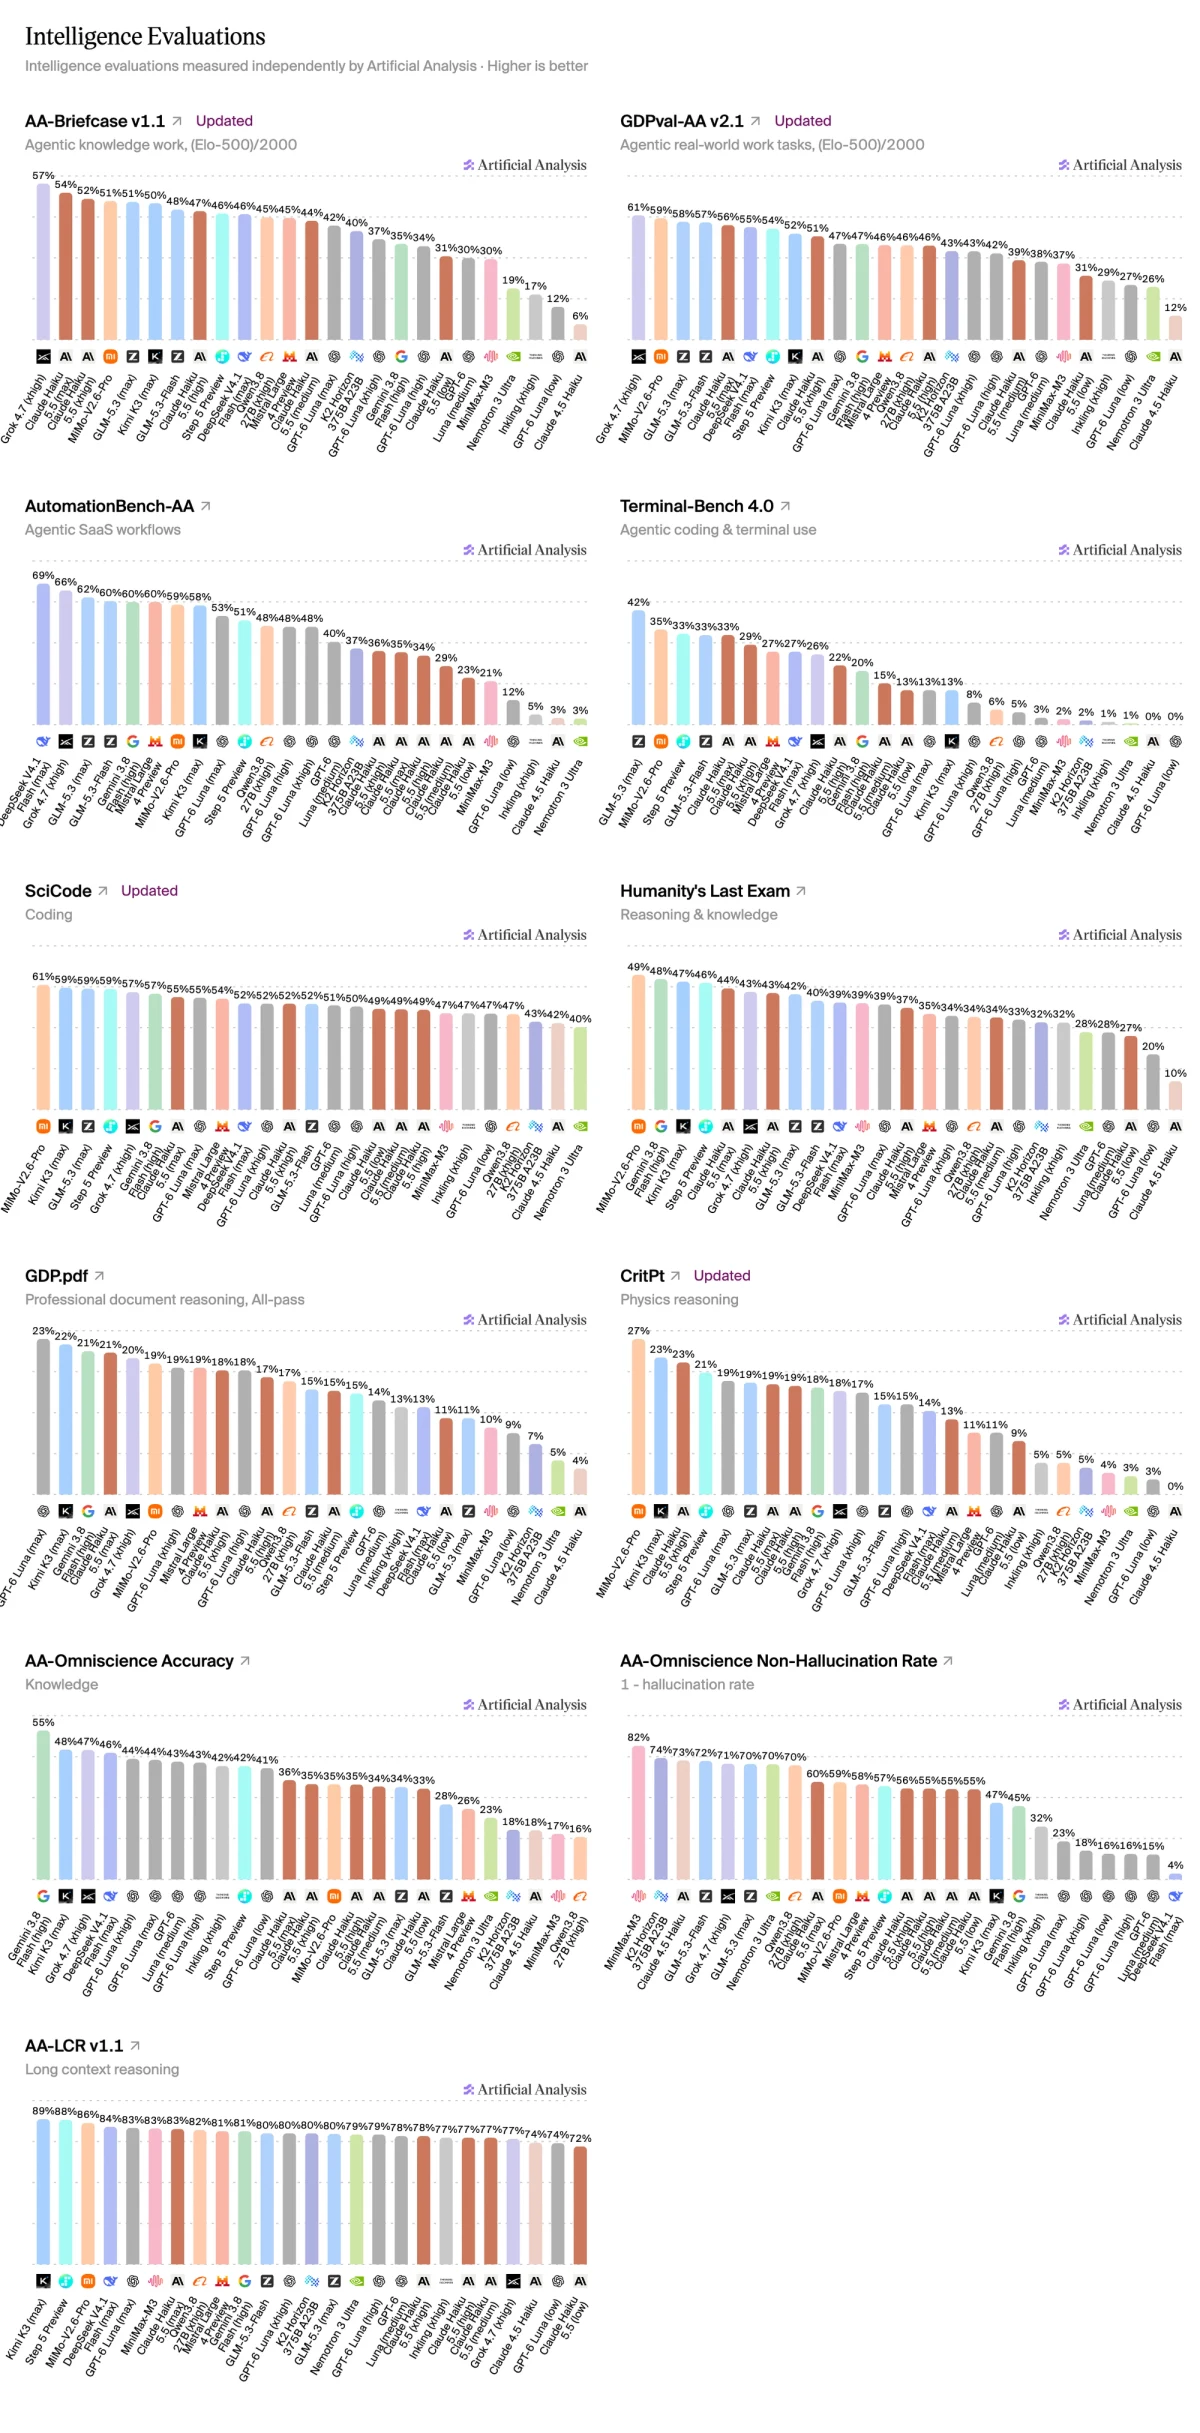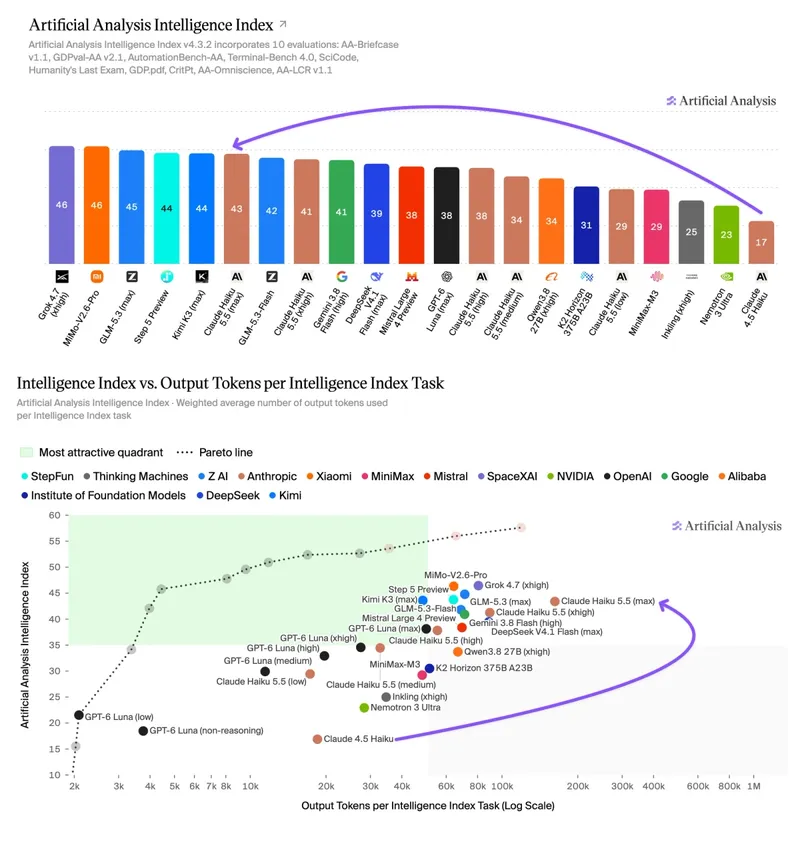
Anthropic이 Claude Haiku 5.5를 출시했으며, Artificial Analysis Intelligence Index에서 43점을 기록했습니다. 이는 지난 Haiku 출시 1년 후 26점 상승한 수치입니다
모델 페이지 보기Haiku 5.5는 Anthropic의 effort 설정과 adaptive thinking을 갖춘 최초의 Haiku 모델이며, Anthropic은 단계별 요금제를 도입했습니다.
Haiku 5.5는 이전 모델보다 저렴합니다. 100k 토큰까지의 프롬프트에 대해 1M 입/출력 토큰당 $0.10/$0.50입니다(GPT-6 Luna와 동일하며 이전 Haiku 모델의 10% 수준). 그러나 이 요금은 100k 초과 시 5배인 $0.50/$2.50로 인상됩니다. 사이트에는 아직 단계별 요금이 반영되지 않아 Haiku 5.5의 잠정 비용 수치에는 이 단계별 인상 비용이 포함되어 있지 않습니다. 지원 작업을 진행 중이며 곧 Cost per Task coverage로 후속 안내를 드릴 예정입니다.
주요 요점:
➤ 소형 클래스 모델 중 최고 수준의 성능: max effort에서 Haiku 5.5는 GLM-5.3 Flash(42), Gemini 3.8 Flash(41), GPT-6 Luna(38) 등의 모델을 약간 앞섭니다. 이 점수는 2.8T 파라미터 오픈 웨이트 모델인 Kimi K3(44)와 비슷하며, Claude Sonnet 5.5(max, 56)보다는 13점 낮습니다
➤ GPT-6 Luna에 비해 많은 토큰 사용: Haiku 5.5(max)는 Intelligence Index 작업당 약 162k 출력 토큰을 사용하며, 이는 GPT-6 Luna(max, 약 50k)의 약 3배입니다. xhigh에서 max로 이동하면 약 1.8배의 토큰으로 2점이 추가됩니다. 비슷한 지능 수준에서도 GPT-6 Luna보다 더 많은 토큰을 사용합니다. Haiku 5.5(high)는 작업당 약 55k 토큰으로 38점을 기록하는 반면 Luna(max)는 약 50k 토큰으로 38점이며, 이 격차는 낮은 effort 설정에서 더 벌어집니다
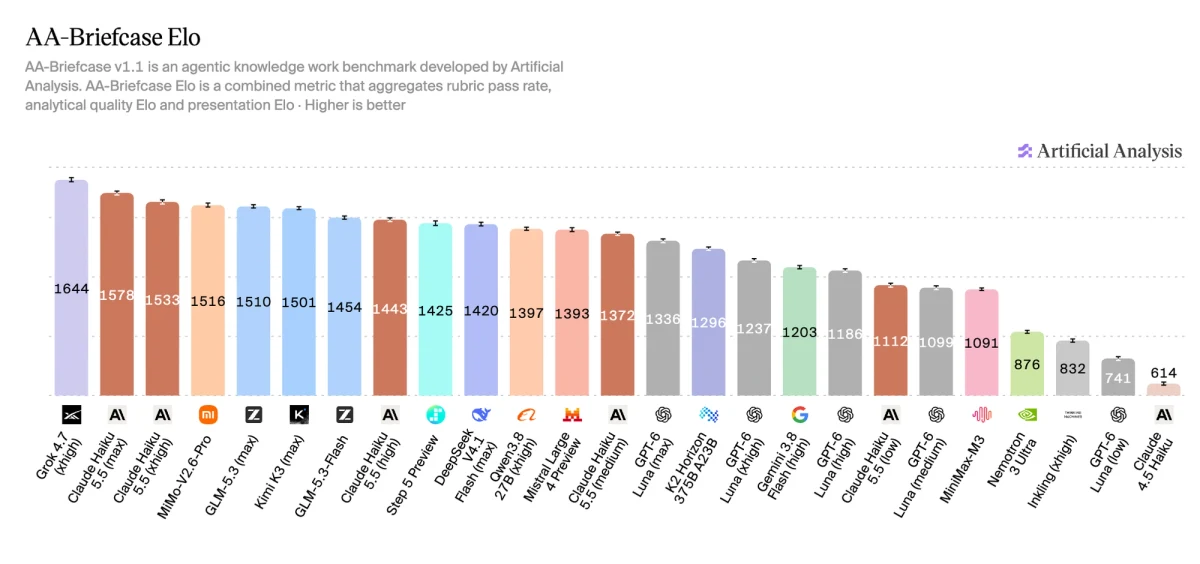
➤ 에이전트형 지식 작업에서 뛰어난 능력: 현실적인 지식 작업 과제를 위한 사내 평가인 AA-Briefcase에서 Haiku 5.5(max)는 1578 Elo에 도달했으며, Kimi K3와 GLM-5.3을 포함한 모델들을 앞서고 Muse Spark 1.3(max)과 비슷한 수준입니다
➤ 터미널 사용에서의 개선: Terminal-Bench 4.0에서 33%를 기록했으며, Haiku 4.5의 0%에서 크게 향상되었습니다. 이는 GLM-5.3 Flash와 동률이며, Gemini 3.8 Flash(20%)와 GPT-6 Luna(13%)를 앞섭니다
➤ 낮은 사실 지식, 하지만 상대적으로 낮은 환각: 소형 클래스 모델에서 예상되듯이 Haiku 5.5는 동일 계열 모델들보다 사실 지식이 낮습니다. AA-Omniscience 정확도는 36%로, Gemini 3.8 Flash의 55%와 GPT-6 Luna의 44%에 미치지 못하지만, 이는 부분적으로 모르는 것을 인정하는 데 더 적극적이기 때문입니다. 환각률은 40%로 55% 및 77%보다 낮습니다
➤ AutomationBench-AA 결과가 과소 평가되었을 가능성: Haiku 5.5는 35%를 기록한 반면, GPT-6 Luna, Gemini 3.8 Flash, GLM-5.3 Flash는 53–60%입니다. 사전 출시 테스트 중 안전 거부 문제로 모델이 과도하게 거부하는 현상이 있었습니다. Anthropic이 이 문제 해결을 진행 중이며, 수정 사항이 반영되면 이 평가를 재실행하여 점수가 상승할 것으로 예상합니다
기타 모델 세부 사항:
➤ 컨텍스트 윈도우: 100만 토큰으로, Claude 4.5 Haiku의 200k에서 증가했습니다
➤ 가격: 100k 토큰까지 1M 입/출력 토큰당 $0.10/$0.50, 100k 초과 시 $0.50/$2.50. 캐시 읽기 $0.01(100k 초과 시 $0.05), 5분 캐시 쓰기 $0.125(100k 초과 시 $0.625)
➤ 멀티모달: 텍스트 및 이미지 입력, 텍스트 출력
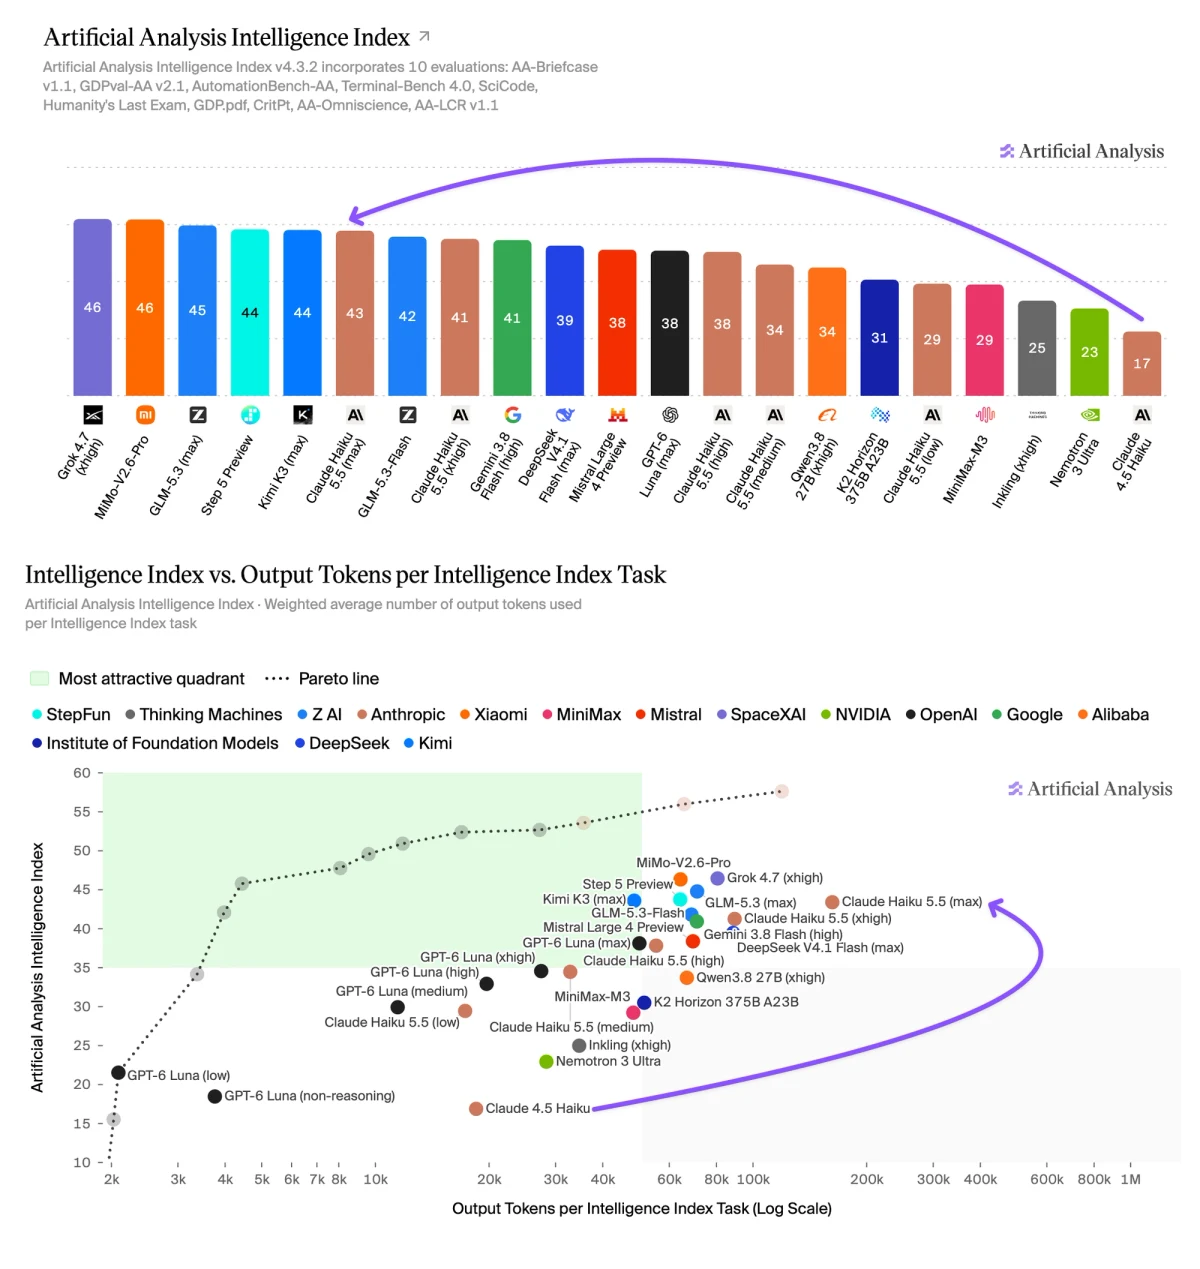
Claude Haiku 5.5(max)는 Intelligence Index 작업당 약 162k 출력 토큰을 사용하며, 이는 Opus 5.5(max)보다 많고 GPT-6 Luna(max)의 약 3배입니다. 모든 effort 설정에서 Haiku 5.5는 비슷한 Intelligence Index 점수에 도달하기 위해 GPT-6 Luna보다 더 많은 출력 토큰을 사용합니다
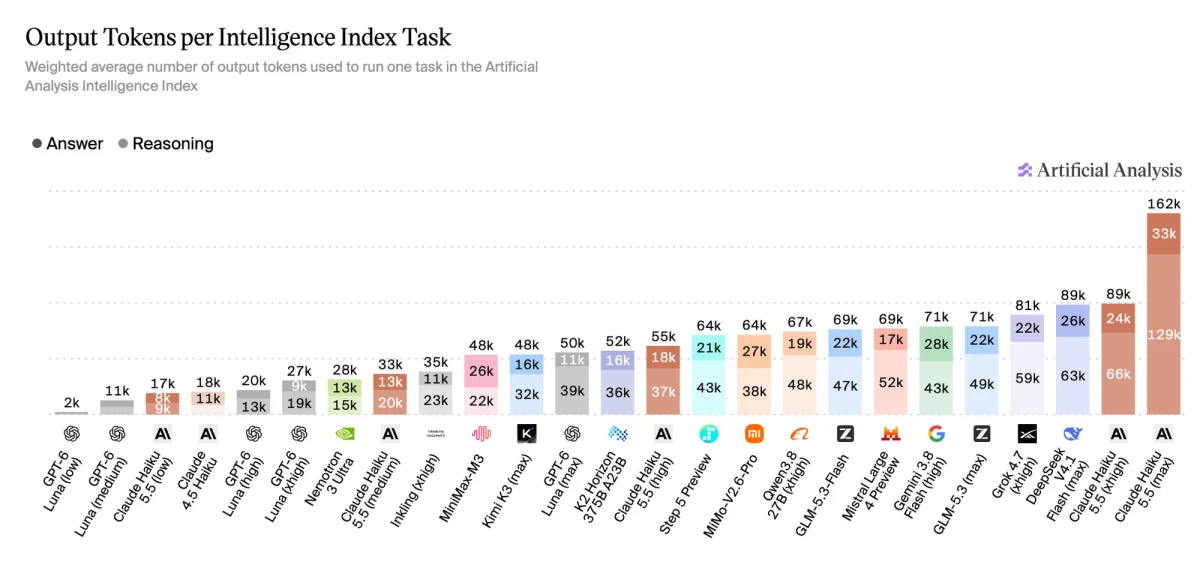
Claude Haiku 5.5(max)는 사내 프론티어 지식 작업 평가인 AA-Briefcase에서 1578 Elo에 도달했으며, 이는 GPT-6 Astra(max)와 Claude Fable 5.1(high)의 신뢰 구간 내에 있습니다
모든 effort 설정에 걸친 Claude Haiku 5.5의 Artificial Analysis Intelligence Index 개별 평가 전체 세부 분석