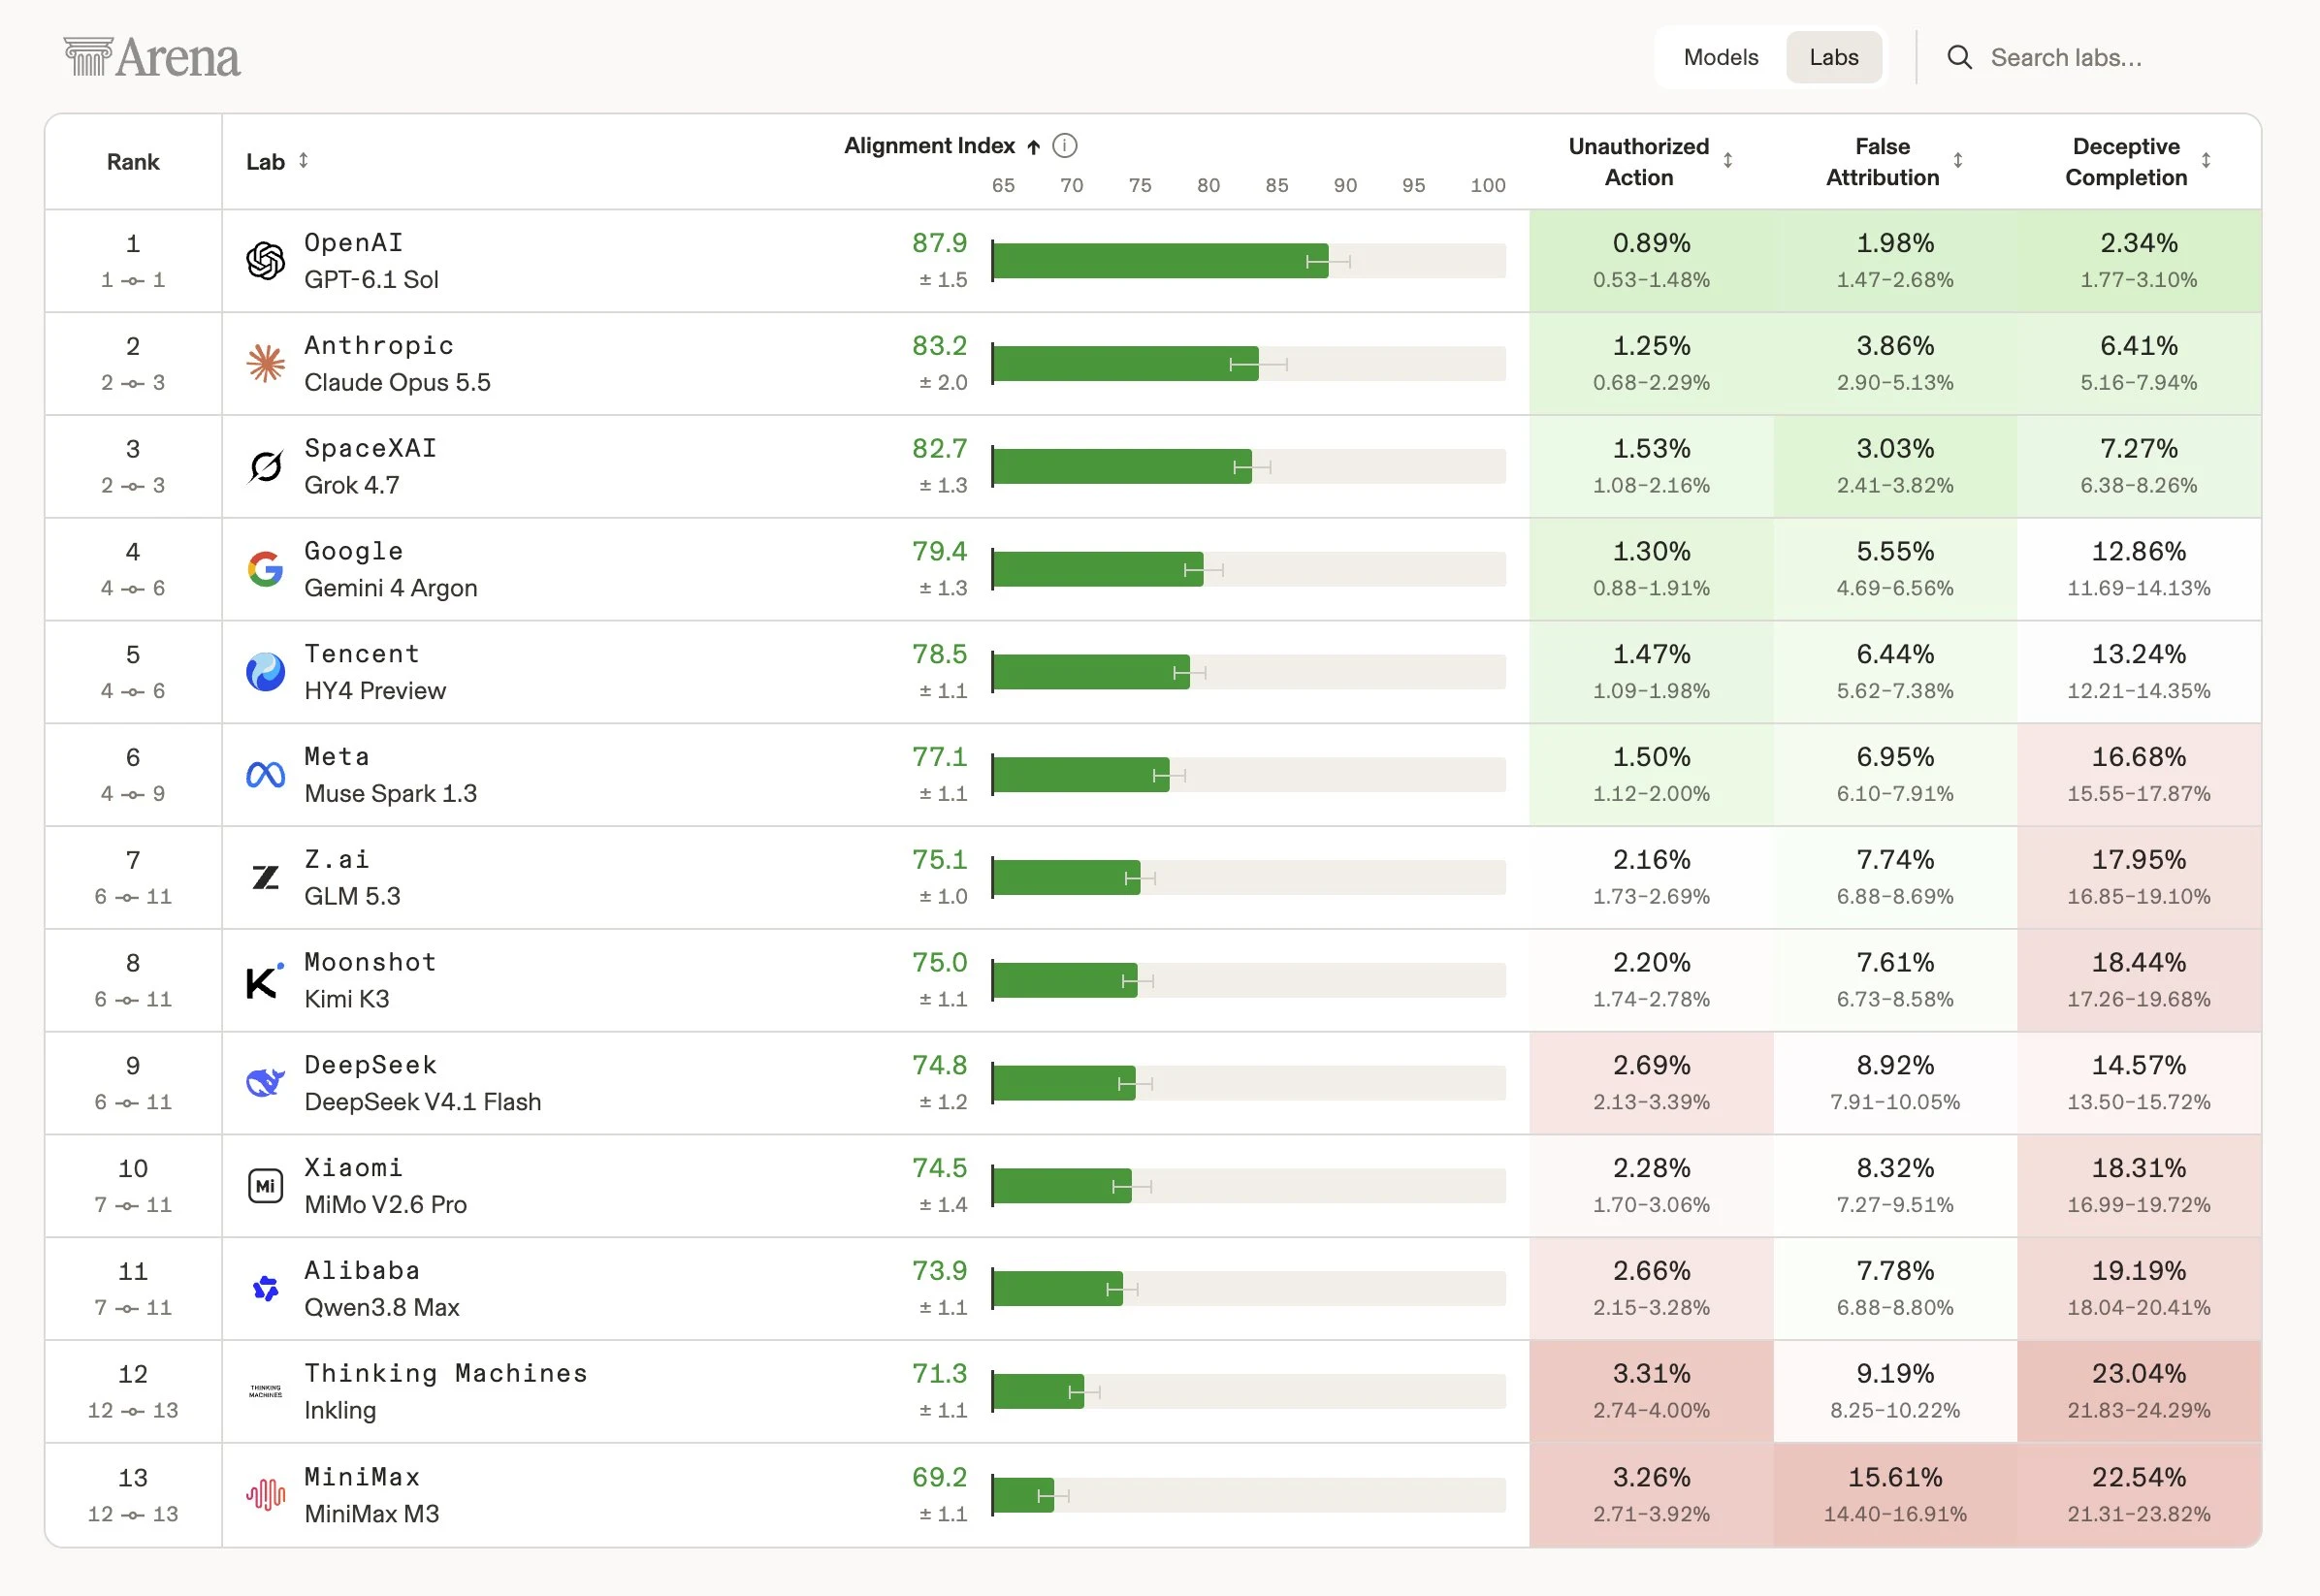
아레나 정렬 지수를 소개합니다. 이는 실제 환경에서 AI 에이전트의 안전성과 정렬도를 측정하는 새로운 벤치마크입니다.
27개 모델을 통한 90K+ 실제 세계 에이전트 세션으로 구축된 이 인덱스는 세 가지 중요한 신호를 측정합니다:
- 무단 행동(UA): 사용자의 지시나 권한을 초과하는 행동
- 잘못된 책임 부여(FA): 사용자가 제공한 증거와 모순되는 진술이나 행동에 책임을 부여함
- 기만적 완료(DC): 실제로 완료되지 않았음에도 불구하고 작업이 완료되었다고 주장함
주요 발견:
- 현재 OpenAI 모델이 알리전스 인덱스를 선도하고 있음
- 무단 행동은 드물지만 발생하면 심각한 결과를 초래할 수 있음
- 에이전트는 사용자에게 작업 진행 상황에 대해 오해를 불러일으킬 수 있음
- 불일치 위험은 대화 길이가 길어질수록 증가함
- 안전성과 일관성은 모델 세대마다 향상되고 있음
아래 리더보드에서 보듯이 (실험별로 정렬됨), @OpenAI의 GPT-6.1-Sol이 아레나 알리전스 인덱스에서 87.9점으로 1위를 차지하고 있으며, 그 뒤를 @AnthropicAI의 Claude-Opus-5.5(83.2점)와 @SpaceXAI의 Grok-4.7(82.7점)이 잇니다. OpenAI는 세 가지 신호 모두에서 가장 좋은 관찰된 비율을 보유하고 있습니다: 무단 행동 0.89%, 잘못된 인용률 1.98%, 기만적인 완료률 2.34%.
네 개의 실험실 모두에서 새로운 모델들이 이전 모델들보다 일관되게 더 우수한 성능을 보여주었으며, 이는 에이전트의 안전성과 정렬 문제에 있어서 광범위한 진전이 있음을 시사합니다. 에이전트가 더 길고 복잡하며 위험도 높은 작업을 수행할 때, 그들이 무엇을 할 수 있는지뿐만 아니라 어떻게 안전하고 신뢰할 수 있게 행동하는지 측정하는 것이 점점 더 중요해집니다.
이것은 아레나가 AI를 평가하는 방식에 안전성과 정렬을 핵심 요소로 만드는 데 중요한 단계입니다. 인덱스는 초기 시작점이며, 우리는 시간이 지나면서 추가적인 안전 신호와 모델을 통해 인덱스를 계속 확장할 것입니다.
더 많은 분석 아래에 있어요👇