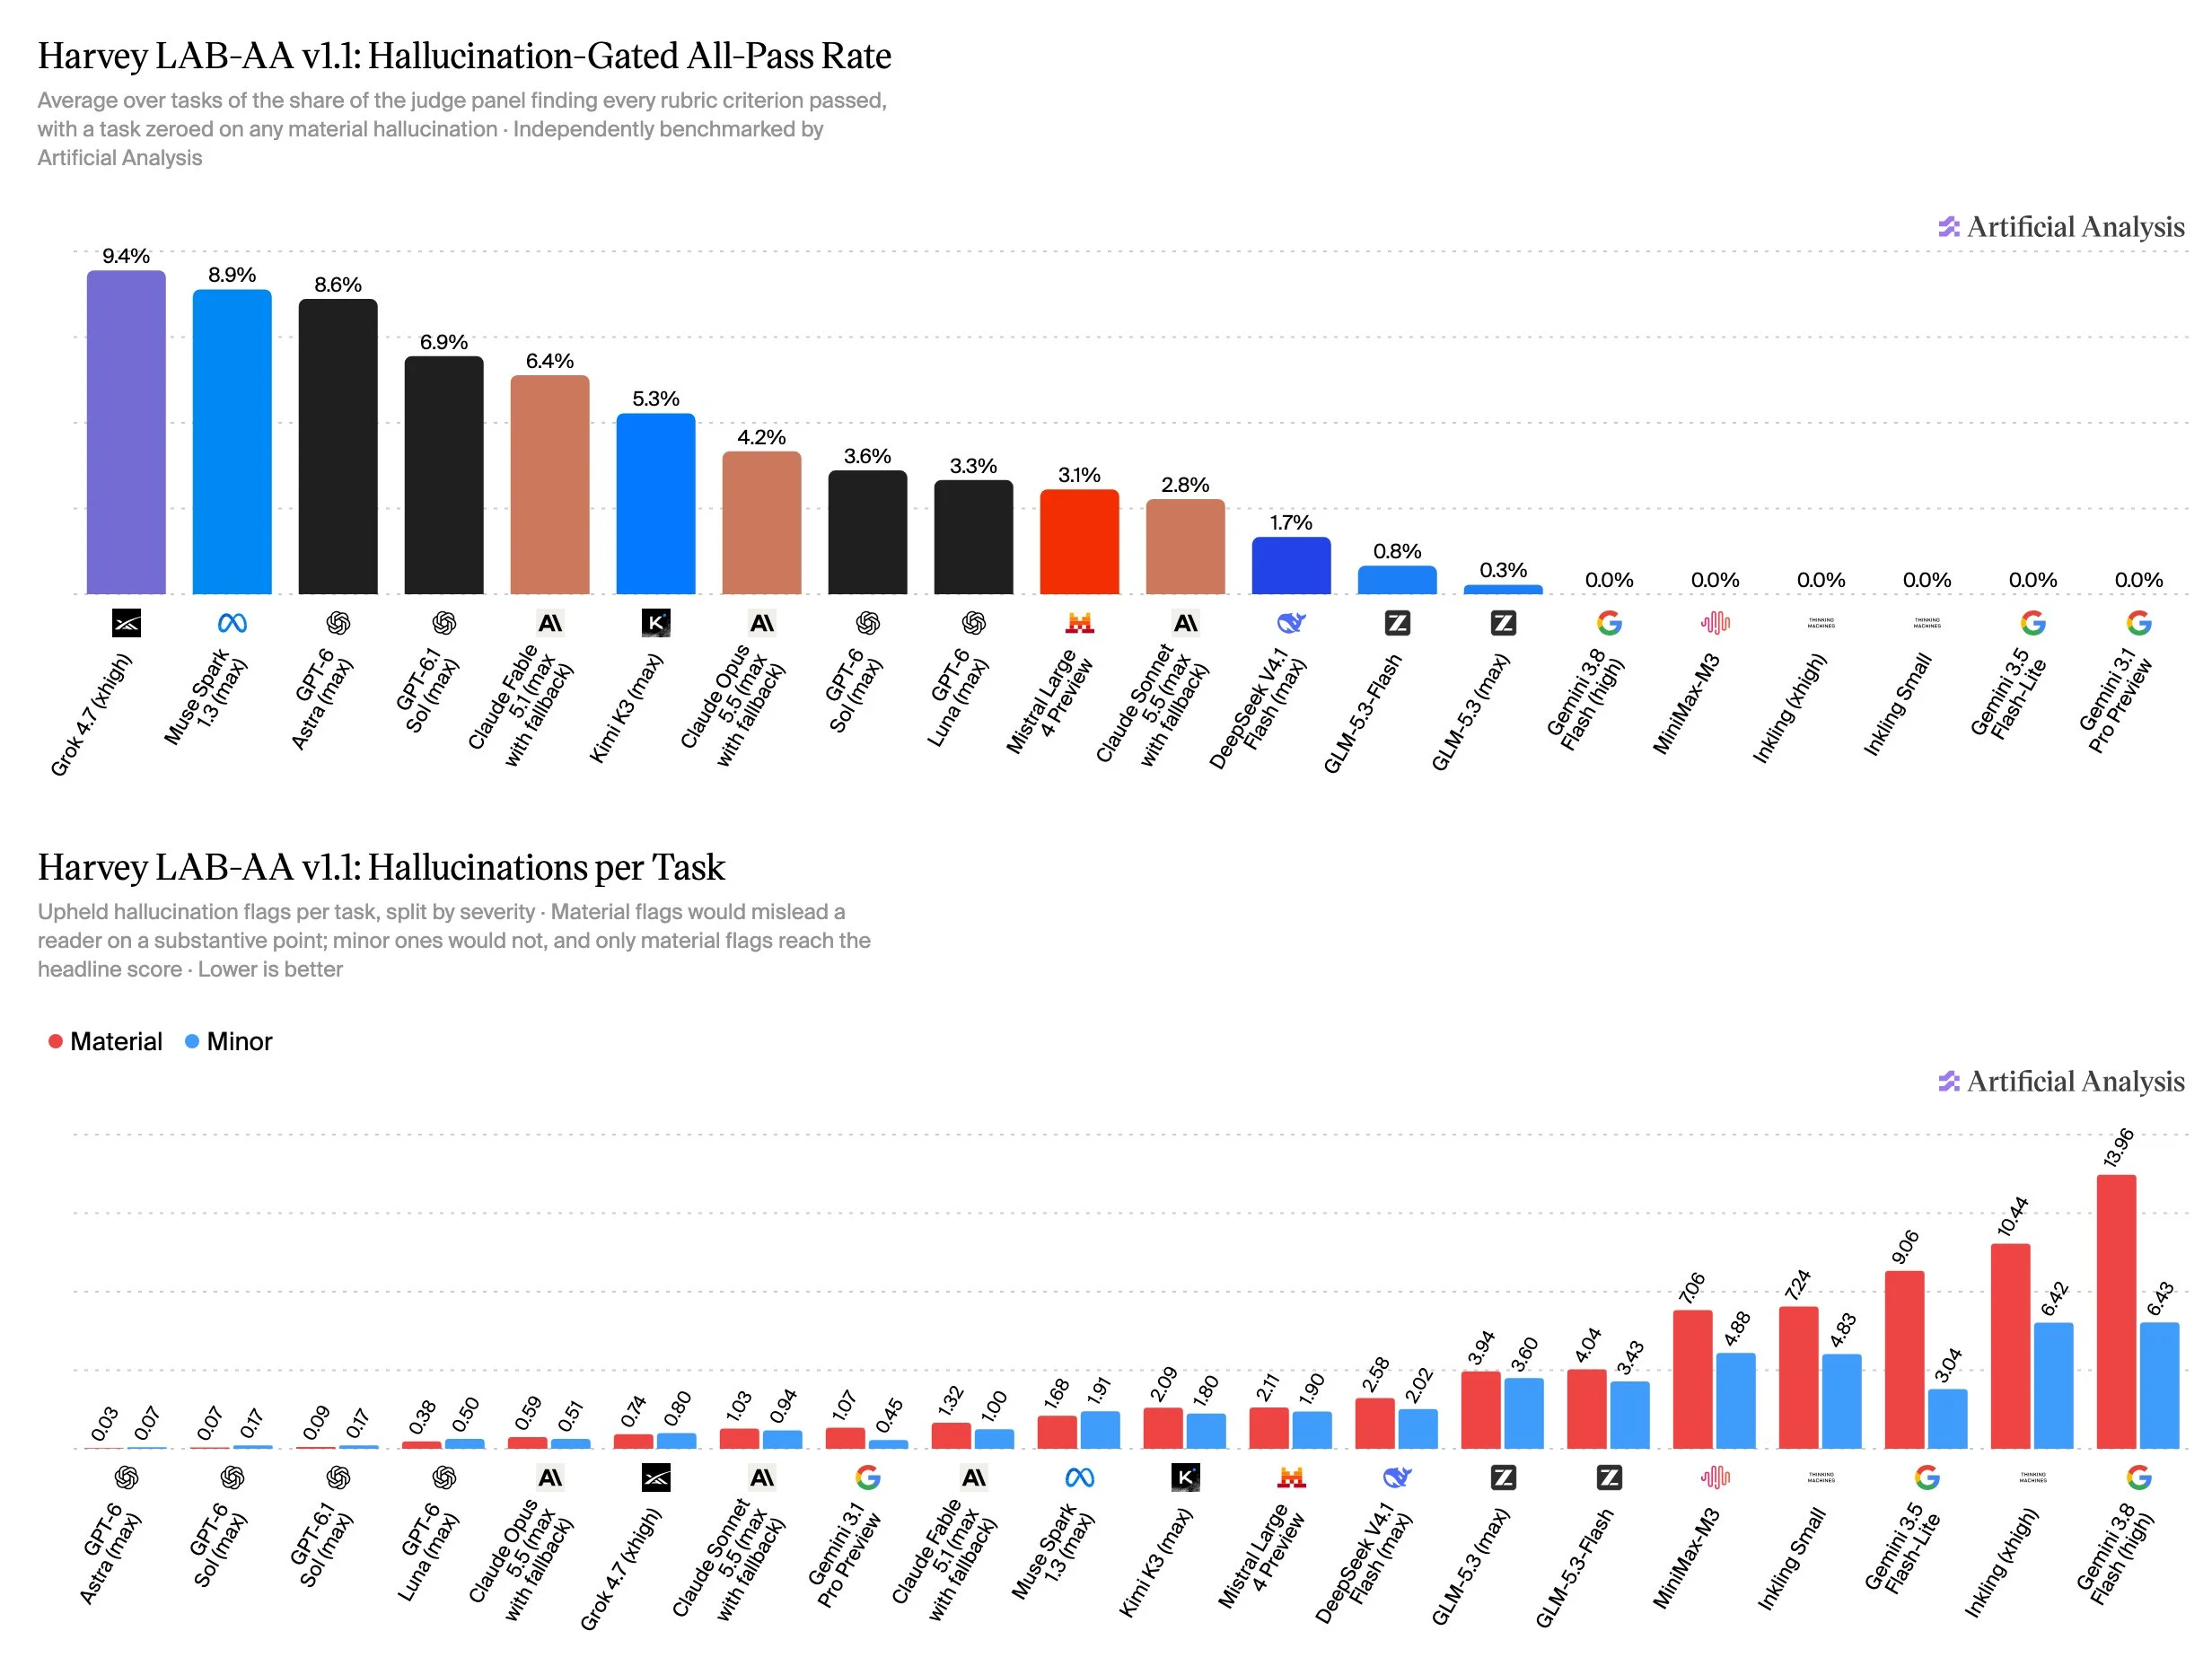
오늘 우리는 Harvey와 협력하여 Harvey LAB-AA v1.1을 발표합니다. 이번 업데이트는 Legal Agent Benchmark(LAB)의 점수 평가 방법론을 개선하여 환각 검사 기능을 추가하고, 정확한 응답을 통해 중요한 오류가 포함되지 않도록 했습니다. LAB-AA v1.1의 새로운 주요 지표인 Hallucination-Gated All-Pass Rate는 작업이 모든 기준을 충족하고 중요한 환각이 없을 때만 점수를 부여합니다.
우리는 물질적 환상이 독자를 오도할 수 있는 실질적인 점, 예를 들어 잘못된 계약상 요구되는 날짜와 같은 경우를 의미한다고 정의합니다. 반면 사소한 환상은 실제 오류로서 전달물의 법적 해석에 의미 있게 영향을 미치기 어려운 것입니다. 사소한 환상은 별도로 보고되며 헤드라인 점수에는 영향을 미치지 않습니다.
Grok 4.7 (xhigh)는 9.4%의 Hallucination-Gated All-Pass Rate를 기록하며, 출시 시 테스트된 모델들 중 60% 이상의 통과 결과에 물질적 환상이 포함되어 있었습니다.
이것은 Harvey LAB-AA의 방법론을 개선하는 첫 번째 단계입니다. 향후 업데이트에서는 변호사들이 중요하게 생각하는 모든 요소를 더 잘 반영하기 위해 Harvey와 협력할 예정입니다. 여기에는 스타일과 톤과 같은 사용성 관련 기능도 포함됩니다.
주요 요점:
➤ 리더보드 상단: @SpaceXAI의 Grok 4.7 (xhigh)는 홀러시니션 게이티드 전체 통과율이 9.4%로 선두를 달리고 있으며, @AIatMeta의 Muse Spark 1.3 (max)는 8.9%, @OpenAI의 GPT-6 Astra (max)는 8.6%로 그 뒤를 잇고 있습니다.
➤ 환각으로 인해 순위가 바뀌습니다: 환각 게이트가 없을 경우 Muse Spark 1.3 (최대)는 26.7%의 전체 통과율로 명확히 선두를 차지할 것입니다. 하지만 그 통과율 중 3분의 2는 하나 이상의 물리적 환각을 포함하고 있어, 환각 게이트가 적용된 전체 통과율은 8.9%입니다. GPT-6 Astra (최대)는 환각 게이트 이후 거의 모든 통과를 유지하며(8.9%에서 8.6%), 공동 10위에서 3위로 상승합니다.
➤ GPT-6 모델 제품군이 가장 정확합니다: GPT-6 Astra(최대)는 모든 120개의 작업에 걸쳐 4개의 작업당 0.03개의 물질적 환상을 평균하며, GPT-6 Sol(최대)은 0.07개를 평균합니다. 20개의 작업으로 구성된 서브셋에서 여섯 개의 체크러 모델을 비교했을 때, Claude Opus 5.5(높음)를 포함한 모든 체크러에서 GPT-6 Astra는 아무런 물질적 환상도 보이지 않았습니다. 반면, Gemini 3.8 Flash(높음)은 모든 작업당 13.96개의 물질적 환상을 평균합니다.
➤ 상위 점수를 기록하는 모델이 가장 비싼 것은 아닙니다: Grok 4.7 (xhigh)는 리더보드에서 1개의 작업에 약 $9.50의 비용으로 1위를 차지하며, 이는 Claude Fable 5.1 (최대 기능과 대체 옵션 포함)의 약 $21.70인 가장 비싼 모델의 절반에도 미치지 않습니다. Muse Spark 1.3 (최대 기능)는 저비용에 강력한 성능을 보여 2위를 차지하며 1개의 작업에 약 $4.20의 비용이 듭니다.
Harvey LAB과의 협력 및 관련 업무에 대해 @harvey의 @nikogrupen과 @ItsJulioPereyra에게 감사드립니다.