
연구에 따르면 AI 에이전트 팀들은 거의 측정할 수 없는 품질 향상에 대해 엄청난 토큰을 낭비하고 있다
 마티아스 바스티안
의 링크드인 프로필 보기
Oct 11, 2026
연구 결과에 따르면, AI 에이전트 팀들은 단일 에이전트보다 거의 더 나은 결과를 내지 못합니다.
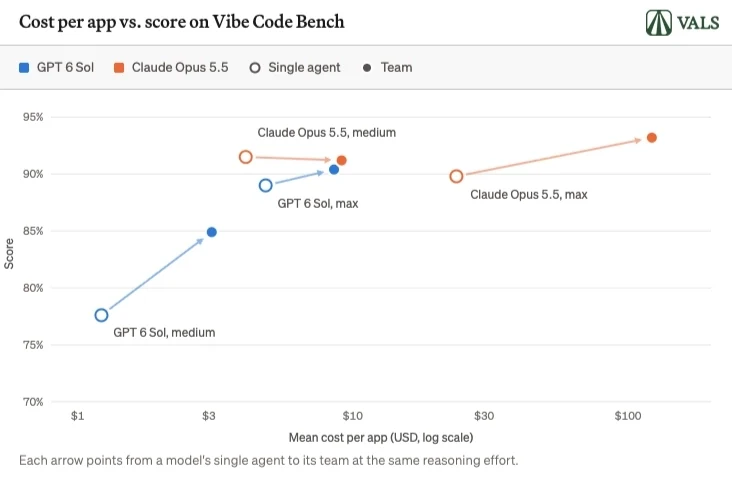
Evals company Vals AI는 “Vibe Code Bench”에서 GPT-6 Sol과 Claude Opus 5.5를 단독으로도, 팀 형태로도 테스트했으며, 두 가지 추론 수준인 중간 및 최대 추론 노력 수준에서 진행되었습니다. 팀의 비용은 단일 에이전트보다 1.8배에서 5.1배 더 높았습니다.
네 가지 비교에서 팀과 단독 에이전트 간의 결과를 보면, 통계적으로 유의미한 향상을 보인 경우는 하나뿐입니다. GPT-6 Sol은 중간 수준의 추론에서 팀이 7.3점 더 높은 점수를 얻었습니다. 최고 수준의 추론에서는 팀 구성도 Sol과 Opus 모두에게 5.5점의 실질적인 이점을 주지 않았습니다. 결과는 대부분의 경우 에이전트 팀의 추가 비용이 가치가 없다는 것을 시사합니다. 특히 모델이 이미 전체 컴퓨팅 능력을 발휘하고 있을 때는 더욱 그렇습니다.
| Opus 5.5의 작업 | 1개의 에이전트 | 10개의 에이전트 | 30 에이전트 | 100 에이전트 |
|---|---|---|---|---|
| 지식 기반 | 0.53 | 0.70 | 0.71 | 0.74 |
| Lean 정리 증명 | 0.39 | 0.66 | 0.66 | 0.68 |
Fable 5.1은 10명 이상의 에이전트를 사용하는 Lean 정리 증명 작업에서 더 나은 품질 향상을 보였지만, 모든 테스트에서 Opus 5.5보다 낮은 점수를 기록했습니다. 지식 기반 작업에서는 30명에서 100명의 에이전트로 확장할 때 Fable의 점수가 약간 하락했습니다.
더 많은 에이전트는 더 빠른 결과를 원하지만 더 나은 출력은 원하지 않습니다
OpenAI 연구원 노암 브라운은 Dwarkesh Podcast에서 다중 에이전트 시스템은 더 나은 품질이 아닌 속도를 중시한다고 확인했습니다. 4개의 에이전트가 작업을 두 배 빠르게 해결했지만 비용도 두 배가 들었습니다. 16개의 에이전트가 되면 그 패턴은 유지되었지만 효율성은 약간 낮아졌습니다.
그 효과는 과제에 크게 달려 있다고 그는 말했다. 웹 연구와 수학은 잘 병렬화되지만, 소설을 쓰는 것은 그렇지 않다고 했다. 10,000명의 에이전트를 소설에 투입하는 것은 10,000명의 사람을 투입하는 것만큼 무의미할 것이다. 브라운은 비용이 너무 높기 때문에 매우 많은 수의 에이전트를 사용하는 방식은 아직 거의 탐구되지 않았다고 인정했다.
OpenAI 개발자 에릭 프로벤처는 에이전트 스웜을 사용하는 것을 바로 이런 이유로 경고했습니다. 그는 에이전트들 간의 조정이 실패하기 때문에 그것이 돈 낭비일 가능성이 높다고 주장했습니다. 그는 이를 ‘조정 세금’이라고 불렀습니다.
AI 뉴스 – 과장 없이, 인간이 선별한 내용
THE DECODER에 가입하여 광고 없는 읽기, 주간 AI 뉴스레터, 매년 6회 발행되는 독점적인 "AI Radar" 전선 보고서, 전체 아카이브 접근 권한, 그리고 우리의 댓글 섹션에 접근하세요.
전체 내용은 여기에 있습니다.
흥분 없이의 보도를 원한다면 구독하세요.
- THE DECODER의 모든 기사에 대한 전체 접근 권한
- 광고 없음
- 댓글과 커뮤니티 토론에 참여하세요
- 주간 AI 뉴스 요약 메일로 보내기
- 6회/년: “AI 레이더” — 가장 중요한 AI 주제에 대한 심층적인 탐구
- 일일 AI 뉴스, 항상 최신 정보
- 우리의 전체 10년간의 아카이브
- 10년 이상 AI 분야에서 근무한 팀에 의해 지원됨