IT之家 10월 12일 소식에 따르면, 알리 천문은 오늘 QwenGyre를 공식적으로 출시했습니다. 이는 장기 지능형agent 작업을 위한 온라인 강화학습 프레임워크입니다.
공식 발표에 따르면, 스마트 어시스턴트가 복잡한 작업을 수행할 때 한 번의 실행이 수 시간에 걸리며, 모델과 환경 사이에는 수백 회의 상호 의존적인 상호작용이 일어나고 백만 단위의 토큰이 처리됩니다. QwenGyre는 탄력적인 스케줄링과 경로 처리를 통해, 이러한 장기간에 걸리는 작업을 효과적인 훈련 자료로 만들어, 동시에 능력과 효율성을 향상시킵니다.
QwenGyre는 GPU를 여러 계산 단위로 나눌 수 있으며, 작업이 끝날 때마다 비어 있는 단위가 훈련에 투입된다. 마치 프로젝트 팀에서 누가 먼저 결과를 제출하고 누가 먼저 회의에 참여하는 것과 같다. 진행 중인 작업은 전혀 방해받지 않고, 진행 상황과 상태는 그대로 유지되며, 이전에 계산된 캐시도 전체로 옮겨져 다시 시작할 필요가 없다. 새로 비어난 단위는 바로 이번 훈련에 투입되어, 더 빨리 계산하는 사람이 더 많은 일을 한다. 마지막으로 핵심 단위가 결과를 종합하여 매개변수 업데이트를 완료한다.
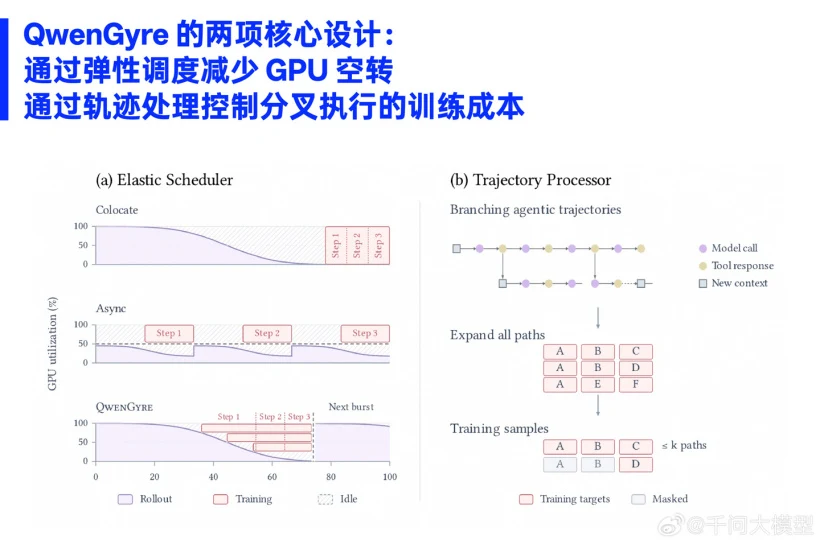
IT之家는 QwenGyre가 토큰-인-토큰-아웃 방식을 통해 각 출력 생성 시의 실제 컨텍스트를 기록하고, 공유 접두사로 구성된 트랙트 트리를 만들며, 선택된 경로만을 훈련 샘플로 전개한다는 점을 알게 되었습니다. 또한, 시간 초과되었지만 일부 완료된 작업도 Partial Scoring을 통해 유용한 피드백을 제공하여 어떠한 노력도 낭비하지 않습니다.
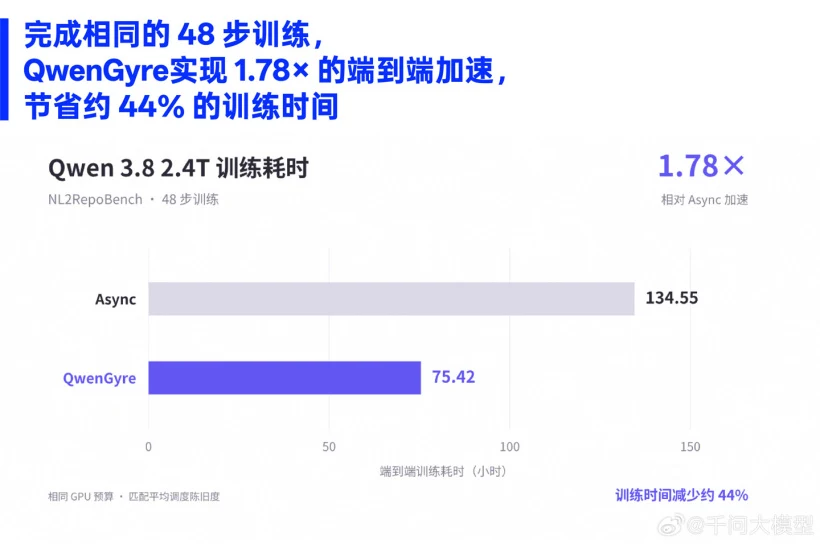
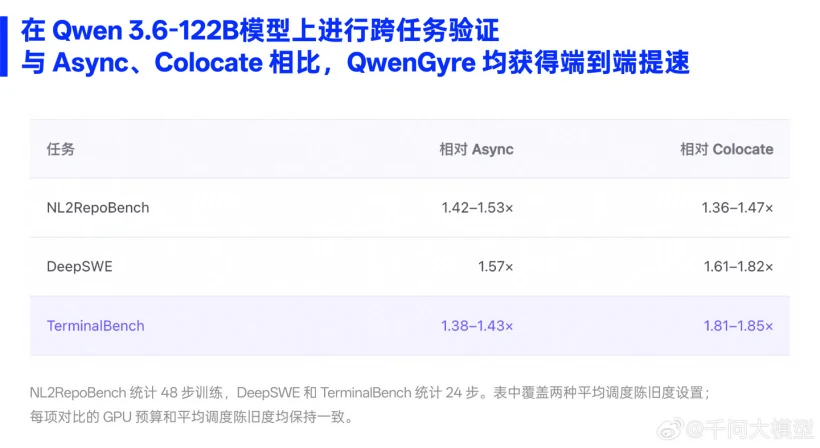
성능 측면에서, 공식 연구팀은 NL2RepoBench 온라인 강화 학습 실험에서 매번 약 70만 토큰의 작업을 통해 훈련을 진행했으며, 48단계의 훈련 후 모델의 통과율은 52.5%에서 58.5%로 향상되었습니다. 동일한 GPU 예산 하에서 QwenGyre는 Async에 비해 1.78배의 엔드투엔드 속도 향상을 이루었으며, 훈련 점수는 Async와 Colocate와 유사했습니다. Qwen3.6-122B에서 진행된 여러 작업 간 검증에서 NL2RepoBench, DeepSWE, TerminalBench 세 가지 작업 모두 엔드투엔드 속도 향상을 보였습니다.