
AI 팩토리가 메가와트 규모에서 기가와트 규모로 성장함에 따라, 이를 구축하는 데는 첨단 컴퓨팅 그 이상이 필요합니다. 개방형 표준은 업계가 AI 인프라를 더 빠르고, 더 효율적이며, 더 안정적으로 확장하는 데 도움을 주고 있습니다.
산호세 맥거너리 컨벤션 센터에서 열리는 Open Compute Project(OCP) 글로벌 서밋에서 NVIDIA는 차세대 AI 인프라를 위한 공통 기반을 만드는 것을 목표로 하는 새로운 파트너십과 기여를 발표했습니다.
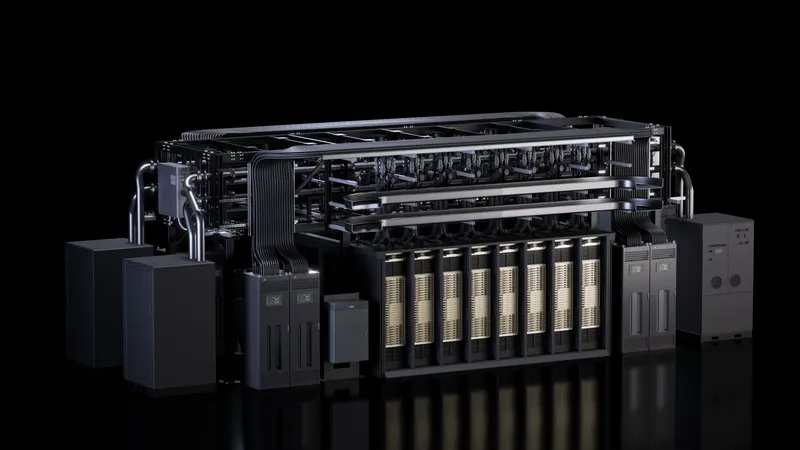
NVIDIA는 주요 NVIDIA Vera Rubin 랙 및 컴퓨트 트레이 설계를 개방형 NVIDIA MGX 아키텍처를 통해 OCP에 기여하여, 시스템 빌더들이 차세대 AI 팩토리 인프라를 개발할 수 있는 공통 기반을 제공했습니다.
이러한 노력은 AI 팩토리 자체와, 이에 전력을 공급하는 유틸리티 그리드, 그리고 현대 가속 컴퓨팅의 핵심인 랙 규모 아키텍처에 걸쳐 이루어집니다.
NVIDIA와 파트너사, 개방형 아키텍처 발전 발표
OCP 행사에서 NVIDIA와 파트너사는 여러 건의 발표를 진행했습니다.
- NVIDIA와 하이퍼스케일러는 AI 팩토리 설계 표준 및 그리드 복원력을 포함해 차세대 AI 팩토리를 위한 개방형 표준을 발표했습니다.
- NVIDIA는 NVIDIA DSX AI Factory를 위한 새로운 오픈 소스 소프트웨어 컴포넌트를 출시했습니다.
- Meta와 NVIDIA는 NVIDIA Spectrum-X Ethernet SuperNIC 및 Spectrum-6 혁신을 통해 개방형 AI 네트워킹을 발전시켰습니다.
- Visionbay는 Vera Rubin 시대를 위한 800V DC AI 팩토리 설계를 선보였습니다.
- NVIDIA와 Cisco는 400Gb/s 기반 네트워킹 패브릭용 업계 최초의 모듈인 Ultra-Dense Small Form Factor Pluggable(USFP) 표준을 발표했습니다.
- NVIDIA와 Google은 향후 NVIDIA ConnectX-10 SuperNIC 및 BlueField DPU에서의 Falcon Transport 지원을 발표했습니다.
NVIDIA의 하이퍼스케일 및 고성능 컴퓨팅 부사장인 Ian Buck는 가득 찬 청중 앞에서 개방형 인프라가 어떻게 전 세계 AI 팩토리 확장의 핵심 요소가 되고 있는지 논의했습니다.
OCP에서 발표된 이 뉴스는 NVIDIA의 익스트림 코드사인과 개방형 표준의 결합이 배포를 가속화하고, 전력 효율을 개선하며, tokens-per-watt 성능을 높이는 방식을 조명합니다.
OCP에서 MGX 랙 기여로 앞선다 가는 Vera Rubin AI 팩토리 🔗
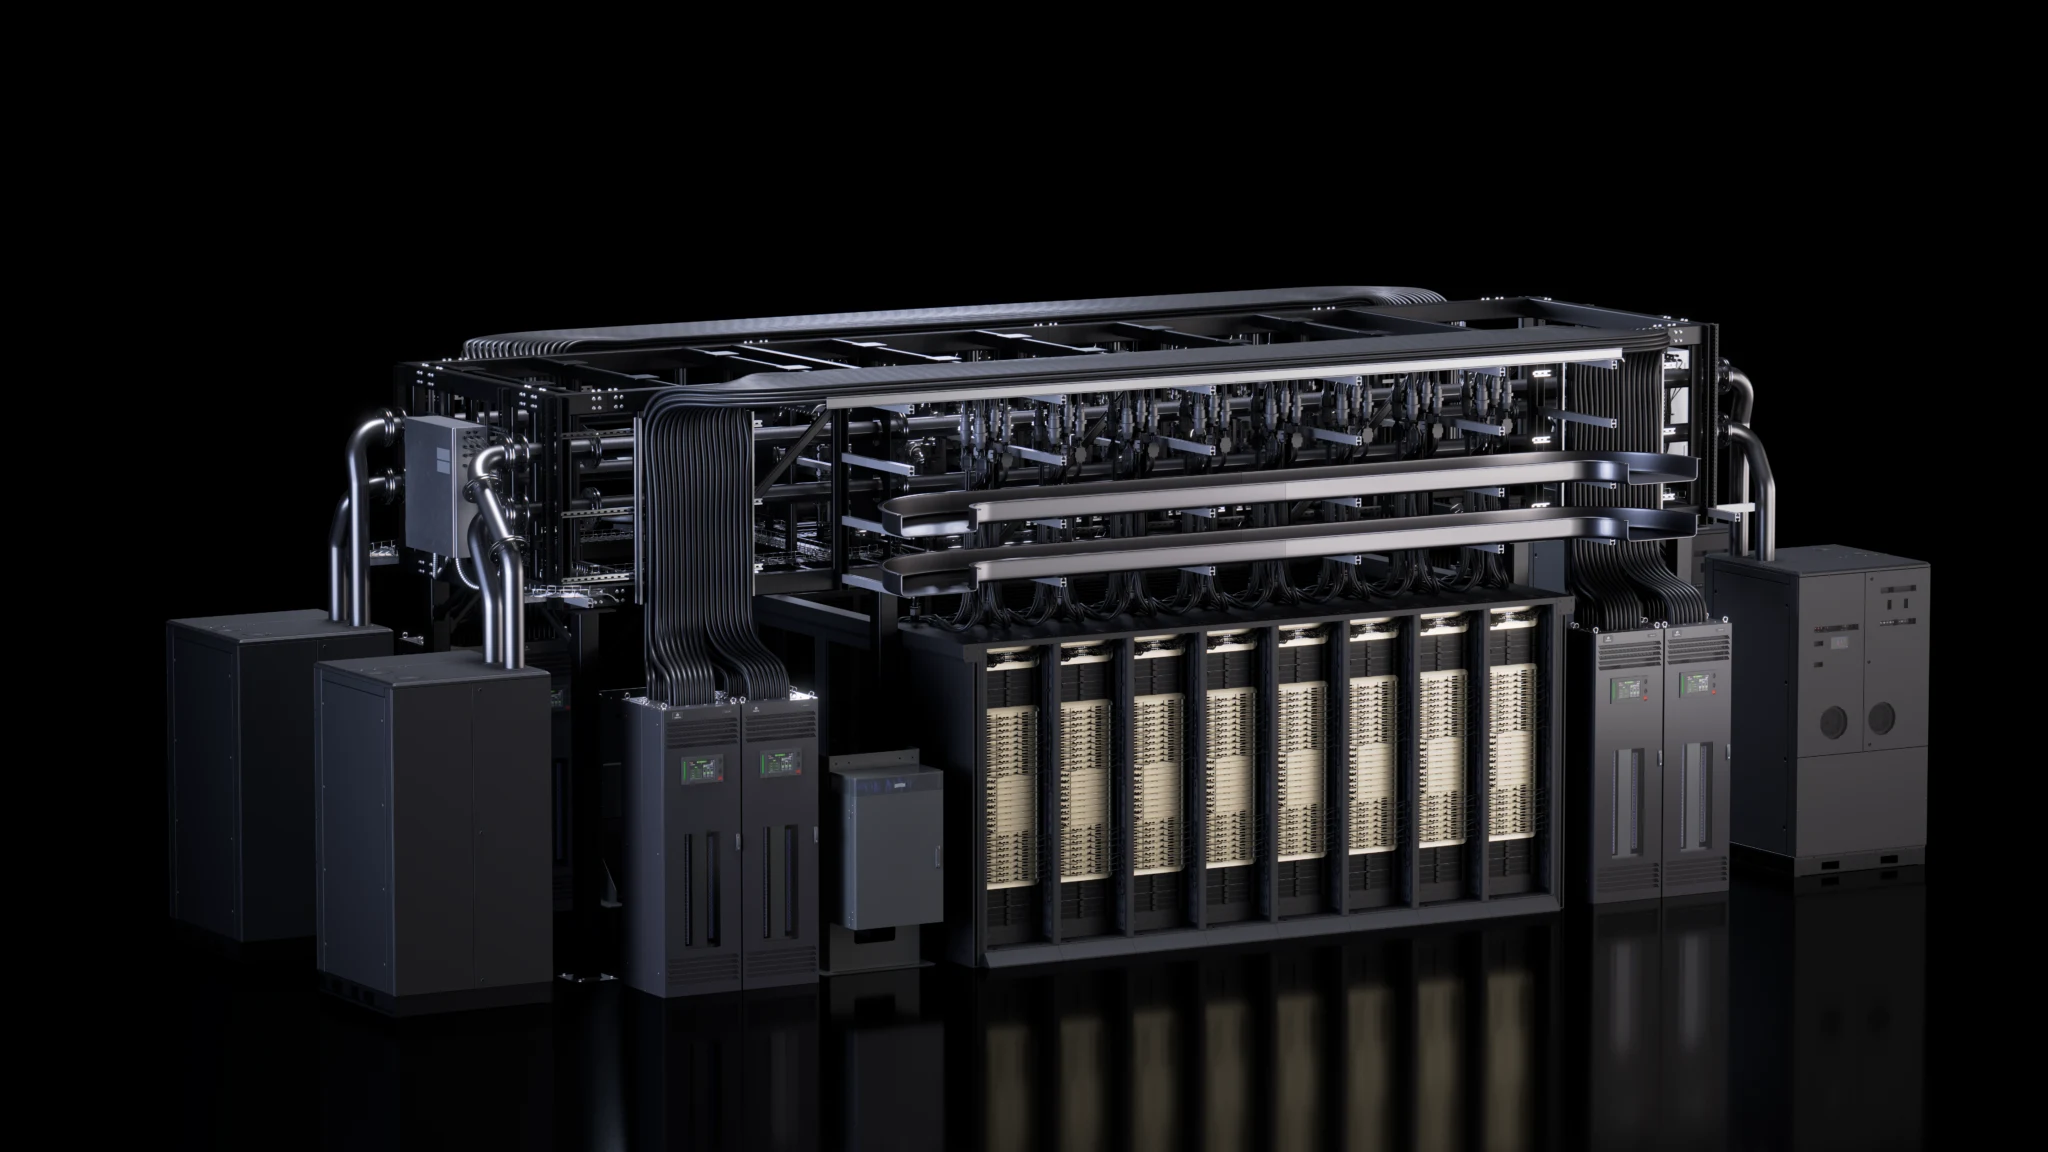
NVIDIA는 업계 선도 기업들과 함께 OCP의 Open DC 이니셔티브를 통해 3세대 MGX AI 데이터 센터 레퍼런스 설계에 기여했습니다.
MQD 및 MQDB와 같은 개방형 액침 냉각 기술과 결합된 이 노력은 검증된 AI 팩토리 설계를 다른 이들이 채택하고, 제조하고, 확장할 수 있는 업계 표준으로 전환하는 데 도움을 줍니다.
NVIDIA Vera Rubin AI 팩토리를 위해, 업데이트된 MGX 1.2 사양은 랙 규모 블라인드메이트 액침 냉각, 상호 운용 가능한 랙 규모 상호연결 인프라, 그리고 더 높은 전력의 AI 시스템을 위해 설계된 액침 냉각 5,000A 버스바로 AI 팩토리를 위한 개방형 아키텍처를 확장합니다. 또한 네이티브 19인치 장비 지원과 더 높은 밀도의 랙 설계도 추가됩니다.
MGX 1.2는 구성 가능한 I/O 베이, 팬리스 액침 냉각 컴퓨트 트레이, 표준화된 전력 및 냉각 인터페이스, 그리고 생태계 파트너가 상호 운용 가능한 가속 컴퓨팅 플랫폼을 구축하는 데 도움이 되는 공통 인프라로 모듈성을 더욱 확장합니다. 또한 조립, 테스트 및 서비스 시간을 개선하여 제조와 현장 서비스를 간소화함으로써 더 빠르고 효율적인 인프라 구축을 가능하게 합니다. 이 아키텍처는 최대 250kW의 랙 배치를 지원하면서도 서비스성, 배포 및 인프라 재사용을 단순화합니다.
Vera CPU 랙 설계 사양은 NVIDIA MGX 개방형 아키텍처를 가속 컴퓨팅을 넘어 확장하여, 성장하는 에이전틱 AI 시대를 위한 목적에 맞게 구축된 플랫폼을 제공합니다. Vera Rubin NVL72가 대규모 학습 및 추론의 기반이 되는 동안, NVIDIA Vera CPU 랙은 도구 호출, 오케스트레이션 및 샌드박스 실행을 지원하도록 설계되어 AI 에이전트가 애플리케이션, 데이터 및 서비스와 실시간으로 상호작용할 수 있도록 돕습니다.
3세대 NVIDIA MGX 랙 아키텍처를 기반으로 구축된 Vera CPU 랙은 컴퓨트, 네트워킹, 전력 및 냉각을 하나의 공통 모듈형 플랫폼으로 통합하는 동일한 랙 규모 설계 원칙을 공유합니다. 이 접근 방식을 통해 파트너는 공유 생태계, 간소화된 통합, 그리고 차세대 AI 팩토리를 위한 일관된 기반의 혜택을 누리면서 특수 인프라를 배포할 수 있습니다.
NVIDIA, DSX AI 팩토리용 새로운 오픈 소스 소프트웨어 컴포넌트 출시 🔗
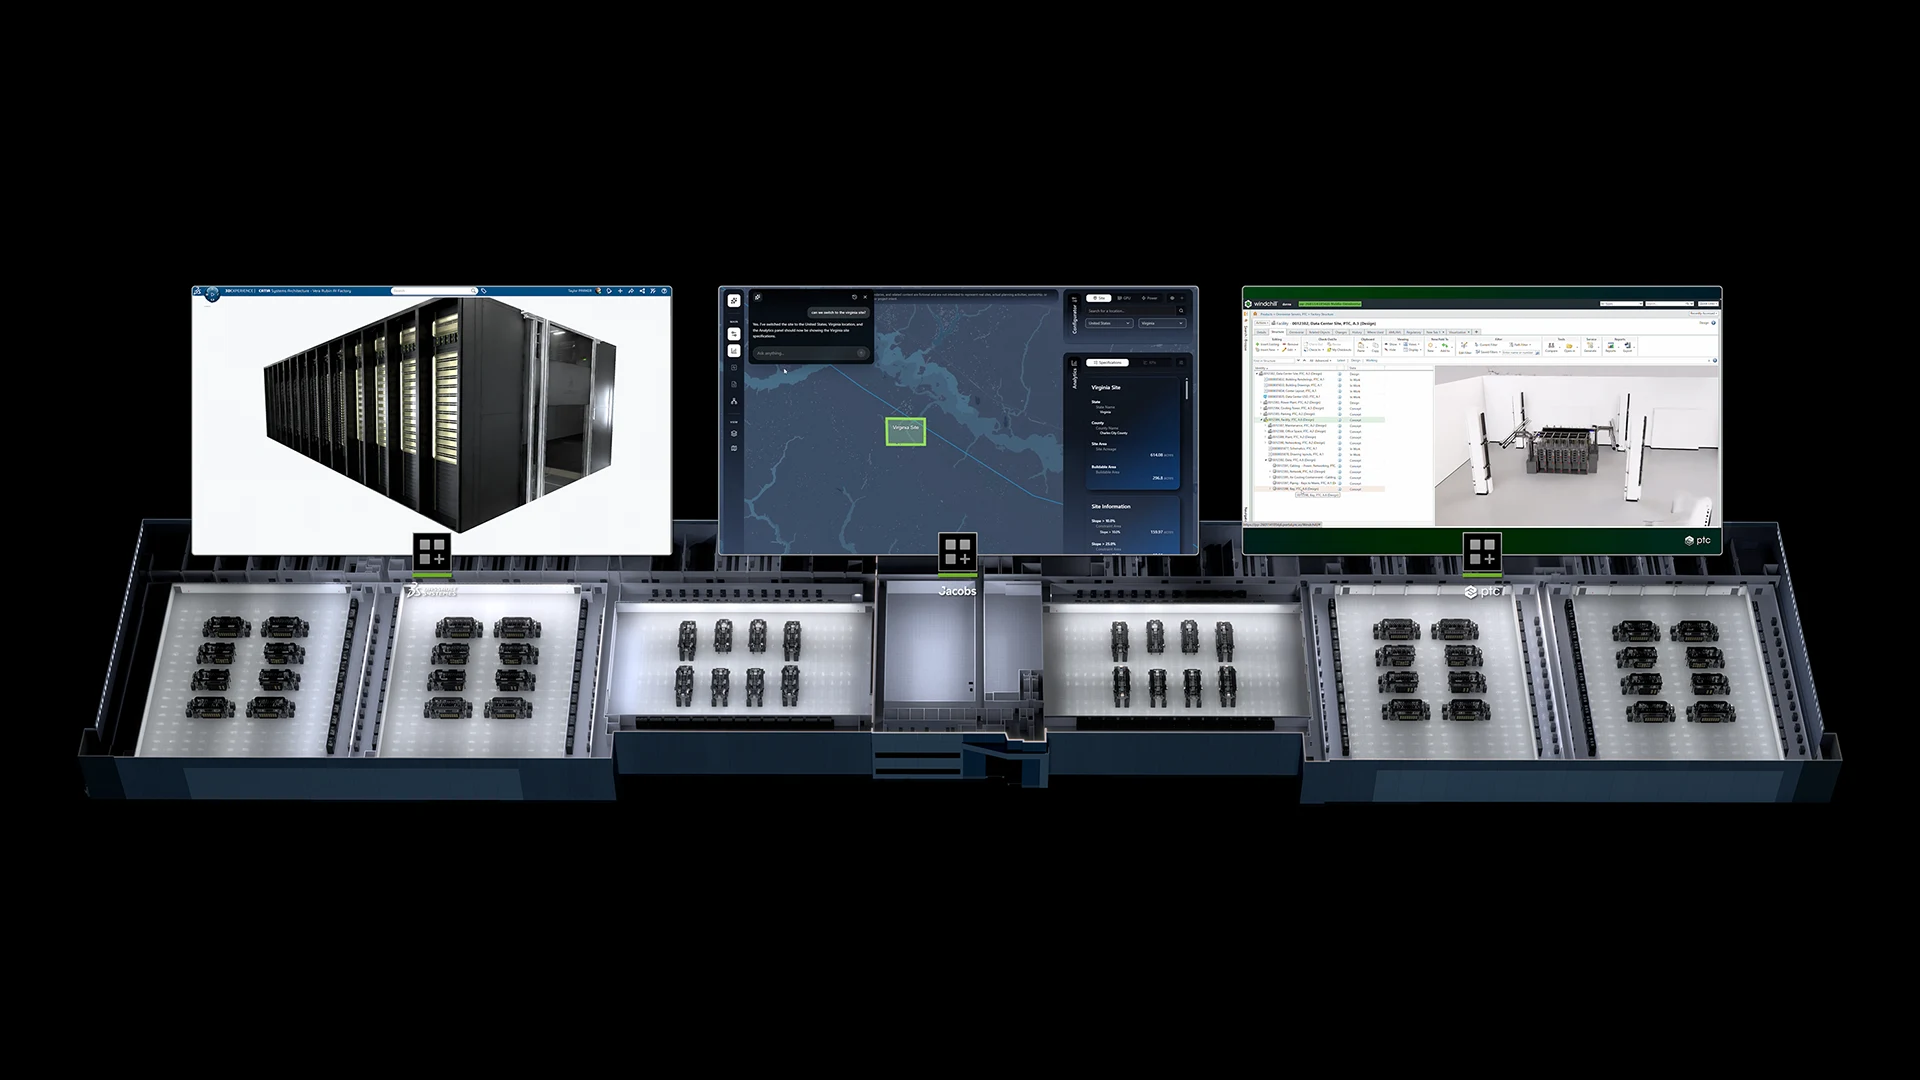
NVIDIA DSX AI 팩토리 플랫폼 컴퓨팅, 네트워킹, 전력, 냉각, 시설 및 소프트웨어를 통합하기 위해 극한의 코드자인(codesign)을 적용하여 AI 팩토리가 하나의 최적화된 시스템으로 운영되도록 지원함으로써, 가용 인프라 제약 조건 내에서 AI 출력을 극대화합니다. 이 통합 시스템의 중심에는 DSX OS가 있으며, 이는 DSX 아키텍처를 대규모로 조정되고 반복 가능한 운영으로 전환하는 오픈 운영 계층입니다.
OCP에서 NVIDIA는 네트워크 구성, 클러스터 검증, 랙 관리 및 베어메탈 프로비저닝을 위한 오픈 소스 구성 요소로 DSX OS를 확장했습니다:
- NVIDIA Config Manager: 대규모 스위치 구성을 자동화하여 고객이 최소한의 수작업 또는 수작업 없이도 일관된 AI 팩토리 네트워크 패브릭을 배포, 검증 및 유지할 수 있도록 지원합니다/
- NVIDIA Cluster Readiness Engine: 훈련을 시작하기 전에 실제 워크로드 시뮬레이션으로 GPU 클러스터를 스트레스 테스트하여 하드웨어 상태를 보증함으로써 비용이 많이 드는 작업 중단을 제거하는 데 도움을 줍니다.
- NVIDIA Rack Management Service: 랙을 퍼스트클래스 단위로 취급하여 AI 팩토리 규모의 펌웨어 관리를 개선하는 랙 하드웨어 추상화 및 운영 솔루션을 제공합니다.
- NVIDIA 인프라 컨트롤러용 Cluster API Provider: 베어메탈 배포와 테넌트 온보딩을 가속화하여, 날것의 AI 하드웨어를 며칠이 아닌 몇 시간 만에 프로덕션 준비가 완료된 클러스터로 전환합니다.
NVIDIA DGX Cloud 운영 경험에서 개발된 이 오픈 소스 컴포넌트들은 클라우드 제공업체와 소프트웨어 파트너가 AI 팩토리 기능을 자사의 멀티테넌트 플랫폼에 직접 통합할 수 있게 해줍니다.
개발자는 DSX AI Factory Github 페이지 를 방문하여 NVIDIA DSX AI Factory 플랫폼의 신규 및 기존 오픈 소스 소프트웨어 컴포넌트를 탐색하고 기여할 수 있습니다.
NVIDIA와 하이퍼스케일러, 차세대 AI 팩토리를 위한 개방형 표준 발표 🔗
AI 인프라가 전 세계적으로 확장되려면 고급 하드웨어 이상의 것이 필요합니다. 바로 전체 산업이 그 위에 구축할 수 있는 공통의 기반이 필요합니다.
OCP에서 NVIDIA는 AMD, Google, Meta와 함께 그 기반을 확립하는 새로운 개방형 사양을 발표했습니다. Open Data Center Specification v0.7 은 전력 아키텍처부터 냉각 인프라, 물리적 배치에 이르기까지 차세대 AI 팩토리 시설 설계를 위한 통합 청사진을 정의합니다.
Google, Meta, Microsoft, NVIDIA가 발표한 OCP Grid Resilience Specification은 대규모 AI 인프라가 전력망 교란 상황에서 어떻게 동작해야 하는지, 즉 연결 상태를 유지하고 자동으로 대응하며 2초 미만 내에 거의 최대 부하로 복구해야 함을 규정합니다.
이제 이러한 표준이 공개됨에 따라, 전 세계 제조업체는 구축의 공통 목표를 갖게 되었습니다. 장비 제조업체, 콜로케이션 제공업체, 데이터 센터 운영자는 개별 고객의 독점 사양을 기다릴 필요 없이, 전 세계에서 건설 중인 AI 팩토리에 전력을 공급하는 인프라 계층의 설계, 제조, 납품을 시작할 수 있습니다.
이러한 사양들은 NVIDIA DSX 레퍼런스 디자인과 호환되며, 시설 배치와 전력 아키텍처부터 전력망 신호를 실시간으로 모니터링하고 대응하는 소프트웨어에 이르기까지 두 사양 모두의 검증된 배포 가능한 구현을 제공합니다. Vera Rubin AI 팩토리를 구축하는 운영자에게는 이제 개방형 커뮤니티 표준에서 가동 중인 시스템까지 곧바로 이어지는 길이 있는 것입니다.
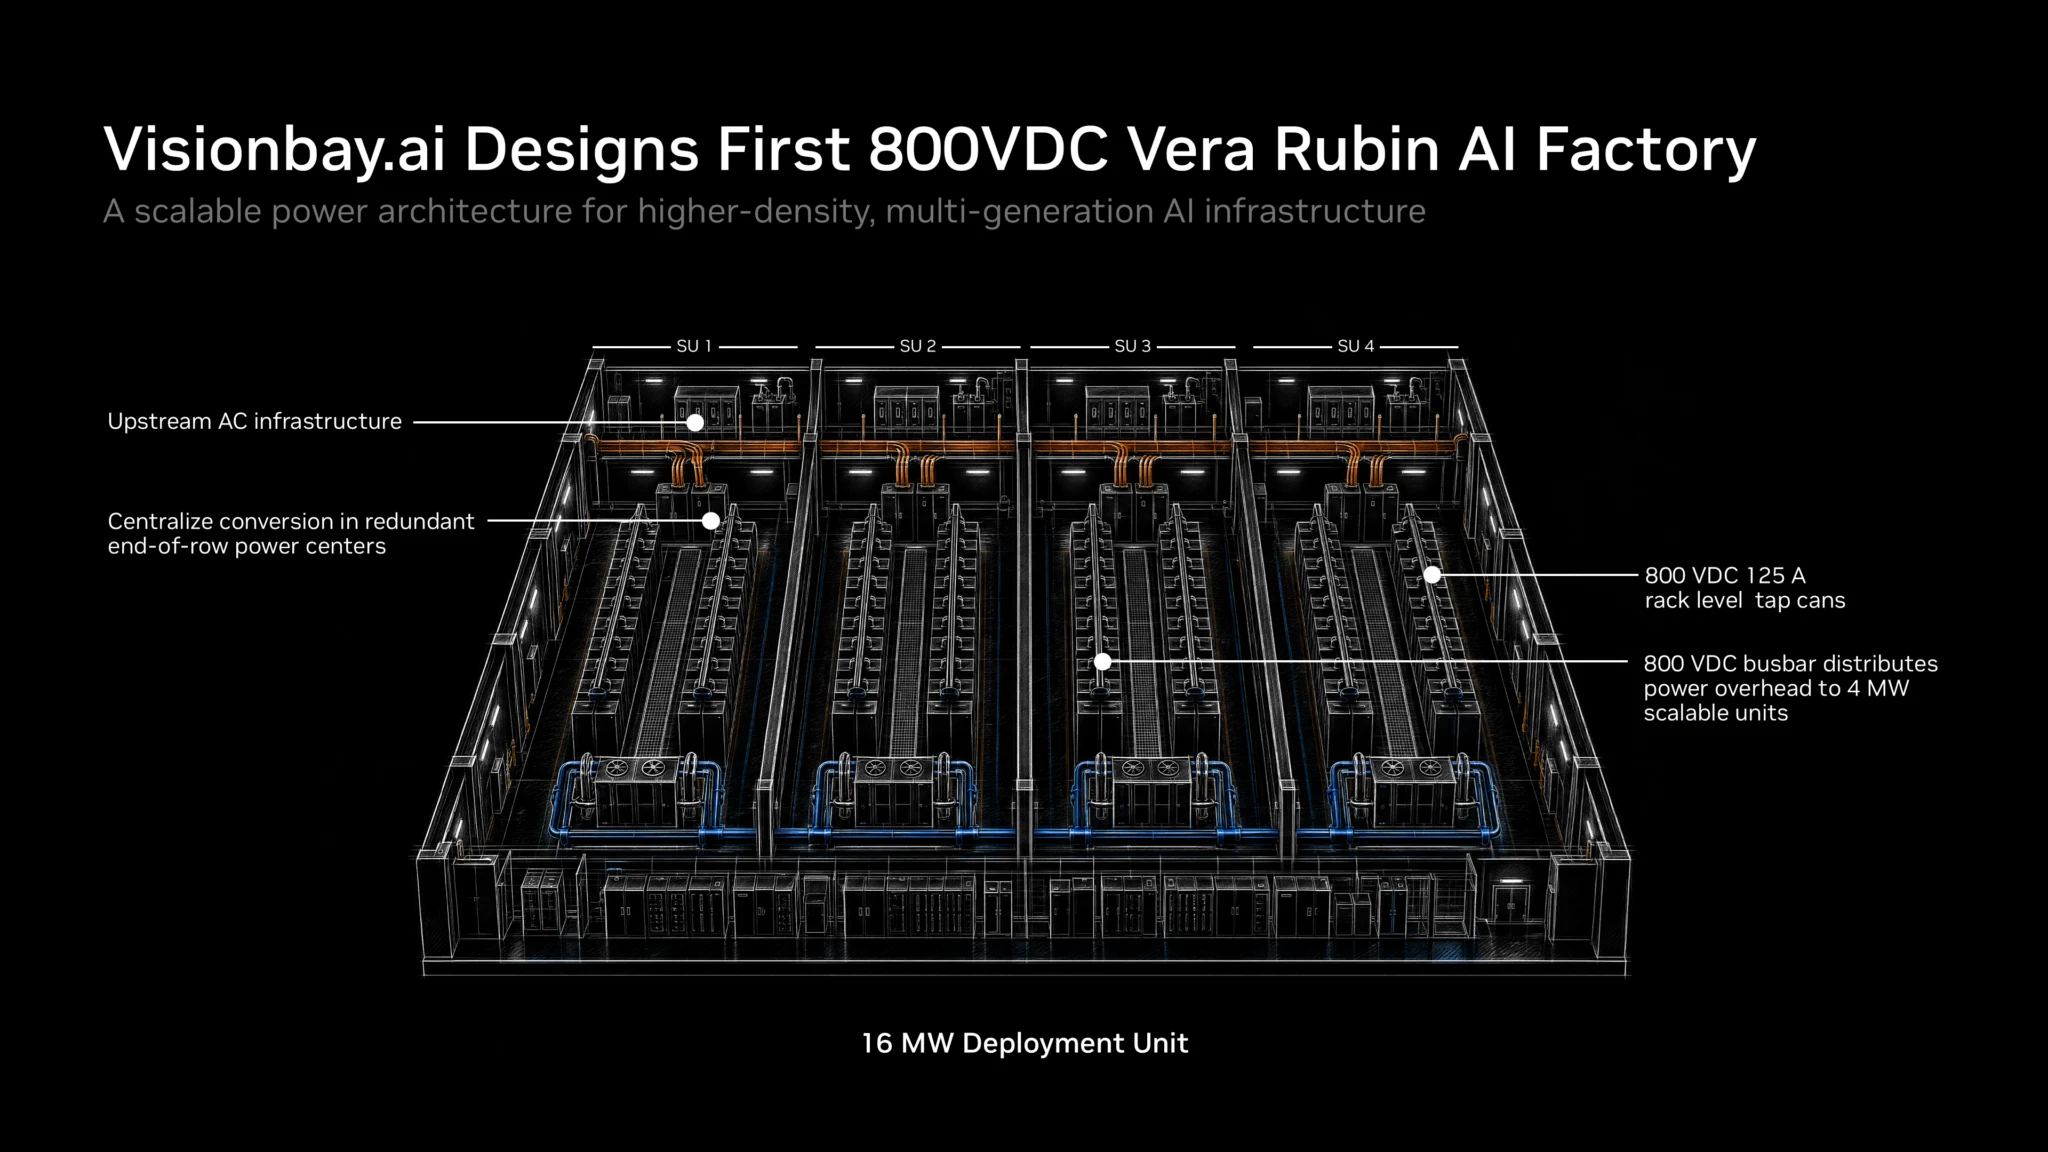
Visionbay.ai, Vera Rubin 시대를 위한 800VDC AI 팩토리 설계 🔗
AI 팩토리가 더욱 커지고 강력해짐에 따라, 그 모든 것에 하나의 과제가 드리워집니다. 바로 차세대 AI를 구동하는 가속 컴퓨팅 시스템에 충분한 전력을 공급하는 것입니다.
OCP에서 Visionbay는 K-1에 대한 계획을 공개했습니다. K-1은 다음과 같은 설계를 기반으로 한 차세대 AI 팩토리 플랫폼입니다 800 VDC 아키텍처 를 중심으로 설계되고 향후 NVIDIA Vera Rubin 배포를 염두에 두고 구축되는 차세대 AI 팩토리 플랫폼인 K-1에 대한 계획을 공개했습니다. 이 프로젝트는 NVIDIA의 800 VDC 레퍼런스 아키텍처와 Vertiv의 전력 및 열 기술을 결합하여 고밀도 AI 인프라를 위한 확장 가능한 기반을 만듭니다.
이 설계는 산업계의 커지는 과제에 대응합니다. AI 훈련, 추론 및 reasoning 워크로드가 확대됨에 따라 랙 전력 밀도가 계속 상승하고 있습니다. 기존의 저전압 전력 분배 방식은 점점 확장하기 어려워지며, 더 많은 구리, 더 많은 케이블링, 더 많은 전력 변환 장비를 필요로 합니다.
NVIDIA의 800 VDC 아키텍처를 채택함으로써 K-1은 기존 배포 환경의 유연성을 유지하면서도 더 높은 밀도의 AI 인프라로 나아가는 길을 열어줍니다. 첫날부터 전면 전환을 요구하는 것이 아니라, 이 플랫폼은 800 VDC 전력 분배가 가장 큰 이점을 제공하는 부분부터 단계적으로 도입하도록 설계되어, 대규모 시설 재설계 없이도 운영자가 차세대 가속 컴퓨팅에 대비할 수 있도록 지원합니다.
이 아키텍처는 AC-DC 변환을 중앙 집중화하고 800 VDC를 컴퓨팅 자원 인근에 분배하는 클러스터 수준의 전력 센터를 중심으로 설계되었습니다. 이 접근 방식은 다운스트림 전력 공급을 단순화하고, 모듈식 확장을 지원하며, 향후 AI 팩토리 성장을 위한 반복 가능한 빌딩 블록을 만듭니다.
K-1은 전력, 냉각, 컴퓨팅을 함께 설계하는 NVIDIA AI 팩토리의 시스템 수준 설계 철학을 반영합니다. 수랭식 인프라, 확장 가능한 전력 배전, 향후 Vera Rubin급 배치에 대한 지원을 통해 이 프로젝트는 생태계 파트너들이 NVIDIA의 AI 팩토리 아키텍처를 가속 컴퓨팅의 다음 시대를 위해 설계된 배치 가능한 인프라로 구현하는 방식을 보여줍니다.
Meta와 NVIDIA, Spectrum-6 및 멀티플레인(Multiplane) 기술로 AI 네트워킹 발전 🔗
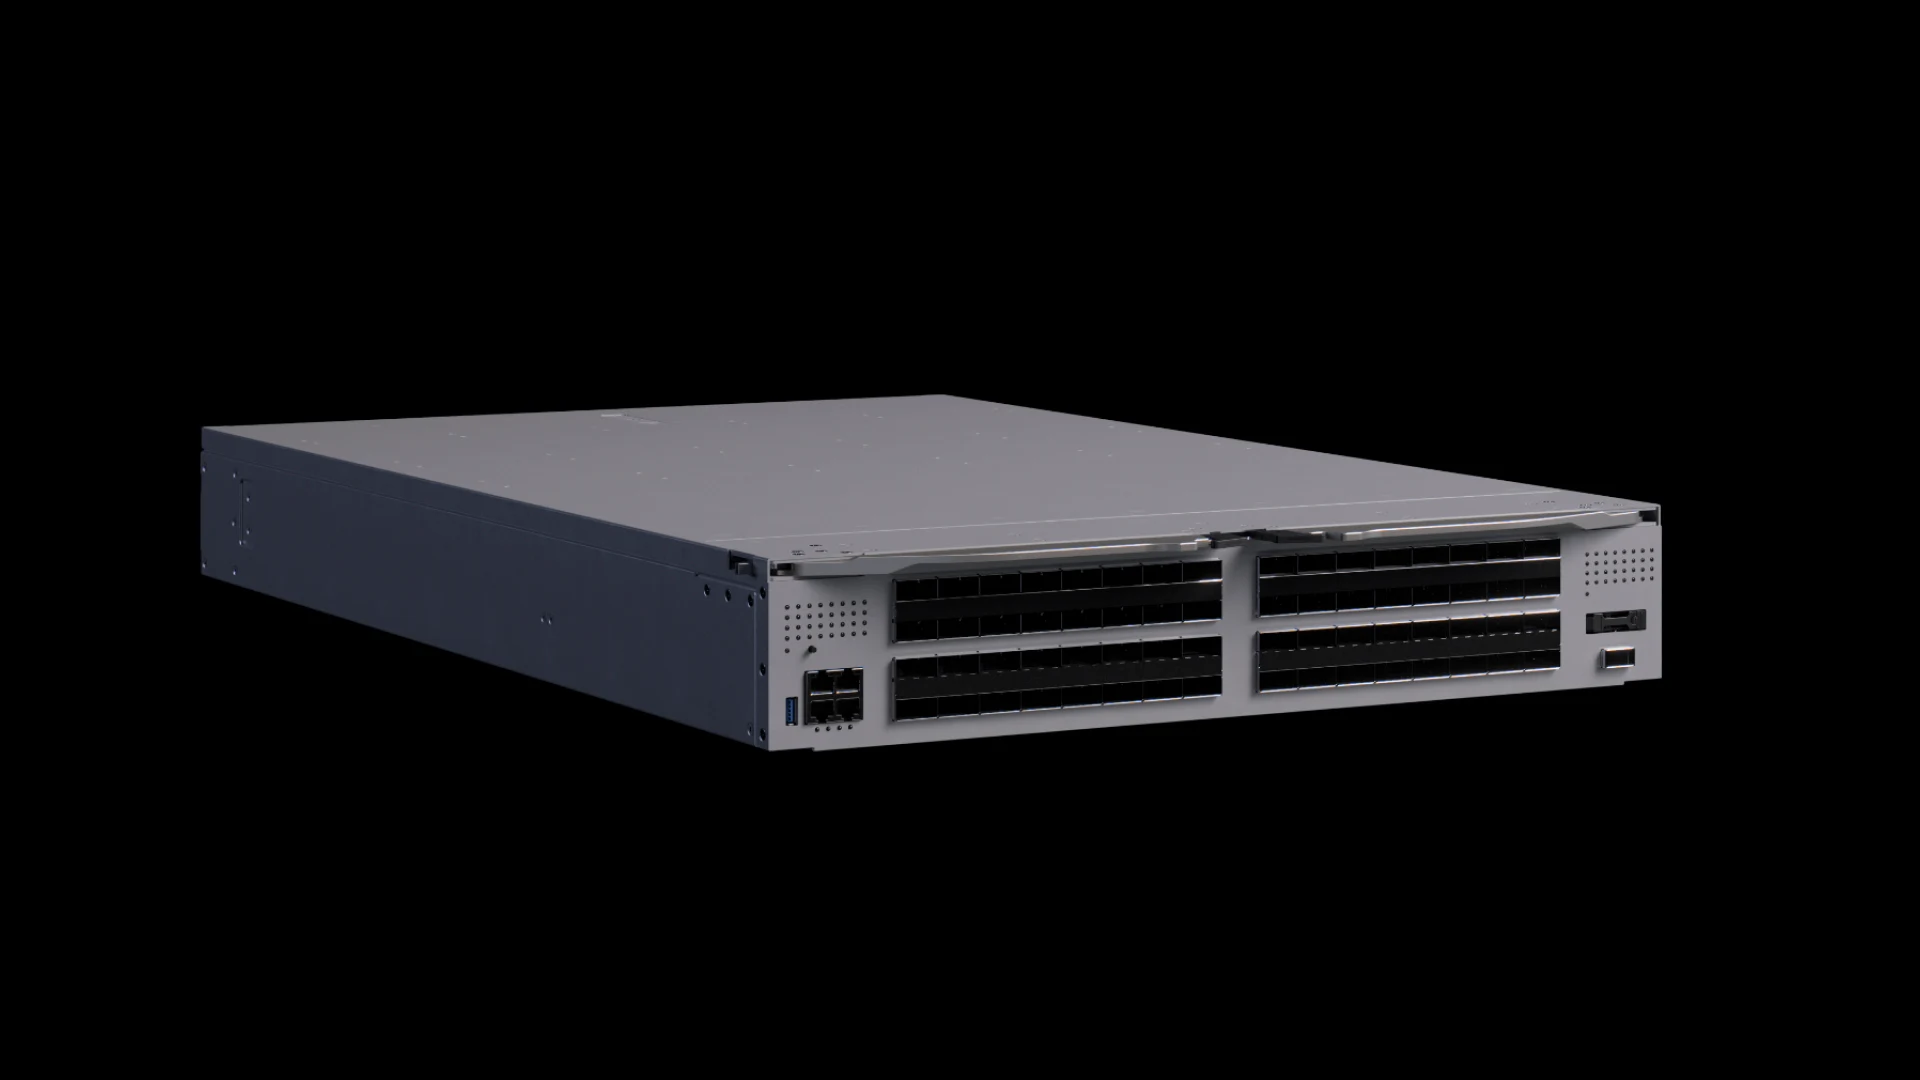
이번 행사에서 Meta와 NVIDIA는 Meta가 NVIDIA Spectrum-6 102.4Tb/s 이더넷 스위치를 도입하여 개방형 네트워킹 기반으로 더 크고 고성능인 NVIDIA Vera Rubin AI 팩토리를 구축한다고 발표했습니다.
Spectrum-6는 Spectrum-4 대비 두 배의 스위칭 용량과 레인당 대역폭을 제공하며, 레인당 200G의 무손실 이더넷 AI 패브릭을 통해 높은 유효 대역폭과 성능 격리를 제공하여 한 작업의 트래픽이 다른 작업을 느리게 만들지 않도록 합니다.
Meta의 Spectrum-6 기반 스위치인 N-IceCube는 Meta의 100T, 액체 냉식 랙인 IcePack에 장착됩니다. N-IceCube는 Facebook Open Switching System(FBOSS)을 구동하며, 이는 초대규모(hyperscale) 환경에서 효율적인 네트워킹을 지원하기 위해 OCP에 기여한 Meta의 오픈 소스 네트워크 운영 체제입니다.
FBOSS는 NVIDIA가 개발에 참여한 OCP 표준인 Switch Abstraction Interface를 기반으로 구축되어, 벤더에 종속되지 않는 방식으로 스위치 하드웨어를 제어할 수 있습니다. 이러한 기술들은 100,000개 이상의 GPU로 구성되어 대규모 모델을 학습하고 서비스하는 에이전틱 AI 팩토리를 지원합니다. mixture-of-experts(전문가 혼합) 모델입니다.
이번 발표는 Meta의 초대규모 AI 인프라 운영 경험과 NVIDIA의 네트워킹 기술을 결합한 협력의 다음 단계를 의미합니다.
이번 협업의 핵심은 Spectrum-6 스위치와 ConnectX-9 SuperNIC으로 구현되는 Spectrum-X Multiplane 기술입니다. Multiplane은 GPU 트래픽을 하드웨어에서 최대 8개의 독립적인 네트워크 플레인에 분산시켜, AI 팩토리가 더 적은 스위치 계층과 낮은 인프라 비용으로 100,000개 이상의 GPU로 확장할 수 있게 합니다. GPU 간의 다중 경로는 네트워크 활용도와 복원력을 향상시킵니다. 구성 요소에 장애가 발생하면 트래픽이 나머지 플레인으로 전환되어 대역폭이 감소하더라도 GPU가 계속 생산적으로 작동하고 AI 애플리케이션이 실행 상태를 유지합니다.
Meta와 NVIDIA는 배포 경험과 신속한 엔지니어링 반복을 통해 그 복원력을 강화하기 위해 협력했습니다. 두 팀은 온프레미스 환경과 클라우드 환경 전반에서 개선 사항을 검증했습니다.
Meta의 데이터센터 및 AI 네트워킹 수석 디렉터인 Omar Baldonado는 “자사 인프라 구축과 공동 클라우드 파트너 모두에게 필수적인 요건인 멀티플레인 패브릭을 운영적으로 확장 가능하고 고성능으로 만드는 NVIDIA와의 긴밀한 파트너십에 대해 기대가 크다”고 말했다. “FBOSS를 Spectrum ASIC으로 확장함으로써 동일한 소프트웨어 스택을 모든 패브릭에서 실행할 수 있게 되었으며, Meta의 새로운 Spectrum 기반 스위치인 N-IceCube는 이를 Icepack, 즉 우리 플릿의 다가오는 세대 가속기를 연결하는 스케일아웃용 액침 냉각 102.4T 네트워크 랙에 도입한다.”
Meta와 NVIDIA는 함께 다른 AI 인프라 운영자들이 채택할 수 있는 아키텍처와 운영 플레이북을 개발하고 있으며, 까다로운 프로덕션 워크로드에서 얻은 교훈을 더욱 확장 가능하고 탄력적이며 효율적인 AI 팩토리로 전환하고 있습니다.
USFP와 함께 NVIDIA와 Cisco가 AI 팩토리 규모를 위한 플러거블 옵틱스를 재발명하다 🔗
AI 팩토리가 더 큰 모델과 급증하는 추론 수요를 지원하며 확장됨에 따라, 인프라 스택의 모든 구성 요소는 네트워크 연결 자체에 이르기까지 더 높은 성능, 효율성, 단순성을 제공해야 합니다.
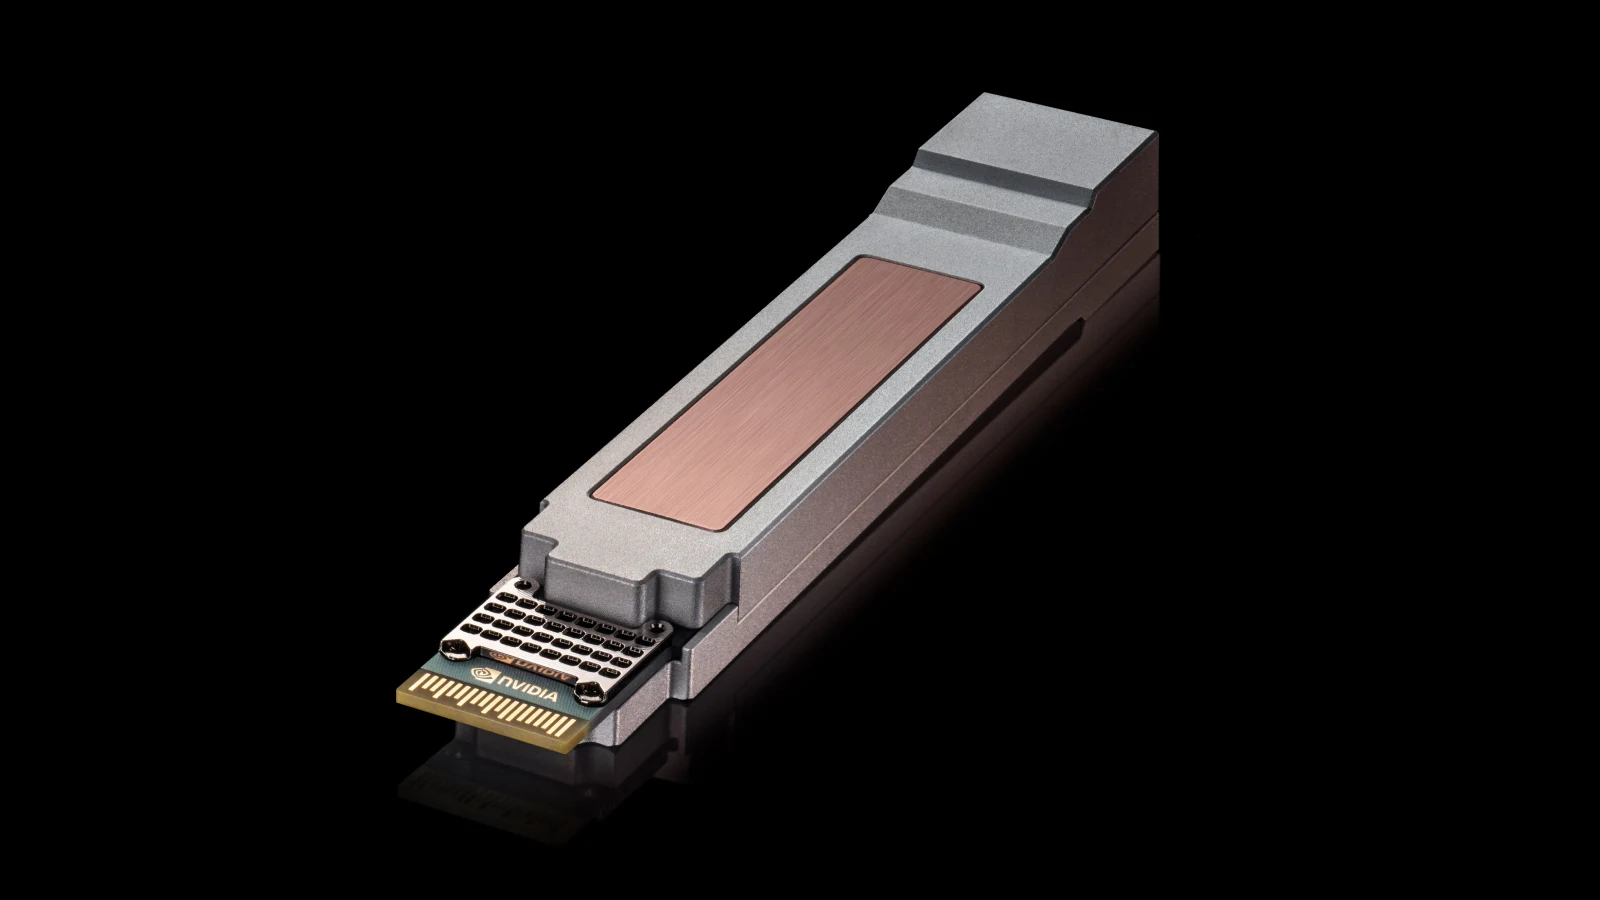
OCP에서는, NVIDIA와 Cisco가 계획을 발표했습니다 USFP는 AI 팩토리 구축업체가 차세대 AI 패브릭을 확장하면서 대역폭 밀도와 전력 효율을 개선할 수 있도록 설계된 새로운 광 플러그형 트랜시버 모듈 폼 팩터입니다.
널리 채택된 레인당 200Gb/s OSFP 폼 팩터와 거의 동일한 설치 면적을 가지는 USFP는 레인당 400Gb/s 네트워킹으로의 전환 경로를 제공하며, 여러 세대의 데이터 센터 네트워크에서 이미 입증된 트랜시버 기반 배포 모델을 확장할 것입니다. 16개의 풀 듀플렉스 레인을 수용하고 32 레인까지 확장할 계획을 갖춘 USFP는 기존 레인당 200Gb/s 플러거블 옵틱스 대비 4배의 대역폭 밀도를 제공할 것입니다.
그 결과는 지연 시간, 전력 소비 및 복잡성을 증가시킬 수 있는 네트워크 계층을 추가하지 않고도 더 많은 컴퓨팅 자원을 연결할 수 있는 능력입니다.
새로운 폼 팩터는 차세대 AI 팩토리의 규모 및 효율성 요구를 위해 설계되었으며, 플러거블 옵틱스가 현대 데이터 센터의 주축이 되게 한 유연성과 유지 보수성을 유지하면서 더 높은 대역폭의 패브릭을 지원합니다. 또한 약 1.3배 더 높은 전력 효율을 제공하여 운영자가 더 적은 에너지로 더 많은 데이터를 처리할 수 있도록 돕습니다.
개방형 생태계 조성을 지원하기 위해 NVIDIA와 Cisco는 TE Connectivity 및 Amphenol과 협력하여 케이지, 커넥터 및 모듈을 개발하고 있으며, 커뮤니티 주도의 멀티소스 노력을 통해 USFP를 발전시킬 계획입니다. 이들 기업은 함께 더욱 확장 가능하고 효율적이며 상호 운용 가능한 AI 팩토리 네트워킹의 기반을 마련하고 있습니다.
Google Falcon Transport, 상호 운용 가능한 AI 네트워킹을 위한 NVIDIA ConnectX-10 지원 🔗
NVIDIA와 Google은 향후 NVIDIA ConnectX-10 SuperNIC 및 BlueField DPU에 대한 Falcon Transport 지원도 발표하여 대규모 AI 인프라의 네트워크 효율성을 개선하는 데 도움을 줍니다.
Falcon은 이더넷 네트워크를 통해 데이터를 안정적으로 전송하도록 설계된 전송 프로토콜로, 이더넷 네트워크는 혼잡 시 패킷을 손실할 수 있습니다. Falcon은 멀티패스 로드 밸런싱, 프로그래밍 가능한 혼잡 제어, 하드웨어 손실 복구 및 연결별 보안을 통해 AI 및 스토리지 워크로드를 지원합니다.
이번 협업은 NVIDIA 하드웨어 가속과 DOCA 소프트웨어를 결합하여 Falcon을 구현하고 NVIDIA 네트워킹을 Google의 데이터 센터 전송으로 확장합니다. NVIDIA 및 Google NIC는 공통 전송을 통해 통신할 수 있으며, 애플리케이션은 표준 RDMA 프로그래밍 인터페이스를 유지합니다.
경로 전반에 트래픽을 분산하고, 혼잡에 적응하며, 손실된 패킷을 복구하고, 연결을 보호함으로써 Falcon은 워크로드가 사용 가능한 대역폭을 더 효율적으로 활용하고 이더넷 패브릭이 확장될 때 예측 가능한 성능을 유지하도록 돕습니다.
참여를 통해 자세히 알아보기 OCP에서의 NVIDIA.