
이 게시물은 Amazon Elastic Kubernetes Service(Amazon EKS)에서 멀티노드를 사용하여 하나의 대규모 언어 모델(LLM)을 두 개의 GPU 노드에 배포하는 방법을 보여줍니다. Ray LLM Deep Learning Containers. 이 시스템은 하나의 OpenAI 호환 엔드포인트 뒤에서 별도의 프리필(prefill) 노드와 디코드(decode) 노드를 사용합니다. 이러한 멀티 노드 구성은 텐서, 파이프라인, 데이터 병렬 처리는 물론 프리필/디코드 분리(disaggregation) 추론 워크로드에서도 일반적입니다. 이전 게시물, 우리는 다음을 소개했습니다: Ray Serve DLC 그리고 이를 사용해 단일 GPU 노드의 HTTP 엔드포인트 뒤에 소규모 모델을 구축했습니다. 동작하는 추론 엔드포인트를 갖게 되었고, 컨테이너는 CUDA 라이브러리를 포함해 GPU 스택과의 호환성을 유지하므로 상용구 코드를 작성할 필요가 없었습니다.
레이 분산 컴퓨팅 프레임워크이므로 Ray Serve 배포는 여러 노드에 걸쳐 있을 수 있습니다. 고객은 여러 가지 이유로 멀티 노드 Ray Serve를 사용합니다. 어떤 고객은 단일 GPU로는 너무 큰 파운데이션 모델이나 오픈 웨이트 모델을 실행하려고 합니다. 다른 고객은 하나의 레플리카가 제공할 수 있는 것보다 더 높은 처리량이 필요합니다. 또 다른 고객은 성능을 개선하기 위해 추론의 두 단계를 분리하려고 합니다. 어떤 경우든 고객은 의존성 체인을 직접 구축해야 합니다. 즉, GPU 스택에 호환되는 라이브러리를 선택하고 구성 요소 간 불일치가 발생할 때 문제를 디버깅해야 합니다. 이는 모델 제공이라는 핵심 작업에서 시간과 노력을 빼앗는, 차별화되지 않은 작업입니다.
AWS Deep Learning Containers (DLC)는 오랫동안 학습 및 추론 워크로드의 이런 종류의 문제를 해결해 왔습니다. DLC는 프레임워크, 해당 종속성 및 GPU 스택을 검증되고 패치된 조합으로 묶어 즉시 가져다 사용할 수 있는, 사전 구축되고 성능이 최적화된 Docker 이미지입니다. 다음의 출시와 함께 Ray LLM DLC 멀티노드 배포를 위해 이제 동일한 접근 방식이 멀티노드 추론으로 확장됩니다. HTTP 엔드포인트 뒤에서 모델을 서빙하도록 특별히 설계된 컨테이너를, AWS가 유지 관리하고 테스트하며 전체 추론 스택이 이미 갖춰진 상태로 이용할 수 있습니다.
이 포스트에서는 multi-node Ray LLM DLC를 사용하여 멀티노드 분산(disaggregated) 추론을 구현하는 방법을 살펴봅니다. GPU가 장착된 두 개의 노드에 하나의 대규모 언어 모델을 배포하는 것을 다룹니다. Amazon EKS 단일 엔드포인트 뒤에서 협력하는 방식입니다. 한 GPU 노드가 prefill 단계를 처리하는 동안 다른 GPU 노드가 decode 단계를 처리합니다. 단계를 분리하면 연산 집약적인 긴 프롬프트가 이미 진행 중인 요청의 토큰 생성을 지연시키는 것을 방지할 수 있습니다. 이 접근 방식은 Retrieval Augmented Generation(RAG), 문서 요약, 에이전트 애플리케이션과 같은 워크로드에 적합합니다. 여기서는 multi-node Ray LLM DLC를 사용하며, 이 DLC에는 Ray Serve LLM, NVIDIA Inference Transfer Library (NIXL), 그리고 Elastic Fabric Adapter (EFA) 스택에 배포하고 애플리케이션 코드 없이 OpenAI 호환 API를 노출합니다. 전체 코드는 다음에서 확인할 수 있습니다. 함께 제공되는 저장소.
왜 프리필/디코드(prefill/decode, PD) 분리(disaggregation)인가
LLM 추론은 서로 구별되는 두 단계로 이루어져 있습니다. 미리 채우기(Prefill) 입력 프롬프트 전체를 병렬로 처리하고 키-값(KV) 캐시를 구축합니다. 디코드 이후 토큰을 하나씩 생성하면서 해당 캐시를 읽고 확장합니다. Prefill은 연산량에 의해 병목이 발생하고, Decode는 메모리 대역폭에 의해 병목이 발생합니다. 두 단계가 하나의 GPU를 공유하면 동일한 자원을 두고 경쟁하게 되며, 버스트성이 있고 연산 집약적인 prefill 작업이 안정적이고 지연 시간에 민감한 decode 작업을 방해합니다. Prefill 단계를 decode 단계에서 분리하면 각 단계에 맞는 하드웨어와 서빙 특성을 선택할 수 있어 대규모 환경에서 전반적인 성능을 향상시킬 수 있습니다.
PD 분리는 두 단계를 별도의 노드에 배치하므로, 각 단계가 서로 간섭 없이 실행되며 독립적으로 확장할 수 있습니다. 단점은 프리필(prefill) 동안 구축된 KV 캐시를 디코드 노드에 전달해야 하며, 그 전송이 그 이점을 지워버리지 않을 만큼 충분히 빨라야 한다는 것입니다. 바로 그렇기 때문에 노드 간 상호연결(interconnect)이 중요합니다.
Ray LLM DLC가 제공하는 기능
AWS DLC는 프레임워크와 그 종속성, GPU 스택을 검증되고 패치된 하나의 조합으로 묶어 즉시 가져와 사용할 수 있는 사전 구축된 성능 최적화 Docker 이미지입니다. 모든 구성 요소는 각 릴리스 전에 함께 검증되므로 CUDA 런타임, 프레임워크, 서빙 계층 간에 버전 불일치가 발생하지 않습니다. 보안 패치는 빌드 시점에 적용됩니다.
이 Ray LLM DLC 이를 분산 LLM 서빙으로 확장합니다. 이 시스템은 vLLM 추론 엔진으로, Ray Serve의 HTTP를 서빙 계층으로, 노드 간 KV-캐시 전송을 위한 NIXL, 그리고 고대역폭 노드 간 통신을 위한 EFA 스택(libfabric 및 aws-ofi-nccl)을 사용합니다. Ray Serve LLM 라이브러리 에는 내장 애플리케이션 빌더가 포함되어 있어 전체 서빙 애플리케이션이 하나의 YAML 블록입니다. 핸들러 클래스도, 모델 아카이버도, 빌드할 커스텀 이미지도 없습니다. 단일 헬퍼인 build_pd_openai_app이(가) 프리필(prefill) 구성과 디코드(decode) 구성을 받아 하나의 OpenAI 호환 엔드포인트 뒤에서 두 구성 간의 KV-캐시 전송을 연결해 줍니다.
아키텍처
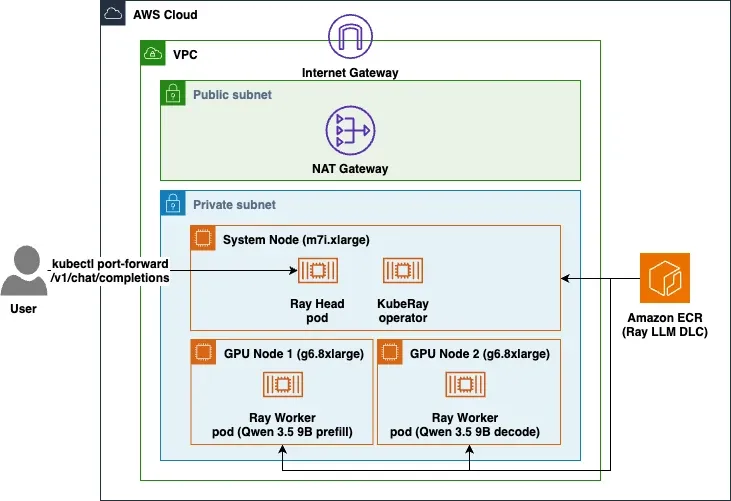
다음 다이어그램은 Amazon EKS에서 이 배포가 어떻게 구성되는지 보여줍니다. 사용자 요청은 CPU 시스템 노드의 Ray 헤드에 도달하고, 두 개의 GPU 워커 노드가 모델의 프리필 및 디코드 단계를 실행합니다.
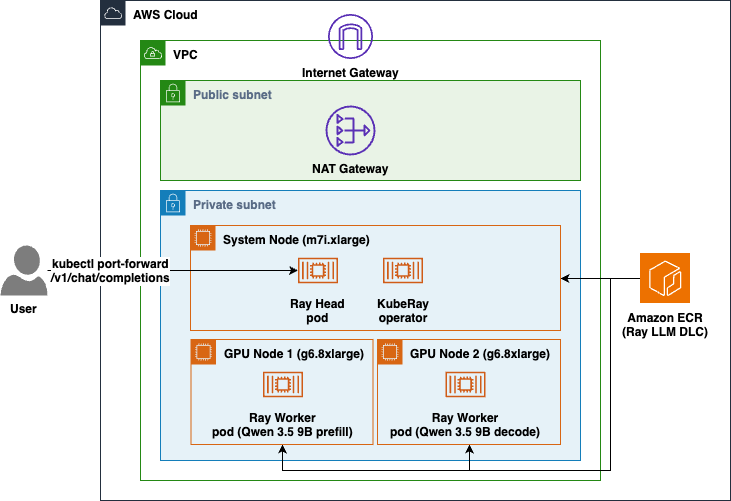
그림 1: Amazon EKS에서의 멀티노드 추론 아키텍처. CPU 시스템 노드의 Ray 헤드와 두 개의 GPU 워커 노드에서 실행되는 프리필 및 디코드 단계
이 배포는 가상 프라이빗 클라우드(VPC) 내부의 EKS 클러스터입니다. 노드는 프라이빗 서브넷에서 실행되며 NAT Gateway를 통해 아웃바운드 액세스를 수행합니다. CPU 시스템 노드 (m7i.xlarge)는 시스템 워크로드, KubeRay 오퍼레이터, 그리고 CPU 전용인 Ray 헤드 파드를 호스팅합니다. 두 개의 GPU 워커 노드 (g6.8xlarge)는 Ray 워커를 실행합니다. 하나는 프리필 단계를 서빙하고, 다른 하나는 디코드 단계를 서빙합니다. 두 노드 모두 Amazon Elastic Container Registry (Amazon ECR).
KubeRay는 사용자가 적용한 RayService를 감시하고 헤드와 워커 간의 조인을 자동으로 연결해 줍니다. Ray Serve는 prefill 배포와 decode 배포를 두 개의 GPU 워커에 배치합니다. KV 캐시는 NIXL을 통해 prefill 워커에서 decode 워커로 전달되며, NIXL의 libfabric 백엔드를 통해 EFA를 사용합니다. EFA는 가용 영역(AZ)을 넘을 수 없기 때문에 GPU 노드 그룹은 단일 가용 영역(AZ)에 고정됩니다.
KubeRay는 적용한 RayService를 감시하고 헤드-워커 조인을 자동으로 연결합니다. Ray Serve는 프리필 및 디코드 배포를 두 GPU 워커에 배치합니다. KV 캐시는 NIXL을 통해 프리필 워커에서 디코드 워커로 흐르며, NIXL의 libfabric 백엔드를 통해 EFA를 사용합니다. EFA는 AZ를 넘어갈 수 없기 때문에 GPU 노드 그룹은 단일 가용 영역(AZ)에 고정됩니다.
사전 조건
- 이 게시물을 따라 하려면 다음이 필요합니다:
- 대상 리전에서 두 개의 g6.8xlarge 인스턴스(최소 64 vCPU)를 실행하기에 충분한 서비스 할당량.
- 대상 리전에서 두 개의 g6.8xlarge 인스턴스(최소 64 vCPU)를 실행하기에 충분한 서비스 할당량. 자격 증명이 구성된 AWS 명령줄 인터페이스(AWS CLI)
- 쿠버네티스 클러스터의 컨트롤 플레인과 통신하기 위한 kubectl CLI.
- EKS에서 클러스터를 생성하고 관리하기 위한 eksctl CLI.
- KubeRay operator를 설치하기 위한 helm(쿠버네티스 패키지 매니저).
- 매니페스트를 렌더링하기 위한 envsubst 유틸리티(GNU gettext의 일부).
다음 명령어로 AWS 자격 증명이 활성 상태인지 확인합니다:
aws sts get-caller-identity사전 빌드된 애플리케이션을 사용하여 추론을 서빙합니다
이 애플리케이션은 serveConfigV2 에 있는 manifest/rayservice.yaml블록입니다. 이 애플리케이션은 build_pd_openai_app을 사용하며, 이는 prefill_config 와(과) decode_config 을(를) 받아 두 KV-cache 간의 전송을 연결합니다:
applications:
- name: qwen
  import_path: ray.serve.llm:build_pd_openai_app # OpenAI-compatible PD app, built in
  route_prefix: /
  args:
    prefill_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true # Skip CUDA graph capture to reduce peak GPU memory
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: prefill
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
    decode_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: decode
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
몇 가지 설정이 대부분의 중요한 역할을 합니다. max_model_len: 4096 는 GPU에서 측정된 KV cache에 맞게 컨텍스트 크기를 조정합니다. dtype: bfloat16 와 gpu_memory_utilization: 0.90 는 정밀도와 vLLM이 사용할 수 있는 VRAM의 양을 설정합니다. enforce_eager: true 은(는) CUDA 그래프 캡처를 건너뛰어 최대 GPU 메모리를 줄입니다(모델 및 입력에 따라 다름). kv_transfer_config 설정이 디스어그리게이션(disaggregation)이 작동하게 만드는 핵심입니다. 두 단계 모두 NixlConnector 와(과) kv_role: kv_both 를 사용하며 서로 다른 engine_id 를 가집니다(하나는 prefill, 다른 하나는 decode). 가장 중요한 설정은 kv_connector_extra_config: { backends: ["LIBFABRIC"] }입니다. 이 줄이 없으면 NIXL은 UCX를 기본으로 사용하며, EFA에서도 TCP 속도로 동작하게 됩니다.
매니페스트의 나머지 부분은 rayClusterConfig에서 pod들을 설명합니다. 헤드 pod는 CPU 전용(num-gpus: "0")이며 시스템 노드 그룹에 고정됩니다. 각 워커 pod는 GPU 한 개와 EFA 인터페이스 한 개(nvidia.com/gpu: "1", vpc.amazonaws.com/efa: "1")를 요청하며, nodeSelector: { role: gpu-worker }을(를) 통해 GPU 노드를 대상으로 합니다. NIXL이 CUDA VRAM을 EFA NIC에 등록하기 때문에 privileged: true 을(를) 실행합니다. IPC_LOCK 기능만으로는 충분하지 않습니다. 워커들은 FI_PROVIDER=efa을(를) 설정하고, pod IP에서 VLLM_HOST_IP 을(를) 읽고, 공유 메모리 볼륨을 마운트합니다. 메모리 제한은 약 18 GiB 체크포인트보다 훨씬 높게 설정되어 OS 페이지 캐시가 이를 유지할 수 있습니다. 앞서 설명한 캐시 구성으로 g6.8xlarge에서 Qwen3.5-9B 모델을 로딩할 경우, 재시작 시 모델 가중치 로딩 시간이 약 145초에서 약 2초로 단축됩니다.
Amazon EKS에 배포
모든 스크립트는 단일 구성 파일을 공유합니다. scripts/env.sh. 이 스크립트에는 다음을 위한 기본값이 포함되어 있습니다. CLUSTER_NAME, REGION, K8S_VERSION, 그리고 NAMESPACE. 기타 기본값은 시스템 및 GPU 노드 그룹, KubeRay 버전, 그리고 모델을 다룹니다. 스크립트를 실행하기 전에 변수를 export하여 기본값을 재정의할 수 있습니다.
프로젝트 루트에서 기본 디렉터리를 설정한 후 변수들을 로드합니다:
CURRENT_DIR=$(pwd)
cd $CURRENT_DIR/ray-serve-multi-node/scripts
source ./env.sh
1단계: EKS 클러스터 생성
./deploy_cluster.sh이 스크립트는 EKS 클러스터(VPC, OIDC 프로바이더, 핵심 애드온)와 시스템 워크로드, KubeRay 오퍼레이터, Ray 헤드를 실행하는 CPU 시스템 노드 그룹을 프로비저닝합니다. 노드는 NAT Gateway를 통한 이그레스가 가능한 프라이빗 서브넷에서 실행되며, 클러스터 서브넷은 해당 GPU 인스턴스 유형을 제공하는 가용 영역(AZ)에 배치됩니다. 이 스크립트는 멱등(idempotent)하며 최초 실행 시 15–20분이 소요됩니다.
2단계: GPU 워커 노드 추가
./deploy_node_group.sh다음은 GPU 노드 그룹을 생성하는 구성으로, EFA가 활성화된 g6.8xlarge 인스턴스 2개를 단일 AZ에 고정하고 레이블을 지정합니다. role=gpu-worker 따라서 Ray 워커들이 이를 대상으로 삼습니다. EFA를 활성화하면 EFA 디바이스 플러그인도 설치되는데, 이 플러그인은 다음을 알립니다 vpc.amazonaws.com/efa 각 노드에서 이 단계는 약 5-20분 정도 걸리며, 보통 첫 실행 시 더 오래 걸립니다.
3단계: KubeRay operator 설치
./install_kuberay.shK Helm을 사용해 KubeRay operator를 설치하며, GPU 노드를 추론에 사용할 수 있도록 시스템 노드 그룹에 고정합니다. KubeRay는 이후에 적용하는 RayService를 감시하고 head와 worker의 조인을 자동으로 구성합니다. 이 단계는 약 1–2분 정도 걸립니다.
4단계: RayService 배포
./deploy_ray_service.sh이렇게 하면 렌더링됩니다 manifest/rayservice.yaml 이미지, 모델, 이름 지정 변수를 envsubst로 치환하여 템플릿을 적용합니다. KubeRay는 헤드 Pod와 워커 Pod 2개를 생성하고, Ray Serve LLM은 prefill 및 decode 디플로이먼트를 띄웁니다. 스크립트는 헤드가 Ready 상태가 되고, 워커 둘 다 Running 상태가 되며, 마지막으로 Serve 앱이 RUNNING을 보고할 때까지 기다립니다. 각 노드가 모델을 로드하므로 이 단계는 몇 분 정도 걸릴 수 있습니다.
각 파드가 어떤 노드에 배치되었고 사용 가능한 GPU 용량이 얼마인지 포함하여 언제든지 상태를 확인하세요:
./deploy_ray_service.sh status모델 호출하기
Serve 앱이 정상 상태가 되면 KubeRay는 안정적인 <rayservice-name>-serve-svc 서비스. 다음과 같이 포트 포워드하십시오:
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000DLC가 OpenAI 호환 API를 노출하기 때문에, 별도의 사용자 정의 스키마 없이도 모델 목록을 조회하고 표준 chat-completion 요청을 보낼 수 있습니다.
curl --silent http://127.0.0.1:8000/v1/models
curl --fail --silent --show-error \
  --request POST "http://127.0.0.1:8000/v1/chat/completions" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.5-9b",
    "messages": [
      {"role": "user", "content": "Explain the benefits of prefill/decode disaggregation."}
    ],
    "max_tokens": 200,
    "temperature": 0.7
  }'
EFA가 사용되고 있는지 확인
NIXL은 libfabric을 사용할 수 없는 경우 TCP 속도의 전송 방식으로 대체(fallback)하며, 이때 오류를 발생시키지 않으므로 선택된 백엔드를 확인해 보는 것이 좋습니다. 워커 로그를 grep해 보세요:
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker \
  -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
    grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
deploy_node_group.sh 이미 다음을 출력합니다: vpc.amazonaws.com/efa 노드당 개수를 그룹 생성 시 사용합니다. 노드 간 대역폭 수치의 경우, DLC는 사전 빌드된 NVIDIA Collective Communications Library (NCCL) 벤치마크를 다음 위치에 제공합니다: /usr/local/bin/all_reduce_perf.
정리
지속적인 요금 부과를 피하려면 리소스를 역순으로 삭제하세요:
./delete_ray_service.sh # Remove the RayService
./install_kuberay.sh cleanup # Uninstall the KubeRay operator
./delete_node_group.sh # Remove the GPU node group
./delete_cluster.sh # Delete the EKS cluster
결론 및 다음 단계
prefill/decode 분리를 통해 두 개의 GPU 노드에 걸쳐 단일 모델을 서빙했고, 전체 애플리케이션은 YAML 블록 하나였습니다. 핸들러 코드도, 모델 아카이버도, 손으로 조립한 GPU 및 EFA 스택도 없었습니다. 멀티노드 Ray LLM DLC가 검증된 추론 스택을 제공했고, KubeRay가 Ray 클러스터를 오케스트레이션했으며, EFA 상의 NIXL이 노드 간 KV 캐시를 전송했습니다. 여러분의 역할은 이를 구축하는 것이 아니라 구성하는 것이었습니다.
다중 노드 추론을 실행하는 일반적인 패턴에는 텐서 및 파이프라인 병렬화(하나의 인스턴스에 맞지 않을 만큼 큰 모델을 샤딩하는 방식), 데이터 병렬화(처리량을 높이기 위해 모델을 복제하는 방식), 그리고 프리필/디코드 분리(disaggregation, 추론의 두 단계를 서로 다른 노드에 나누어 배치하는 방식)가 있습니다.
여기서부터는 처리량을 높이기 위해 디코딩 복제본을 확장하거나, 더 큰 GPU 인스턴스에서 텐서 또는 파이프라인 병렬성을 사용해 더 큰 모델로 이동하거나, 필요한 모델을 위해 동일한 검증된 기반 위에 추가 라이브러리를 얹을 수 있습니다. 전체 코드, 현재 이미지 태그 목록 및 내부 동작 방식에 대해서는 다음을 참조하십시오. 함께 제공되는 저장소, Ray LLM DLC 사용 가능 이미지 페이지및 Ray Serve LLM prefill/decode 문서, 그리고 EFA 문서.