

메타의 새로운 프론티어 모델 Muse Wonder Full은 인공지능 최상위권에 진입합니다
 마티아스 바스티안
의 링크드인 프로필 보기
Oct 12, 2026
 메타
주요 내용
- 메타의 두 새로운 모델, Muse Wonder와 Muse Wonder Full은 선도적인 프론티어 모델들과의 격차를 좁혔습니다.
- 가장 큰 이점은 에이전트형 코딩과 자율적인 문제 해결에 있습니다.
- 두 버전 모두 API 호출당 이전 제품인 Muse Spark 1.3보다 거의 세 배나 많은 비용이 듭니다.
메타는 두 가지 버전으로 프론티어 모델 Muse Wonder을 출시했으며, 둘 다 현재 사용 가능한 최고의 AI 모델 중 하나에 속합니다.
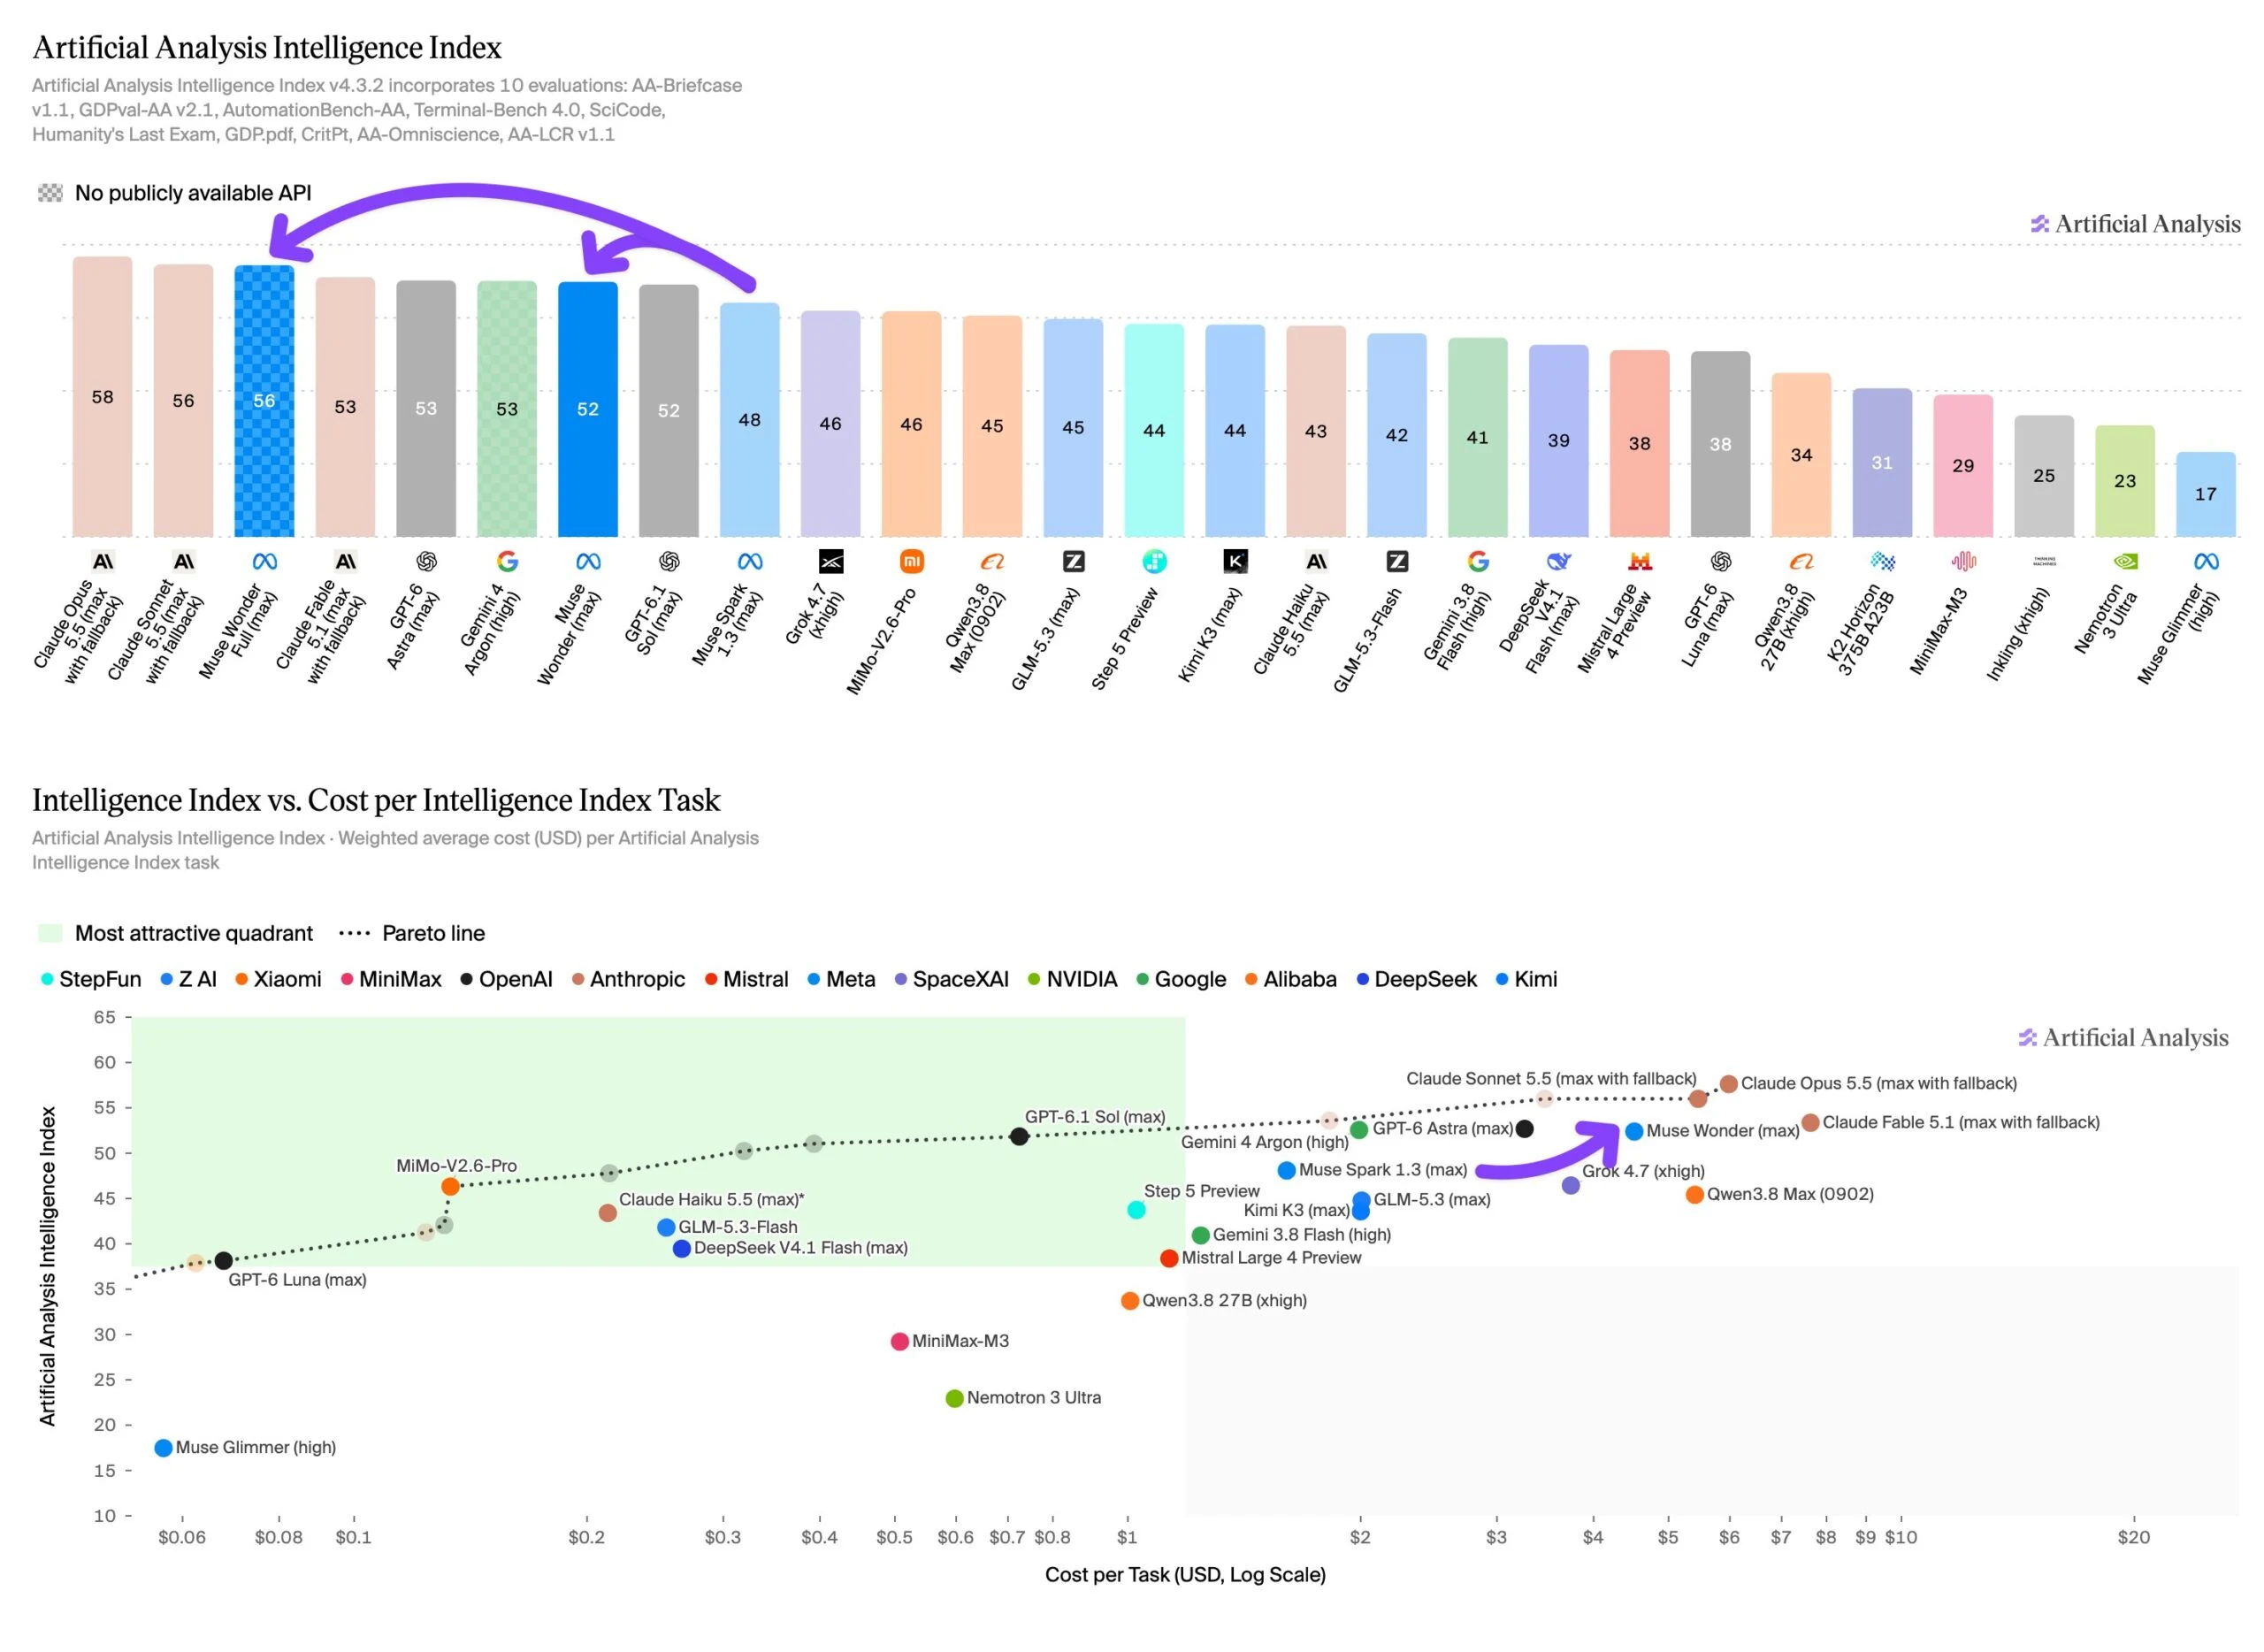
Muse Wonder Full은 인공 분석 인텔리전스 지수 v4.3에서 56점을 얻는 반면, Muse Wonder는 52점을 기록했습니다. 이전 모델인 Muse Spark 1.3는 48점을 기록했으며, 이는 중간급 모델에서 상당한 성장을 보이는 결과입니다.
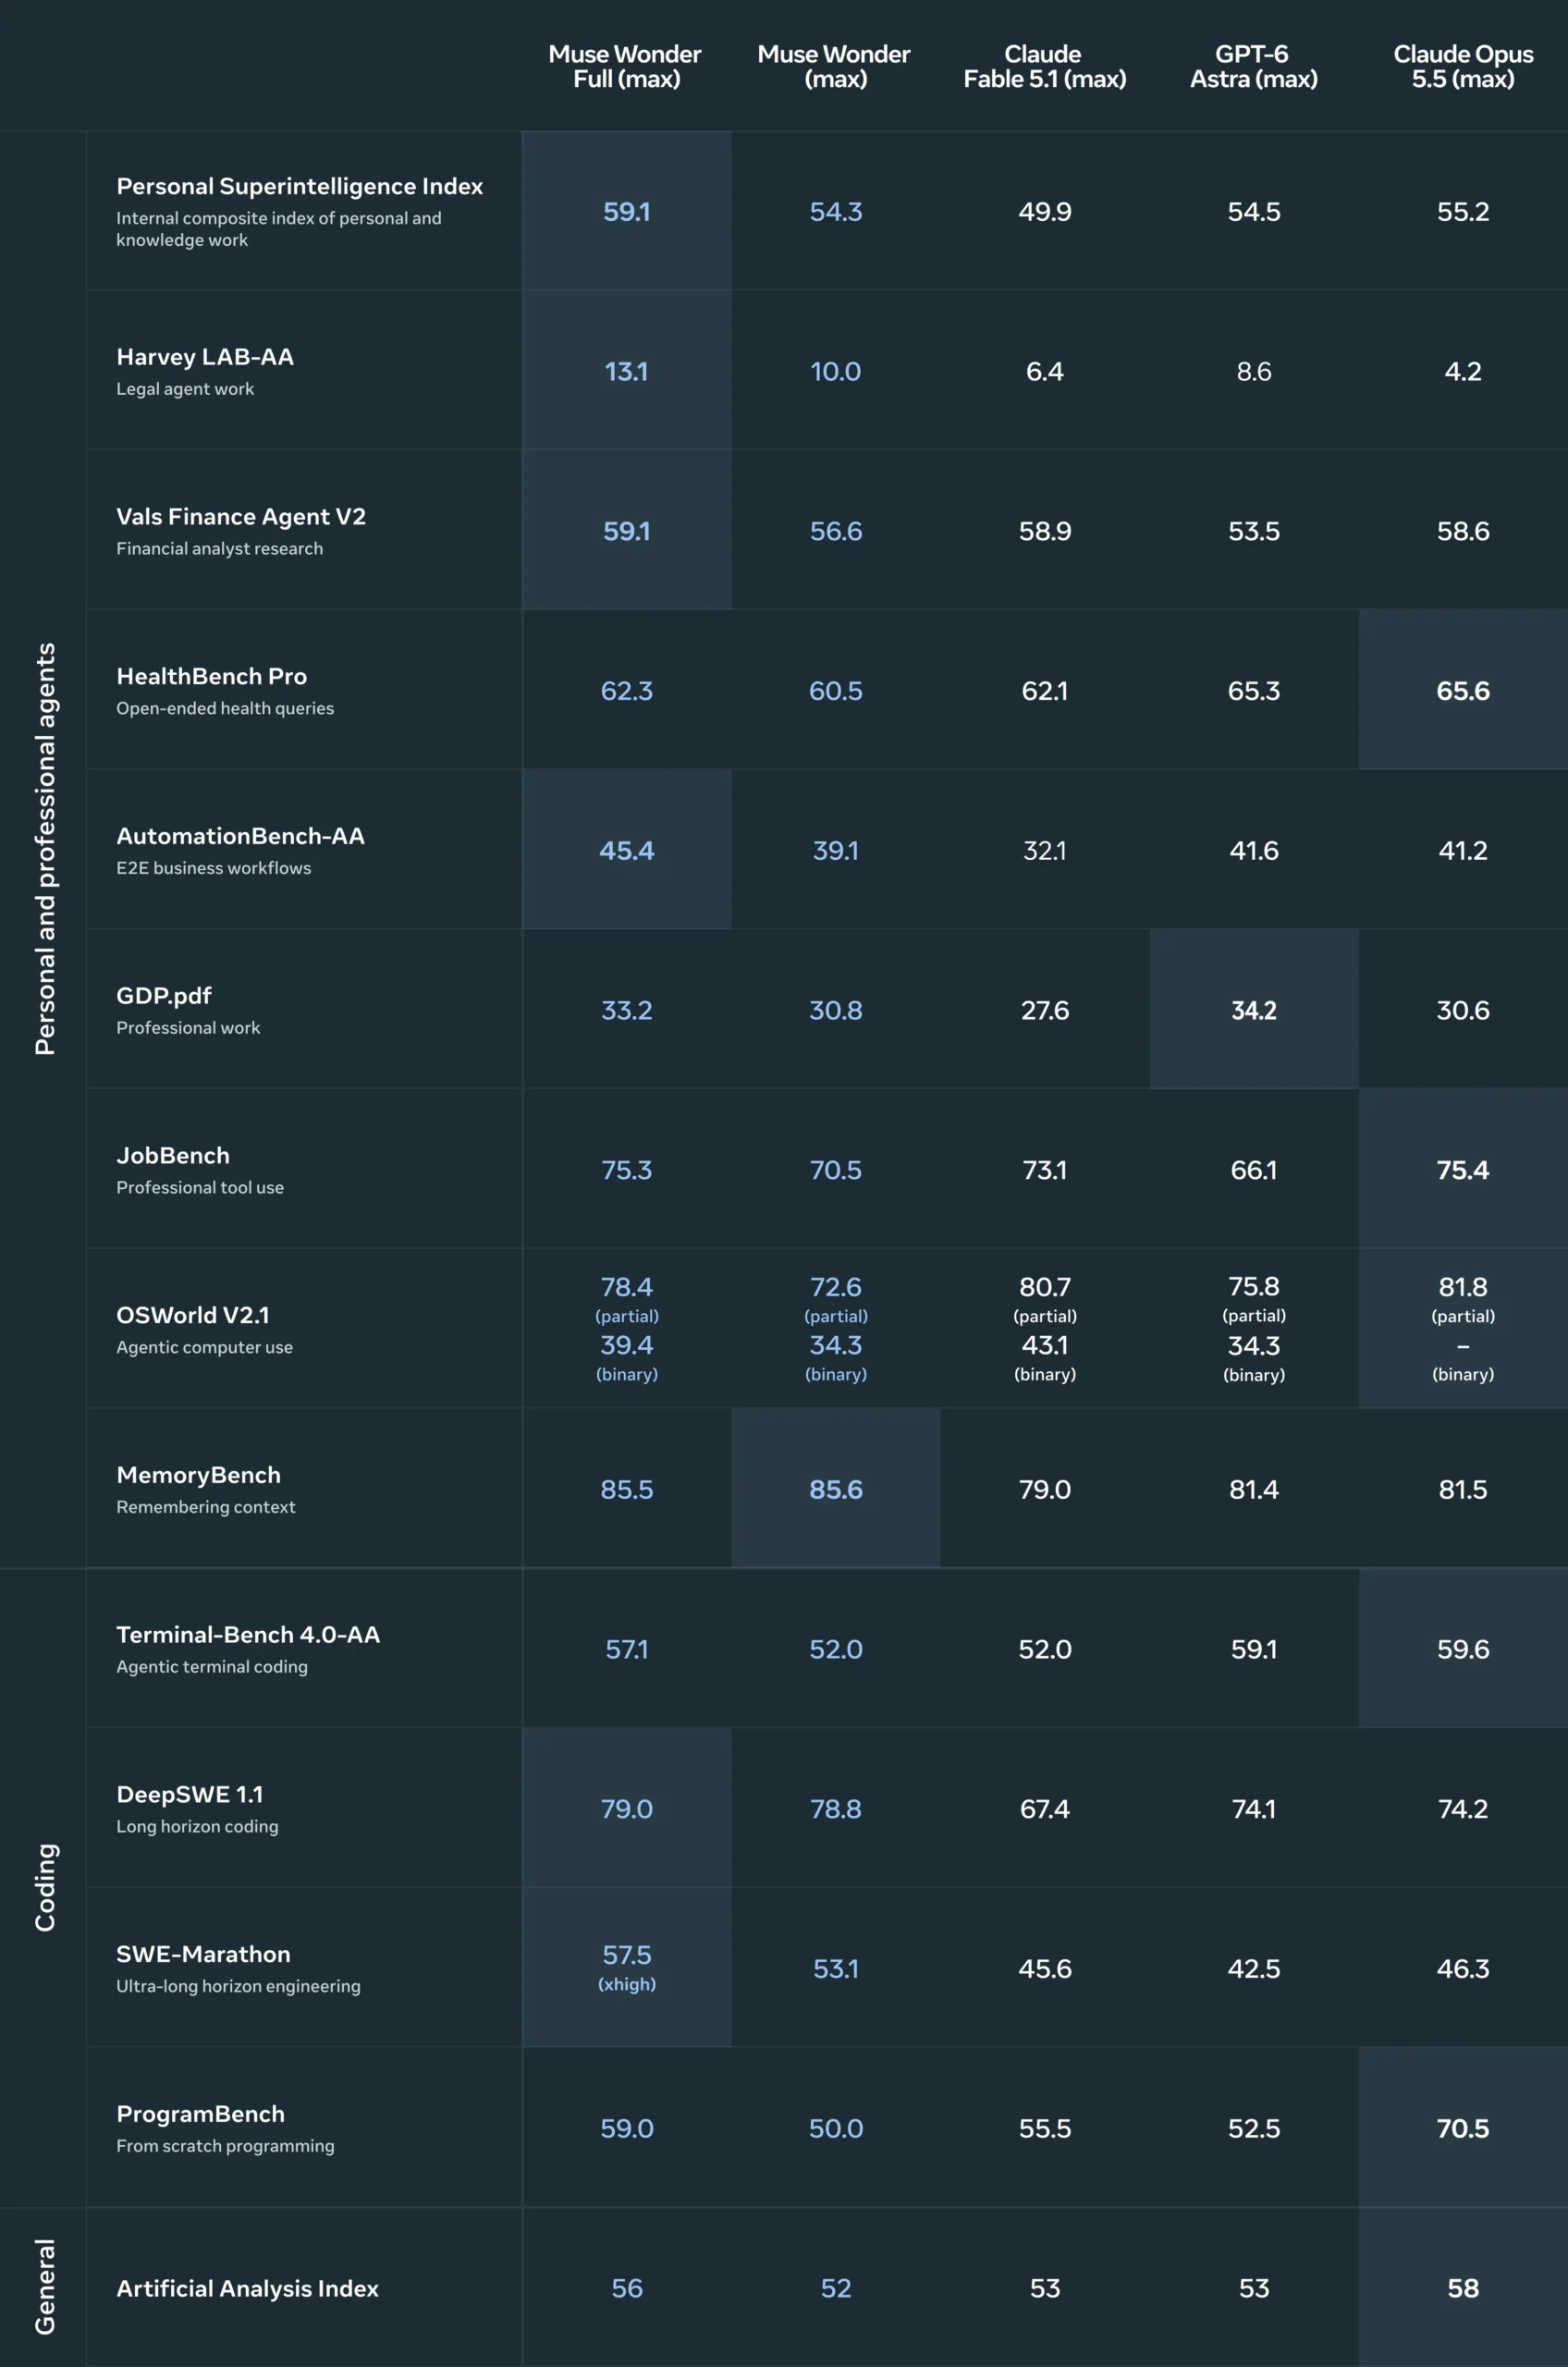
가장 큰 성과는 에이전트 기반 평가에서 나타납니다. 이는 AI 모델이 스스로 복잡한 작업을 처리하는 능력을 측정하는 테스트입니다. Terminal-Bench 4.0에서 성능은 33%에서 57%로 상승했습니다. Muse Wonder Full은 10개의 벤치마크 중 6개에서 상위 3위에 올랐으며, 이는 Meta에게 강력한 결과입니다. Meta는 오픈 Llama 모델을 통한 약한 성과 이후 회복된 것으로 보입니다.
메타는 두 가지 새로운 기능을 강조합니다. "액티브 메모리"는 모델이 대화를 통해 주요 정보를 기억하고 필요할 때 그것을 다시 불러올 수 있게 합니다. "액티브 포커스"는 모델이 어려운 작업에 집중하고, 다른 접근 방식을 시도하며, 명확하지 않은 부분에 대해 후속 질문을 할 수 있는 능력을 말합니다. 이 두 가지 기능은 캘린더, 메시지, 문서에 접근할 수 있는 개인형 AI 에이전트를 위한 메타의 주장에서 핵심적인 요소입니다.
두 모델 모두 백만 토큰의 컨텍스트 윈도우를 지원하며, 텍스트, 이미지, 비디오, 오디오 형태의 입력을 받습니다. Muse Wonder는 Meta의 API와 Muse Code를 통해 사용할 수 있지만, Muse Wonder Full은 현재 Muse Code 사용자에게만 제공됩니다. Muse Wonder는 곧 유료 구독자부터 Muse 앱도 지원할 예정입니다. 시간이 지나면 Meta는 이를 기반으로 모든 사용자들을 위한 전문 모델을 개발할 계획입니다.
코딩 점수가 급격히 상승하지만, 사실적 지식은 뒤처진다
두 모델 모두 코딩 능력에서 큰 향상을 보입니다. Muse Wonder Full은 Coding Agents Index에서 68점을 기록하여 Claude Code와 Sonnet 5.5를 동등하게 만듭니다. Muse Wonder는 이전 모델보다 54점에서 63점으로 상승했습니다.
사실적 지식은 약점으로 남아 있습니다. AA-Omniscience 지식 테스트에서 Muse Wonder Full은 30점만을 받았고, Muse Wonder는 25점을 받았습니다. 이는 Claude Opus 5.5(46점), GPT-6 Astra(43점), Gemini 4 Argon(42점)보다 훨씬 낮은 수치입니다. 이는 Wonder 시리즈가 경쟁 모델들보다 더 작은 기본 모델을 기반으로 만들어졌음을 나타냅니다. 낮은 허위 생성률이 이러한 격차를 보완하는 데 도움이 됩니다. Muse Wonder Full은 전작과 비교하여 허위 생성률을 33%에서 23%로 줄였으며, 45점 이상의 지수 점수를 받은 모든 모델 중에서는 두 번째로 낮습니다. Gemini 4 Argon(15%)만이 더 적은 수준으로 허위 생성이 발생합니다.
Meta는 자신의 블로그 글에서 Muse 모델들이 벤치마크 테스트에 맞게 조정되었지만 실제 사용에서는 부족함을 보인다는 일반적인 비판에 대응했습니다. 회사는 훈련 최적화에 포함되지 않은 익숙하지 않은 작업에서 Muse Wonder Full이 예상보다 더 잘 작동한다고 말하며, 이는 더 강력한 기반 모델 덕분이라고 밝혔습니다.
Vals AI Index에 따르면, Muse Wonder Full (Max)는 5위로 데뷔했으며 모든 OpenAI 모델을 제치고 우승했습니다. 현재의 Anthropic 모델만이 더 높은 점수를 받았습니다. Muse Wonder는 10위에 올랐습니다.
가장 큰 향상은 코딩과 수학 분야에서 나타났습니다. 수학 증명을 위한 민간 벤치마크인 ProofBench에서 Muse Wonder Full은 전체 100개 문제 중 94개를 해결했으며, 이전 모델의 58개에서 향상되었습니다. 이는 최고 모델들(99~100점)보다 단 5~6점 뒤에 위치하는 수준입니다. Terminal-Bench 4에서는 Muse Wonder Full이 출력 토큰을 30% 줄여도 점수를 두 배로 높였습니다. 금융 및 법률 작업에서의 성능은 이전 모델 수준을 유지했으며, 최대 2점 하락했습니다.
더 나은 성능을 얻으려면 큰 대가를 치러야 한다
인공 분석에 따르면, Muse Wonder는 지능 지수 기준으로 작업당 $4.52의 비용이 소요되며, 이는 Muse Spark 1.3의 $1.60보다 거의 세 배나 높은 수치입니다. 토큰 가격도 상승했는데, 입력 토큰당 $4와 출력에 대한 $20이 전임 모델의 $1.25와 $4.25에서 증가했습니다. Muse Wonder는 작업당 28% 더 많은 입력 토큰을 사용하며, 이 입력 토큰들이 총 비용의 76%를 차지합니다.
이는 Muse Wonder의 가격이 클로드 팔레 5.1($7.63)과 클로드 오퍼스 5.5($5.98)보다 높지만, GPT-6 아스트라($3.26), 제미니 4 아르곤($1.99), GPT-6.1 솔($0.72)보다 낮습니다. Muse Wonder 풀 버전의 토큰 가격은 아직 공개되지 않았습니다. 두 모델 모두 이전 모델보다 약 10% 적은 출력 토큰을 사용합니다.
메타는 자체 프로미토프스크 데이터 센터에서 기가와트 규모로 모델을 훈련했다고 밝혔습니다. 더 자세한 내용은 모델 카드에 있습니다.
하이퍼를 빼고의 AI 뉴스 – 인간이 선별한 내용
THE DECODER에 가입하여 광고 없는 읽기, 주간 AI 뉴스레터, 매년 6회 발행되는 독점적인 "AI Radar" 전선 보고서, 전체 아카이브 접근 권한, 그리고 우리의 댓글 섹션에 접근하세요.
출처: Meta | Artificial Analysis | 모델 카드