
Mixture-of-Experts(MoE)는 토큰당 연산량을 낮게 유지하면서 대규모 언어 모델(LLM)의 용량을 확장하는 희소 활성화(sparse activation) 아키텍처입니다. MoE 연산이 전체 연산 시간에서 큰 비중을 차지하기 때문에, 이 부분의 비효율성은 요청 지연 시간과 비용을 직접적으로 높입니다. 따라서 커널 엔지니어링을 통해 MoE 연산을 최적화하는 것이 성능 향상의 가장 큰 기회를 제공합니다.
퓨전 MoE(fused MoE)는 MoE 아키텍처를 위한 핵심 최적화 기법입니다. 퓨전 MoE 시스템은 토큰 라우팅, 데이터 셔플링, 전문 네트워크 연산을 GPU에서 단일 배치 연산으로 병합합니다. 이는 라우팅과 전문가(expert) 연산을 별도의 순차적 루프 연산으로 실행하는 방식을 대체합니다. 이는 지연 시간상의 이점을 제공하지만, 커널 구현과 디버깅 측면에서 복잡성을 가져옵니다. 이 아키텍처에서 높은 GPU 활용률을 달성하려면 하드웨어별 최적화가 필요합니다.
이 게시물에서는 퓨전 MoE 모델을 위해 구현한 다양한 커널 최적화 기법을 설명하고, 이 작업을 통해 얻을 수 있는 이점을 보여드립니다. 우리는 대표적인 MoE 모델을 주요 예제로 사용했습니다.
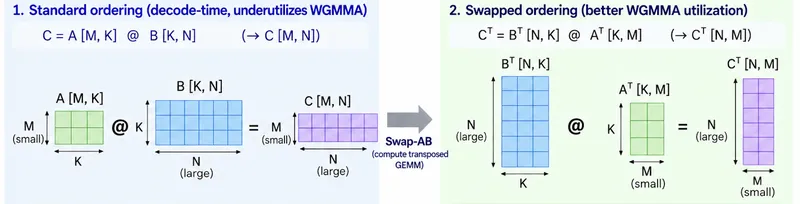
WGMMA 활용을 위한 Swap-AB
텐서 처리 처리량을 극대화하기 위해 NVIDIA Hopper 아키텍처는 128개 스레드로 구성된 협력적 warpgroup 전체에서 집단적으로 실행되는 Warp Group Matrix Multiply Accumulate(WGMMA) 명령 프로토콜에 의존합니다. 이 피연산자 비대칭성은 근본적으로 명령어 집합 아키텍처(ISA) 수준의 속성입니다. 하부 wgmma.mma_async 어셈블리 정의에서 하드웨어는 병렬 스레드 매핑 토폴로지를 정의하기 위해 행렬 행 차원(M)을 64의 고정 스케일로 고정합니다. 열 차원(N)은 매우 가변적으로 남아 있습니다. 피연산자 A는 이 고정된 M 차원에 엄격하게 매핑되고(레지스터 또는 공유 메모리 사용), 피연산자 B는 가변 N 차원에 (공유 메모리 디스크립터를 통해) 매핑됩니다. 따라서 이러한 피연산자 슬롯은 구조적으로 상호 교환이 불가능합니다. 결과적으로 최대 하드웨어 타일 활용률은 이러한 경직된 형상 인코딩에 의해 결정되며, 연산 실행 레인이 유휴 상태로 놓이는 것을 방지하려면 M 차원이 64 이상이어야 합니다.
이러한 구조적 선호는 Hopper Tensor Core가 메모리 블록을 분할하는 방식에서 비롯됩니다. 하드웨어는 첫 번째 피연산자의 선행 차원에 대해 고정된 최소 레이아웃 형상을 강제하여 블록 높이를 정확히 64(M=64)로 고정합니다. 수학적 행렬이 이 주요 슬롯에서 크고 연속적인 선행 차원을 가질 때, Hopper의 내부 하드웨어 스케줄러는 데이터를 물리적 연산 그리드 전체에 깔끔하게 매핑하고 분배할 수 있습니다.
이러한 구조적 비대칭성은 MoE 네트워크의 디코드(decode) 단계에서 심각한 성능 병목이 됩니다. 표준 MoE 레이어에서 전문가 연산을 지배하는 선형대수는 전통적인 행렬 표기법을 사용하여 다음과 같이 정식화됩니다:
A[M,K] x B[K,N] —> C[M,N]
여기서 (M)은 토큰 행 수(또는 배치 크기), (K)는 은닉 특성 차원, (N)은 방대한 전문가 출력 차원을 나타냅니다.
디코드 단계에서 시스템은 한 번에 사용자 시퀀스당 하나의 토큰만 처리합니다. 결과적으로 배치 공간 또는 토큰 행 크기가 극도로 얇아져 정기적으로 (M < 64) 프로파일로 떨어지며, 자주 단일 행(M = 1)까지 낮아집니다. 이 표준 구조 레이아웃에서:
행렬 (A)은 얇고 조각난 수평 벡터(예: 1 x 4096)로 변합니다.
행렬 (B)(핵심 전문가 가중치)는 크고 밀집된 수직 블록(예: 4096 x 8192)으로 남아 있습니다.
행 수(M)가 매우 작기 때문에 행렬 (A)는 피연산자 A를 위한 하드웨어의 고정 (64)행 레이아웃 버킷을 물리적으로 채울 수 없습니다. WGMMA 명령이 이 레이아웃에서 실행될 때, 물리적 Tensor Core 용량의 상당 부분이 완전히 굶주리게 됩니다. 실리콘이 빈 공간 슬롯을 처리하는 데 클록 사이클을 소비하여 하드웨어 활용률이 저조해집니다.
표준 밀집(dense) LLM 레이어에서는 가중치 행렬이 정적이고, 통일되며, 완벽하게 연속적입니다. 그러나 MoE 레이어에서는 워크로드가 독립적인 하위 네트워크(전문가) 집합에 걸쳐 분열됩니다. 이는 메모리 및 레이아웃 병목을 유발하여 Hopper GPU의 WGMMA 제약에 극도로 민감하게 만듭니다. 표준 밀집 레이어에서 행렬 곱셈은 토큰 벡터에 단일 레이어 가중치 행렬을 곱합니다. 출력 차원(N)은 모델의 은닉 크기(예: 4096)입니다.
퓨전 MoE 커널에서는 GPU가 하나의 전문가에 대해서만 곱셈을 수행하지 않습니다. 각 전문가마다 개별 커널을 실행하는 것을 피하기 위해 모든 활성 전문가에 대한 연산을 동시에 그룹화하고 실행합니다. 표준 밀집 레이어에서 N은 은닉 크기(4,096)입니다. 퓨전 MoE 레이어에서 N은 선택된 전문가 수 곱하기 전문가 중간 크기입니다. topk=8 루틴을 실행하는 모델의 경우, 퓨전 커널 내부의 유효 N 차원은 수만에서 수십만 개의 파라미터로 폭발적으로 커집니다. N 차원이 아주 작은 디코드 토큰 크기(M=1)에 비해 불균형적으로 크기 때문에, 레이아웃 비대칭성이 극단적으로 됩니다. 행렬을 전치하면 이 크고 결합된 MoE 차원이 주요 슬롯으로 이동하여, 표준 밀집 레이어가 따라올 수 없는 규모의 하드웨어 프리페칭을 실현합니다.
모델의 근본적인 수학적 무결성을 변경하지 않고 이러한 하드웨어 정렬 불일치를 해결하기 위해, 우리는 행렬 전치의 대수적 속성을 활용합니다:
BT[N,K] x AT[K,M] —> CT[N,M]
그림 1: WGMMA 활용을 위한 Swap-AB
프로그래밍 방식으로 행렬 곱셈을 PTX 어셈블리 계층에 도달하기 전에 전치함으로써, 우리는 소프트웨어를 Hopper 실리콘의 정확한 토폴로지에 맞게 재정렬했습니다. 이 전치는 GPU에서 두 가지 즉각적인 아키텍처상의 이점을 발생시킵니다. 첫째, 물리적 레이아웃을 포화시킵니다. 넓은 expert 차원 (N = 8192)이 첫 번째 피연산자 위치 (BT)로 승격되고, (N)이 크기 때문에 하드웨어의 필수 (64)행 임계값을 쉽게 채웁니다. 그러면 Tensor Core는 낭비되는 실행 사이클 없이 최대 로컬 밀도로 작동합니다. 둘째, 비동기 프리페치를 활성화합니다. Hopper의 전용 하드웨어 복사 엔진은 연산 실행 블록이 실행되기 전에 공유 메모리에서 레지스터로 메모리 주소를 비동기적으로 프리페치할 수 있습니다. 연속적이고 큰 가중치 블록 (BT)을 선행 슬롯에 배치하면 이러한 엔진이 데이터 레이아웃을 매끄럽게 추적하고 CPU 개입 없이도 컴퓨팅 파이프라인을 포화 상태로 유지할 수 있습니다. 이를 통해 H200에서 대규모 MoE 모델 전반에 걸쳐 2–4퍼센트의 엔드투엔드 출력 처리량이 향상되었습니다. 우리는 이 최적화를 vLLM에 업스트림했으며, 버전 0.24.0 이상에서 사용할 수 있습니다.
FP8 텐서 양자화를 위한 백엔드 라우팅
커널 내부를 넘어, 어떤 백엔드가 MoE 연산을 실행하는지의 선택은 성능에 큰 영향을 미칩니다. vLLM MoE 오라클은 서로 다른 양자화 방식을 Triton, FlashInfer+CUTLASS 또는 다른 백엔드로 라우팅합니다. 프로파일링 결과, Hopper에서 FP8 텐서 양자화 모델의 경우 Triton 백엔드가 기본 FLASHINFER_CUTLASS 경로보다 일관되게 우수한 것으로 나타났습니다.
Triton 백엔드가 낮은 동시성 MoE 워크로드에서 CUTLASS를 능가하는 주된 이유는 경직된 프레임워크 수준의 행렬 연산 구성을 사용자 정의 연산자 수준 레지스터 융합으로 대체하기 때문입니다. CUTLASS는 FP8 텐서 스케일링, 행렬 곱셈, expert 집계를 개별적인 수학 연산으로 취급하는 표준 C++ 템플릿 구조에 의존합니다. 반면 Triton 백엔드는 이 전체 파이프라인을 단일 하드웨어 패스로 통합합니다. 데이터는 전역 고대역폭 메모리(HBM)에서 정확히 한 번만 가져와져 GPU의 초고속 로컬 SRAM 레지스터와 컴퓨트 실행 파일 내에서 전부 처리됩니다. 그런 다음 최종 행렬 목적지로 다시 스트리밍됩니다. 이는 CUTLASS가 중간 텐서 스케일링 단계를 계속 거쳐야 할 때 성능을 저하시키는 느린 전역 VRAM 읽기/쓰기 왕복을 제거합니다.
또한 이 레지스터 수준 융합은 가변 토큰 버케팅을 중심으로 설계된 동적 스케줄링 레이아웃과 특별히 결합되어, 기존 컴파일 템플릿의 심각한 구조적 결함을 해결합니다. CUTLASS는 조밀하고 크며 예측 가능한 행렬 차원에 기본적으로 최적화되어 있습니다. 라이브 디코드 생성 단계에서 전형적인 유동적이고 초박형인 배치 프로파일(M < 64 또는 M = 1)을 마주하면, 기본 블록 타일링과 스레드 매핑 구조가 심각하게 비효율적이 됩니다. 그 결과 심각한 워프 미활용 또는 비용이 많이 드는 메모리 패딩 오버헤드가 발생합니다. 반대로 Triton MoE 백엔드는 이러한 작고 파편화된 토큰 배열을 활성 expert 가중치의 물리적 경계를 넘어 동적으로 매핑하는 데 탁월합니다. 이는 매우 불안정한 워크로드를 매우 낮은 배치 크기로 처리할 때에도 하드웨어의 내부 프리페치 스트림과 Tensor Core 파이프라인을 완전히 포화 상태로 유지합니다.
라우팅 정책 업데이트는 커널 코드를 전혀 수정하지 않는 순수한 구성 변경입니다. 그럼에도 불구하고 H200에서 FP8 양자화 퓨전 MoE 모델에 대해 다음과 같은 성과를 얻었습니다. 엔드투엔드 처리량 10퍼센트 향상 H200에서 FP8 양자화된 fused MoE 모델에 대해 적용됩니다. 이 향상은 AWS Large Model Inference (LMI) v28 컨테이너에서 사용할 수 있습니다.
Triton JIT 재컴파일 제거
GPU 추론에서 가장 큰 영향을 미치는 성능 병리 중 하나는 가장 눈에 띄지 않는 것이기도 합니다. 바로 불필요한 커널 재컴파일입니다. vLLM의 많은 사용자 정의 커널의 기반이 되는 컴파일러 프레임워크인 Triton은 기본적으로 정수 인자를 특수화합니다. 특수화된 파라미터에 대해 이전에 보지 못한 값으로 커널이 호출될 때마다 Triton은 새로운 JIT(just-in-time) 컴파일을 트리거합니다. 시퀀스 길이와 배치 크기가 끊임없이 변하는 서빙 워크로드에서는 이것이 지속적인 컴파일 오버헤드의 흐름을 만들어 지연 시간, 특히 첫 토큰 생성 시간(Time to First Token, TTFT)을 증가시킵니다.
MoE 모델 서빙에서 _fused_inv_rope_fp8_quant_per_head 커널(퓨전 로터리 위치 임베딩과 FP8 양자화를 담당)은 새로운 num_tokens 값이 나올 때마다 재컴파일되고 있었습니다. 가변 길이 파라미터에 do_not_specialize 어노테이션을 추가하면 이러한 재컴파일이 완전히 제거되어, 8방향 텐서 병렬화에서 H200의 TTFT가 9퍼센트 H200에서 8방향 텐서 병렬화를 사용할 때 개선되었습니다 (PR #42849).
멀티 GPU 클러스터에서는 8개 GPU 모두 완벽한 마이크로초 수준의 동기화로 커널을 실행해야 합니다. 단 하나의 GPU라도 로컬 토큰 배치 수가 변경되어 로컬 _fused_inv_rope_fp8_quant_per_head 커널을 재컴파일하기 위해 멈추면, 나머지 7개 GPU는 유휴 상태로 그것을 기다립니다. 전체 클러스터에서 재컴파일을 제거함으로써 우리는 멀티 GPU 조정 오버헤드를 없애 사용자의 초기 응답 지연 시간을 9퍼센트 단축했습니다. 여기서의 원칙은 컴파일러를 일급 최적화 대상으로 다루는 것입니다. Triton이 특수화 의미론을 어떻게 처리하는지 이해하고 파라미터가 dead인지 variable인지 인식하면 최소한의 코드 변경으로 지연 시간 개선을 실현할 수 있습니다.
우리는 이 최적화를 vLLM에 업스트림했으며, 버전 0.22.0 이상에서 사용할 수 있습니다.
결론
vLLM 커뮤니티와의 협업을 통해 융합 MoE 모델을 위한 여러 커널 최적화를 구현하고 오픈 소스로 공개했습니다. 이러한 최적화는 Amazon SageMaker AI의 LMI Deep Learning Container에 적용됩니다. 이 최적화들을 통해 최대 10% 높은 처리량과 최대 9% 빠른 TTFT를 달성했습니다. 커스텀 모델 호스팅을 시작하려면 다음을 참조하세요: Amazon SageMaker AI 호스팅 문서.