
SpaceXAI의 Grok 4.7이 이제 여러 공급자의 기반 모델(FM)을 선택할 수 있는 Amazon Bedrock에서 제공됩니다. SpaceXAI에 따르면, Grok 4.7은 더 어려운 과제를 더 오래 수행하도록 훈련되었으며 자신의 작업을 검증해야 할 때를 압니다. 이는 많은 단계를 거쳐 과제를 수행하고 진행 과정에서 발견한 내용을 검증해야 하는 에이전트에 가장 중요한 부분입니다.
이런 방식으로 작동하는 에이전트는 단순히 정보를 찾는 것 이상의 작업을 해야 합니다. 후보 답변을 만들고, 학습한 내용과 대조해 확인하며, 맞을 때까지 다듬어야 합니다. Grok 4.7은 각 응답 전에 수행되는 숙고의 정도를 제어하는 reasoning effort 설정을 노출하며, 에이전트 워크로드의 경우 어느 수준으로 실행할지가 실용적인 질문입니다.
이 게시물에서는 Grok 4.7로 도구 호출 에이전트를 구축하고, 조회가 아닌 검색이 필요한 3가지 과제에 대해 평가합니다. 과제는 경고(alarm)로부터 두 서비스의 장애를 진단하는 것, 상호 작용하는 제약 조건 하에서 유지 보수 일정을 계획하는 것, 그리고 예산 내에서 최적의 마이그레이션 집합을 선택하는 것입니다. 각 과제에는 무차별 탐색(brute force)으로 검증된 정확히 하나의 정답이 있습니다. 우리는 모든 reasoning effort 수준에서 세 과제를 각각 6회씩, 총 72회의 에이전트 실행을 수행했습니다.
에이전트는 72회 실행 중 67회를 정확히 답했습니다. xhigh 에서는 18회 모두 정확히 답했고, low 에서는 약 8분의 1의 출력 토큰을 사용하면서 18회 중 15회를 정확히 답했습니다. 이는 요청별로 조정할 수 있는 명확한 트레이드오프를 제공하며, 자신의 과제에서 이를 측정하는 방법과 프로덕션에서 모니터링하는 방법을 보여드립니다.
우리는 전체적으로 통화가 아닌 토큰 수를 보고합니다. 토큰 가격은 변하지만, 토큰 수가 바로 비용의 근원이므로 토큰으로 표현된 측정값은 유효하게 유지됩니다.
SpaceXAI가 Grok 4.7에 대해 보고하는 내용
SpaceXAI에 따르면, Grok 4.7은 Grok 4.6보다 더 큰 기반 모델을 사용하며, 더 어려운 과제 혼합에 대해 더 긴 강화 학습 실행으로 훈련되었습니다. 이 혼합은 완료하는 데 여러 시간이 걸리는 문제들에 비중을 둡니다. SpaceXAI는 이 모델이 자신의 작업 검증과 더 긴 컨텍스트 관리에 더 뛰어나다고 보고합니다.
SpaceXAI가 발표한 벤치마크 결과는 그 강조점을 따릅니다. Grok 4.6 대비 보고된 가장 큰 향상은 단일 턴 답변이 아닌 지속적인 작업을 측정하는 범주에서 나타납니다.
| 벤치마크 | 범주 | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | 수 시간에 걸친 터미널 작업 | 20.3% | 37.6% |
| EEBench | 전기 공학 | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | 법률 작업 | 15.8% | 19.6% |
| CursorBench 4.0 | 장시간 코딩 | 40.4% | 46.3% |
| HealthBench Professional | 임상 추론 | 48.5% | 56.7% |
| AA Briefcase v1.1 | 수 시간에 걸친 사무 작업 | 1,546 | 1,657 |
출처: SpaceXAI, Introducing Grok 4.7 (https://x.ai/news/grok-4-7). 점수는 모델 출시 시점에 SpaceXAI가 발표한 대로입니다.
벤치마크는 모델이 표준 작업에서 어떻게 수행되는지를 보여줍니다. 실제 사용자의 워크로드에 대해서는 사용자의 작업과 유사한 형태의 작업에서 측정하는 것이 유용한 다음 단계이며, 이 게시물의 나머지 부분에서 그 방법을 안내합니다.
SpaceXAI는 Grok 4.7에 대해 500K 토큰 컨텍스트 창을 텍스트 및 이미지 입력, 텍스트 출력과 함께 명시하고 있습니다. Amazon Bedrock에서 이 모델은 구성 가능한 추론 노력, 도구 호출, 구조화된 출력을 지원합니다.
Amazon Bedrock에서 Grok 4.7에 액세스하는 방법
Grok 4.7은 bedrock-runtime 엔드포인트에서 실행되며 크로스 리전 추론(cross-Region inference) 프로파일을 통해 액세스됩니다. 두 가지 프로파일을 사용할 수 있습니다:
| 추론 프로필 | 라우팅 | 사용 시기 |
| us.xai.grok-4.7 | 미국 내 지역에서는 | 귀하에게는 미국 데이터 레지던시 요구 사항이 있습니다 |
| global.xai.grok-4.7 | 상용 AWS 리전 | 거주지 제한이 없고 가장 폭넓은 수용 범위를 원한다면 |
교차 리전(Cross-Region) 추론은 여러 AWS 리전에 걸쳐 요청을 라우팅하므로, 리전별로 용량을 관리할 필요 없이 더 높은 처리량을 얻을 수 있습니다. 요청 시에는 모델 ID 자체 대신 추론 프로파일 중 하나를 지정합니다.
이 모델은 OpenAI 호환 Chat Completions 및 Responses API와 Amazon Bedrock Converse API를 지원합니다. Converse에서는 추론이 다음과 같이 반환됩니다. reasoningContent 옆에 있는 블록 text 블록. inferenceConfig, 설정 maxTokens 전용으로 두고, 추론 노력(reasoning effort)과 같은 모델별 매개변수는 다음에 넣으십시오. additionalModelRequestFields.
지원되는 리전, 서비스 티어 및 토큰 가격의 최신 목록은 Amazon Bedrock 사용 설명서의 Grok 4.7 모델 카드와 Amazon Bedrock 가격 페이지(를 참조하십시오.https://aws.amazon.com/bedrock/pricing/).
전제 조건
- Amazon Bedrock에 대한 액세스 권한이 있고 Grok 4.7에 대한 모델 액세스가 활성화된 AWS 계정.
- Python 3.9 이상, 그리고
openai,boto3, 그리고aws-bedrock-token-generator설치되었습니다. - 사용자 환경에 구성된 AWS 자격 증명.
귀하의 AWS Identity and Access Management(IAM) 자격 증명에는 다음이 필요합니다 bedrock:InvokeModel 추론 프로필과 계정의 기본 프로젝트 양쪽 모두에서:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7또는global.동등한.arn:aws:bedrock:{region}:{account-id}:project/default.
정책 설명에 두 리소스를 모두 포함하세요. 추론 프로파일 외에 기본 프로젝트 권한이 필요합니다.
모델에 연결
프로덕션 용도로는 기존 AWS 자격 증명에서 단기 bearer 토큰을 생성하는 것을 권장합니다. 이렇게 하면 인증이 IAM 자격 증명에 연동되고 장기 보안 비밀이 저장되지 않습니다:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
추론 토큰은 출력 토큰으로 간주되며 다음을 소진합니다 max_completion_tokens 답변 텍스트가 생성되기 전에 한도에 도달할 수 있으므로, 두 경우 모두 여유가 있도록 한도를 설정하세요. 추론 중에 한도에 도달하면 답변 텍스트 없이 응답이 반환되므로, 에이전트 코드에서 빈 내용을 확인하고 이를 발견하면 한도를 올리세요. 우리의 실행에서는 32,768 토큰의 한도를 사용했으며, 이는 모든 effort 수준에서 여유를 남겼습니다.
Grok 4.7는 네 가지 노력 수준을 지원합니다: low, medium, high및 xhigh입니다. 노력 수준은 모델 버전에 따라 달라질 수 있으므로, 목록을 코드에 하드코딩하기보다는 서비스에서 확인하는 것이 좋습니다:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
추론이 필요한 설계 과제
많은 에이전트 평가는 성실성을 테스트합니다: 기록을 읽고, 필터링하고, 합산하는 것입니다. 이러한 과제도 가치가 있지만, 추론 노력이 무엇을 기여하는지 보려면 탐색이 필요한 과제여야 합니다: 답을 데이터에서 읽어낼 수 없고, 답을 제안한 다음 검증해야 합니다.
우리는 7개의 도구를 통해 노출되는 20개의 서비스로 구성된 합성 환경을 만들고, 그 위에 세 가지 과제를 구축했습니다. 모든 과제에는 정확히 하나의 정답이 있으며, 각 과제는 간단한 휴리스틱만으로는 찾을 수 없도록 설계되었습니다.
| 과제 | 에이전트가 해야 할 일 | 추론 과제인 이유 |
| two_fault_diagnosis | 두 서비스가 03시 00분에 조용히 실패했고 다른 12개 서비스가 알림을 발생시켰습니다. 실패한 두 서비스를 식별하십시오 | 실패한 서비스는 어떤 알림도 발생시키지 않으므로, 정답은 알림을 발생시킨 서비스들 중에 없습니다. 가능한 쌍은 190가지이고, 관찰된 알림을 정확히 설명하는 쌍은 단 하나뿐입니다 |
| maintenance_schedule | 네 개의 밤에 걸쳐 여덟 개의 서비스를 밤마다 두 개씩 패치하되, 열 개의 제약 조건과 '같은 팀의 두 서비스는 같은 밤에 배정되지 않는다'는 규칙을 지켜야 합니다 | 가능한 일정은 2,520가지이고 유효한 것은 하나입니다. 팀 규칙은 에이전트가 직접 조회해야 하는 데이터에 의존합니다 |
| migration_budget | 예산 내에서 위험 감소를 최대화하는 마이그레이션 후보를 선택하되, 전이적 선행 조건까지 포함해야 합니다 | 실현 가능한 집합은 53가지이고 최적은 하나입니다. 비율이 가장 좋은 것부터 고르는 방식은 최적보다 9점 모자란 집합을 만듭니다 |
이러한 측정을 신뢰할 수 있게 유지하는 네 가지 관행이 있으며, 이는 대부분의 에이전트 평가에 적용됩니다.
채점자가 의존하는 모든 규칙을 명시하라. 프롬프트가 엣지 케이스를 열어두면 합리적인 답변도 오답으로 채점될 수 있고, 평가는 모델이 아니라 명세를 측정하게 됩니다. 예를 들어 진단 프롬프트는 실패한 서비스는 그 자체로는 알림을 발생시키지 않는다고 명시적으로 말하고 있습니다.
각 과제에 정답이 하나뿐임을 증명하라. 각 환경은 열거가 가능할 만큼 작기 때문에, 무언가를 실행하기 전에 모든 후보 답변을 확인했습니다. 일정 과제의 경우 몇 줄이면 됩니다:
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
응답 전체가 아니라 필수적인 마지막 줄을 채점하라. 각 프롬프트는 에이전트에게 다음과 같은 줄로 끝내라고 요청합니다 FINAL: auth, checkout. 채점자는 그 줄만 읽으므로, 추론을 설명하면서 다른 후보들을 논의한 응답이라도 결론을 기준으로 채점됩니다:
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
정답 여부와 형식을 따로 추적하라. 마지막 줄이 없다는 것은 마지막 줄이 틀렸다는 것과 다른 신호입니다. 우리의 실행에서 72개의 응답 모두 채점 가능한 마지막 줄을 포함했습니다.
유효한 값이 알려져 있는 경우 도구 매개변수를 enum 으로 제한하여 모든 도구 호출이 실제 리소스를 대상으로 하도록 하십시오:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
시스템 프롬프트는 의도적으로 짧게 유지되었으며, 에이전트에게 답변을 제시하기 전에 검증하라고 요청합니다:
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
에이전트 루프는 표준적인 도구 호출 루프입니다. reasoning_effort 을 설정하여 모델을 호출하고, 반환된 각 도구 호출을 실행한 뒤, 그 결과를 tool_call_id을 키로 하여 추가하고, 모델이 더 이상 도구를 요청하지 않을 때까지 반복합니다. 루프 전체에서 prompt_tokens 과 completion_tokens 을 추적하면 다음 절에서 보고하는 토큰 수가 산출됩니다.
결과
각 과제를 각 노력 수준마다 여섯 번 실행하여 총 72번 실행했습니다. 에이전트는 67번 정답을 맞혔습니다.
| Task | low | medium | high | xhigh |
| two_fault_diagnosis | 6 중 5 | 6 중 6 | 6 중 6 | 6 중 6 |
| maintenance_schedule | 6 중 5 | 6 중 5 | 6 중 5 | 6 중 6 |
| migration_budget | 6 중 5 | 6 중 6 | 6 중 6 | 6 중 6 |
| 세 가지 작업 모두 | 18 중 15 | 18 중 17 | 18 중 17 | 18 중 18 |
| 실행당 | low | medium | high | xhigh |
| 평균 출력 토큰 | 1,184 | 6,430 | 6,778 | 9,147 |
| low 대비 출력 토큰 | 1.0x | 5.4x | 5.7x | 7.7x |
| 평균 도구 호출 | 17.2 | 18.7 | 17.8 | 18.1 |
| 중앙값 경과 시간 | 18초 | 98초 | 89초 | 106초 |
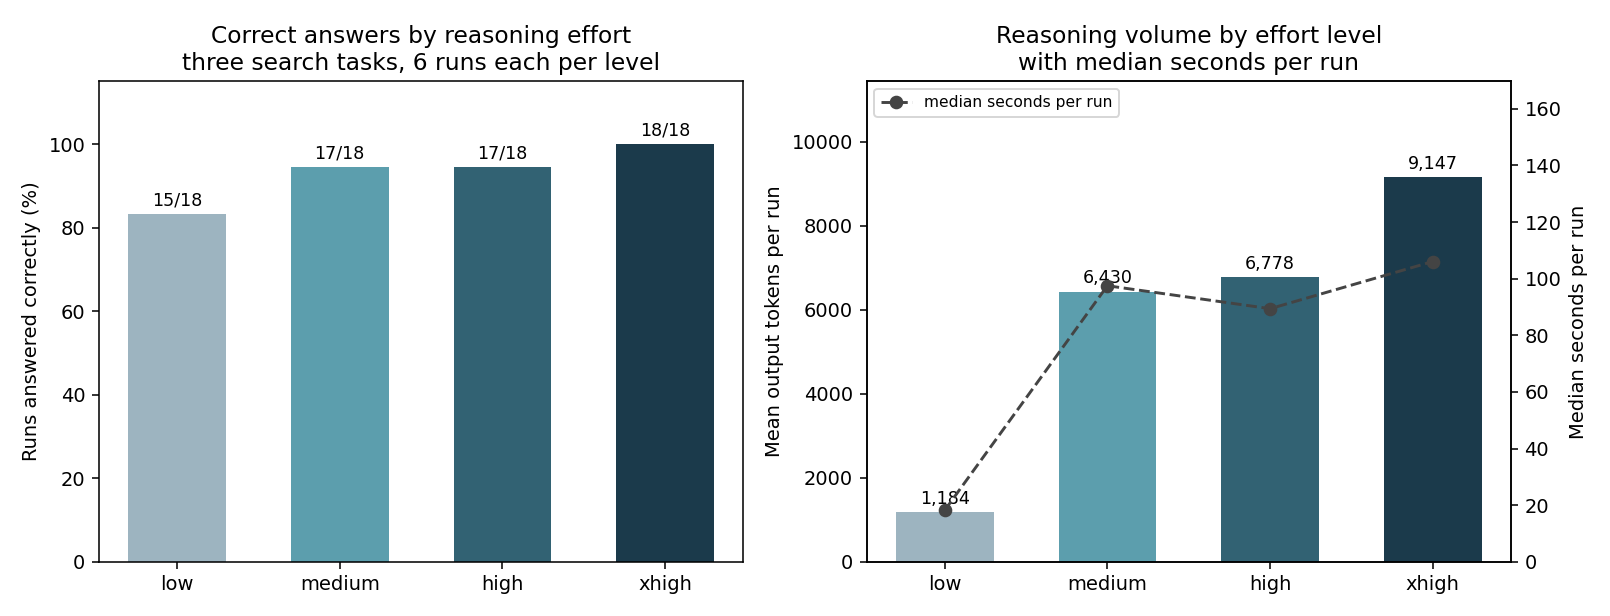
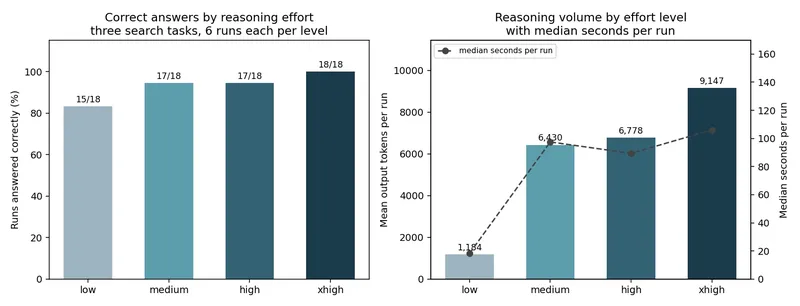
그림 1: 각 추론 노력 수준에서 정답을 맞힌 실행의 비율(왼쪽), 실행당 평균 출력 토큰과 실행당 중앙값 초가 함께 표시된 그래프(오른쪽)
세 가지 관찰.
xhigh 모든 실행을 정답으로 처리했습니다. 세 작업에 걸친 18개 실행 모두 다음에서 정답이었습니다: xhigh, 그리고 medium 그리고 high 각각 18개 중 17개를 맞혔습니다. 작업과 수준당 6회의 실행으로는 수준 간의 차이가 통계적으로 결정적이라기보다 경향을 보여주는 수준이며, 방향은 세 작업 모두에서 일관되었습니다.
노력은 에이전트가 탐색하는 양이 아니라 추론하는 양을 바꿉니다. 도구 호출은 사실상 변화가 없었으며, 모든 수준에서 실행당 17.2에서 18.7 사이를 유지했습니다. 에이전트는 노력 수준과 무관하게 동일한 사실들을 수집했고, 달라진 것은 그 사실들에 적용한 추론의 양이었으며, 출력 토큰은 1,184에서 low 에서 9,147까지 상승했습니다. 즉, xhigh.
low offers의 1,184개에서 9,147개로 증가했습니다. 에서 low, 이 에이전트는 18회 실행 중 15회를 정확히 답변했으며, xhigh에서 에이전트는 18번의 실행 중 15번을 정확히 답했으며, 출력 토큰은 약 8분의 1 수준을 사용했고 실행 중앙값은 18초였습니다. 약간 낮은 완료율이 허용되거나 답변이 후속 단계에서 검토되는 경우에는 low 이 효율적인 선택입니다. 모든 답변이 한 번에 정확해야 하는 경우에는 더 높은 수준이 더 안전한 기본값입니다.
노력 수준이 답변을 어떻게 형성하는가
과제들은 특정한 종류의 난이도를 중심으로 설계되었으며, 각 노력 수준이 이를 어떻게 처리했는지 살펴보면 추가적인 추론이 언제 가치가 있는지 명확해집니다.
최적화. 마이그레이션 과제에서는 옵션을 하나씩 순위 매기기보다 조합을 고려하는 것이 보상을 받습니다. 개별 비율이 가장 좋은 후보들을 선택하면 합리적인 답이 나오지만 최적해보다 9점 모자랍니다. At medium 그리고 그 이상의 경우, 에이전트는 18회 실행 모두에서 최적의 집합을 찾았습니다.
가설 검정. 진단 과제는 후보 쌍을 양방향으로 검사할 것을 요구합니다: 모든 알림이 설명되어야 하고, 침묵을 유지한 모든 서비스가 답과 일치해야 합니다. At medium 그리고 그 이상에서는, 에이전트가 18회 실행 모두에서 올바른 쌍을 식별했습니다.
제약 만족. 이 스케줄링 작업은 나열된 10가지 제약 조건을, 조회된 소유권 데이터에 의존하는 팀 규칙과 결합합니다. xhigh 모든 실행에서 유효한 일정을 생성했으며, 이 작업은 최고 수준이 가장 뚜렷한 차이를 만든 과제였습니다.
세 사례에서 나타나는 공통 패턴은 추가적인 추론 노력이 여러 후보 답변을 서로 비교하여 저울질해야 하는 상황에서, 단일 경로를 따라 결과에 도달하는 경우보다 가장 가치가 크다는 것입니다.
프로덕션 환경에서 추론 모니터링
프로덕션 환경에서는 채점하기 위한 정답이 주어지지 않지만, 각 실행이 사용한 출력 토큰 수와 도구 호출 횟수는 알 수 있습니다. 이것들이 유용한 운영 신호를 제공합니다.
각 수준에서 올바른 실행은 추론량의 명확한 하한선을 넘습니다. 모든 올바른 실행은 medium 이상 모델은 최소 1,739개의 출력 토큰을 사용했으며, 일반적인 실행은 수천 개를 사용했습니다. 도구 호출을 전혀 하지 않거나 해당 수준에서 정상적인 것보다 훨씬 적은 출력을 생성하는 실행은 검토할 가치가 있는 flag 대상입니다:
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
직접 채점한 실행 결과를 기준으로 작업별, 노력 수준별 베이스라인을 보정한 뒤, 채점하지 않은 실행 결과에 이를 적용하세요. 플래그는 검토하거나 재실행하라는 신호로 취급하세요. At low, 여기서는 실행 횟수가 짧으므로 출력량은 덜 유력한 신호가 되며, 따라서 표본 검사와 병행해야 합니다.
시스템 프롬프트에서 에이전트에게 자신의 답변을 검증하도록 요청하는 것은 유지할 가치가 있습니다. 실행 결과를 검토할 때 에이전트의 추론 과정을 쉽게 따라갈 수 있게 해주기 때문입니다. 정답이 존재하는 경우에는 자동 채점을 함께 사용하여, 품질이 트랜스크립트와 독립적으로 측정되도록 하세요.
추론 노력 선택
이러한 결과는 몇 가지 실용적인 규칙을 시사합니다.
일의 종류에 맞게 노력의 강도를 조절하세요. 검색, 최적화 또는 가설 검증이 포함되는 작업은 다음으로부터 가장 큰 이점을 얻습니다. medium 이상. 단일 경로를 따르는 작업이나 그 답변이 하류에서 검토되는 작업은 다음 버전에서 효율적으로 실행할 수 있습니다. low.
요청별로 노력을 설정하고, 에이전트별로 설정하지 마십시오. Effort는 요청 파라미터이므로, 에이전트는 계획 수립 및 검증 단계는 더 높은 수준에서 실행하고 도구 결과 포맷팅과 같은 기계적인 단계는 더 낮은 수준에서 실행할 수 있습니다. low. 이는 더 높은 수준의 신뢰성 대부분을 더 낮은 토큰 비용과 결합한 것입니다.
자신의 업무를 측정하되, 반복해서 측정하세요. 구성당 한 번의 실행은 단일 관측값을 제공합니다. 각 구성을 여러 번 반복하면 그 일관성이 어느 정도인지 보여줍니다.
추론 사용량을 모니터링하십시오. 실행당 출력 토큰과 도구 호출을 노력 수준별로 추적하면 결과가 사용되기 전에 실행을 검토할 수 있는 조기 신호를 얻을 수 있습니다.
이 측정 방법의 한계
작업당, 노력 수준당 6회 실행. 세 가지 작업에서 일관된 방향을 보여주기에는 충분하지만, 신뢰 구간을 제시하기에는 부족합니다. 수준 간의 차이는 참고용으로만 받아들이십시오.
합성 환경. 도구들은 코드로 생성된 데이터를 읽어오며, 이 덕분에 각 작업이 정확히 하나의 답을 가진다는 것을 증명하고 자동으로 채점할 수 있습니다. 실제 도구는 지연 시간, 부분 결과, 오류를 추가하며, 이 중 어느 것도 여기서는 테스트되지 않았습니다.
몇 시간이 아니라 몇 분. 중앙값 기준 실행 시간은 18초에서 low 106초까지 ranged 했습니다 xhigh에서 106초까지였습니다. 이것은 긴 수명 주기 작업에 대한 축소된 대리 지표입니다. 방법론은 전이되지만, 절대적인 수치는 그렇지 않습니다.
하나의 모델 버전, 하나의 리전, 작업당 하나의 프롬프트. 동일한 작업을 다르게 표현하면 결과가 달라질 수 있으며, 이것이 모든 규칙을 명시적으로 밝히는 것이 중요한 이유 중 하나입니다.
비용이 아니라 토큰 수. 금액으로 환산하려면 Amazon Bedrock 요금 페이지에서 추론 프로파일과 서비스 티어에 맞는 최신 요금을 적용하십시오. 글로벌 및 미국 지오 프로파일은 요금이 다르게 책정되며, Flex 및 Priority 서비스 티어는 배수가 적용됩니다.
에이전트 워크로드를 위한 운영 통제
재시도를 설계에 포함하십시오. 대량의 호출을 발생시키는 에이전트는 재시도를 설계의 일부로 취급해야 합니다. 요청 타임아웃을 설정하고, 재시도 가능한 오류만 재시도하며, 지터를 포함한 지수 백오프를 사용하고, 반환되는 경우 Retry-After 헤더를 존중하십시오:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
온디맨드 처리량은 시간이 지나며 확장되므로, 새로운 대량 워크로드는 전체 속도로 시작하기보다 점진적으로 늘려가십시오.
실행 감사. 모델 호출 로깅은 요청 및 응답 데이터를 Amazon Simple Storage Service(Amazon S3) 또는 Amazon CloudWatch Logs에 기록합니다. 이를 통해 나중에 검토하고자 하는 실행의 전체 기록을 확보할 수 있습니다.
대규모 추론 볼륨 모니터링. Amazon CloudWatch 지표는 토큰 사용량의 집계 보기를 제공하며, 앞서 설명한 수준별 기준선이 여기서 알람 설정 가능한 항목이 됩니다.
에이전트 간 지출 귀속. AWS Cost Explorer와 AWS Cost and Usage Report의 비용 항목화는 모델별로 사용량을 분류해 주며, 작업별 토큰 수와 결합하면 단위 경제성과 총 청구액을 모두 파악할 수 있습니다.
비용을 긴급도에 맞추기. 서비스 등급은 요청별로 설정되므로, 하나의 배포가 overnight 분석은 Flex 등급으로, 대화형 요청은 Priority로 보낼 수 있습니다. 더 높은 effort 수준에서 실행되는 워크로드의 경우 등급 선택이 비용을 조절하는 추가적인 수단이 됩니다.
라우팅 프로파일 선택. 크로스 리전 추론은 긴 실행이 사용할 수 있는 용량 풀을 넓혀줍니다. Global 프로파일은 상용 AWS 리전 중 선택한 리전에서 서비스를 제공하며, 일반적으로 지리적 라우팅보다 토큰당 가격이 낮습니다. US 프로파일은 처리를 미국 내에 유지합니다. 비용과 함께 데이터 레지던시 요구 사항에 따라 선택하십시오.
정리
이 게시물의 예제는 요청별 토큰 사용 외에 과금되는 AWS 리소스를 생성하지 않습니다. 장기 Amazon Bedrock API 키를 생성했다면, 작업을 마친 후 취소하기 전까지 유효 상태로 유지되므로 Amazon Bedrock 콘솔에서 삭제하십시오. IAM 자격 증명에서 생성된 단기 토큰은 자체적으로 만료됩니다.
테스트 중 Amazon S3로의 모델 호출 로깅을 활성화했다면, 버킷을 검토하고 더 이상 필요하지 않은 객체를 제거하십시오.
결론
SpaceXAI는 Grok 4.7을 더 어려운 작업에서 더 오래 작업하고 자신의 작업을 검증할 때를 알도록 훈련했습니다. 검색이 조회가 아닌 방식이 필요한 세 가지 작업에서 에이전트는 72회 실행 중 67회를 정확히 답변했으며, 모든 실행은 xhigh. 추론 effort는 요청별로 설정되므로, 에이전트의 각 단계가 철저함과 토큰 비용 사이의 균형에서 어디에 위치할지 선택할 수 있습니다.
자체 평가에 적용할 가치가 있는 세 가지가 있습니다. 하나의 증명 가능한 답을 가진 작업을 설계하고 채점자가 의존하는 모든 규칙을 명시하십시오. 각 구성이 얼마나 일관적인지 확인할 수 있도록 반복 실행하십시오. 그리고 effort 수준별로 출력 토큰과 도구 호출을 모니터링하여 품질 측정과 함께 운영 신호를 확보하십시오.
추가 자료
- Amazon Bedrock에서 Grok 소개
- Grok 4.7이 Amazon Bedrock에서 정식 출시
- 크로스 리전 추론으로 AWS 리전 전반에 걸쳐 모델 추론 요청 라우팅
- Amazon Bedrock 시작하기
- Chat Completions API
- Amazon Bedrock 요금
- Grok 4.7 소개 (SpaceXAI)