
보안 분석가들은 도메인 특화 쿼리 언어에 대한 깊은 지식 없이도 클라우드 인프라에 대한 빠른 답변을 필요로 합니다. Orca Security의 도구는 900개 이상의 클라우드 모델(Sonar가 추적하는 리소스 유형, 예: Amazon Elastic Compute Cloud(Amazon EC2) 인스턴스 또는 Amazon Simple Storage Service(Amazon S3) 버킷)을 지원합니다. 이 데이터를 쿼리하려면 정확한 모델 이름, 중첩된 관계 탐색, 그리고 18개 연산자(equals 또는 contains 같이 결과를 필터링하는 비교 함수) 중 선택이 필요했습니다.
이를 해결하기 위해 Orca Security는 AWS와 협력하여 자연어 쿼리 에이전트인 Discovery AI를 Amazon Bedrock위에 구축했습니다. Orca는 클라우드, 코드, AI를 위한 컨텍스트 인식 보안을 제공하며, Sonar는 사용자가 전체 데이터 그래프에서 검색, 필터링, 탐색을 수행하는 도메인 특화 쿼리 시스템입니다.
이 게시물에서는 자연어 질문을 Sonar 쿼리로 변환하는 Discovery AI의 아키텍처와 결과를 공유합니다. 그 결과, Orca는 초기 기준선 대비 쿼리 비용을 90퍼센트, 입력 토큰을 93퍼센트, 지연 시간을 75퍼센트 줄였습니다.
자연어와 구조화된 쿼리의 연결
Orca Security의 Sonar 쿼리 시스템은 복잡한 상호 관계를 가진 900개 이상의 클라우드 인프라 및 애플리케이션 모델을 지원합니다. 이 데이터를 쿼리하기 위해 사용자는 정확한 모델 이름을 지정하고 18개 연산자 중에서 선택하며 클라우드 공급자 전반의 부모-자식 계층을 탐색하는 JSON 객체를 생성합니다. 이를 잘 수행하려면 Sonar 스키마에 대한 깊은 이해가 필요합니다.
이 기능을 구축하기 위해 Orca 팀은 일반 텍스트로부터 유효한 Sonar 쿼리를 생성할 수 있는 자연어 인터페이스를 만들기 시작했습니다.
초기 개념 증명(proof of concept)은 전체 Sonar 스키마를 사용 가능한 가장 큰 모델의 단일 프롬프트에 로드했습니다. 여기에는 900개 이상의 모델 정의, 모든 관계 유형, 그리고 넉넉한 예제 쿼리 세트가 포함되었습니다. 출력 품질은 우수했지만(디자인 파트너와 내부 사용자가 긍정적으로 반응했습니다) 프로덕션 규모에서 세 가지 중대한 단점이 드러났습니다.
토큰 소비가 비효율적이어서 워크로드당 약 2백만 입력 토큰에 이르러 비용이 증가했습니다. 지연 시간이 높아 워크로드당 엔드투엔드 응답 시간이 약 60초였습니다. 복잡한 다중 모델 쿼리에서의 정확도가 제한적이었는데, 중첩된 관계와 다중 조건 쿼리에 추가적인 정제가 자주 필요했기 때문입니다.
Orca 팀은 개념이 작동한다는 것을 검증했습니다. 다음 과제는 이를 프로덕션에 사용할 수 있을 만큼 비용 효율적이고, 빠르며, 정확하게 만드는 것이었습니다. 이를 위해 Orca 팀은 Amazon Bedrock을 사용하여 하루 수천 건의 쿼리를 15초 응답 시간으로 처리하는 솔루션을 설계하고 배포했습니다.
솔루션 개요
Orca는 Discovery AI를 스키마 인식 쿼리 구성과 결합된 검색 증강 생성(Retrieval Augmented Generation, RAG)을 활용하는 Amazon Bedrock 기반의 하이브리드 솔루션으로 설계했습니다. 이 시스템은 다단계 파이프라인을 통해 자연어 질문을 유효한 Discovery 필터로 변환하며, 각 단계는 가장 적합한 Amazon Bedrock 모델에 매칭됩니다.
Orca가 Amazon Bedrock을 선택한 이유는 단일 API를 통해 멀티 모델 액세스를 제공하여 별도의 통합을 관리할 필요 없이 각 파이프라인 단계에 서로 다른 파운데이션 모델을 할당할 수 있기 때문입니다. Amazon Bedrock은 또한 AWS Identity and Access Management(IAM), 가상 프라이빗 클라우드(VPC) 엔드포인트, AWS CloudTrail을 통해 AWS 거버넌스 제어를 상속받아 Orca의 보안 요구 사항을 충족합니다. 모델 비종속 아키텍처 덕분에 팀은 파이프라인을 재설계하지 않고도 새로운 모델 버전이 출시되는 대로 교체할 수 있었습니다.
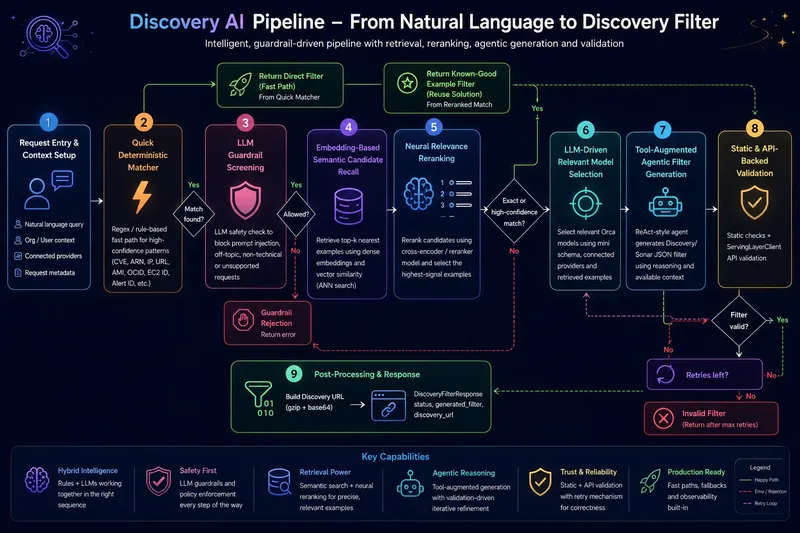
다음 다이어그램은 9단계 파이프라인 아키텍처를 보여줍니다.
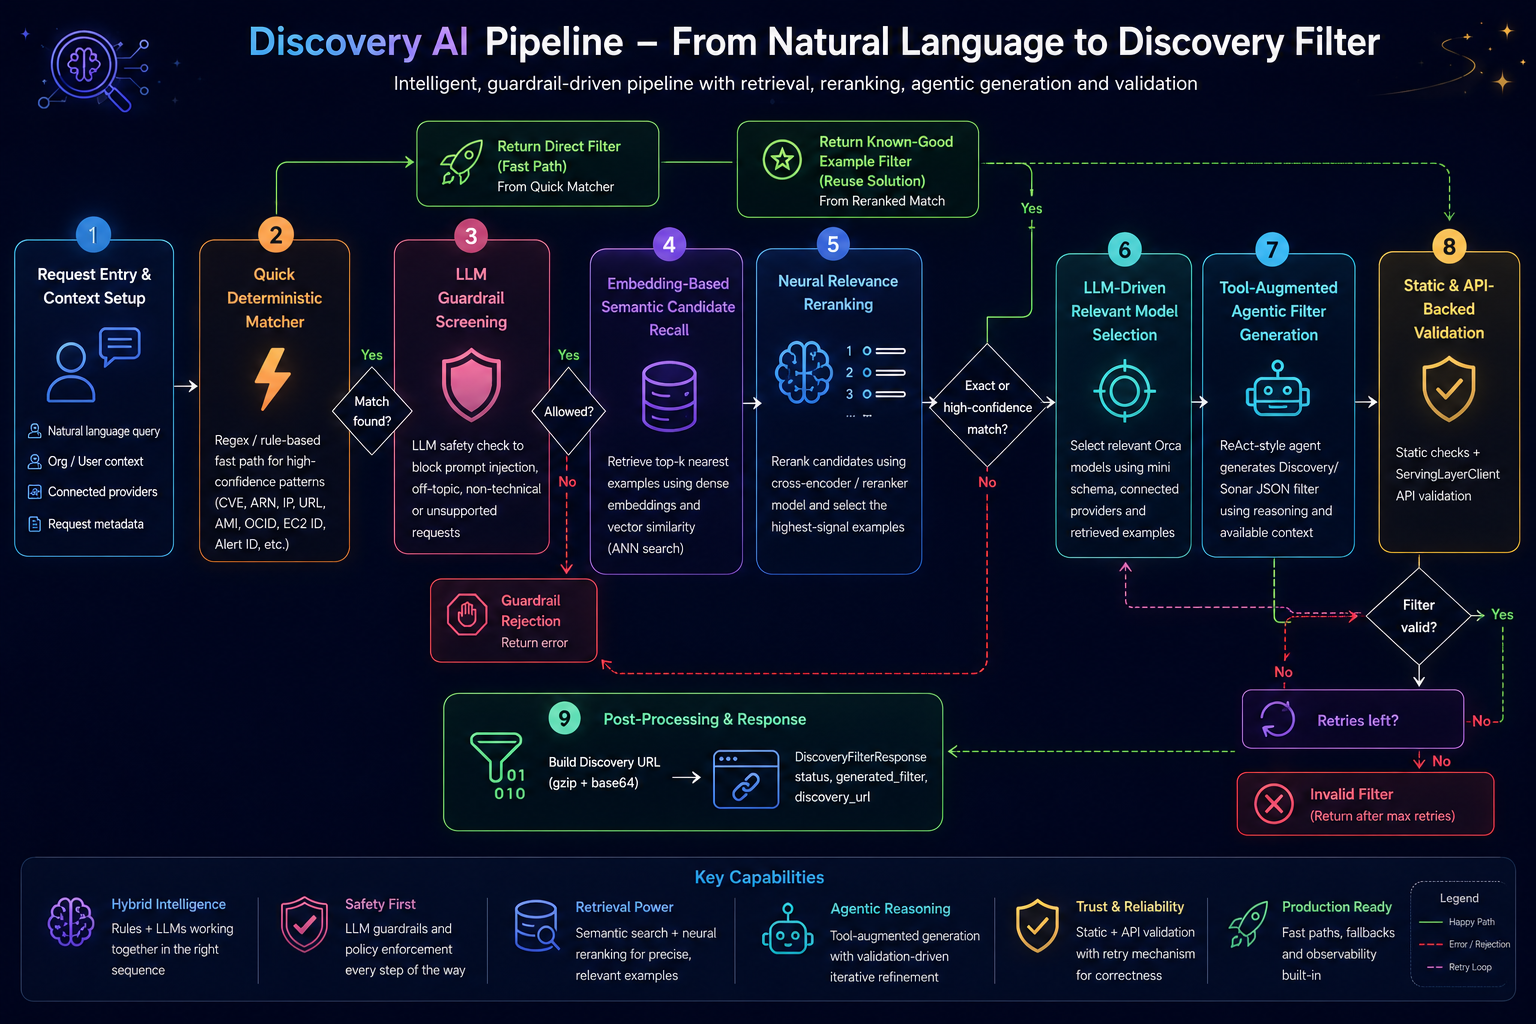
그림 1: Amazon Bedrock의 파운데이션 모델을 사용하여 자연어 입력에서 검증된 Discovery 필터 쿼리로 이어지는 흐름을 보여주는 다단계 Discovery AI 파이프라인 아키텍처
Discovery AI 파이프라인은 9단계를 통해 자연어 요청을 검증된 Discovery 필터로 변환합니다.
- 요청 진입 및 컨텍스트 설정(Request Entry and Context Setup): 파이프라인은 사용자의 자연어 요청을 사용자의 조직, 연결된 클라우드 공급자, 요청 메타데이터 등 관련 컨텍스트와 결합하는 것으로 시작합니다. 이 컨텍스트는 파이프라인이 요청을 정확하게 해석하고 고객 환경에 맞는 Discovery 필터를 생성하는 데 도움이 됩니다.
- 빠른 결정적 매처(Quick Deterministic Matcher): Quick Matcher는 IP 주소, CVE(Common Vulnerabilities and Exposures), ARN, 파일 해시, Amazon Machine Image ID, Oracle Cloud Identifier, EC2 ID, URL, 알림 ID와 같은 구조화된 입력을 식별합니다. 정규식 및 규칙 기반 매칭을 사용하여 높은 신뢰도의 패턴을 탐지합니다. 일치하는 항목이 발견되면 파이프라인은 대규모 언어 모델(LLM) 추론을 사용하지 않고 빠른 경로를 통해 사전 정의된 Discovery 필터를 반환할 수 있습니다. 일치하는 항목이 없으면 요청은 다음 단계로 진행됩니다.
- LLM 가드레일 검사(LLM Guardrail Screening): Guardrail 구성 요소는 요청이 안전하고, 관련성이 있으며, 기술적이고, 지원되는지 확인합니다. 프롬프트 인젝션 시도, 주제에서 벗어난 요청, 지원되지 않는 입력을 파이프라인의 나머지 부분에 도달하기 전에 차단합니다. 가드레일 검사에 실패한 요청은 적절한 오류와 함께 거부됩니다. 승인된 요청은 예제 검색 단계로 계속 진행됩니다.
- 임베딩 기반 시맨틱 후보 리콜: 파이프라인은 Amazon Titan Text Embeddings를 사용하여 관련성 있는 이전에 검증된 쿼리 예시를 검색합니다. 시맨틱 유사도를 기반으로 벡터 스토어에서 가장 가까운 20개의 예시를 가져옵니다. 이러한 후보들은 파이프라인에 유사한 자연어 요청이 이전에 Discovery 필터로 번역된 방식의 예시를 제공합니다.
- 신경망 기반 관련성 재순위화(Neural Relevance Reranking): 검색된 후보들은 Amazon Bedrock의 Cohere Rerank 3.5를 사용하여 재순위화됩니다. 이는 현재 요청과 가장 관련성이 높은 예시들을 식별하고 신호가 가장 강한 상위 5개 예시를 선택합니다. 정확한 일치 또는 높은 신뢰도의 일치가 발견되면, 파이프라인은 검증된 필터를 직접 재사용할 수 있습니다. 그렇지 않으면 재순위화된 예시들이 생성 단계로 전달됩니다.
- LLM 기반 관련 모델 선택(LLM-Driven Relevant Model Selection): 모델 선택(Model Selection)은 900개 이상의 Sonar 모델을 요청과 관련된 소수의 모델 집합으로 좁힙니다. 적절한 모델을 선택할 때 사용자의 요청, 연결된 공급자, 그리고 검색된 예시들을 고려합니다. 선택된 모델은 컴팩트한 마이크로 스키마부터 더 상세한 미니 스키마에 이르는 적절한 스키마 수준으로 Generator에 제공됩니다. 이를 통해 불필요한 컨텍스트를 줄이고 생성을 더 효율적으로 만듭니다.
- 도구 보강 에이전틱 필터 생성(Tool-Augmented Agentic Filter Generation): Generator는 도구로 보강된 에이전트를 사용하여 최종 Discovery 필터를 구성합니다. 이는 선택된 모델 스키마, 검색된 예시, 사용자 컨텍스트, 그리고 사용 가능한 도구들을 바탕으로 추론합니다. 에이전트는 사용자 요청의 유효한 표현에 도달할 때까지 필터를 반복적으로 다듬을 수 있습니다.
- 정적 및 API 기반 검증(Static and API-Backed Validation): 생성된 필터는 구문적 및 의미적 정확성이 검사됩니다. 파이프라인은 먼저 정적 검증을 적용한 다음 Orca의 Sonar API를 통해 필터를 확인합니다. 검증에 실패하면 검증 오류가 Generator로 반환되어 에이전트가 필터를 수정하고 다시 시도할 수 있습니다. 최대 재시도 횟수에 도달해도 유효한 필터가 생성되지 않으면 파이프라인은 invalid-filter 응답을 반환합니다. Generator는 재순위화된 예시와 선택된 스키마로 제한됩니다. 정적 검증은 모든 모델, 필드, 연산자를 해당 스키마 정의로 역추적하여 확인합니다. 각 검증 오류는 문제가 되는 요소가 식별된 상태로 에이전트에게 반환되므로, 재시도는 재추측이 아니라 재정착(re-ground)이 됩니다.
- 후처리 및 응답(Post-Processing and Response): 유효한 필터가 생성되면, Quick Matcher를 통해서든, 검증된 예시의 재사용이든, 에이전틱 생성이든, 파이프라인은 최종 응답을 준비합니다. 팀은 각 단계의 요구 사항에 따라 Amazon Bedrock에서 서로 다른 파운데이션 모델을 컴포넌트별로 배정했습니다. Anthropic Claude Haiku 4.5는 Model Selector와 Generator를 구동합니다. 이러한 컴포넌트들은 정확한 쿼리 구성을 위해 강력한 추론 능력이 필요합니다. Amazon Nova 2 Lite는 Guardrail과 Validator를 담당하며, 여기서는 낮은 비용에서의 빠른 추론이 우선시됩니다. Amazon Titan은 Example Retrieval 컴포넌트에서 의미 검색을 위한 임베딩을 제공합니다. Cohere Rerank 3.5는 검색된 후보를 재순위화하여 관련성을 극대화합니다. AWS 리전별 모델 가용성에 대해서는 모델별 리전별 가용성.
예시 검색에서 관련성과 다양성 극대화
예시 검색은 파이프라인에서 가장 중요한 정확도 레버로 부각되었습니다. 좋은 예시는 스키마만 사용하는 것보다 Generator가 질문을 Sonar 쿼리로 변환하는 방법을 더 효율적으로 학습시키기 때문에, Orca 팀은 Amazon Bedrock에서 여러 검색 전략을 벤치마킹했습니다. 각 전략은 관련성, 다양성, 속도를 서로 다른 방식으로 절충했으며, 이를 직접 비교함으로써 어떤 조합이 가장 효과적인지 확인했습니다.
Amazon Titan 임베딩에 대한 순수 top-K 의미 검색은 빠르게 수행되었지만, 거의 중복되는 예시들을 반환하는 경향이 있어 Generator의 다양성이 부족해졌습니다. Maximal Marginal Relevance(MMR)는 다양성을 개선했지만, 최상위 후보가 실제로 정답일 때 관련성을 희생했습니다. 더 큰 후보 집합을 검색한 뒤 재순위화하는 방식은 더 넓은 풀을 확보하고 재순위기를 사용해 가장 관련성 높은 하위 집합을 선택했으며, 이것이 승리한 접근 방식의 방향을 제시했습니다.
최종 승자는 Amazon Titan 임베딩을 사용하는 top-20 최근접 이웃 검색이었습니다. 그런 다음 Orca는 Cohere Rerank 3.5로 이 결과들을 상위 5개로 재순위화했습니다. 이 접근 방식은 검색 시점에 커버리지와 정밀도 사이의 절충을 강요하지 않으면서도 Generator에게 작고, 다양하며, 매우 관련성 높은 예시 집합을 제공합니다.
900개 이상의 모델을 컨텍스트에 로드하기
핵심 제약 조건이 아키텍처를 형성했습니다. 모든 프롬프트에 900개 이상의 Sonar 모델 스키마를 포함하는 것은 현실적이지 않았습니다. 긴 컨텍스트 모델을 사용하더라도 그렇게 하면 비용과 정확도 모두 저하됩니다.
Model Selector가 이 문제를 해결합니다. Anthropic Claude Haiku 4.5에서 실행되는 이 컴포넌트는 각 모델의 컴팩트하고 의미가 풍부한 표현(이름, 목적, 주요 필드, 주요 관계)을 대상으로 작동합니다. 사용자의 질문이 주어지면 Generator가 실제로 필요로 하는 모델만 반환합니다. 그런 다음 Generator는 선택된 모델들과 그 모델들을 연결하는 관계에 대해서만 전체 스키마 세부 정보를 받게 됩니다.
평가 방법론
자신 있게 반복 개발하기 위해 Orca 팀은 프로젝트 초기에 지속적 평가 하네스를 구축했습니다. 이 하네스는 큐레이션된 데이터셋, 자동화된 채점 계층, 그리고 슬라이스 기반 측정 방식을 결합하여 팀이 배포 전에 모든 변경 사항을 신뢰할 수 있게 합니다. 이러한 요소들이 함께하여 평가를 사후 고려 사항이 아닌 일상적인 단계로 만듭니다.
엄선된 평가 데이터셋은 프로덕션 환경에서 관찰되는 질문 유형, 모델 계열, 복잡도 등급을 모두 포괄하므로 실제 사용 양상을 반영합니다. LLM-as-judge 채점 레이어는 생성된 쿼리를 정확성, 완전성, 참조 쿼리와의 의미적 동등성 기준으로 채점하여 팀에 일관된 품질 신호를 제공합니다. 이 측정 방법론은 이어서 변화분(delta)을 슬라이스별로 분해함으로써 팀이 성능 저하가 정확히 어디서 발생하는지, 무엇을 수정해야 하는지 파악할 수 있게 해줍니다.
프롬프트, 모델, 검색 매개변수 또는 예제에 대한 모든 변경 사항은 프로덕션에 배포되기 전에 하네스를 거칩니다.
지속적인 개선을 위한 도메인 전문가 참여형(domain-expert-in-the-loop) 라벨링 시스템
고객 환경이 변화하고 새로운 질문 패턴이 나타남에 따라 정확도를 유지하는 것은 강력한 초기 배포 이상의 노력을 필요로 했습니다. Orca 팀은 제품 관리자, 지원 엔지니어, 보안 연구원을 위한 내부 라벨링 도구를 구축했습니다. 이 도구를 통해 그들은 쿼리에 플래그를 지정하고, 출력을 수정하고, 한 번의 작업으로 수정 사항을 예시 은행에 반영할 수 있습니다. 나아가 이 시스템은 낮은 신뢰도의 매칭 예시를 가진 프로덕션 쿼리를 자동으로 수집하여 매일 라벨링 작업을 할 수 있도록 해당 도메인 전문가에게 전달합니다. 다음 파이프라인 실행 시 Cohere Rerank 3.5를 통해 새로운 예시가 검색되며, 해당 유형의 질문에 대한 정확도는 배포 없이도 그 순간 바로 향상됩니다.
“라벨링 UI는 장기적인 품질을 위해 우리가 한 투자 중 가장 중요한 것입니다. Discovery AI를 정적인 배포물에서 살아있는 시스템으로 바꾸어, 우리 도메인 전문가들이 일상 업무 흐름 안에서 지속적으로 이를 개선할 수 있습니다.”
— Or Gabay, Orca Security AI 총괄 디렉터
엔드투엔드 파이프라인 관측 가능성과 제품, 엔지니어링, 고객 대면 팀에 걸친 공유 대시보드와 결합되어, 이 피드백 루프가 초기 출시 이후 Discovery AI를 지속적으로 개선하는 원동력입니다.
결과
Discovery AI를 프로덕션에 배포한 후, 새로운 솔루션은 비용, 지연 시간, 정확도 전 영역에서 초기 베이스라인을 능가했습니다. 입력 토큰 사용량은 93퍼센트 감소하여, 유사한 작업 부하당 약 2백만 토큰에서 140,000 토큰으로 줄었습니다. 전체 비용은 90퍼센트 감소했으며, 이는 토큰 소비 감소와 Amazon Bedrock을 통한 단계별 모델 할당이 함께 작용한 결과입니다.
지연 시간도 개선되어, 엔드투엔드 응답 시간이 75퍼센트 감소해 약 60초에서 15초로 줄었습니다. 복잡한 멀티 모델 쿼리에 대한 정확도도 향상되었으며, 이는 팀의 평가 하니스를 통해 지속적으로 측정되었습니다.
Discovery AI는 2026년 3월부터 프로덕션 환경에서 하루 수천 건의 쿼리를 처리하고 있으며, 사내 전문가와 고객 피드백이 품질을 검증하고 있습니다.
결론
이 게시물에서는 Orca Security가 Amazon Bedrock을 기반으로 Discovery AI를 구축한 방법을 공유했습니다. 이 솔루션은 초기 기준선 대비 쿼리 비용을 90퍼센트, 입력 토큰 사용량을 93퍼센트, 지연 시간을 75퍼센트 줄였습니다. 이 솔루션은 여러 핵심 기술을 결합합니다. 여기에는 Cohere Rerank 3.5를 활용한 RAG 기반 예제 검색, Anthropic Claude Haiku 4.5와 Amazon Nova 2 Lite에 걸친 단계별 모델 할당, Amazon Titan으로 구동되는 시맨틱 검색이 포함됩니다. 또한 지속적인 human-in-the-loop 라벨링 시스템이 지속적인 개선을 제공합니다. 이러한 조합을 통해 Orca는 동작하는 프로토타입을 실행 비용이 더 저렴하고 정확도도 더 높은 프로덕션급 솔루션으로 전환할 수 있었습니다.
유사한 솔루션 구축을 시작하려면 다음을 살펴보세요. Amazon Bedrock 파운데이션 모델(FM) 접근을 위한, Amazon Bedrock의 Cohere Rerank 검색 최적화를 위한 것이며, Amazon Titan 임베딩용입니다. Orca Security의 클라우드 보안 도구에 대해 자세히 알아보려면 방문하십시오: orca.security.
Orca Security가 프레임워크 전반에 AI를 어떻게 적용하는지 자세히 알아보려면 다음을 참조하십시오. Orca가 AI로 보안 성과를 이끄는 방법 그리고 Orca가 Amazon Bedrock 등을 포함한 AI 도입을 어떻게 보호하는지.
이 글에서 사용된 기법에 대해 더 자세히 알아보려면 다음을 읽어보세요: 관련 게시물 위의 AWS 머신 러닝 블로그.