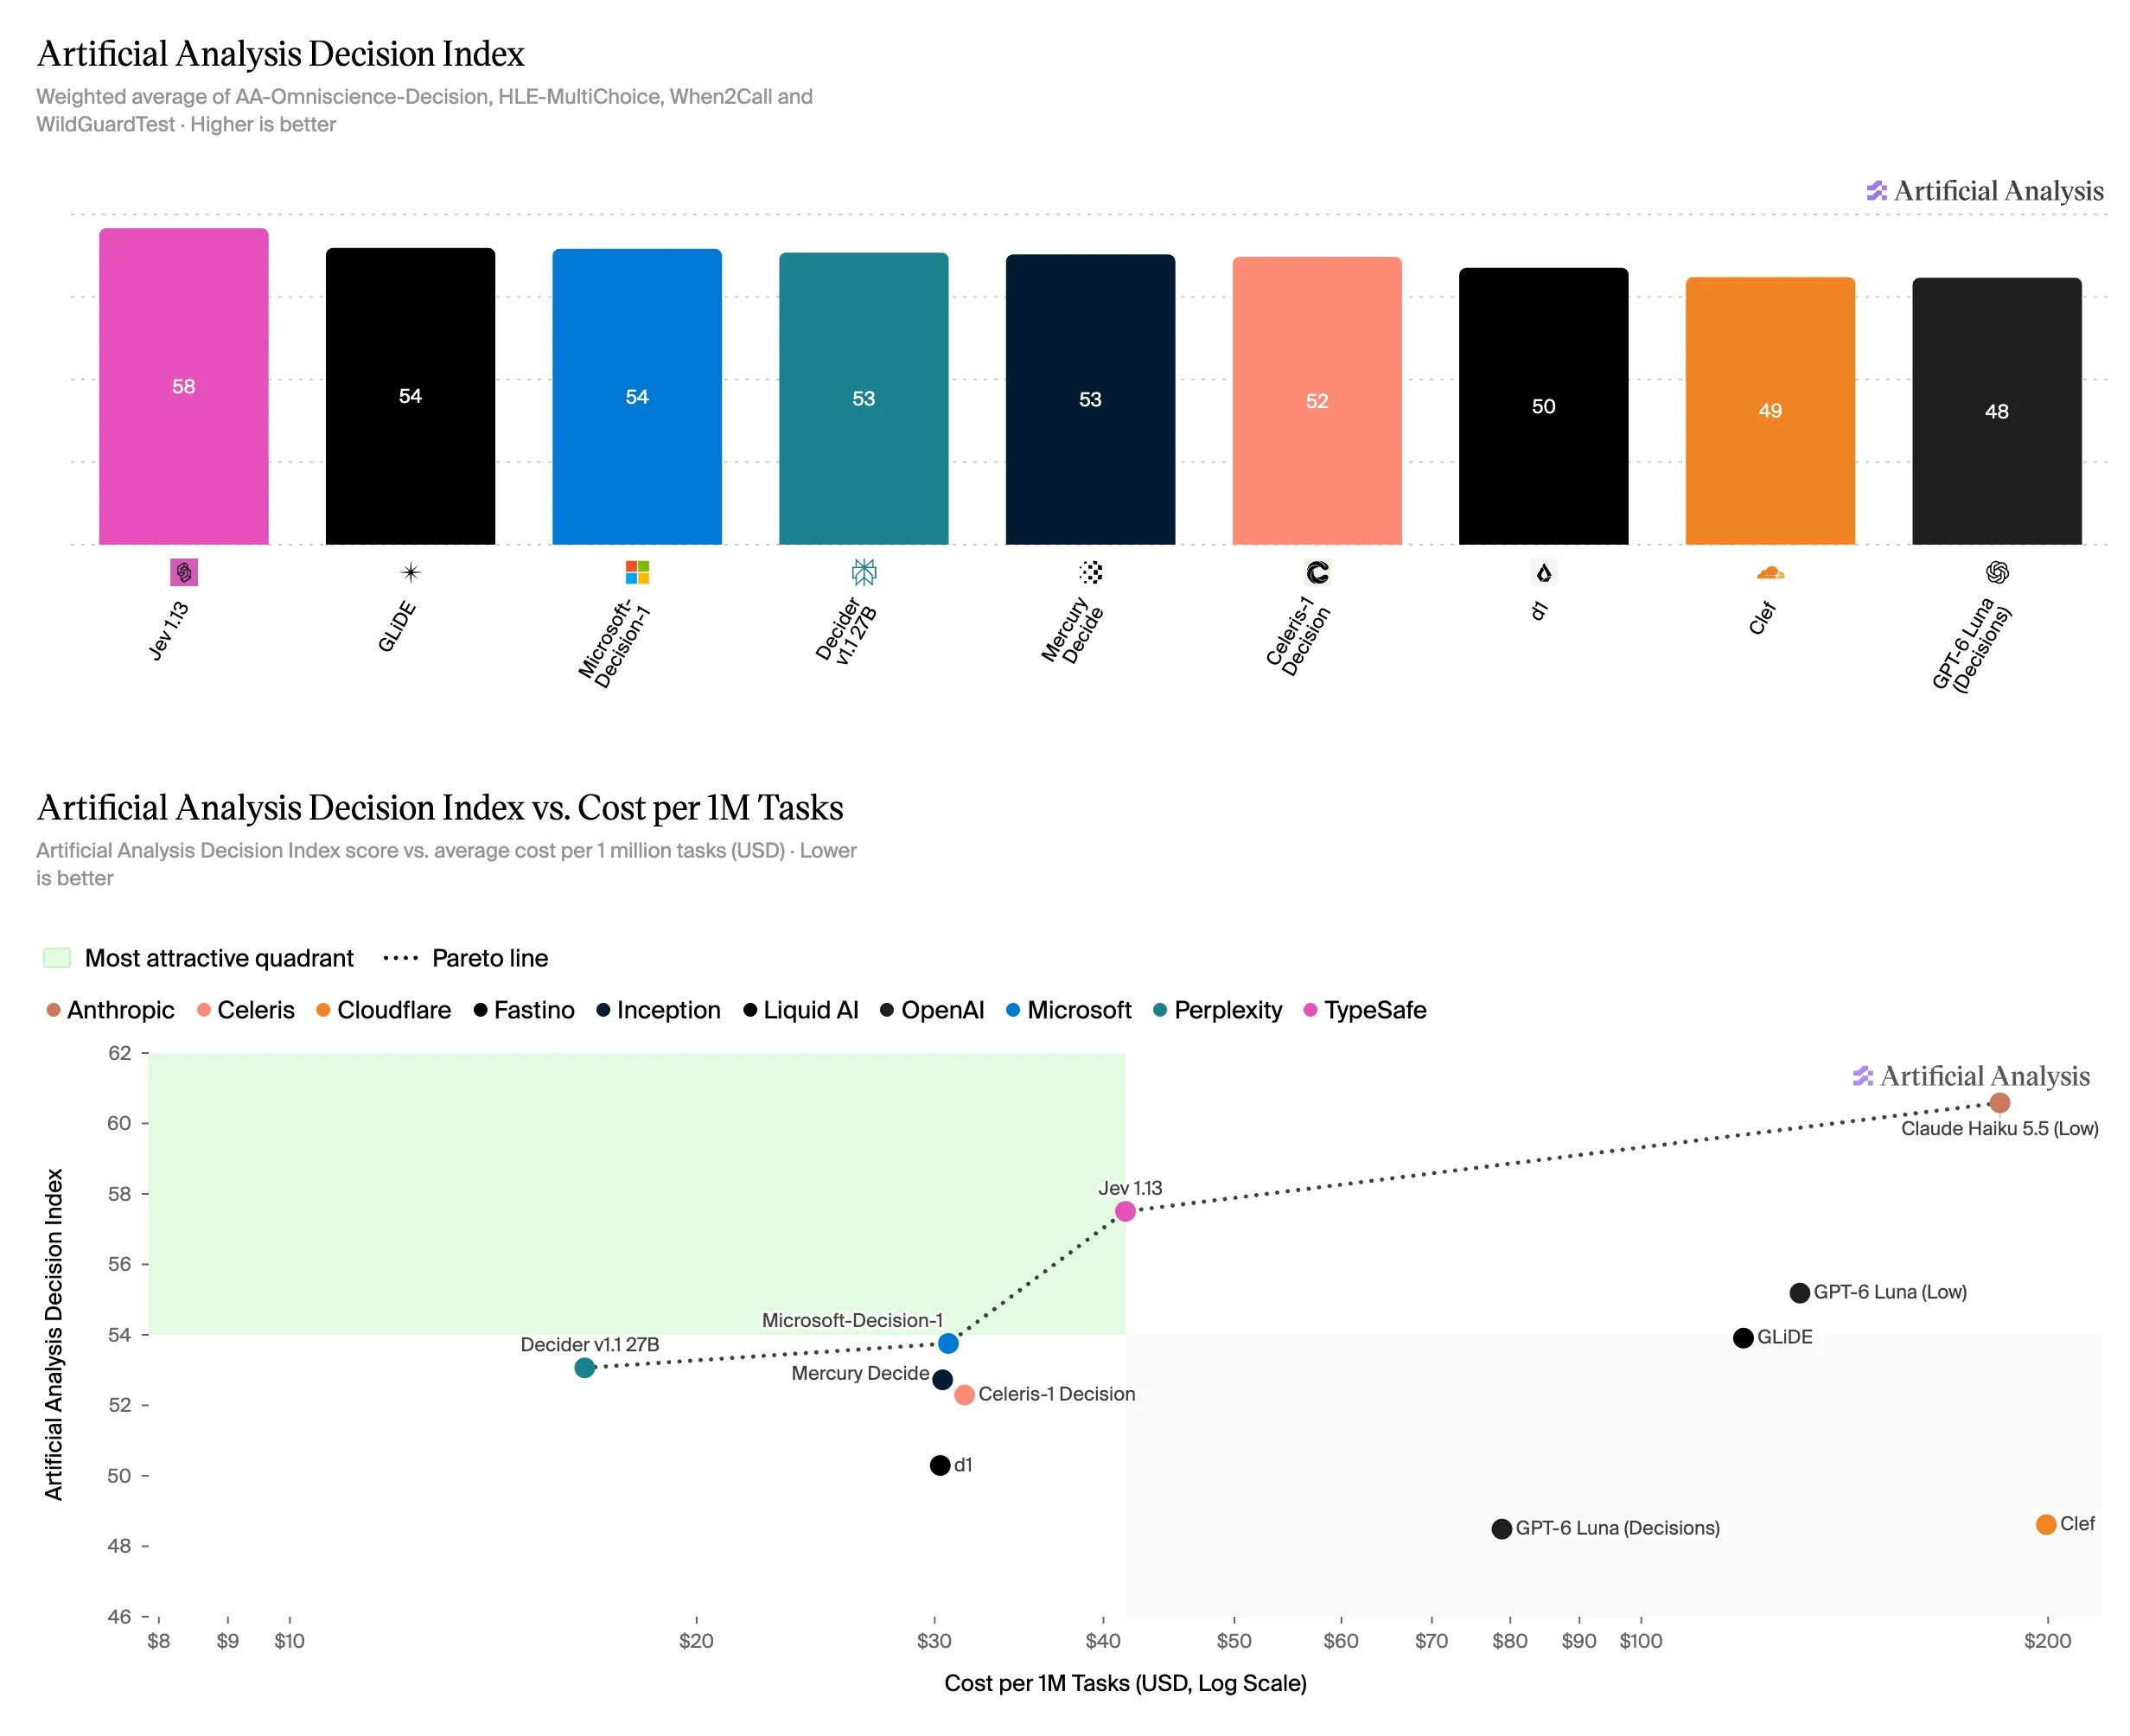
Artificial Analysis Decision Index를 소개합니다. 분류, 도구 호출, 지식 및 추론 전반에 걸쳐 의사결정 모델을 벤치마킹합니다. Jev가 의사결정 모델 중 선두를 차지했으며, Claude Haiku 5.5와 같은 언어 모델은 여전히 더 높은 정확도를 제공하지만 비용과 지연 시간이 훨씬 큽니다.
의사결정 모델은 관련 확률과 함께 구조화된 답변이나 분류를 제공하여, 언어 모델을 사용하는 것보다 더 빠른 응답과 낮은 비용을 제공합니다. Artificial Analysis Decision Index v1.0은 의사결정 모델의 능력, 비용, 속도를 비교하며 언어 모델과도 비교합니다.
Artificial Analysis Decision Index v1.0의 벤치마크:
➤ AA-Omniscience-Decision: 독점 AA-Omniscience 벤치마크에서 변형된 500개 질문의 비공개 데이터셋으로, 의사결정 모델의 지식과 환각 경향을 측정합니다.
➤ HLE-MultiChoice: Humanity’s Last Exam의 텍스트 전용 513개 객관식 질문으로, 의사결정 모델의 추론 능력을 테스트합니다.
➤ When2Call: NVIDIA의 도구 호출 벤치마크로, 모델이 도구 호출, 명확화 요청, 답변 거절 또는 직접 응답을 올바르게 결정할 수 있는지 테스트하며 에이전트 워크플로 및 도구 라우팅과 관련된 능력을 평가합니다.
➤ WildGuardTest: 유해한 사용자 요청, 어시스턴트의 거절, 유해한 응답 전반에 걸쳐 모델의 분류 능력을 평가하는 안전 벤치마크입니다. 우리는 지속적으로 모델 거절을 유발하는 질문을 제외한 후, 세 명의 인간 주석자가 세 개의 라벨 모두에 대해 일치한 원본 1,725개 테스트 행 중 835개의 하위 집합을 사용합니다.
주요 결과:
➤ Jev 1.13이 Decision Index에서 선두이며 Capability vs. Cost Pareto 프론티어에 위치합니다: @typesafeai의 Jev 1.13은 Artificial Analysis Decision Index에서 58점을 기록해, @fastinoAI의 GLiDE(54)와 @Microsoft의 Microsoft-Decision-1(54)을 앞섭니다. @perplexity_ai의 Decider v1.1 27B는 Cost per 1M Tasks가 $17로 가장 낮으며, Microsoft-Decision-1($31)과 Jev 1.13($42)도 Capability vs. Cost Pareto 프론티어에 있습니다. Celeris-1 Decision은 Time per Task가 0.06초로 가장 빠르며, Jev 1.13(작업당 0.13초)보다 2배 이상 빠릅니다.
➤ 의사결정 모델은 지식 및 추론 작업에서 보정이 잘 되어 있지 않습니다: 선택된 답변의 거의 모든 확률 수준에서 정확도가 모든 의사결정 모델에 대해 해당 확률 미만으로 떨어집니다. 이 격차는 AA-Omniscience-Decision과 HLE-MultiChoice에서 가장 크며, 대부분의 모델은 WildGuardTest(분류)와 When2Call(도구 호출)에서는 비교적 잘 보정되어 있습니다.
➤ 의사결정 모델은 언어 모델 대비 상당한 속도와 비용 이점을 제공하지만, 지식과 추론에서는 뒤처집니다: 분류 및 도구 호출 작업에서 선도적인 의사결정 모델은 언어 모델과 비슷한 성능을 내면서도 훨씬 빠르고 저렴합니다. 그러나 지식과 추론에서는 언어 모델이 크게 앞섭니다. Claude Haiku 5.5(Low)는 Decision Index에서 61점으로 Jev 1.13보다 3점 앞서지만, 작업당 1.4초 vs. 0.13초(11배 느림)가 걸리고, 비용은 1M 작업당 $184로 Jev 1.13의 $42 대비 4.4배 더 비쌉니다.
우리는 개발자와 기업이 의사결정 모델을 언제 어떻게 사용해야 하는지 더 잘 이해할 수 있도록 Artificial Analysis Decision Index를 계속 발전시켜 나갈 것입니다.