
윤중(Yunzhong), 아페이쓰(凹非寺) 발
량쯔웨이(QbitAI) | 공식 계정 QbitAI
Agent에게 주간 보고를 쓰게 하고 방안을 분석하게 하는 것은 이미 많은 사람의 일상이 되었다. 하지만 매번 시작할 때 사용자는 자료를 뒤져 배경을 설명해야 하고, 에이전트 역시 검색, 읽기, 정리 등 여러 단계를 거쳐야 비로소 작업을 시작할 수 있다.작업을 바꾸면 이 과정을 다시 반복해야 한다.이미 있는 자료를 반복해서 처리하는 것은 시간도 많이 들고 token 소모도 늘린다. 자료가 많고 절차가 길어질수록 정보를 누락하거나 오차가 생기기 쉬워 작업 완료의 정확도에 영향을 미친다.
이러한 문제를 해결하기 위해,WorkSwarm이 개인 지식 공간을 처음으로 네이티브 지원。
“개인 지식 공간”은 사용자가 설정한 여러 자료 소스를 기반으로 콘텐츠를 자동 수집하고, 규칙 처리, 규칙과 대규모 모델 혼합 처리 또는 에이전트 처리를 통해 자료를목차가 있고, 연관성이 있으며, 출처가 있는개인 지식으로 정리한 뒤 점진적 공개 방식으로 에이전트가 사용할 수 있도록 제공한다.
WorkSwarm은 개인 자료를 장기적으로 재사용 가능한 개인 지식으로 정리하여“한 번 수집, 반복 사용”을 실현함으로써, 에이전트가 관련 정보를 더 쉽게 찾고 잘 활용할 수 있도록 하여 작업 완료의 정확도를 높이는 동시에 작업 준비 시간을 단축하고 token 소모를 줄인다.
openJiuwen 개인 지식 공간: 개인화된 다중 소스 지식을 자동 수집, 오피스 에이전트가 필요에 따라 사용
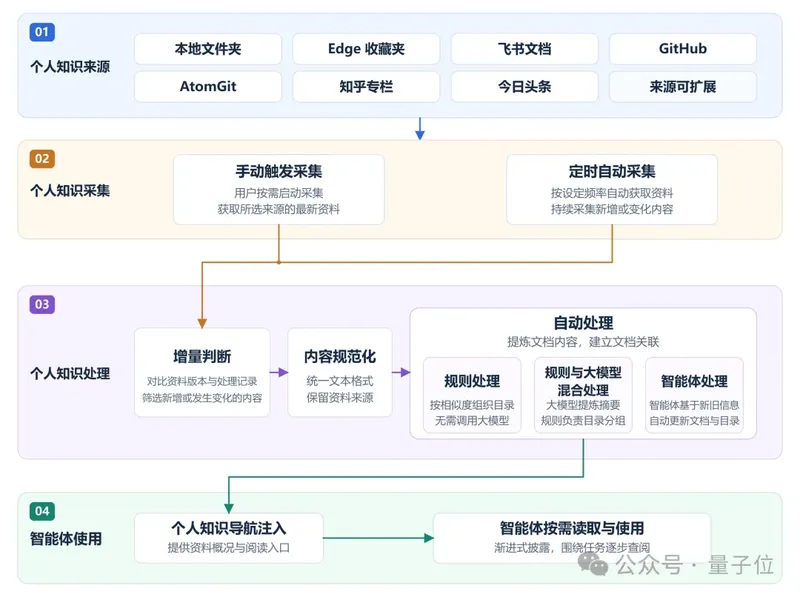
개인 지식 공간은 소스, 수집, 처리, 사용의 네 계층을 중심으로 사용자가 일상적으로 축적한 개인 자료를 지속적으로 재사용 가능한 작업 배경 지식으로 전환한다.
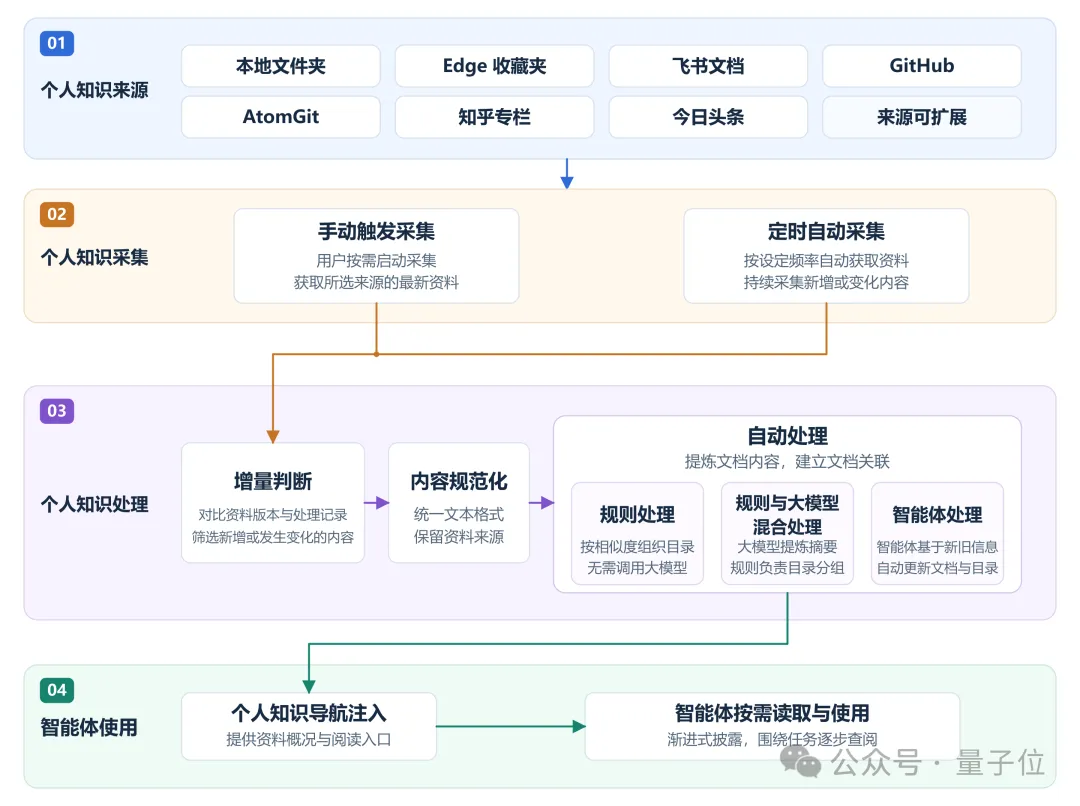 △ 개인 지식 공간의 4계층 흐름: 다중 소스 자료 설정, 수동 및 예약 수집, 세 가지 처리 방식 및 에이전트의 필요에 따른 사용을 보여줌
사용자는 먼저 개인 지식 소스와 수집 범위를 선택하고, 시스템은 필요에 따라 또는 예약에 따라 콘텐츠를 가져온다. 수집된 자료는 형식 통일과 증분 판단을 거쳐 이번 라운드에서 처리해야 할 새 콘텐츠와 변경 사항을 식별한 후, 설정에 따라 규칙, 규칙과 대규모 모델 혼합 또는 에이전트 방식을 선택하여 주제 목차와 Markdown 페이지로 정리하고 문서 간 연관성과 출처를 유지 관리한다. 목차 구조와 출처 참조 검사를 통과하면 정리 결과를 사용자가 열람할 수 있다.
사용자가 작업에 사용하도록 활성화하면, 시스템은 개인 지식 개요와 읽기 입구를 에이전트에 제공하고, 에이전트가 현재 문제를 중심으로 관련 페이지를 단계적으로 읽으면서 기존 지식이 작업 수행의 배경이 되도록 한다.
개인 지식 공간 설정 및 수집: 개인 지식 소스를 스스로 선택, 수동/예약 증분 수집 지원
“설정”의 “지식” 페이지에서 개인 지식 공간을 활성화한 후 사용자는로컬 폴더, Edge 즐겨찾기, 지후(知乎) 칼럼, 투데이 헤드라인(今日头条), 페이슈(飞书) 문서, GitHub 및 AtomGit등의 소스를 추가할 수 있다. 소스별로 개별 설정이 가능하며, 사용자가 어떤 개인 자료를 개인 지식 공간에 넣을지 직접 결정한다.
설정을 완료한 후 사용자는수동으로 수집 시작하여 개인 지식 공간을 능동적으로 업데이트할 수도 있고,예약 자동 수집을 설정하여 정해진 주기에 따라 지속적으로 콘텐츠를 가져올 수도 있다. 시스템은 소스 식별자, 버전, 수집 진행 상황을 결합하여 새로 추가되었거나 변경된 자료를 식별하고, 기존 개인 지식과 결합하여 새로 추가되었거나 변경된 자료를 처리한다.
소스 관리 페이지는 수집 진행 상황과 최근 상태를 보여주며, 사용자는 업데이트 주기를 조정하고 이번 라운드 결과를 확인할 수 있으며, 진행 중인 수집을 중지할 수도 있다.
“설정”의 “지식” 페이지에서 개인 지식 공간을 활성화한 뒤 “지식” 페이지의 “소스 관리”로 이동합니다. 영상에서는 투데이 헤드라인(今日头条)을 예로 들어 작성자 홈페이지 링크를 추가하고, 수동으로 수집을 시작하며, 소스의 실행 상태를 확인합니다.
개인 지식 처리: 세 가지 정리 방식을 제공하여 흩어진 자료를 재사용 가능한 지식으로 만들기
웹페이지, 문서, 코드의 구조는 서로 다르며, 같은 주제의 내용이라도 여러 출처에 흩어져 있을 수 있습니다. 개인 지식 공간은 먼저 자료 형식을 통일한 후 내용을 추출하여, 주제별로 목차와 페이지로 조직함으로써 에이전트가 먼저 개요를 파악한 후 관련 내용을 단계별로 읽을 수 있도록 하고, 동시에 원본 문서의 링크와 출처를 보존합니다.
새로운 자료를 수집한 후, 시스템은 기존의 개인 지식과 결합하여 보완하고 갱신함으로써 지식이 동일한 일련의 순수 텍스트 파일 속에서 지속적으로 축적되도록 합니다.
사용자는 '설정'의 '지식' 페이지에서 자료의 특성과 정리 요구에 따라 다음 세 가지 처리 방식을 선택할 수 있습니다:
- 규칙 처리: BM25 단어 가중치와 콘텐츠 유사도를 활용하여 관련 페이지를 주제별로 분류하고, 목차와 페이지 간의 링크를 유지 관리합니다. 생성 모델을 호출할 필요가 없습니다.
- 규칙과 대규모 모델 혼합 처리: 먼저 대규모 모델이 새 자료의 제목, 요약, 키워드를 추출하고, 이어서 규칙이 주제 그룹화와 목차 구성을 완성하며, 마지막으로 대규모 모델이 목차 제목과 소개를 생성하여 이해와 조회를 용이하게 합니다.
- 에이전트 처리: 에이전트가 새 자료와 기존 개인 지식의 관계를 분석하여, 기존 주제 페이지의 갱신 또는 병합을 우선하고, 필요시 새 문서를 추가하며, 목차 설명과 문서 간 상호 참조를 함께 유지 관리합니다.
뒤의 두 가지 방식을 사용할 경우, 사용자는 자료 정리에 사용할 모델을 구성할 수 있습니다. 정리가 완료되면 시스템이 목차 구조와 출처 인용을 검사하며, 검사를 통과한 내용은 사용자가 조회하고 에이전트가 사용할 수 있게 됩니다.
사용자는 파일 트리, 그래프 또는 검색을 통해 관련 내용을 찾고, 문서를 열어 본문을 읽으며, '출처' 표시를 통해 원본 자료를 추적할 수 있습니다.
수집이 완료되면 'jev' 관련 내용이 이미 수집되어 있습니다. 사용자는 '지식' 페이지에서 jev를 검색하여 오른쪽에서 정리된 본문을 읽을 수 있으며, 그래프를 통해 관련 노드와 그 연관 관계를 확인할 수도 있습니다.
필요에 따른 활용: 점진적 공개, 에이전트가 기존 지식을 갖고 작업을 시작하도록 하기
자료가 개인 지식으로 정리된 후, 사용자는 작업 입력 영역의 '+' 메뉴를 통해 에이전트를 개인 지식 공간에 연결할 수 있습니다. 사용자의 입력을 받으면, 에이전트는 먼저 개인 지식 공간의 자료 개요와 읽기 입구를 획득하여 기존 지식의 범위를 파악한 후, 현재 작업에 따라 목차와 문서 링크를 따라 단계적으로 참조하며 필요한 배경 지식을 보충합니다.
이러한 점진적 공개 방식은 업무를 인수할 때 먼저 목차와 프로젝트 소개를 살펴본 후 관련 문서를 넘겨 보는 것과 유사하며, 매번 작업 시 필요에 따라 기존 지식을 읽도록 합니다.
수집과 작업 사용은 각각 따로 제어할 수 있습니다. 사용자는 시스템이 지속적으로 자료를 수집하고 정리하도록 한 뒤, 필요할 때 에이전트 사용을 켤 수 있습니다. 작업 사용을 끈 후에도 자료는 계속 수집할 수 있으며, 사용자는 기존 문서를 직접 열람하고 검색할 수도 있습니다.
어떤 자료가 개인 지식 공간에 들어갈지, 그리고 에이전트가 언제 사용할 수 있는지는 사용자가 결정합니다. 작업을 시작할 때는 이번에 해결할 문제에만 집중하면 되며, 이미 쌓인 지식은 에이전트가 작업을 이해하고 완수하는 데 배경 지식을 제공합니다.
개인 지식 공간을 켠 후 'jev 소개해줘'라고 입력하고 전송합니다. WorkSwarm은 이어서 개인 지식 공간의 Jev 문서를查阅하여 핵심 메커니즘, 적용 사례 등을 아우르는 소개를 생성합니다.
효과 비교: 작업 통과율 향상, 작업 소요 시간과 token 소비 감소
개인 지식 공간을 활성화하면 에이전트는 먼저 기존 자료의 범위를 파악한 뒤 관련 문서를 찾아 읽을 수 있어, 작업 중 원시 자료를 반복해서 찾고 정리하는 작업을 줄일 수 있습니다.
팀은 먼저 2개의 비교 테스트를 통해 이 변화가 작업 완수 효과, 소요 시간, token 소비에 미치는 영향을 살폈습니다.
비교해 보면, 개인 지식 공간이 있을 때 WorkSwarm은 고객 프로필, 프로젝트 자료, 업무 계획을 결합하여 구체적인 프로젝트 요약과 다음 단계 계획을 정리해 냈습니다. 관련 개인 지식이 없을 때는에이전트가여러 차례 검색한 후에도 프로젝트 배경을 얻지 못해, 일반적인 회의 준비 프레임워크만 먼저 제시하고 사용자에게 자료 보충을 요청할 수밖에 없었습니다.
비교해 보면, 개인 지식 공간을 켠 후 WorkSwarm은 사용자 브라우저 즐겨찾기, 知乎(즈후) 칼럼 등의 출처에서 축적된 지식을 활용해 더 빠르게 작업을 완수할 수 있었습니다.
또한 openJiuwen 팀은 25개 문제로 구성된 자체 테스트 세트를 만들었습니다. 로컬 논문, 브라우저 즐겨찾기, 飞书(피서) 문서, GitHub, AtomGit, 知乎, 头条(투터자오) 등 7가지 출처의 자료를 기반으로 단일 출처 검색, 교차 출처 종합, 문제 교체 후 재사용, 결측 사실, 무관 작업 등의 시나리오를 다루고, 각 문제마다 검수 기준을 미리 설정했습니다. 테스트 결과, 개인 지식 공간 활성화 후:
- 작업 통과율이 32% 향상되었습니다. 개인 지식 공간은 에이전트가 필요한 자료를 더 쉽게 찾도록 하고, 서로 다른 출처의 개인화 정보를 결합해 답변하게 하여, 자료를 찾지 못하거나 정보를 누락해 작업을 완수하지 못하는 경우를 줄입니다.
- 작업 총 소요 시간이 76.2% 감소했습니다. 자료가 사전에 수집·정리되어 있어 작업 중 관련 문서를 바로 열람할 수 있고, 임시로 원시 자료를 찾고 읽고 정리하는 단계를 줄일 수 있습니다.
- 작업 단계 token 총 소비가 84.1% 감소했습니다. 정리된 지식은 서로 다른 작업에서 재사용할 수 있으며, 에이전트는 작업에 맞춰 필요한 내용만 읽기 때문에 원시 자료를 반복 정리하거나 무관한 내용을 전달하는 token 소비가 줄어듭니다.
이번 실험은 에이전트 처리 방식을 채택했으며, 전처리 단계에서도 token이 소비되지만 이 비용은 자료 정리에 적합하고 가격이 낮은 모델을 선택함으로써 통제할 수 있고, 정리 결과가 여러 작업에서 반복 사용됨에 따라 점진적으로 분산됩니다.
맺음말
openJiuwen 개인 지식 공간은 흩어진 개인 자료를 지속적으로 재사용 가능한 지식으로 정리합니다. 사용자가 출처를 직접 선택하고 시스템이 지속적으로 수집·갱신하여, 자료를 열람하기 편리할 뿐 아니라 에이전트가 필요에 따라 읽을 수 있게 하고 다양한 작업에 배경 지식을 제공합니다.
향후 openJiuwen 개인 지식 공간은 사용자 사용 궤적을 결합해 업무 목표와 지식 공백을 파악하고 자료를 능동적으로 보충하여, 지식 축적이 실제 수요에 더 가까워지고 오피스 에이전트가 사용할수록 사용자를 더 잘 이해하도록 할 계획입니다.
개인 지식 공간은 쌓아온 자료가 다음 Agent 협업의 출발점이 되도록 합니다.
개인 지식 공간이 WorkSwarm에 출시되었습니다. 관심 있는 사용자는 공식 웹사이트에서 원클릭 다운로드하여 지금 바로 체험할 수 있습니다:
WorkSwarm 공식 웹사이트: https://openjiuwen.com/workswarm
GitHub: https://github.com/openJiuwen-ai/jiuwenswarm
AtomGit: https://atomgit.com/openJiuwen/
*본 글은 量子位(챙쯔웨이)가 승인을 받아 게재한 것으로, 견해는 원저자에게 귀속됩니다.