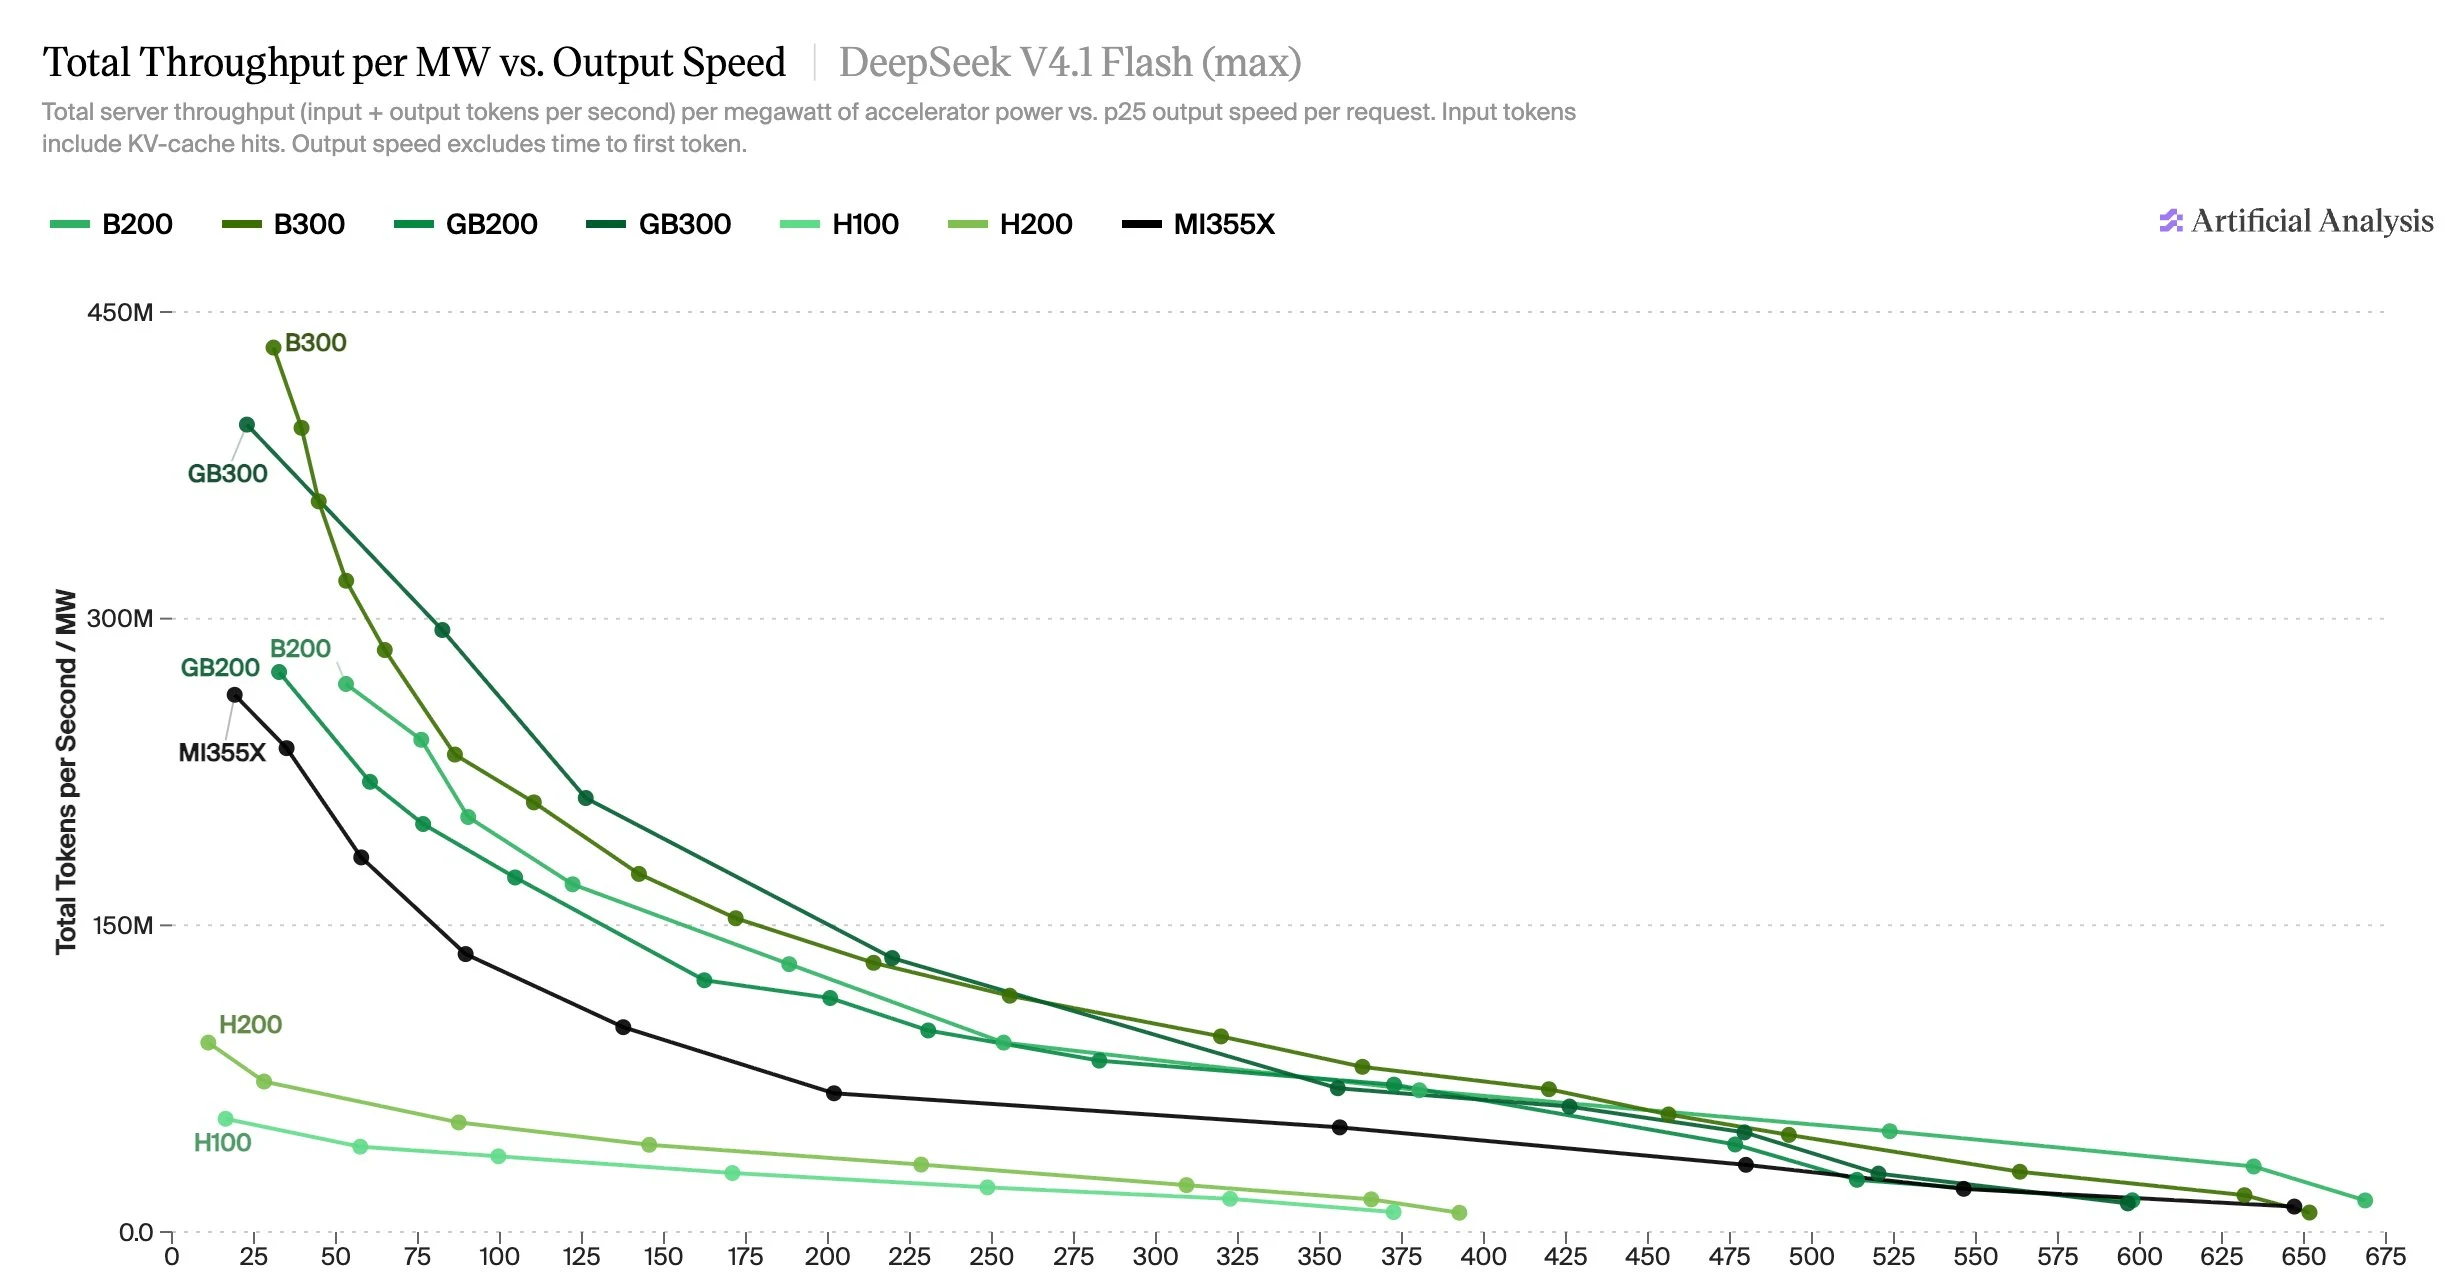
AA-AgentPerf에 DeepSeek V4.1 Flash를 추가했으며, NVIDIA 및 AMD 하드웨어에 대한 결과를 포함했습니다. 사용자당 100 tokens/s 기준으로 NVIDIA GB300가 MW당 최대 261M tokens/s의 처리량으로 1위를 차지했습니다.
AA-AgentPerf는 우리의 에이전틱 추론 성능 벤치마크입니다. 프롬프트 캐싱과 도구 호출 지연을 포함한 실제 에이전틱 코딩 세션을 재현하여 일상적인 에이전틱 워크로드에서의 추론 성능을 현실적으로 측정합니다. 우리는 런타임 전력 메가와트당 총 시스템 처리량과 다양한 동시성 수준에서의 에이전트별 출력 속도를 측정하여, 시스템 활용도와 개별 사용자 경험 사이의 트레이드오프를 보여줍니다.
DeepSeek V4.1 Flash가 오늘 리더보드에 합류했습니다. 이로써 리더보드는 DeepSeek V4 Pro 0813, Kimi K3, GLM-5.2/5.3에 이어 4개의 주요 모델을 갖추게 되었습니다. 우리는 인기 있는 새로운 오픈 웨이트 모델이 출시됨에 따라 주요 모델을 지속적으로 갱신하고 있으며, 향후 주요 릴리스에 대해 day-0 결과를 제공할 예정입니다.
DeepSeek v4.1 Flash 배경 정보:
➤ Artificial Analysis Intelligence Index에서 39점을 기록하여, 36점을 받은 DeepSeek의 이전 모델 V4 Pro 0813을 앞서며, 파라미터는 약 3분의 1 수준입니다(552B ‘백본’ 및 16B 활성, 기존의 1.6T 및 49B 대비)
➤ 새로운 아키텍처를 기반으로 구축되었으며, 입력 토큰당 8B, 출력 토큰당 16B의 파라미터를 활성화하는 인과적(causal) 인코더-디코더 설계를 채택했습니다. 가속기가 아닌 호스트 메모리에 상주할 수 있는 196B 규모의 Engram n-gram 메모리를 추가로 사용하며, 기존 V4 Flash 모델보다도 토큰당 KV 캐시가 약 4분의 1 수준으로 적게 필요한 압축 희소 어텐션(compressed sparse attention)을 사용합니다
➤ 이 덕분에 서빙이 훨씬 더 효율적입니다. 웨이트가 더 적은 GPU에 들어가고, 더 작은 KV 캐시 덕분에 GPU당 더 많은 동시 에이전트를 수용할 수 있는 여유 공간이 생기기 때문입니다
DeepSeek V4.1 Flash의 초기 AA-AgentPerf 결과:
➤ V4.1 Flash는 최소 2개의 GPU에서 실행될 수 있어, 랙 스케일 시스템이 B300 같은 8-GPU 단일 노드 대비 얻는 이점이 줄어듭니다. B300은 전체 커브에서 랙 스케일 GB300 NVL72의 약 20% 이내에 머무르며, 양쪽 끝에서는 선두를 차지합니다
➤ 사용자당 100 tok/s 기준으로 GB300이 MW당 약 261M tokens/s로 선두이며, B300(약 220M), B200(약 193M), GB200(약 178M), MI355X(약 128M)를 앞섭니다
➤ 모든 Blackwell 시스템과 MI355X는 단일 에이전트(즉, 배치 크기 1)에 대해 약 600~670 tok/s의 출력 속도에 도달할 수 있는 반면, H100과 H200에서는 372~392 tok/s입니다
➤ V4.1 Flash는 V4 Pro 0813보다 지능적일 뿐만 아니라 서빙 비용도 훨씬 저렴하여, 사용자당 100 tok/s 기준으로 더 큰 형제 모델 대비 MW당 처리량이 약 1.3배(GB300)에서 약 6.2배(B200)에 이릅니다