
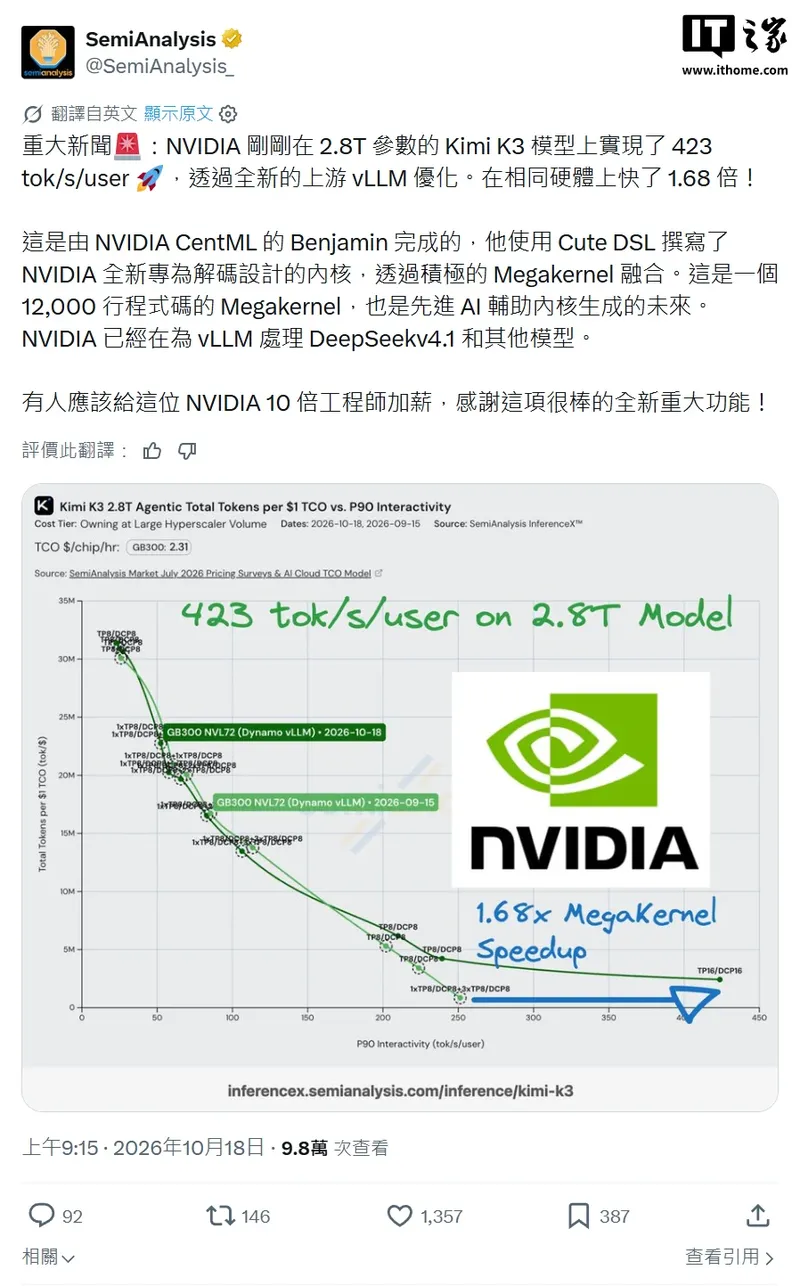
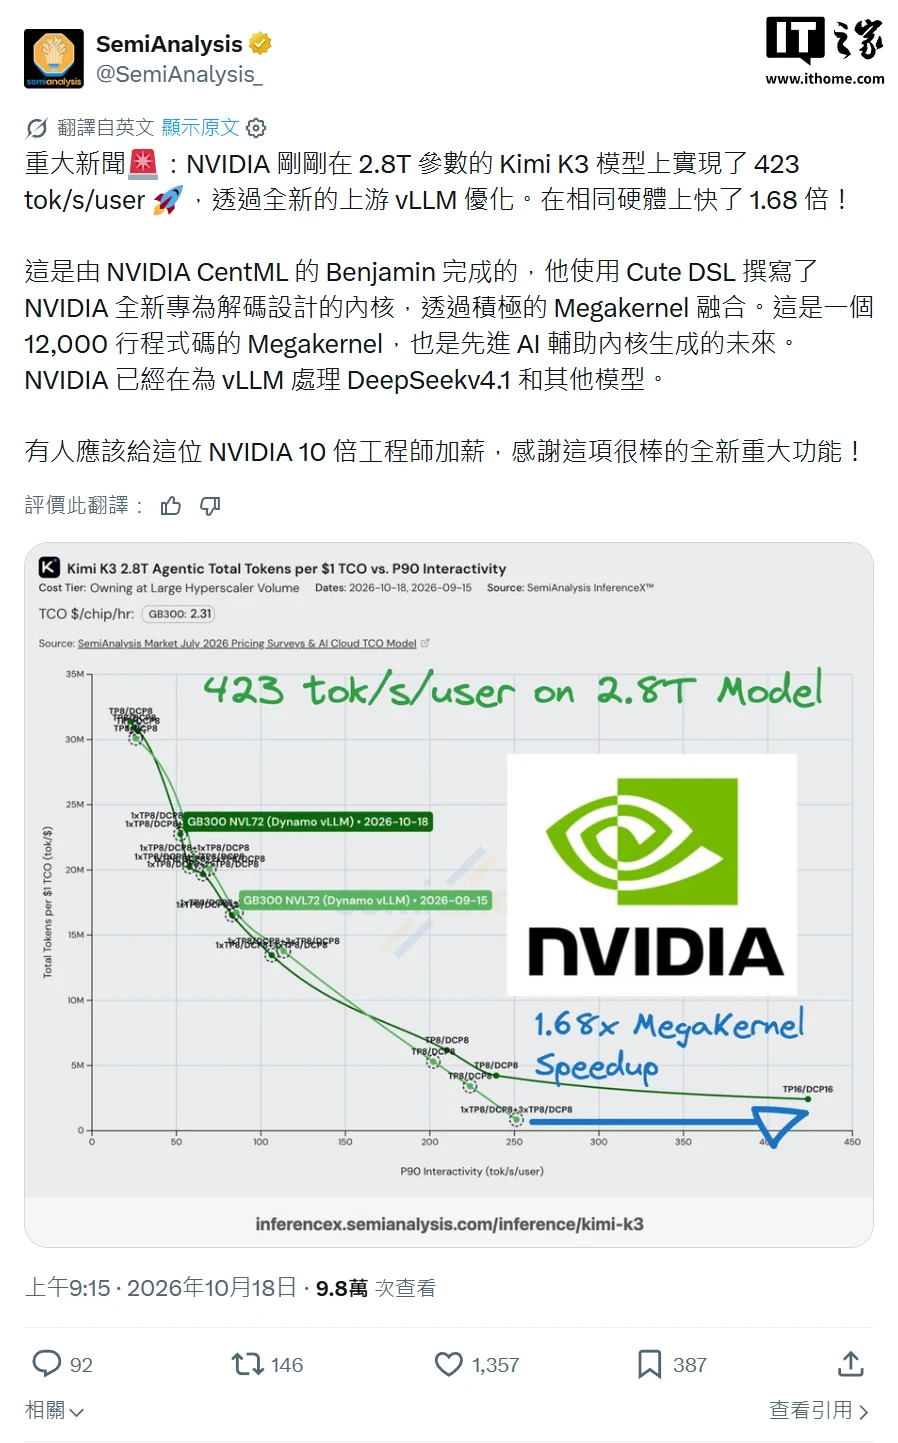
IT之家 10월 18일 소식, 조사기관 SemiAnalysis가 오늘 발표한 글에 따르면, 엔비디아는 상류(upstream) vLLM 최적화를 통해 2.8조 파라미터 규모의 Kimi K3 모델에서 사용자당 초당 423 tok/s/user(토큰)의 추론 속도를 달성했으며,동일 하드웨어(GB300 NVL72) 대비 성능이 1.68배 향상되었다。
소개에 따르면 이번 최적화는 엔비디아 CentML 엔지니어 Benjamin가 완성했다. 이는 대규모 Megakernel 융합을 통해 Cute DSL을 사용해 엔비디아가 새로 출시한 디코딩 전용 커널을 작성한 것이다.해당 Megakernel은 1.2만 줄의 코드를 포함하고 있으며, AI가 보조하여 고급 컴퓨팅 커널을 생성하는 미래 방향을 대표한다. 엔비디아, Kimi K3 모델 추론 속도 최적화로 1.68배 향상.
IT之家는 엔비디아가 이 외에도 vLLM을 위해 DeepSeek V4.1 등 다른 모델의 최적화를 개발하고 있음을 확인했다.