
10월 16일, 제10회 CSDI Summit 중국 소프트웨어 연발 인공지능 혁신 테크 서밋이 선전(深圳)에서 개최되었다. 상탕대장치(商湯大裝置) 부사장 겸 CTO 선선밍(宣善明)이 메인 포럼에서 〈Agentic 시대 AI 인프라 실천과 트렌드〉라는 제목의 기조연설을 발표하며, Agentic 시대의 Token 증가 트렌드, 이기종 추론 클러스터 실천 및 AI 인프라 신기술 탐구 등의 주제를 중심으로, 상탕대장치의 대규모 추론 서비스 분야에서의 기술 탐구와 실천 경험을 공유했다.
센스타임(商汤) AI 대규모 인프라 사업 부사장 겸 CTO 쉬안산밍(宣善明)
선선밍(宣善明)은 AI 애플리케이션이 대화형 질의응답에서 점차 멀티에이전트 협업과 장기 작업 실행으로 나아가면서 토큰 수요가 천 배 수준으로 증가하고 있으며, AI 인프라가 지금수요 폭발과 연산 능력 공급 제약이 공존하는 새로운 국면에 직면하고 있다。미래 업계 경쟁의 핵심은 얼마나 많은 연산 능력을 보유하느냐가 아니라, 아키텍처 혁신, 이기종 협업, 자원 스케줄링 등을 통해 어떻게더 낮은 비용, 더 높은 효율, 더 안정적으로 고품질 Token을 지속적으로 생산합니다.
연산 능력 규모부터 토큰 생산 능력까지, AI 인프라가 효율성의 변화를 맞이하다
전통적인 대화형 질의응답에 비해, 단일 에이전트 도구 호출, 다중 에이전트 협업, 그리고 장기 작업·무인 실행은 더 많은 모델 호출, 추론 라운드 및 컨텍스트 처리를 수반하며, 토큰 소비는 천 배 수준의 증가를 보인다. 동시에 고급 칩 공급의 제약, 기존 컴퓨팅 파워와 추론 작업의 자원 수요 간 불일치 등의 문제로 인해 컴퓨팅 파워 공급이 동일한 속도로 확장되기 어렵다. 업계 데이터에 따르면 2026년 추론 지출이 AI IaaS 총 지출에서 차지하는 비중은 55%에 이를 것으로 예상되며, 2027년에는 59%로 상승할 것으로 전망된다.
한편, 애플리케이션마다 Token에 대한 수요도 뚜렷한 차이를 보입니다. 기본 질의응답은 단위 비용과 동시 처리 능력에 더 주목하는 반면, 오피스 Agent, 고객 서비스 등 시나리오는 응답 지연과 생성 속도에 더 높은 요구를 두며, 과학 탐사, 금융 퀀트 등 고가치 시나리오는 결과의 정확성, 감사 가능성, 추적 가능성 등을 더욱 중시합니다. 첫 Token 지연 시간(TTFT), 생성 속도(OTPS), 긴 컨텍스트 캐싱, 동시 처리 능력, 호출 성공률 등의 지표가 Token 서비스의 품질과 비용을 공동으로 결정합니다.
쉔샤밍(宣善明)은 이렇게 말했다. “이는 AI 인프라가 더 이상 단일 하드웨어 구성으로 모든 작업을 충족할 수 없으며, 서로 다른 시나리오의 서비스 요구 사항에 따라 연산 자원을계층적 조직과 정밀한 스케줄링。규모 확장에서 효율 최적화로, 단일 지점 하드웨어 대체에서 이기종 협업으로 전환하고 있습니다, Agentic 시대 AI 인프라의 중요한 발전 방향이 되고 있다."
PD 분리를 핵심으로 하여 만 카드 규모의 이기종 추론 클러스터를 구축한다
고급 연산 능력 공급 제약과 추론 수요 증가 사이의 모순에 직면하여, 상탕(SenseTime) 대장치(大装置)는 분리형 추론 아키텍처를 탐색하고 있으며,PD 분리와 이기종 혼합 스케줄링을 통해 서로 다른 유형의 컴퓨팅 파워가 각각 더 적합한 작업을 담당하도록 합니다.
대규모 모델 추론 과정에서 Prefill은 입력 토큰을 처리하며 강한 연산 집약적 특성을 지니고, Decode는 출력 토큰을 단계적으로 생성하며 컨텍스트 캐시를 지속적으로 읽어야 하므로 메모리 대역폭에 대한 요구가 높다. PD 분리는 이 둘을 분리한다. 적합한 국산 연산력이 Prefill 작업을 집중적으로 담당하고, 높은 대역폭을 갖춘 고성능 GPU가 Decode 작업을 담당하며, KV Cache 전송으로 두 단계를 연결한다. 이 방안은 단순히 서로 다른 칩을 조합하는 것이 아니라, 연산 특성, 메모리 대역폭, 작업 요구를 중심으로 연산 자원을 재구성하는 것이다. 이를 통해 국산 연산력은 기본 추론 작업을 담당하는 데서 나아가 더 상위 수준의 추론 서비스에 참여하게 되며, 다양한 시나리오의 서비스 품질 요구를 충족하는 동시에 하이브리드 클러스터의 전체 효율과 가성비를 높인다.
이러한 발상을 바탕으로 센스타임(상탕) 대설비(大装置)는 린강 AIDC에서 이기종 추론 실천을 지속적으로 수행하여 만 카드급 이기종 추론 클러스터를 구축했습니다. 이 아키텍처를 구현하려면 세대와 유형이 다른 연산 자원 간의 상호 연결 문제를 해결해야 하며, 동일한 클러스터에서 800G, 400G, 200G 등 서로 다른 규격의 네트워크를 융합하여 Prefill 노드와 Decode 노드 간의 KV Cache 효율적 전송을 보장해야 합니다.
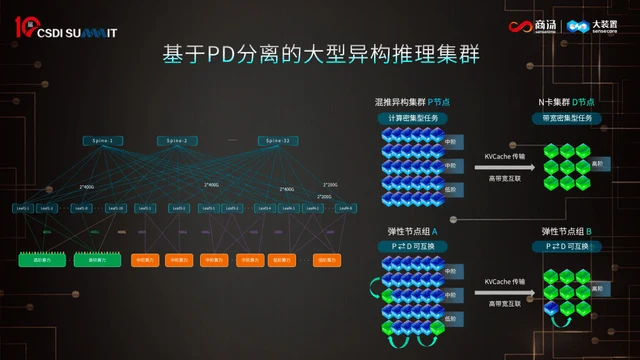
그러나 클러스터 규모가 확대됨에 따라 노드 장애와 자원 유휴가 새로운 엔지니어링 과제로 떠오르고 있습니다. 예를 들어 일부 이기종 구성에서는 하나의 Decode 노드의 처리 능력에 맞추기 위해 30~50개의 중저가 Prefill 노드가 필요할 수 있습니다. Decode 노드에 장애가 발생하면 대량의 Prefill 자원도 유휴 상태가 되어 전체 서비스 효율에 영향을 미칠 수 있습니다.
이에 대해 상탕대장치(商汤大装置)는 두 가지 최적화 방식을 실천했다. 하나는 Prefill 자원 풀에 소량의 고급 연산 자원을 예비해 두어, Decode 노드에 장애가 발생했을 때 고급 노드를 신속히 배치해 보완할 수 있도록 하는 것이고, 다른 하나는 클러스터 내 노드가 Prefill과 Decode 역할을 동적으로 전환할 수 있는 능력을 갖추어, 실시간 부하와 자원 압박에 따라 노드의 역할 분담을 유연하게 조정함으로써 연산 자원의 동적 흐름과 탄력적 스케줄링을 실현하는 것이다. 이 두 가지 방식을 통해 비용을 절감하는 동시에 대규모 이기종 클러스터가 지속적이고 안정적으로 고품질 Token을 출력하도록 보장할 수 있다.
이러한 실천을 둘러싸고 상탕(商汤) 대규모 인프라는 에너지 시설, 자원 상호연결, KV 데이터 플레인, 추론 런타임, 서비스 스케줄링 및 전달 계층을 포괄하는6계층 아키텍처 체계이기종 하드웨어를 통합 스케줄링과 탄력적 운영이 가능한 추론 서비스 체계로 조직화한다.
쉰산밍(Xuan Shanming)에 따르면, 특정 테스트 구성에서 기존 기준 방안과 비교하여 동일한 수량의 하이엔드 플래그십 카드 조건 하에서 이기종 추론과 자원 협업을 통해전체 Token 처리량을 기존의 5배까지 향상시킬 수 있다.
크로스 도메인 PD 분리에서 AF 분리로, 추론 아키텍처의 경계를 지속적으로 확장하다
대규모 이기종 추론을 바탕으로 센스타임 대장치(商湯大裝置)는크로스 도메인 PD 분리, AF 분리등의 기술 방향을 탐색하며 분산된 연산 자원의 협업 잠재력을 한층 더 끌어내고 있다.
크로스 도메인 PD 분리는 단일 데이터센터의 자원 경계를 깨는 것을 목표로 한다. 선셴밍(宣善明)은 단일 데이터센터에서 PD 분리를 실현한 후, 다음 단계로 탐구하는 것이 크로스 도메인 PD 분리이며, 이를 통해 지역별 연산 자원을 더욱 활성화할 수 있다고 말했다. 상탕 대장치(商汤大装置)는 전국 각지 정부와 협력하고 있으며, 크로스 도메인 협업을 통해 로컬의 중저단계 연산 자원이 Prefill을 담당하고, KV Cache를 다른 지역의 고성능 연산 클러스터로 전송하여 Decode를 완료할 수 있다.클러스터 간, 데이터센터 간, 나아가 지역 간 추론 오케스트레이션을 실현한다.
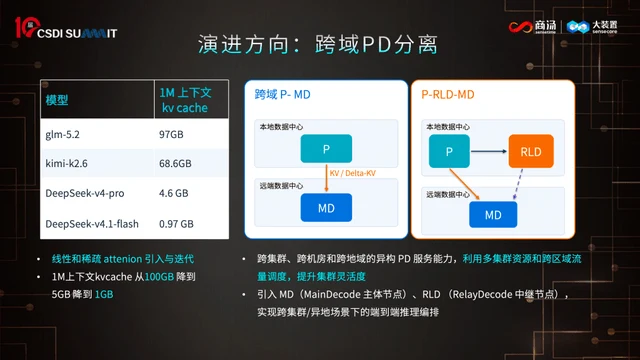
이 방향의 실현 가능성은 모델 아키텍처의 진화와도 밀접한 관련이 있다. 1M 컨텍스트의 KV Cache 규모는 일부 모델에서 이미 약 100GB에서 약 1GB로 감소하여, 크로스 도메인 전송의 부담을 크게 줄였다. 상탕 대장치는 또한 주체 Decode 노드(MD)와 중계 Decode 노드(RLD)를 도입하는 것을 탐구하고 있어, 타지역 시나리오에서의 추론 오케스트레이션을 지원한다. 이를 통해 해당 지역에 완전한 고성능 연산 능력이 갖춰져 있지 않더라도, 서로 다른 규모와 성능의 연산 자원을 통합하여 일체화 연산 네트워크가 자원 연결에서 태스크 협업으로 나아가도록 하고, 더 높은 처리량과 더 높은 품질의 Token 서비스를 실현할 수 있다.
AF 분리는 추론 과정의 서로 다른 연산 태스크를 한층 더 분리(decoupling)한다. Decode 단계에서 Attention은 주로 컨텍스트 처리와 핵심 정보 추출을 담당하며, 메모리(显存) 용량과 대역폭에 대한 요구가 높다. FFN은 대량의 행렬 곱셈 연산을 수행하며, 연산 능력에 대한 요구가 더 높다. 전통적 아키텍처는 이 둘을 동일한 GPU 자원에 묶어 자원 경쟁을 초래할 수 있다. AF 분리는 Attention과 FFN을 각자의 태스크 특성에 더 적합한 하드웨어에 배치함으로써 독립적인 확장과 자원 최적화를 실현한다.
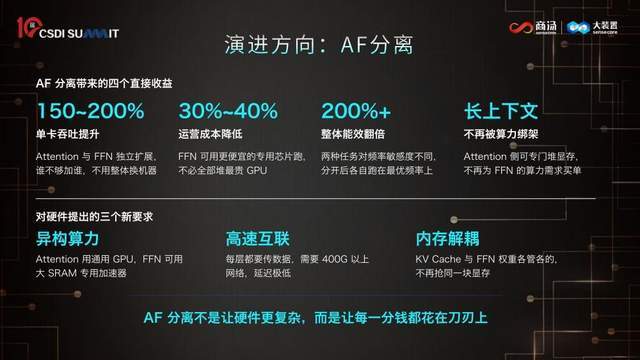
향후 AF 분리는 카드당 처리량 150%에서 200% 향상, 운영 비용 30%에서 40% 절감, 전체 에너지 효율을 기존의 두 배 이상으로 끌어올릴 것으로 기대된다. 관련 이득은 여전히 구체적인 모델 아키텍처, 하드웨어 구성 및 시스템 구현에 따라 달라지지만, 그 기술적 사고방식은 일관된다. 즉, 추론 과정에서의 성능 병목을 지속적으로 식별하고, 더 세분화된 태스크 분할과 자원 배치를 통해 전체 시스템 효율을 높이는 것이다.
PD 분리에서 크로스 도메인 PD 분리로, 그리고 AF 분리로 이어지는 향후 추론 아키텍처의 지속적인 진화는 추론 인프라의 성능과 비용 우위를 한층 더 발휘할 것으로 기대된다.
튜닝의 예술에서 시스템 엔지니어링으로, SLA와 비용으로 추론 가치를 측정하다
선셴밍은 추론 인프라의 최적화는 두 가지 핵심 지표로 돌아가야 한다고 생각한다. 하나는 엔드투엔드 서비스 품질, 즉 시스템이 약속된 응답 속도, 생성 효율, 동시성 능력 및 호출 성공률을 충족할 수 있는지이고, 다른 하나는 비용, 즉 해당 서비스 품질 요구를 충족하는 전제 하에 단위 투입이 얼마나 많은 유효 Token을 산출할 수 있는지이다.
이는 인프라에도 더 높은 요구를 제기한다. 국산 연산 자원, 첨단 연산 자원과 다양한 모델 간의 지속적인适配(적配)가 필요하며, 모델과 애플리케이션의 빠른 반복이 최적화의 복잡도를 더욱 증가시킨다. 하드웨어 구성, 모델 특성, 태스크 요구와 스케줄링 전략을 통일된 체계에 넣을 때에만, 다차원 조합 속에서 지속적으로 더 나은 해를 찾을 수 있다.
현재 상탕 대장치는 Token 공장 모델을 통해 대규모 추론 서비스 능력을 향상시키고 있다. 상탕 대장치 플랫폼의 일평균 Token 서비스량은 이미 6조에 달했으며, 2026년 연간 Token 서비스 규모는 25배 증가할 것으로 예상되고, 4분기에는 일평균 10조 Token 규모에 도달할 전망이다.
선셴밍은 Agentic 시대에 희소한 것은 칩이 아니라안정적이고 저비용으로 높은 등급의 Token을 지속적으로 산출하는 시스템 능력이라고 밝혔으며, 이는 시스템 효율, 아키텍처 혁신과 산업 전달 능력을 아우르는 완전한 체계를 포괄한다. 기술 실천에서 비즈니스 전달에 이르기까지, 상탕 대장치는 추론 인프라가 경험에 의존하는 튜닝 과정에서측정 가능하고, 최적화 가능하며, 검수 가능한 시스템 엔지니어링으로 나아가, 연산 투자가 최종적으로 안정적인 Token 서비스 생산 능력으로 전환되기를 희망한다.
본 글은 상탕과기(商汤科技)가 제공하였으며, 양자웨이(量子位)가 전재 승인을 받았고, 견해는 원저자에게 귀속된다.