
vLLM 은(는) 대규모 언어 모델(LLM)을 위한 오픈 소스 추론 및 서빙 엔진입니다. LLM 추론에는 두 가지 뚜렷한 단계가 있습니다. 입력 프롬프트를 처리하고 키-값(KV) 캐시를 구축하는 prefill과, 해당 캐시를 사용하여 한 번에 한 토큰씩 출력을 생성하는 decode입니다. 이 두 단계는 서로 다른 컴퓨팅, 메모리 및 확장 특성을 가집니다. Prefill-decode (P-D) 분리 방식 은(는) 이 두 단계를 별도의 엔진 인스턴스에서 실행하여 각 단계가 독립적으로 확장되고 최적화될 수 있게 합니다. 이는 부하 상황에서 리소스 활용도, 처리량 및 지연 시간을 개선할 수 있습니다. 그러나 토큰 생성이 시작되기 전에 KV 캐시를 prefill 인스턴스에서 decode 인스턴스로 전송해야 하므로, 효율적인 KV 전송이 time-to-first-token(TTFT)에 매우 중요합니다.
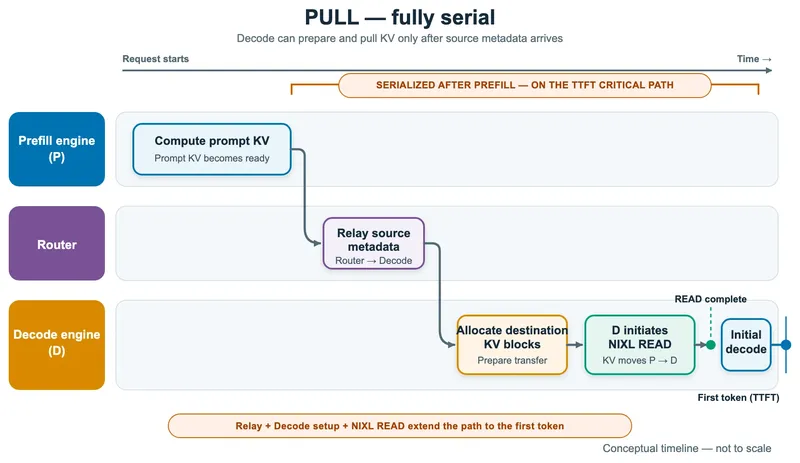
vLLM이 이 전송을 수행하는 방법 중 하나는 NVIDIA Inference Xfer Library (NIXL) 커넥터를 통하는 것으로, 이는 AWS Elastic Fabric Adapter(AWS EFA, AWS에서 서버 간에 사용되는 저지연 RDMA 네트워크)와 같이 원격 직접 메모리 액세스(RDMA)를 지원하는 상호 연결을 통해 KV 블록을 이동합니다. 지원되는 인스턴스 유형에서 AWS EFA는 GPUDirect RDMA와 Neuron Direct RDMA를 지원합니다. 따라서 NIXL은 호스트 메모리를 거치지 않고 GPU 또는 AWS Trainium 장치 메모리 간에 KV 블록을 직접 전송할 수 있습니다. NIXL 커넥터의 기본 모드는 풀 기반입니다: prefill 인스턴스가 프롬프트 KV 캐시 계산을 마치면, 라우터가 prefill 블록 ID를 포함한 소스 메타데이터를 decode 인스턴스에 전달합니다. 그런 다음 decode 인스턴스가 대상 블록을 할당하고, NIXL 전송을 준비하며, NIXL READ를 시작하여 prefill 인스턴스에서 KV 블록을 가져옵니다(pull). 이러한 조정 및 설정 단계가 prefill 이후, 디코딩 시작 이전에 순차적으로 발생하기 때문에 다음 타임라인에서 보이는 것처럼 TTFT 임계 경로가 길어집니다.
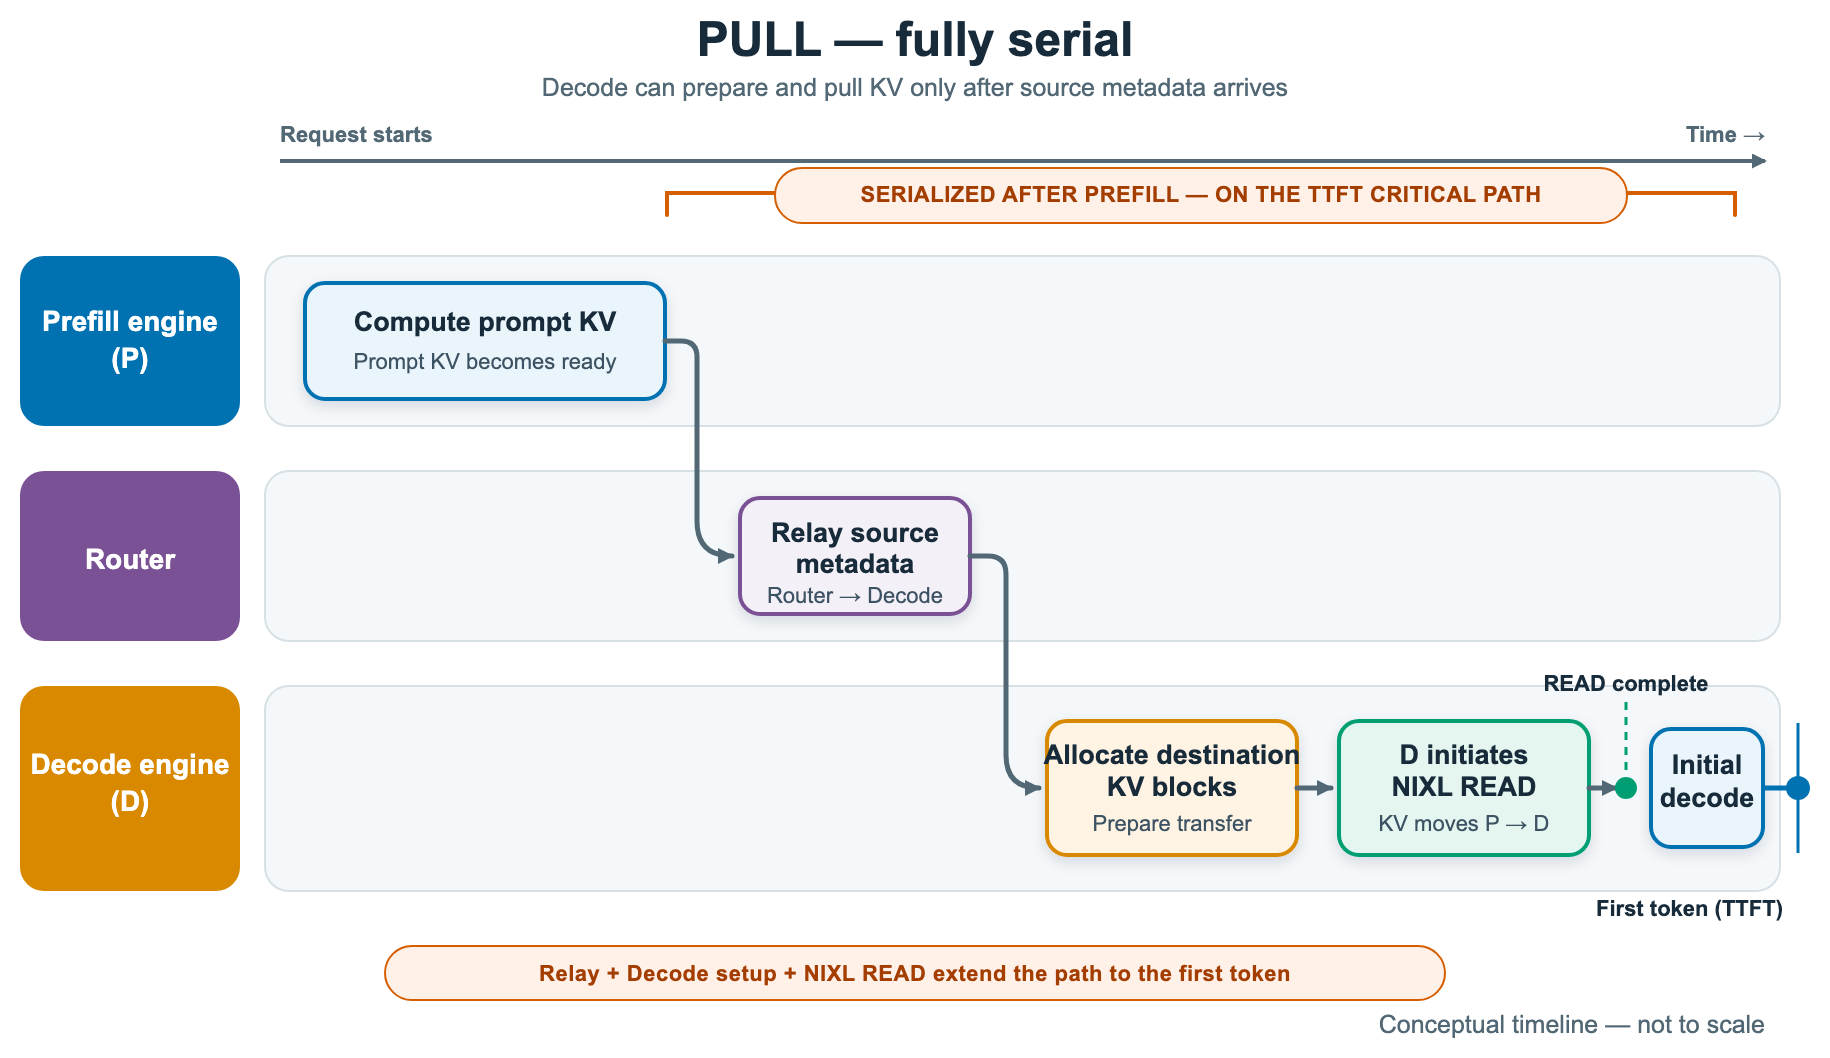
그림 1: 풀 모드 KV 전송 타임라인. 라우터 릴레이, decode 측 할당, NIXL READ가 첫 번째 토큰에 이르는 경로에서 직렬로 실행됨
이 게시물은 post-prefill 전송 조정 및 설정을 임계 경로에서 벗어나게 하는 푸시 기반 NIXL 커넥터를 소개합니다. vLLM으로 분리형 prefill/decode 추론을 실행하는 경우, 푸시 모드는 TTFT와 TPOT을 줄여 애플리케이션 응답성을 개선할 수 있으며, 특히 높은 요청 비율에서 그렇습니다.
EFA로 연결된 Amazon Elastic Compute Cloud(Amazon EC2) P5en 인스턴스를 사용하는 1P1D 배포 벤치마크에서, 푸시 모드는 Qwen3-32B 모델에 대해 풀 모드에 비해 최대 3배 더 나은 TTFT와 최대 30% 더 나은 time-per-output-token(TPOT)을 제공했습니다(성능 데이터 섹션 참조). 결과는 워크로드와 구성에 따라 달라집니다.
저희는 EFA로 연결된 AWS Trainium 인스턴스 클러스터에서 이 기능을 구축하고 검증한 뒤, 가속기에 구애받지 않는 기능으로 vLLM에 기여했습니다. 여기의 결과는 EFA가 연결된 Amazon EC2 P5en(GPU) 클러스터에서 얻은 것으로, 해당 성능 향상이 GPU로도 이어짐을 보여줍니다. 이 게시물에서는 푸시 기반 아키텍처, 전송 흐름, 스레딩 모델, 성능 결과 및 벤치마크 재현 방법을 설명합니다.
푸시 기반 KV 전송
이 섹션에서는 KV 전송을 임계 경로에서 벗어나게 유지하는 푸시 기반 설계의 아키텍처, 전송 프로토콜 및 스레딩 모델을 설명합니다.
아키텍처 개요
푸시 기반 전송이 TTFT와 디코딩 처리량을 개선하는 이유는 두 가지입니다:
- 풀 모델의 직렬화를 제거 하여 생산자와 소비자의 작업을 겹칩니다. 생산자가 아직 KV를 계산하는 동안 decode 인스턴스가 대상 블록을 미리 등록합니다. 그런 다음 소비자 측 ID 검색 왕복을 기다리지 않고 생산자의 블록이 준비되는 즉시 전송이 시작되어, 해당 왕복이 첫 번째 토큰에 이르는 경로에서 제거됩니다.
- 전송 설정 시간을 decode 인스턴스에서 옮깁니다. 그 설정은 prefill 측과 백그라운드 스레드에서 실행됩니다. NIXL 디스크립터를 준비하고 전송을 제출하므로, decode 인스턴스는 지연 시간에 민감한 토큰 생성 단계 동안 해당 사이클을 소비하지 않습니다.
순 효과는 디코드 인스턴스에서 TTFT가 낮아지고 출력 토큰 처리량이 높아지는 것입니다.
푸시 커넥터는 세 개의 주체를 조율합니다: 디코드 인스턴스는 대상 블록을 사전에 등록하고, 프리필 인스턴스는 각 요청을 매칭하여 전송을 발행하며, 전용 백그라운드 스레드가 KV 쓰기를 엔진의 포워드 패스 루프 밖으로 옮깁니다. 다음 다이어그램은 이러한 구성 요소들이 어떻게 맞물리는지 보여줍니다.
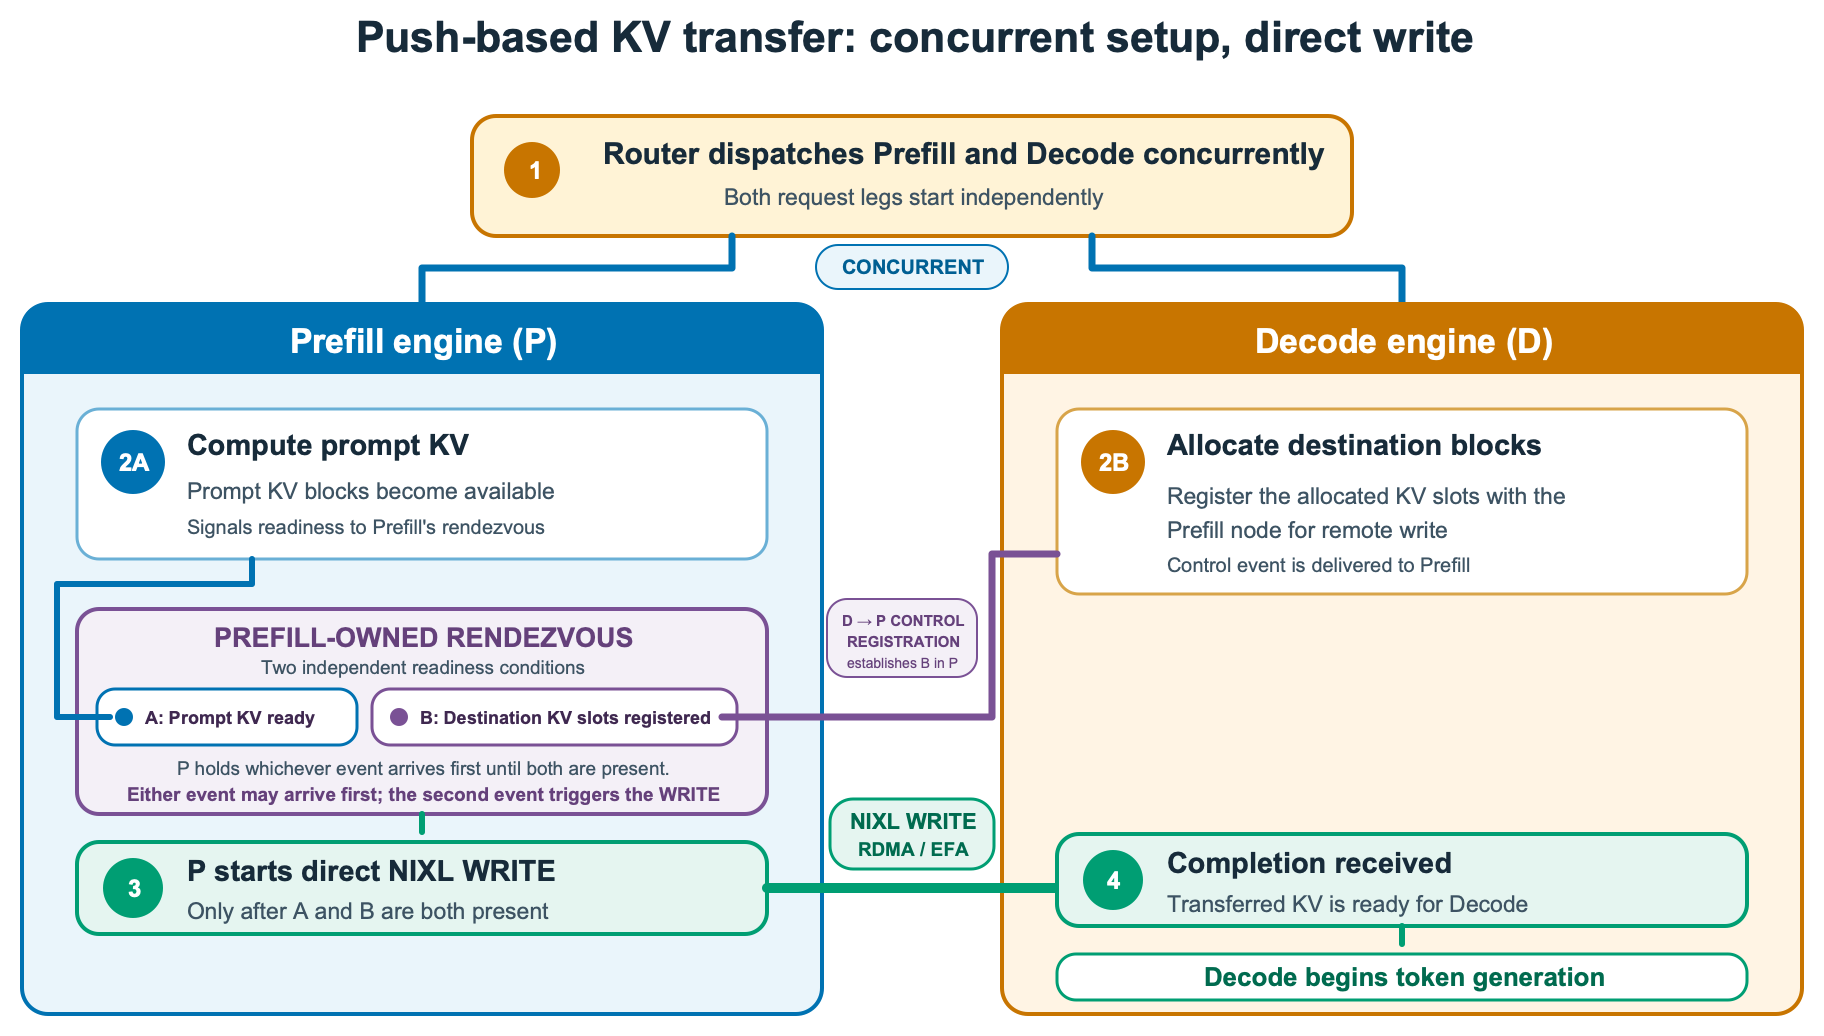
그림 2: 푸시 기반 KV 전송 아키텍처로, 디코드 인스턴스, 프리필 인스턴스, 백그라운드 전송 스레드가 어떻게 조율하는지 보여줍니다
구현 세부 사항
이 프로토콜에는 세 가지 논리적 단계가 있습니다.
1. 등록(디코드 측). 디코드 인스턴스가 원격 프리필링이 필요한 요청에 대해 로컬 블록을 할당할 때, 프리필 인스턴스가 KV를 써야 할 위치를 기술하는 등록 정보를 준비합니다. 여기에는 자신의 식별 정보와 방금 예약한 블록 위치가 포함됩니다. 동일한 엔진 스텝 내에서 워커는 이 등록 정보를 NIXL 알림으로 프리필 인스턴스에 전송합니다. 등록이 할당 시점에 이루어지기 때문에, 커넥터는 프리필 인스턴스가 프리필을 완료하기 전에 목적지 블록을 알 수 있습니다.
2. 랑데부(프리필 측). 디코더로부터의 등록 정보와 프로듀서에서의 프리필 완료는 어느 쪽이 먼저 도착할지 알 수 없으며, 커넥터는 두 경우 모두를 처리합니다. 등록 정보가 먼저 도착하면 프로듀서는 자신의 프리필이 끝날 때까지 이를 보관합니다. 프리필이 먼저 끝나면 프로듀서는 등록 정보가 도착할 때까지 요청의 블록을 보관합니다. 두 번째로 발생하는 이벤트가 전송을 트리거합니다. 커넥터는 ID로 요청을 매칭하며, 이 매칭은 재발행된 요청을 고려하여 선점되거나 재시도된 요청을 올바르게 연관시킵니다.
3. 전송(프리필 측). 요청이 매칭되면, 프로듀서는 디코드 인스턴스에 대한 연결을 설정하고(아직 존재하지 않는 경우) NIXL WRITE를 발행하여 KV 블록을 디코더의 등록된 메모리로 직접 복사하며, 각 목적지 텐서 병렬 랭크를 개별적으로 어드레싱합니다. 프로듀서와 컨슈머는 서로 다른 내부 블록 레이아웃을 사용할 수 있습니다. 각 측은 전송 시점에 블록 위치를 자신의 물리적 레이아웃에 매핑하므로, 양측에서 서로 다른 블록 크기를 사용할 수 있습니다. 각 WRITE는 완료 알림을 포함하며, NIXL은 데이터가 도착하면 이를 디코드 인스턴스에 전달합니다. 디코더는 이 알림들을 셉니다. 자신에게 쓰는 프로듀서 랭크당 하나씩입니다. 예상되는 모든 알림이 도착한 후에만 KV를 수신된 것으로 간주하며, 그 시점에 요청은 디코드 단계로 진행됩니다.
스레딩 모델
푸시 커넥터는 각 프리필 워커에서 전용 백그라운드 전송 스레드를 사용하여 모델 실행과 KV 전송 준비를 분리합니다. 요청이 시작될 때, 디코드 메인 루프는 목적지 KV 블록을 할당하고 프리필 인스턴스에 등록하는 한편, 프리필 메인 루프는 프롬프트 KV 캐시를 계산합니다. 목적지 등록과 프롬프트 KV가 모두 준비되면, 프리필 메인 루프는 KV 블록을 백그라운드 스레드에 넘기고 신속히 모델 실행으로 돌아갑니다.
백그라운드 스레드는 NIXL 연결을 설정하거나 재사용하고, 요청의 KV 블록 ID를 메모리 디스크립터에 매핑하며, 연속된 블록을 더 큰 전송 영역으로 병합하고, NIXL WRITE를 디코드 인스턴스에 제출합니다. NIXL이 전송을 완료하면 디코드 인스턴스에 완료 알림을 보내고, 디코드 인스턴스는 이후 토큰 생성을 시작합니다. 디스크립터 준비와 전송 제출을 지연에 민감한 메인 루프 밖으로 옮김으로써, 이러한 요청별 작업이 모델 실행을 지연시키지 않도록 합니다. 다음 다이어그램은 단일 요청에 대한 이러한 메인 루프와 백그라운드 스레드 간의 인계 과정을 보여줍니다.
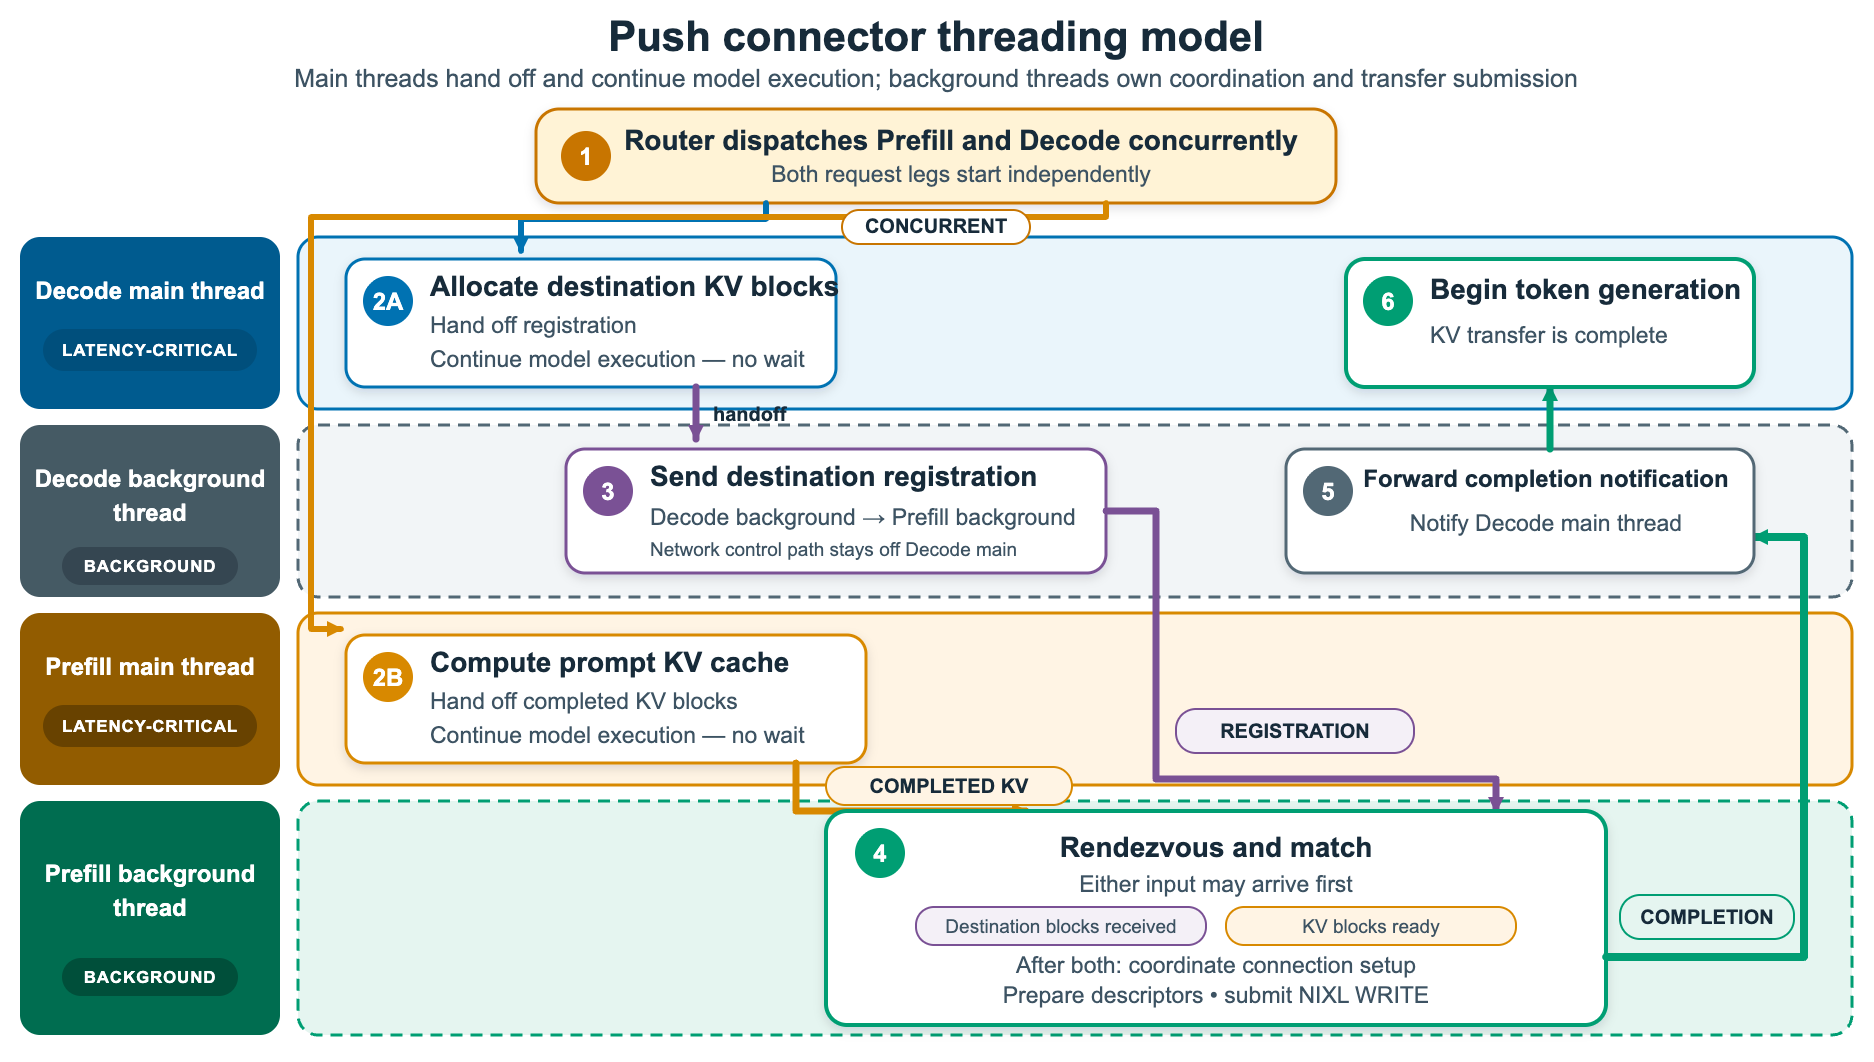
그림 3: 푸시 기반 스레딩 모델에서 단일 요청에 대한 메인 루프와 백그라운드 스레드 간의 인계
풀과 푸시의 타이밍 비교
다음 다이어그램은 앞 섹션에서 설명한 풀과 푸시 전송 흐름을 요약하고 TTFT에 미치는 영향을 강조합니다. 두 모드 모두 동일한 NIXL 및 EFA/RDMA 데이터 경로를 사용하지만, 풀은 프리필 이후에 메타데이터 릴레이와 디코드 측 설정을 수행하는 반면, 푸시는 디코드 측 설정을 프리필과 오버랩시킵니다. 그 결과, 푸시는 이러한 작업을 프리필 이후의 중요 경로에서 제거하여 디코딩이 더 일찍 시작될 수 있게 합니다.
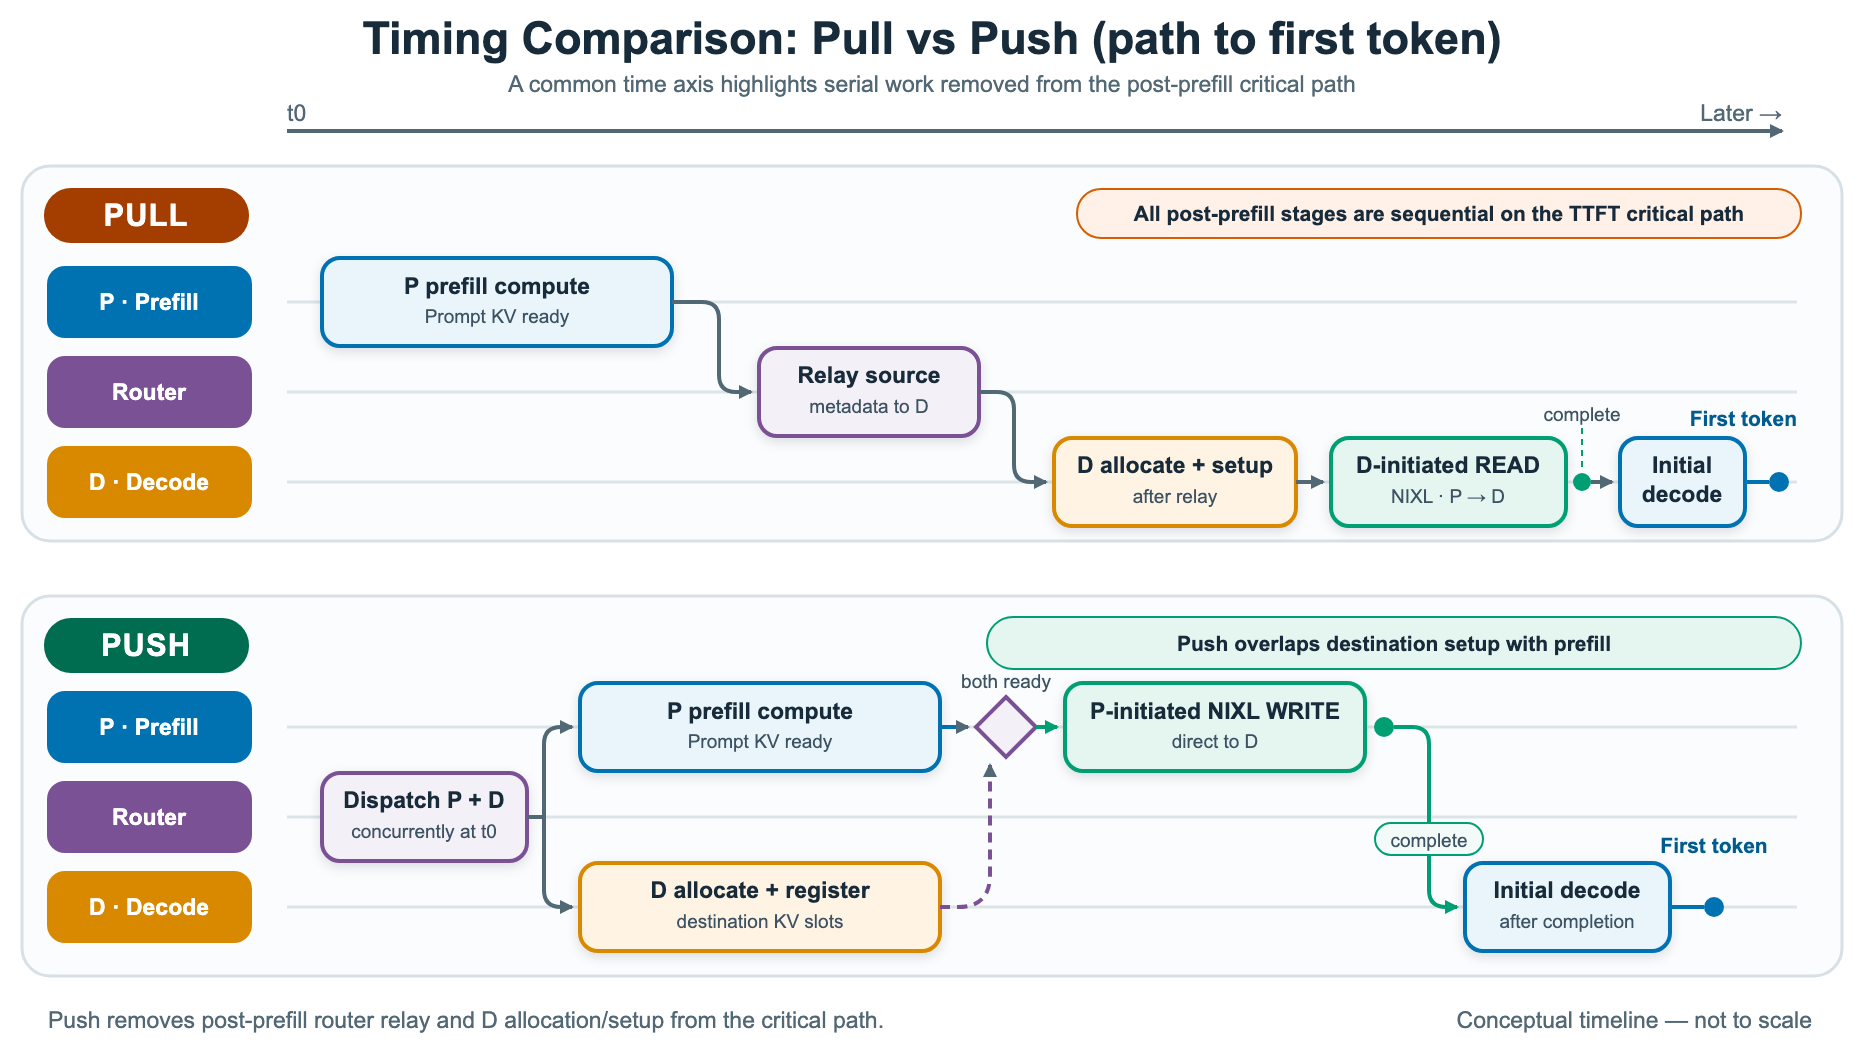
그림 4: 풀과 푸시 전송 흐름 비교. 푸시가 디코드 측 설정을 프리필과 오버랩시키는 방식을 강조
두 모드는 또한 라우팅 트레이드오프를 수반합니다. 풀 모드는 라우터가 프리필이 완료된 후에 디코드 인스턴스를 선택할 수 있게 하여, 부하 인식 라우팅과 서비스 품질 관리에 더 큰 유연성을 제공합니다. 푸시 모드는 목적지 설정이 프리필과 오버랩될 수 있도록 디코드 인스턴스를 더 일찍 선택합니다. 그 대가로, 유사한 부하 조건에서 프리필 인스턴스는 프롬프트 KV와 목적지 등록이 준비되는 즉시 전송이 시작되기 때문에 KV 블록을 더 일찍 해제할 수 있습니다.
성능 데이터
평가를 위해, 저희는 EFA로 연결된 Amazon EC2 P5en 인스턴스를 사용하는 1P1D 배포에서 Qwen3-32B 모델을 사용했습니다. P→D 전송 성능을 분리하기 위해, 벤치마크를 구성하여 다음을 통해 프리픽스 캐싱을 비활성화했습니다: --no-enable-prefix-caching. 이 구성은 디코드 노드가 모든 요청에 대해 프리필 노드에서 전체 KV 캐시를 검색하도록 만듭니다. 그렇지 않으면, 겹치는 프롬프트가 디코드 노드의 로컬 캐시를 재사용하여 전송을 우회할 수 있으며, 이는 오해의 소지가 있는 비교 결과를 낳을 것입니다.
다음 차트는 푸시 KV 전송과 풀 KV 전송의 TTFT를 비교합니다. 입력 길이 1k–16k와 요청 속도 초당 1–8개 쿼리(QPS)를 스윕했습니다. 낮은 부하와 짧은 프롬프트에서는 두 모드가 거의 동일하게 수행합니다. QPS와 입력 길이가 커짐에 따라, 풀 모드는 급격히 저하되어 8 QPS 및 16k에서 약 1,744 ms에 도달합니다. 푸시 모드는 약 540 ms로 훨씬 낮게 유지되며, 약 3배 감소에 해당합니다. 이 격차는 풀 모드가 NIXL 디스크립터를 디코드 워커에 엔진 루프 내에서 동기적으로 인라인으로 게시하기 때문에 발생하며, 그 작업이 토큰 생성을 정체시킵니다. 푸시 모드는 이를 백그라운드 스레드로 옮겨 중요 경로 밖에 둡니다.
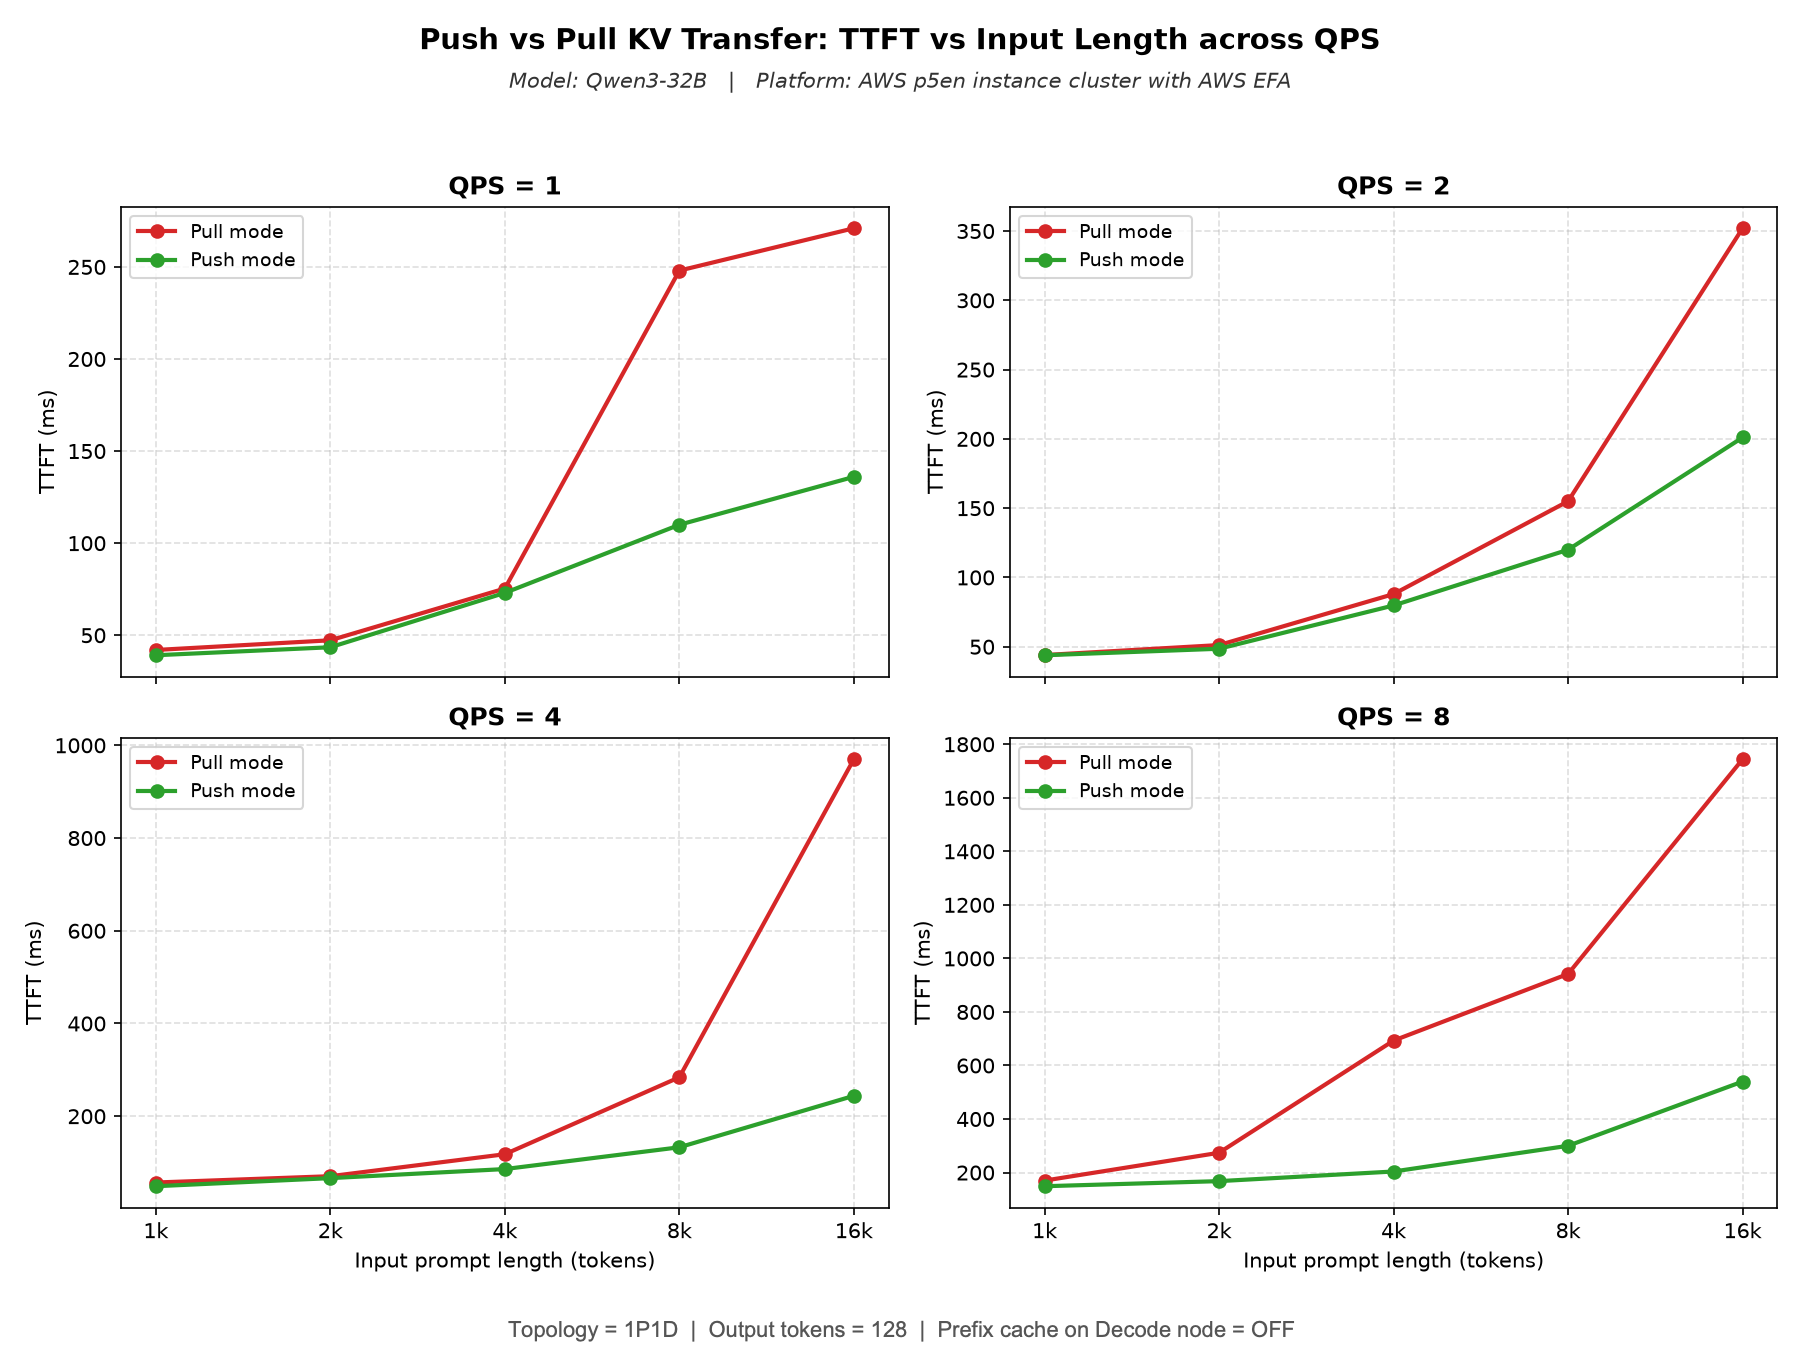
그림 5: 입력 길이와 요청 속도에 따른 푸시와 풀 KV 전송의 TTFT 비교(1P1D 토폴로지, 128 출력 토큰, 디코드 노드에서 프리픽스 캐싱 비활성화)
이 차트는 동일한 조건에서의 TPOT을 보여줍니다. 패턴은 TTFT와 유사합니다. 낮은 부하에서는 푸시와 풀이 5.6–5.8 ms 근처로 근접합니다. 부하와 입력 길이가 증가함에 따라, 풀은 4–8 QPS 및 16k에서 약 10.4 ms로 상승하는 반면, 푸시는 7 ms 근처를 유지합니다. 그 이유는 푸시가 디스크립터 준비와 전송 제출을 디코드 워커에서 오프로드하기 때문입니다. 토큰 생성이 굶주리지 않으므로, 높은 동시성과 긴 컨텍스트에서도 토큰당 지연 시간은 평탄하게 유지됩니다.
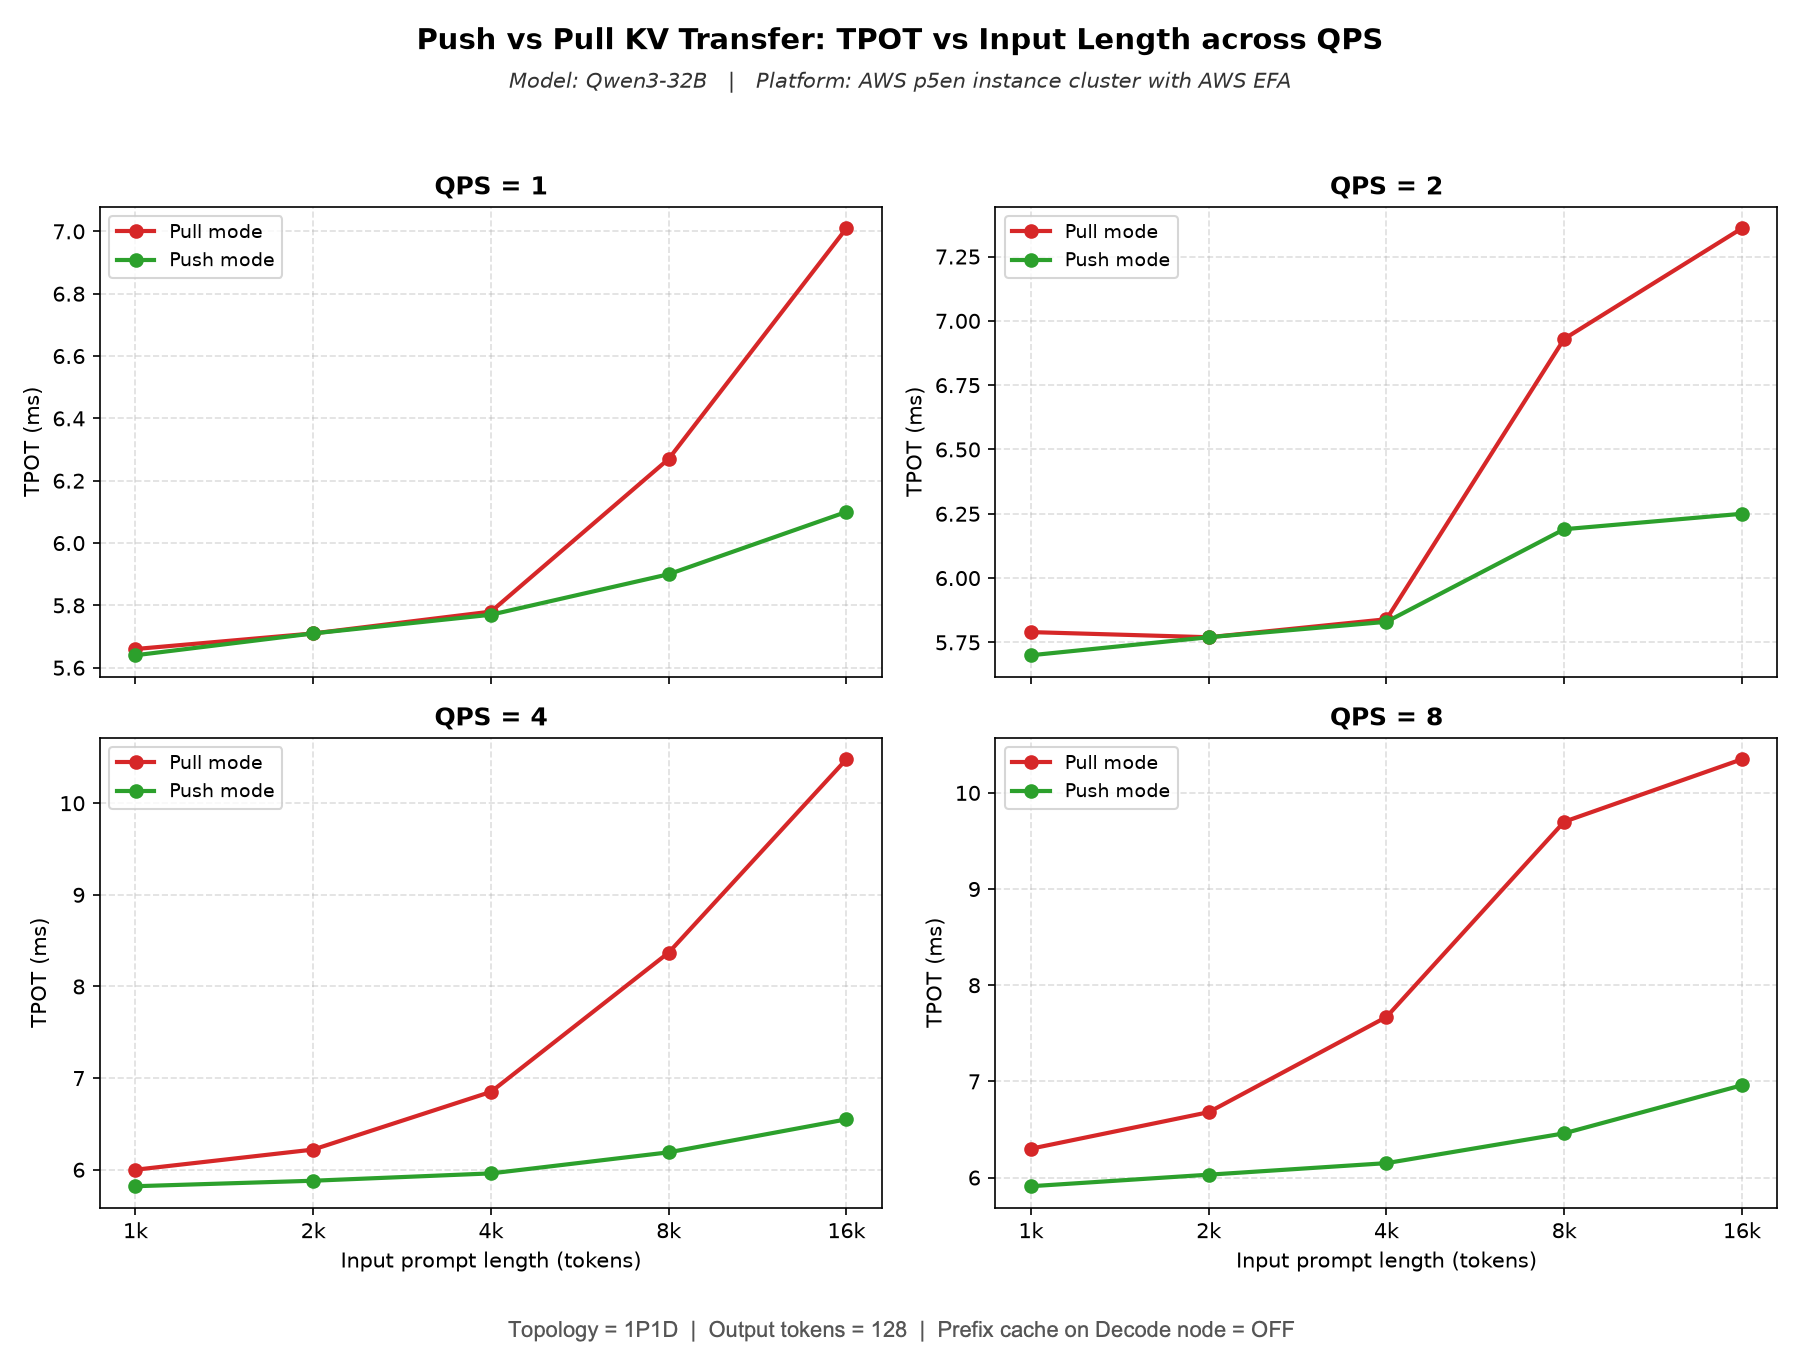
그림 6: 입력 길이 및 요청률에 따른 push 대 pull KV 전송의 TPOT 비교 (1P1D 토폴로지, 128 출력 토큰, 디코드 노드에서 prefix caching 비활성화)
벤치마크 실행 방법
1P1D 벤치마크 구성, 즉 EFA로 연결된 Amazon EC2 P5en 인스턴스를 사용하는 하나의 프리필 노드와 하나의 디코드 노드를 재현하려면 다음 문서의 자세한 지침을 참조하십시오. 우리의 결과 재현하기 가이드입니다. 이 가이드는 환경 설정, vLLM prefill 및 decode 서버 시작, 벤치마크 실행, 결과 수집 방법을 다룹니다. 이 기능은 다른 지원되는 구성에서도 실행할 수 있지만, 성능 결과는 하드웨어, 모델, 워크로드 및 네트워크 구성에 따라 달라집니다.
결론
이 게시물에서는 푸시 기반 KV 커넥터가 prefill 연산과 decode 측 블록 할당 및 등록을 겹쳐 수행하여, prefill 이후 라우터 왕복과 decode 측 전송 설정을 중요 경로(critical path)에서 제거하는 방법을 보여주었습니다. 이를 통해 TTFT와 TPOT이 감소하며, 특히 높은 요청 비율에서 그렇습니다. EFA로 연결된 Amazon EC2 P5en 인스턴스를 사용하는 1P1D 배포에서 진행한 Qwen3-32B 벤치마크에서, 푸시 모드는 풀 모드에 비해 TTFT에서 최대 3배 개선, TPOT에서 30퍼센트 개선을 제공했습니다. 결과는 워크로드와 구성에 따라 달라집니다. 푸시 모드를 사용하려면 prefill 서버와 decode 서버 모두 다음을 사용하도록 구성하십시오. NixlPushConnector 대신 NixlConnector.
초기 decode 노드 선택이 허용 가능하고 낮은 TTFT가 우선순위라면 푸시 기반 커넥터를 선택하십시오. 풀 기반 커넥터는 다음이 필요한 워크로드에는 여전히 더 적합합니다. 양방향 KV 전송 또는 부하 인식 라우팅을 위해 prefill 이후까지 decode 인스턴스 선택을 미루는 경우입니다. vLLM은 푸시 기반 및 풀 기반 KV 커넥터를 모두 지원하므로, 배포에 가장 적합한 방식을 선택할 수 있습니다.
향후 개선 과제로, 우리는 백그라운드 NIXL 스레딩 모델을 풀 모드 커넥터에 도입하여 NIXL 설정을 중요 경로에서 제외함으로써 풀 모드 워크로드도 동일한 최적화의 이점을 얻을 수 있도록 하는 방법을 연구하고 있습니다. 이를 탐색하기 위해 풀 리퀘스트 를 열었습니다.
관련 리소스
감사의 글
이 기능의 유지 보수에 대한 지원을 해주신 vLLM 커뮤니티에 감사드립니다.