
음성이 AI의 일급 모달리티가 되면서 Deepgram의 모델은 음성-텍스트 변환, 텍스트-음성 변환, 음성 에이전트를 아우릅니다. 현재 연간 200,000명 이상의 개발자와 1,400개 조직을 위해 수천조 개의 오디오 토큰을 처리합니다. 고객은 Deepgram API를 통해 이를 사용하거나 Amazon SageMaker AI를 포함한 자체 환경에서 실행합니다.
Deepgram에게 서빙 효율은 주어진 인프라 예산으로 시스템이 처리할 수 있는 오디오의 양을 결정합니다. 대용량 배치 워크로드는 이 예산에 큰 부담을 주므로, 가속기 시간을 효율적으로 사용할수록 Deepgram은 동일한 플릿에서 더 많은 오디오를 서빙할 수 있습니다. 그래서 추론 효율이 자연스러운 목표가 되었고, Deepgram은 이를 개선하기 위해 AWS AI 칩으로 눈을 돌렸습니다. Deepgram은 AWS와 협력하여 콜센터 분석 및 의료 전사와 같은 오프라인 배치 워크로드를 위해 Nova-3 음성-텍스트 변환 모델을 AWS Trainium2에 탑재했습니다.
이 협업은 Deepgram이 표준 PyTorch 코드로 Nova-3를 전달하는 것으로 시작되었습니다. 몇 달에 걸쳐 Deepgram과 AWS Forward Deployed Engineering (FDE) 팀은 Nova-3를 AWS Trainium2 로 PyTorch 재구성 방식으로 포팅하고 새로운 하드웨어에 맞게 튜닝했습니다. 최종 구성은 단일 Amazon Elastic Compute Cloud (Amazon EC2) trn2.3xlarge 인스턴스에서 8개의 모델 복제본을 실행합니다. Deepgram의 오프라인 처리량 지향 배치 워크로드에서 이 설정은 Deepgram이 기존에 사용하던 컴퓨팅 옵션 대비 달러당 11~70% 더 많은 오디오를 처리했습니다. 이는 평가 시점의 인스턴스 가격을 기준으로 측정한 값입니다. 이러한 이점은 Deepgram이 효율적으로 확장하고, 더 나은 모델을 계속 출시하며, 고객에게 더 낮은 가격으로 제공하는 데 도움이 됩니다. 이러한 혜택은 Amazon SageMaker AI에서 자체 가상 프라이빗 클라우드 (VPC)에 Deepgram 모델을 직접 호스팅하는 고객에게도 확장될 수 있습니다.そこ에서 Deepgram과 AWS는 설정 용이성, 안정성, 관찰 가능성을 계속 개선하고 있습니다.
이 게시물에서는 Trainium에서의 전체 추론 최적화 과정을 살펴봅니다. Nova-3를 AWS Neuron 소프트웨어 스택으로 포팅하기, 이후의 커널 수준 튜닝, Deepgram 자체 모델 서버가 Trainium을 호출할 수 있게 해주는 데이터 병렬 Rust 런타임, 그리고 배치 전사에서 측정한 처리량 및 비용 결과입니다.
네이티브 PyTorch로 Nova-3를 Trainium2에 최적화하기
표준 PyTorch 코드에서 시작하여, 우리는 Neuron Compiler의 네이티브 PyTorch 통합인 TorchNeuron을 사용했습니다. 이는 eager 실행과 torch.compile를 모두 지원합니다. 먼저 Trainium2에서 Nova-3를 eager 모드로 실행하여 어떤 연산이 CPU로 폴백되는지 확인한 후, torch.compile로 컴파일했습니다. 컴파일된 경로는 모든 모델 연산을 Trainium2에서 실행했으며 CPU 폴백은 감지되지 않았습니다.
우리는 torch.compile을 사용하여 인코더와 디코더를 별도의 정적 셰이프 그래프로 컴파일했습니다. 전체 과정에서 두 수준의 수치 정확도를 확인했습니다. CPU 대비 레이어 수준 출력 일관성, 그리고 Deepgram의 참조 값과 목표에 부합해야 하는 엔드투엔드 Word Error Rate (WER)였습니다.
이 작동하는 기준선으로부터, 우리는 공개 NKI Library (NKILib)의 퓨즈드 커널로 여러 레이어를 교체하여 최적화 작업을 시작했습니다. NKILib는 Neuron Kernel Interface (NKI)로 작성된 사전 구축 참조 커널 모음입니다. 이 커널들은 퓨즈드 QKV 프로젝션, 퓨즈드 피드포워드 네트워크 (FFN) 레이어, depthwise 1D 컨볼루션과 같은 연산을 다루었습니다.
우리는 처리량, 나아가 비용 효율을 목표로 최적화했으며, Deepgram의 오프라인 추론 워크로드를 대상으로 했습니다. 처리량은 초당 절대 처리 오디오량이 아니라 기준 구성 대비 상대적 증가로 보고되었으며, 처리량을 최대화하는 배치 크기를 찾기 위해 배치 크기 1~128을 탐색했습니다.
Neuron Explorer와 NAD를 사용한 커널 수준 튜닝
커널을 활성화하는 것은 최적화 플라이휠의 첫 번째 단계일 뿐입니다. NKI 커널(직접 작성하거나 NKILib에서 가져온 것)을 활성화하고, 워크로드를 프로파일링한 다음, 프로파일링 인사이트를 바탕으로 기존 커널을 튜닝하거나 새 커널로 교체합니다. 이 주기는 성능 목표가 달성될 때까지 반복됩니다. 각 단계에서 Neuron 스택의 서로 다른 부분이 작업을 가속화합니다. NKILib는 즉시 교체 가능한 커널을 제공하고, Neuron Explorer는 Neuron 워크로드 프로파일링을 위한 필수 도구이며, Neuron Agentic Development (NAD) 툴킷은 프로파일링 및 커널 작성 기능을 통해 프로파일링 분석과 커널 튜닝을 가속화합니다.
우리의 경우 NKILib 커널이 대부분의 작업을 해결해 주었고, 프로파일링을 통해 수작업으로 작성한 커널이 더 나은 성능을 낼 수 있는 부분이 어디인지 보여주었습니다. 매번 NAD 프로파일링 기능이 Neuron Explorer 프로파일을 근본 원인까지 연결해 주었고, NAD 커널 작성 기능이 교체 커널을 만드는 데 도움을 주었습니다.
| 레이어 | 발견한 내용과 변경 사항 | 개선 결과 |
| FFN | 참조 커널의 타일링 스케줄은 토큰 타일마다 오프칩 메모리에서 전체 프로젝션 가중치 세트를 다시 로드했기 때문에, 토큰 수가 증가함에 따라 메모리 대역폭이 처리량을 제한했습니다. 우리가 수작업으로 튜닝한 커널은 각 가중치 타일을 한 번만 로드하고 여러 토큰 타일에 걸쳐 재사용하며, 온칩 연산과 가중치 읽기를 파이프라인화합니다. | 배치 크기 96에서 참조 커널 대비 2.0배 낮은 지연 시간 |
| Depthwise conv1d | 실험적 NKILib 커널은 이 연산을 암시적 일반 행렬 곱 (GEMM)으로 처리했고, 이로 인해 Tensor Engine 활용도가 낮았습니다. 우리는 이를 Vector Engine에서의 브로드캐스트 곱셈-누산 루프로 재작성하여 엔진 활용도를 최대로 끌어올렸고, Vector Engine의 낮은 최대 처리량을 충분히 상쇄하고도 남는 성능을 얻었습니다. | 배치 크기 96에서 기준 커널 대비 1.5배 속도 향상 |
| Conv2d | 모델의 conv2d 레이어가 컴파일 병목에 부딪혔습니다: 배치 크기 32를 넘어서면 이러한 레이어들이 모델이 단일 그래프로 컴파일되는 것을 막았습니다. NKILib에는 conv2d 커널이 없었기 때문에, 우리는 NKI로 처음부터 직접 작성했습니다. 이 커널은 앞서 설명한 플라이휠을 따라 프로파일러 정보에 기반한 여러 차례의 반복 개선을 거쳤고, 그 결과 배치 크기 32 이상을 사용할 수 있게 되었습니다. | 배치 크기 ≤32에서 컨볼루션 모듈의 경우 최대 50배 |
Rust로 작성된 데이터 병렬 런타임
각 Trainium2 디바이스는 8개의 물리적 NeuronCore를 갖추고 있으며, 기본적으로 4개의 논리적 NeuronCore(LNC2)로 노출됩니다. 각 Nova-3 모델 인스턴스가 단일 물리적 코어에 충분히 들어가기 때문에, 논리적 코어당 물리적 코어 수를 1개(LNC1)로 줄였습니다. 이 구성을 통해 Trainium2 디바이스당 8개의 모델 레플리카(DP8)를 호스팅할 수 있습니다. 입력은 디바이스당 처리량을 최대화하면서 동시에 처리됩니다. 데이터 병렬 런타임은 레플리카당 하나의 스레드를 가진 work-stealing 큐에 의해 구동됩니다.
Deepgram의 프로덕션 서빙 스택은 Rust로 작성되었으므로, Nova-3를 Trainium2로 포팅하는 일은 단순히 모델을 컴파일하는 것 이상을 요구했습니다. 즉, 서빙 경로에서 Python이나 PyTorch 없이 실행되어야 했습니다. 그래서 우리는 Rust가 공유 work-stealing 큐를 통해 모델 복제본들을 조정하는 경량 런타임을 구축했습니다. C 레이어는 사전 컴파일된 Neuron Executable File Format(NEFFs)을 Neuron Runtime API(libnrt)를 통해 직접 로드하고 실행합니다. 이 런타임은 Deepgram의 서빙 아키텍처와 직접 통합되며, 테스트된 모든 배치 크기에서 참조 토큰 시퀀스를 정확히 재현했습니다.
우리는 이를 멀티스레드(MT) 및 멀티프로세싱(MP) Python 데이터 병렬 런타임과 벤치마크했습니다. MP 베이스라인과 비교했을 때, Rust 런타임은 Python 인터프리터의 오버헤드를 완전히 제거합니다. MT 베이스라인과 비교했을 때는 전역 인터프리터 잠금(GIL) 직렬화를 더욱 완화하여, 동시 워커 스레드의 디스패치 호출이 단일 프로세스 내에서 더 이상 경합하지 않습니다. 이러한 이득이 중요한 이유는 Nova-3가 각 오디오 청크마다 일련의 작은 디코더 호출을 수행하기 때문에, 낮은 배치 크기에서는 호스트 측 디스패치가 병목이 되기 때문입니다. 따라서 처리량 개선은 낮은 배치 크기에서 가장 크며, 처리량을 최대화하는 배치 크기에서도 의미 있는 수준을 유지합니다. 그 지점에서 Rust 런타임은 멀티프로세싱 Python 베이스라인 대비 7.5%의 처리량 향상을 달성했습니다.
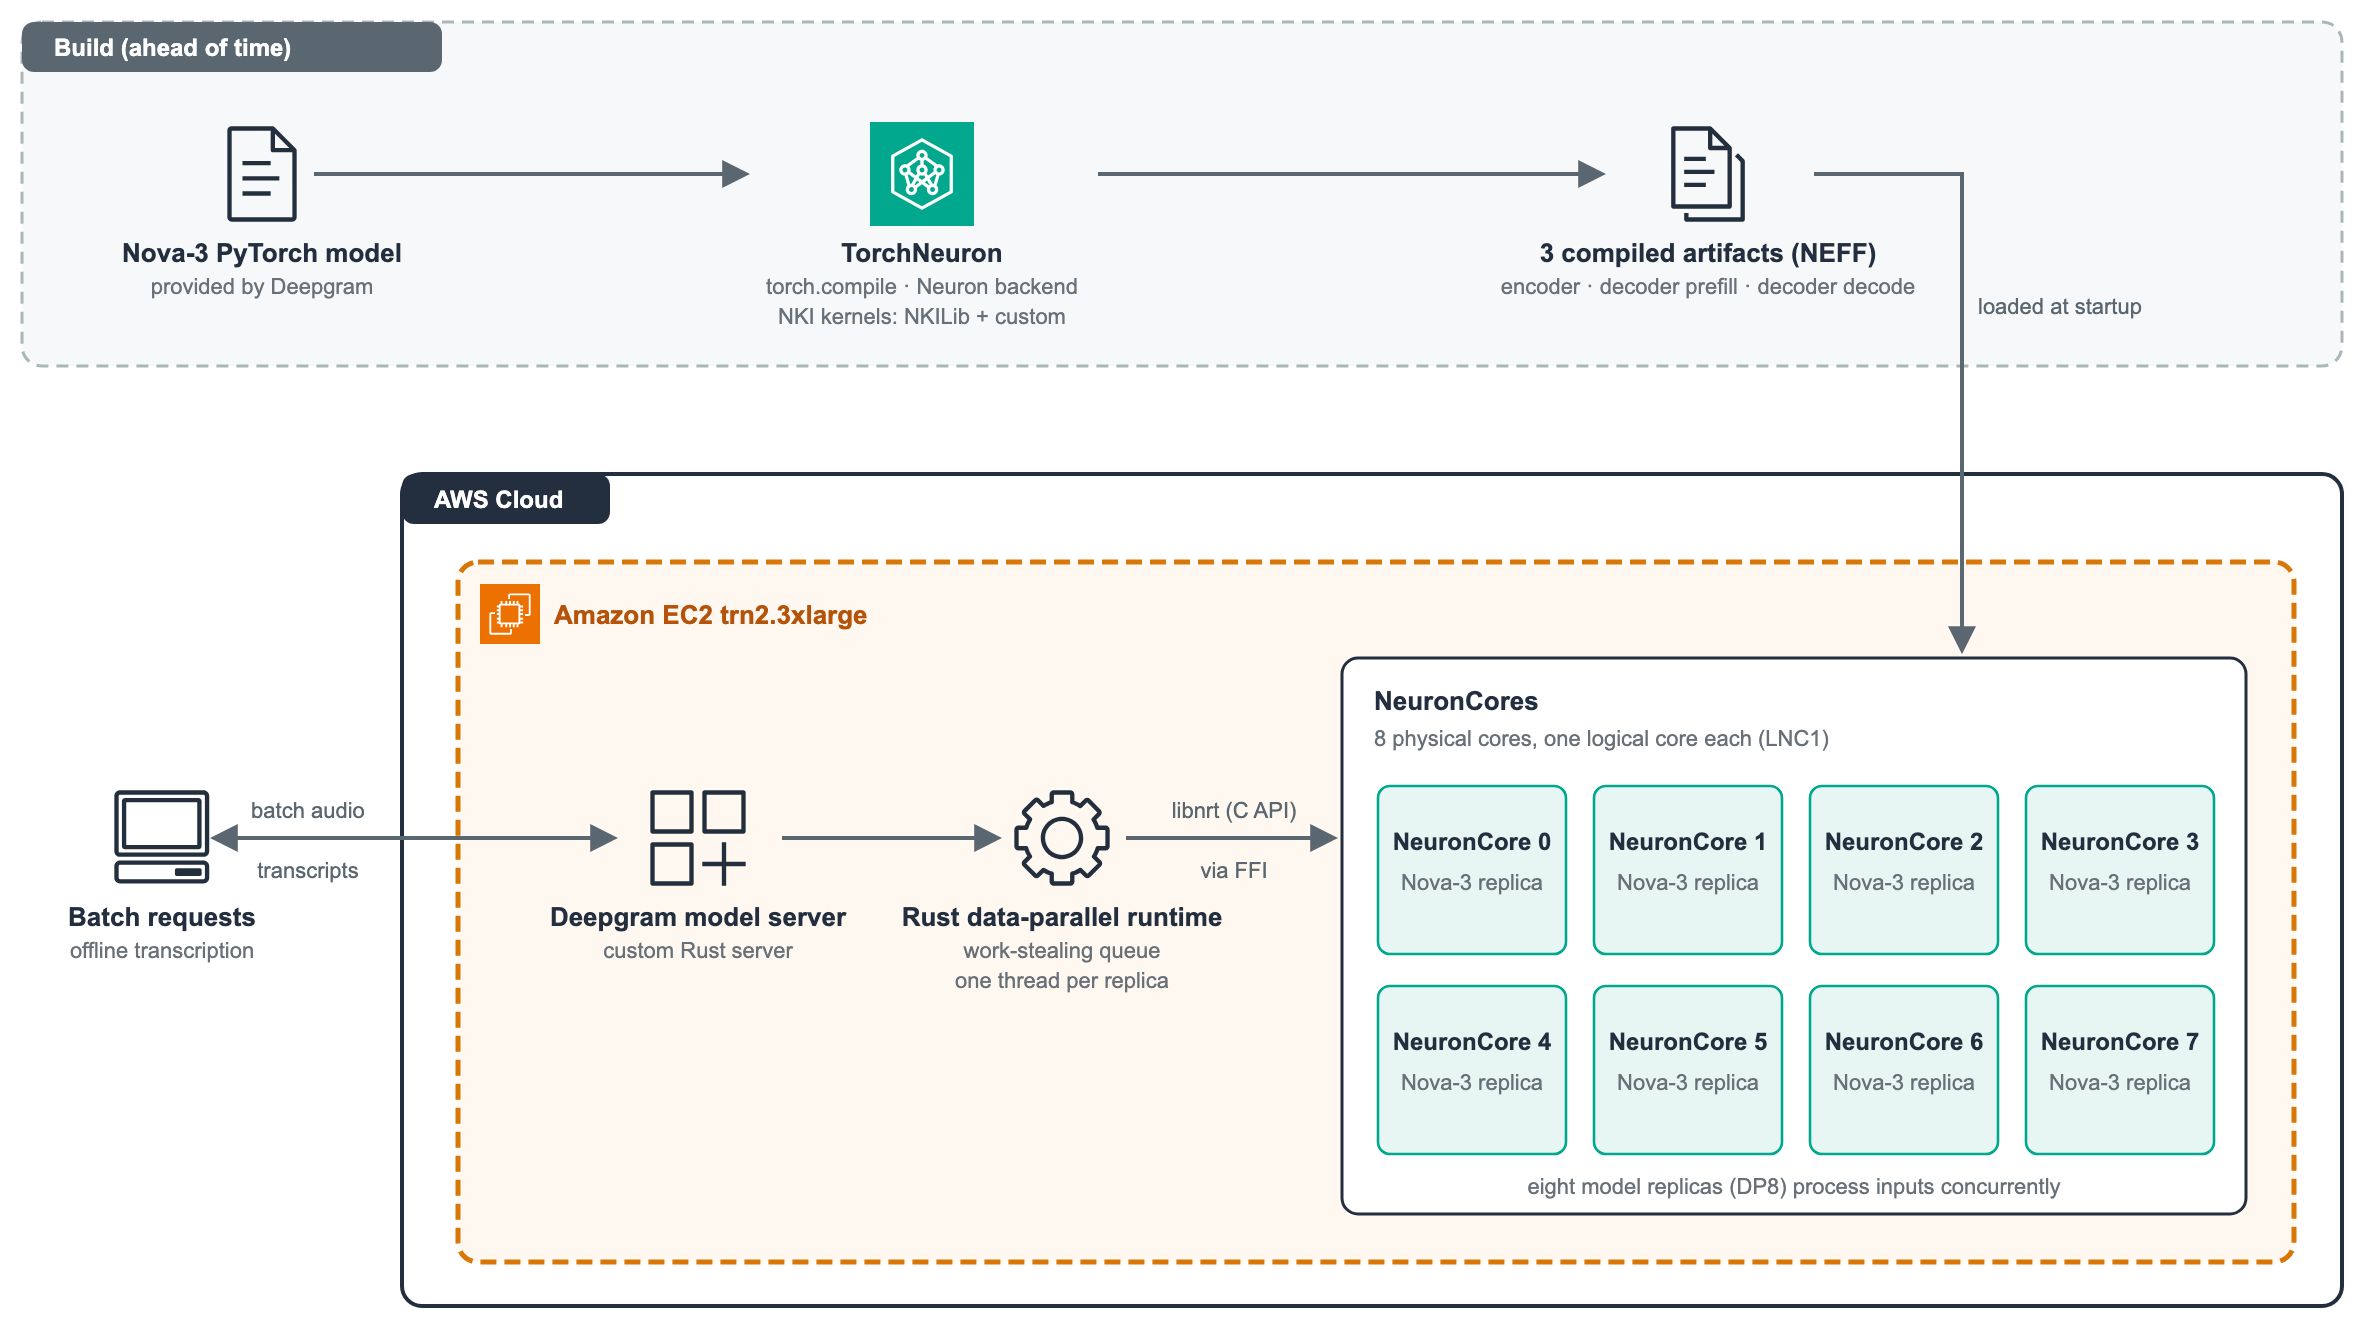
그림 1: AWS Trainium2에서 사전 컴파일되어 Rust로부터 서빙되는 Deepgram Nova-3
비용 절감 효과
우리는 달러당 처리한 오디오량으로 가격 대비 성능을 측정했습니다. Deepgram의 오프라인 처리량 지향 배치 워크로드에서 단일 디바이스 Trainium2 구성(trn2.3xlarge)은 Deepgram이 기존에 사용하던 컴퓨팅 옵션보다 달러당 11~70% 더 많은 오디오를 처리했습니다.
결론
이 게시물에서 우리는 AWS Trainium을 위한 네이티브 PyTorch 프레임워크 통합을 제공하는 TorchNeuron을 사용하여 Deepgram과 AWS FDE가 Nova-3 음성-텍스트 PyTorch 모델을 Trainium 하드웨어로 포팅하는 방법을 시연했습니다. 우리는 NKILib의 사전 빌드된 커널로 레이어를 직접 교체하여 성능을 개선했습니다. 그런 다음 Neuron Explorer를 사용하여 성능을 평가하고, Neuron Agentic Development(NAD) 프로파일링 스킬을 활용하여 프로파일링 데이터를 조회하고 성능 문제 해결을 가속화했습니다. 이러한 인사이트를 바탕으로 NAD 커널 작성 스킬을 사용하여 커널 소스 코드를 수정했습니다. 마지막으로 Rust에서 Neuron Runtime API를 호출하는 경량 Rust 데이터 병렬 런타임을 AWS Trainium용으로 구축했습니다. 우리의 구성은 오프라인 처리량 지향 시나리오에서 비용 절감을 입증했으며, AWS Trainium이 Deepgram의 추론 워크로드에 viable하고 효율적인 선택지임을 검증했습니다.
자신의 모델에 이 접근 방식을 적용해 보려면 다음에서 시작하세요: AWS Neuron 문서에는 컴파일러, 런타임 및 지원되는 프레임워크가 다루어져 있습니다. Neuron Kernel Interface(NKI) 가이드 에서는 이 게시물에서 설명한 커널을 작성하는 방법을 설명하고, NKI 샘플 저장소 에는 우리가 시작점으로 삼은 참조 커널이 있습니다. Neuron 개발자 도구 문서 에는 여기서 사용한 프로파일링 및 에이전트 도구(Neuron Explorer와 Neuron Agentic Development 포함)가 다루어져 있습니다. 인스턴스 크기와 가격은 Amazon EC2 Trn2 Instances를 참조하세요. 유사한 포팅 작업의 범위 설정에 도움이 필요하면 AWS Forward Deployed Engineering에 문의하십시오.