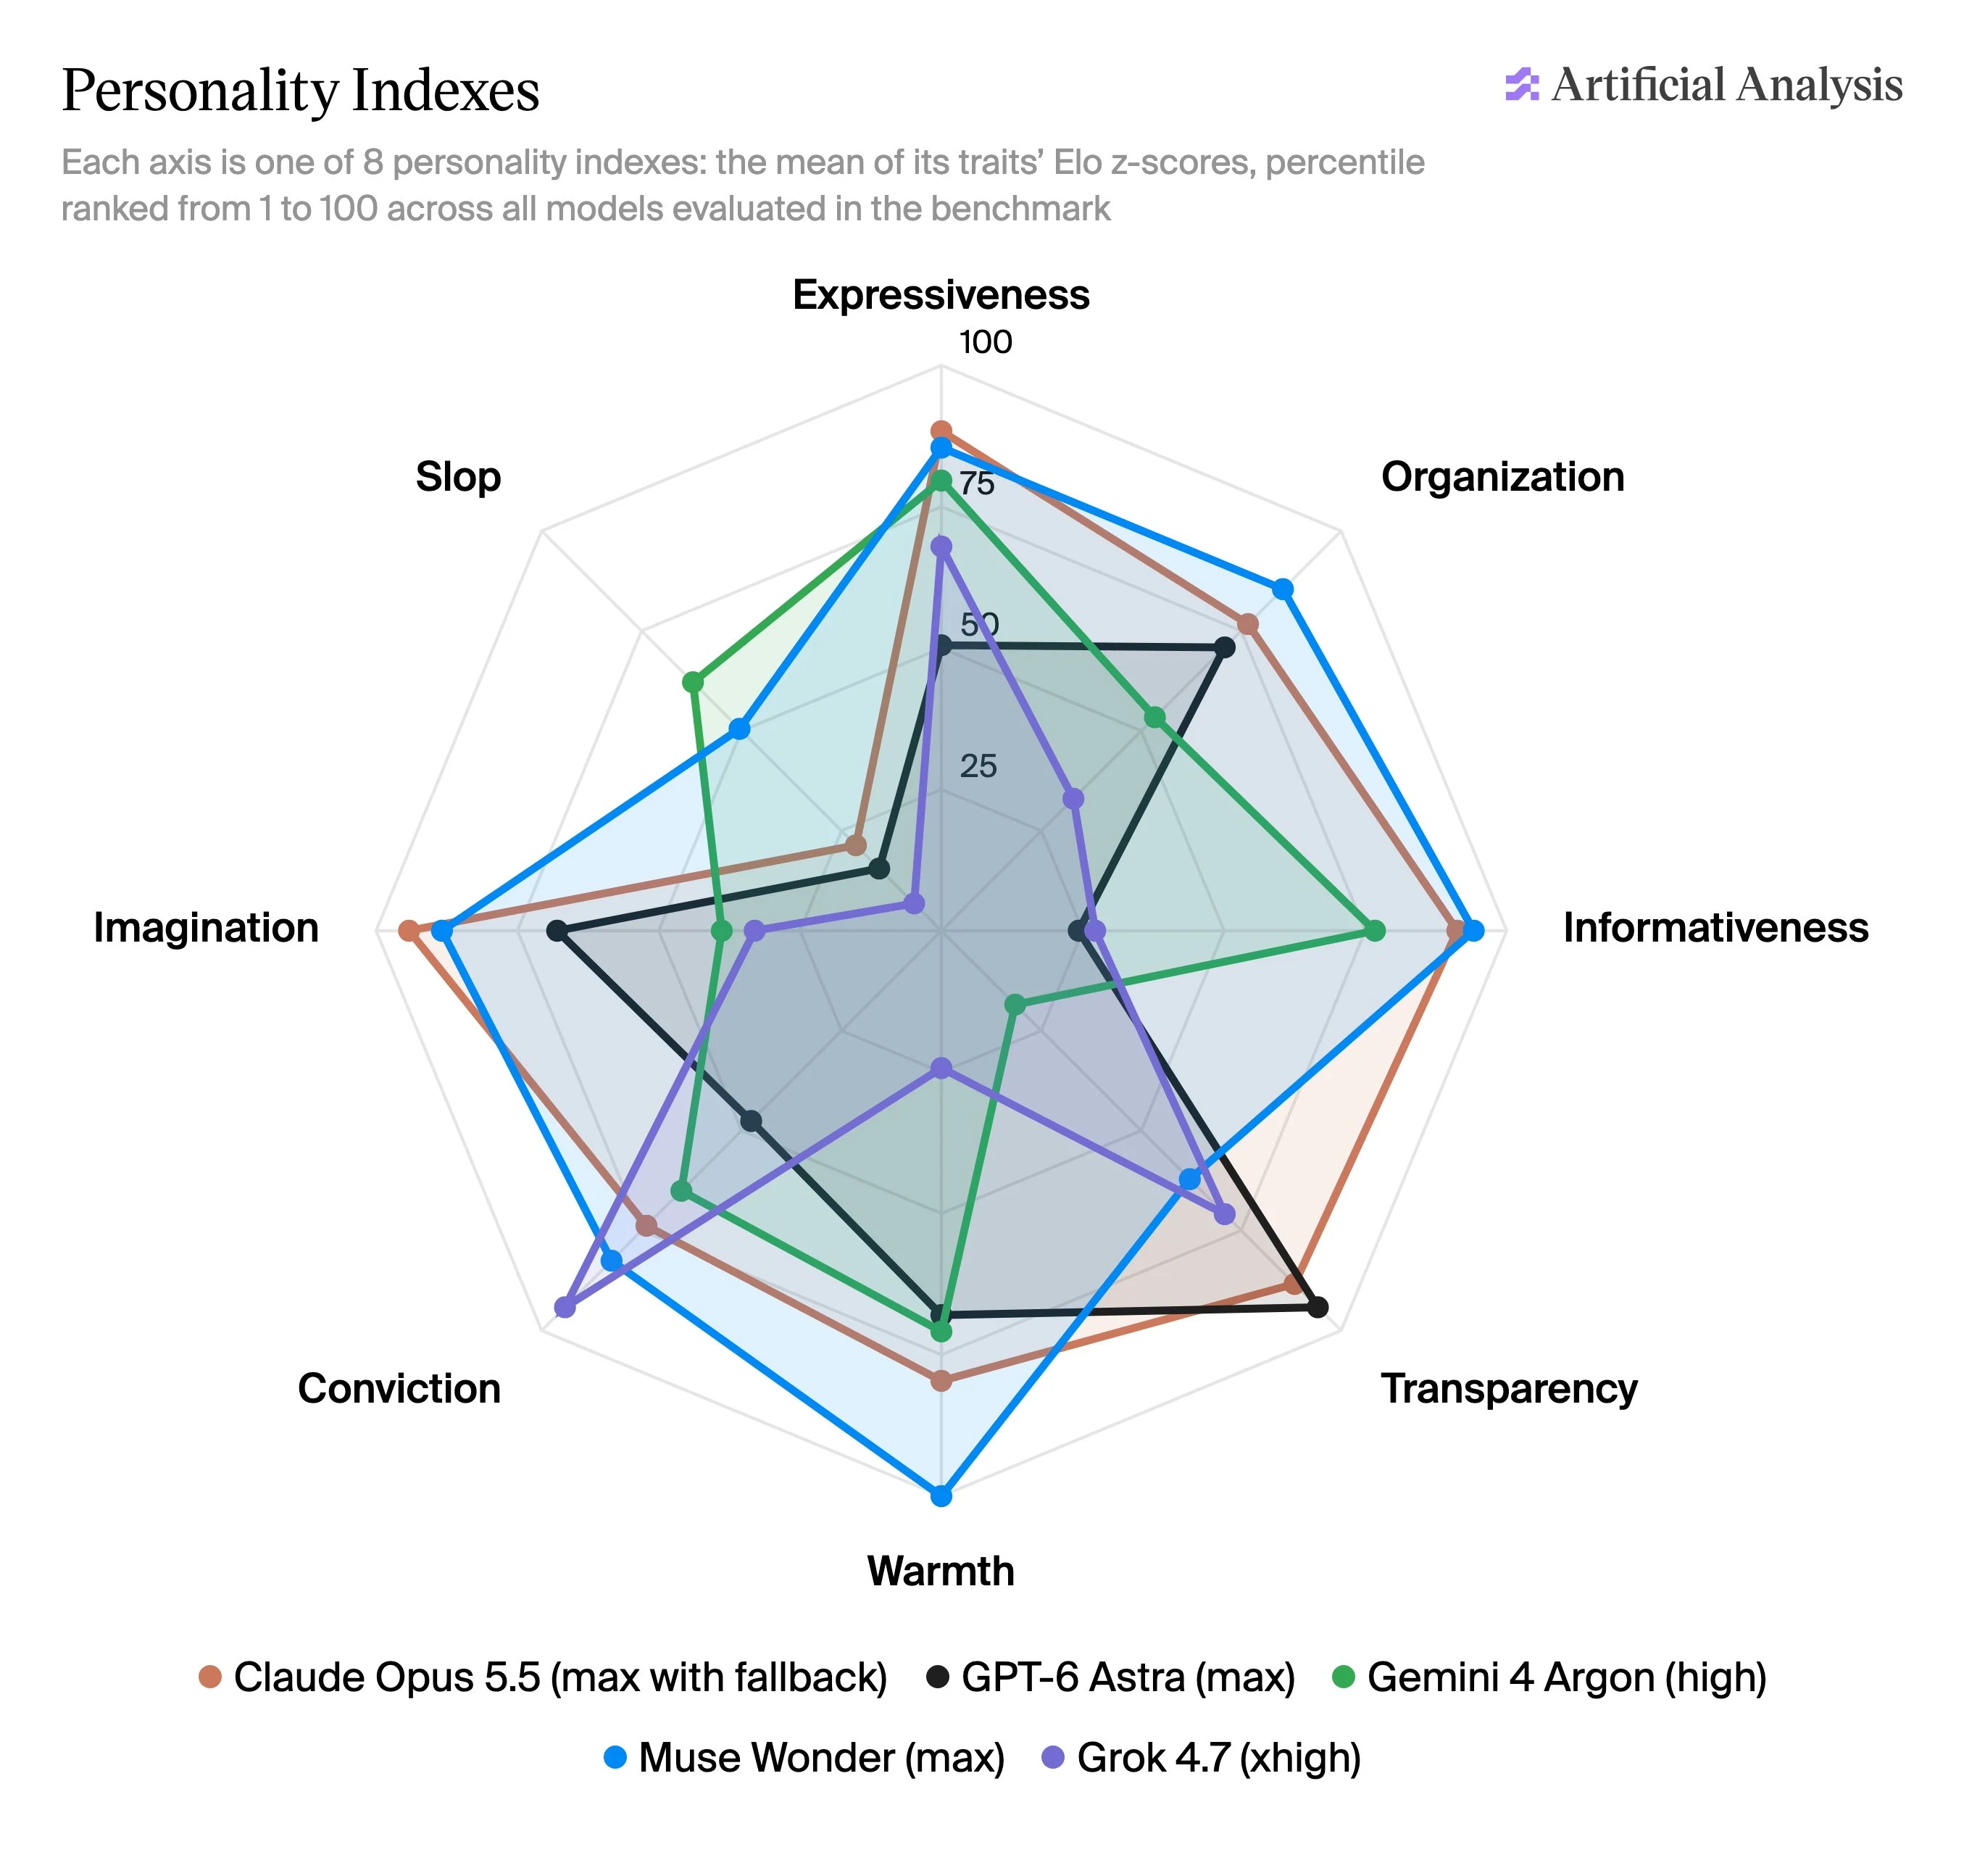
AA-PersonalityBench를 발표합니다. 30가지 특성에 걸친 언어 모델의 성격과 21가지 특성에 걸친 커뮤니케이션 스타일을 측정하는 저희의 새로운 벤치마크입니다
두 모델가 똑같이 정확한 답변을 주더라도 사용할 때 느낌은 매우 다를 수 있습니다. AA-PersonalityBench는 이러한 차이를 측정하여 사람들이 다양한 사용 사례에서 어떤 모델을 사용할지 이해할 수 있도록 합니다. 창작과 같은 일부 사용 사례는 상상력을 요구할 수 있고, 법률 사용 사례는 직접성을 요구할 수 있습니다. 저희는 주관적인 성격 특성을 판단하기 위해 900개의 엄선된 질문에 대한 모델의 답변을 평가하고, 프로그래밍 방식으로 객관적인 커뮤니케이션 특성을 계산합니다.
성격 특성 및 지수. 30가지 성격 특성(예: 웅변적, 실용적, 아첨하는)이 있으며, 이를 8개의 종합 성격 지수로 묶습니다: 표현력, 조직성, 정보성, 투명성, 따뜻함, 확신, 상상력, Slop. 각 특성에는 30개의 전용 질문 세트가 있으며, LLM 심사위원 패널이 모델의 답변을 쌍별로 비교합니다. 그런 다음 특성 및 성격 Elo에 대해 z-점수 및 백분위 순위를 매깁니다.
8개 성격 지수에서 가장 강한 대표성을 보이는 모델:
➤ 표현력: Claude Fable 5.1, GLM-5.3, GLM-5.3-Flash
➤ 조직성: DeepSeek V4.1 Flash, Step 5 Preview, Inkling
➤ 정보성: Muse Spark 1.3, Claude Fable 5.1, Muse Wonder, Claude Opus 5.5
➤ 투명성: Claude Sonnet 5.5, Claude Fable 5.1, GPT-6 Astra
➤ 따뜻함: Muse Wonder, Muse Spark 1.3, Claude Fable 5.1
➤ 확신: Claude Fable 5.1, DeepSeek V4.1 Flash, Grok 4.7
➤ 상상력: Muse Spark 1.3, Claude Opus 5.5, GLM-5.3
➤ Slop: Llama 4 Maverick, GPT-4o, K2 Horizon
커뮤니케이션 특성. 21가지 커뮤니케이션 특성(예: 평균 문장 길이, 이모지 사용, 엠 대시 사용)이 있으며, 이를 길이, 구조, 문장부호, 강조의 네 가지 범주로 묶습니다. 저희는 모든 모델 응답에 걸쳐 이러한 특성을 프로그래밍 방식으로 계산합니다.
➤ 길이: Qwen3.8 27B는 응답당 평균 약 1,030단어로, GPT-6 Luna의 270의 거의 4배입니다
➤ 구조: Nemotron 3 Ultra는 응답당 평균 거의 3개의 표를 사용하는 반면, 대부분의 모델은 표를 거의 사용하지 않습니다
➤ 문장부호: GLM-5.3은 응답당 평균 7개의 엠 대시를 사용하는 반면, Claude Opus 5.5, Sonnet 5.5 및 Haiku 5.5는 거의 사용하지 않습니다
➤ 강조: K2 Horizon은 응답당 평균 2개 이상의 이모지를 사용하는 반면, 대부분의 모델은 거의 사용하지 않습니다