
TorchNeuron은 AWS Trainium에서 PyTorch의 새로운 네이티브 백엔드를 제공합니다. Transformers, Diffusers 및 Kernels이 기본적으로 이를 지원하므로, Trainium에서 모델을 실행하고 HF 허브에서 공유하는 것이 이전보다 훨씬 쉬워집니다.
TorchNeuron
TorchNeuron는 Trainium에 새로운 백엔드를 제공하는 PyTorch 플러그인으로, 에이지 모드, torch.compile 및 FSDP와 TP와 같은 네이티브 분산 API를 지원합니다.
TorchNeuron에 대한 더 많은 정보는 Pytorch 블로그를 참조하세요.
2026년 10월 20일부터 TorchNeuron은 공개 베타 버전으로 제공될 예정입니다. 연구자와 개발자는 pip install torch-neuronx를 통해 이를 설치할 수 있습니다.
새로운 백엔드, HF 라이브러리 내의 네이티브 인터페이스
지금까지 AWS Trainium 및 Inferentia에서의 Hugging Face 경험은 — 각각 저비용으로 대규모 학습 및 인출을 위해 설계된 AI 칩들 — optimum-neuron를 통해 제공되었습니다. 이 라이브러리는 torch-neuronx 패키지에 의존하며, 이는 PyTorch XLA를 기반으로 합니다. 당시에는 자연스러운 선택이었지만, 컴파일러처럼 생각해야 했습니다: 즉각적인 실행 대신 지연된 텐서, 정적 형태만 허용, 모든 그래프가 끊기면 재컴파일이 필요했습니다. Optimum Neuron은 그러한 복잡성을 숨기기 위해 존재했으며, 모델링 클래스, 트레이너 등의 맞춤형 코드를 유지하여 이를 가능하게 했습니다.
TorchNeuron은 이를 변경합니다. PyTorch에 직접 통합되어 neuron를 네이티브 장치로 제공하며, 에어리어 리턴 처리, PyTorch의 자체 분산 원시 데이터(DTensor, FSDP2) 및 torch.compile 기능을 지원합니다.
Hugging Face 라이브러리의 경우, Trainium은 다른 장치와 마찬가지로 작동합니다. Transformers, Diffusers, Accelerate, PEFT 및 TRL이 다른 액셀레이터에서 사용하는 것과 동일한 클래스와 스크립트를 사용하여 직접 실행됩니다. 이제부터 Neuron 사용자들은 Optimum Neuron을 거치지 않고 이 라이브러리들을 직접 사용하는 것을 권장합니다.
트랜스포머
인ферें스
텍스트 생성은 이제 Transformers에서 다양한 모델에 내장되어 지원됩니다. TorchNeuron을 사용하면 상위 100개의 가장 많이 사용되는 텍스트 생성 모델 아키텍처 중 89%가 기본적으로 지원되며, Optimum Neuron v0.4.5에서는 46%만이 지원됩니다. 코드에 device_map=neuron 매개변수를 전달하기만 하면 모델이 Neuron 장치로 이동됩니다.
다음은 텐서 병렬성으로 텍스트 생성의 예시입니다. 이를 통해 Neuron 인스턴스를 최대한 활용할 수 있습니다. Neuron에서는 자주 재컴파일링을 방지하기 위해 정적 캐시를 사용하므로 이를 강력히 권장합니다.
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
훈련
이제 Neuron은 네이티브 PyTorch 장치이므로, Trainium에서 훈련할 때 다른 가속기와 마찬가지로 Hugging Face 라이브러리인 Transformers, Accelerate, PEFT 및 TRL을 사용합니다. 더 이상 전용 훈련기나 Neuron에 특화된 모델 코드 포크가 필요하지 않습니다. 표준적인 TRL 미세조정 스크립트는 몇 가지 Neuron에 특화된 설정만으로 Trainium 인스턴스에서 실행됩니다.
TRL의 SFTTrainer를 기반으로 구축된 감독형 미세조정 스크립트입니다. 이전에 GPU를 사용하여 TRL로 모델을 미세조정한 경험이 있다면 익숙할 것입니다.
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser


def main(script_args, training_args, model_args):
    # The Neuron backend can't compile Dynamo's automatic dynamic shapes yet (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # The model is sharded on the TP x FSDP grid as its weights are loaded
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # Prepare dataset
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat also has a string `prompt` column, which makes TRL treat it as a prompt-completion dataset.
    train_dataset = train_dataset.select_columns(["messages"])

    # Training
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()


if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
병렬 처리는 Transformers에 내장되어 있습니다. DistributedConfig를 model_init_kwargs에 Tensor-Parallel(TP) 및 FSDP 크기로 설정하고, SFTTrainer는 이를 from_pretrained에 전달합니다. 모델의 가중치가 로드될 때마다 모델이 분산되어 저장됩니다. Trainer는 모델이 이미 분산된 상태임을 알고 있어 다시 묶지 않습니다. --fsdp 플래그나 Accelerate FSDP 설정을 필요로 하지 않습니다.
스크립트에는 Trainium과 관련된 내용이 전혀 없습니다. 동일한 코드는 어떤 하드웨어에서도 작동합니다. Trainium에서 실행할 때 알아두면 좋은 몇 가지 사항이 있습니다.
- 정적 형태. 스크립트는
torch.compile에서 자동 동적 형태를 비활성화하고 래핑 패킹 방식을 사용하여 최대 2048개의 토큰을 포함하는 시퀀스를 생성합니다. TRL ≥ 1.16일 때, Neuron에서의 배치는 128개 토큰의 배수로 채워져 입력 형태의 수가 제한됩니다. 컴파일된 그래프는 동일한 형태로 후속 단계에서 재사용됩니다. torch.compile온. 전달--torch_compile true그게 전부입니다: Trainium 인스턴스에서.torch.compile장치를 감지하고 Neuron 백엔드를 자동으로 선택하며, 추가 설정이 필요하지 않습니다.- 비동기 무게 로딩이 해제되었습니다. Transformers의 내장 비동기 무게 로딩 기능은 Neuron에서는 지원되지 않으므로, 현재는
HF_DEACTIVATE_ASYNC_LOAD=1로 이 기능을 비활성화합니다.
아래 명령은 torchrun를 사용하여 훈련을 시작하며, 각 NeuronCore에 하나의 프로세스가 실행됩니다. TP_SIZE와 FSDP_SIZE는 병렬 처리 구조를 결정하며, 이 두 값의 곱이 프로세스 수입니다. 여기서는 4 x 8 = 32로, --nproc_per_node와 일치합니다. 32개의 프로세스는 4 x 8 그리드를 형성합니다. 텐서 병렬 처리는 각 레이어를 TP 그룹의 4개 코어에 분배하며, FSDP는 매개변수, 그래디엄, 옵티마이저 상태를 8개의 TP 그룹에 분산시킵니다.
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
8개의 Trainium2 칩(32개의 NeuronCores)으로 실행했으며, 이는 trn2.48xlarge 인스턴스의 절반에 해당합니다.
훈련이 완료되면 trainer.save_model이 표준 Transformers 체크포인트를 저장합니다. 이 파일에는 Neuron과 관련된 내용이 전혀 없습니다. Hugging Face Hub에 그대로 업로드하여 다른 하드웨어에서 불러오는 것도 가능합니다.
디프러스어스
인퍼넨스
Diffusers 라이브러리의 많은 파이프라인은 에어리스 및 컴파일된 모드에서 TorchNeuron과 호환됩니다. FLUX.1-dev, FLUX.2, Qwen-Image, Qwen-Image-2.1 및 H3도 Tensor 병렬성과 호환되어 Neuron 장비를 최대한 활용할 수 있습니다. 다음은 TP를 사용하는 방법을 보여주는 예시입니다.
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# Distributed devices initialization
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# Pipeline initialization
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# Image generation
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder stays on CPU
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # same noise on every rank
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
이 코드를 다음과 같이 실행할 수 있습니다: NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py.
점점 더 많은 파이프라인들이 TP와 호환될 것입니다. 마음에 드는 파이프라인이 호환되지 않다면, 이 가이드를 따라 그 파이프라인에 대한 지원을 추가할 수 있습니다.
커널
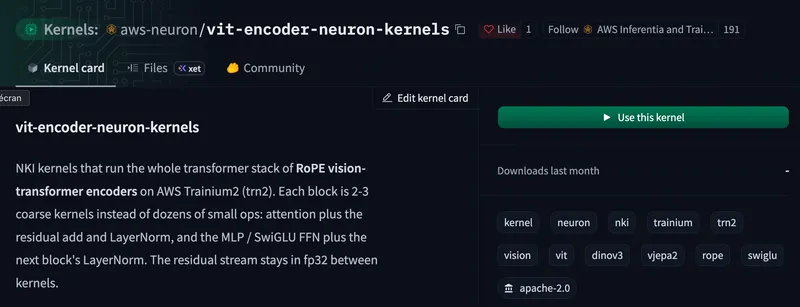
Neuron 팀의 커널들도 꼭 확인해 보세요. 점점 더 많은 Neuron 커널들이 Hub에 공개되어 모델 빌드 속도를 높여줍니다. Neuron 커널은 Neuron Kernel Interface (NKI)를 사용하여 작성할 수 있습니다. 이 인터페이스를 통해 작동 방식을 최적화할 수 있으며, 사용자들은 자신만의 커스텀 작업을 실행하고 Hub에서 공유할 수 있습니다.
예를 들어 이 커널을 사용하여 Trainium에서 비전 트랜스포머의 속도를 x2.4까지 향상시킬 수 있습니다!

감사의 말
TorchNeuron에 대한 작업과 HF 통합을 가능한 한 우수하게 만들기 위한 우리의 피드백에 대한 적극적인 반응에 대해 AWS 팀에게 특별한 감사를 드립니다.