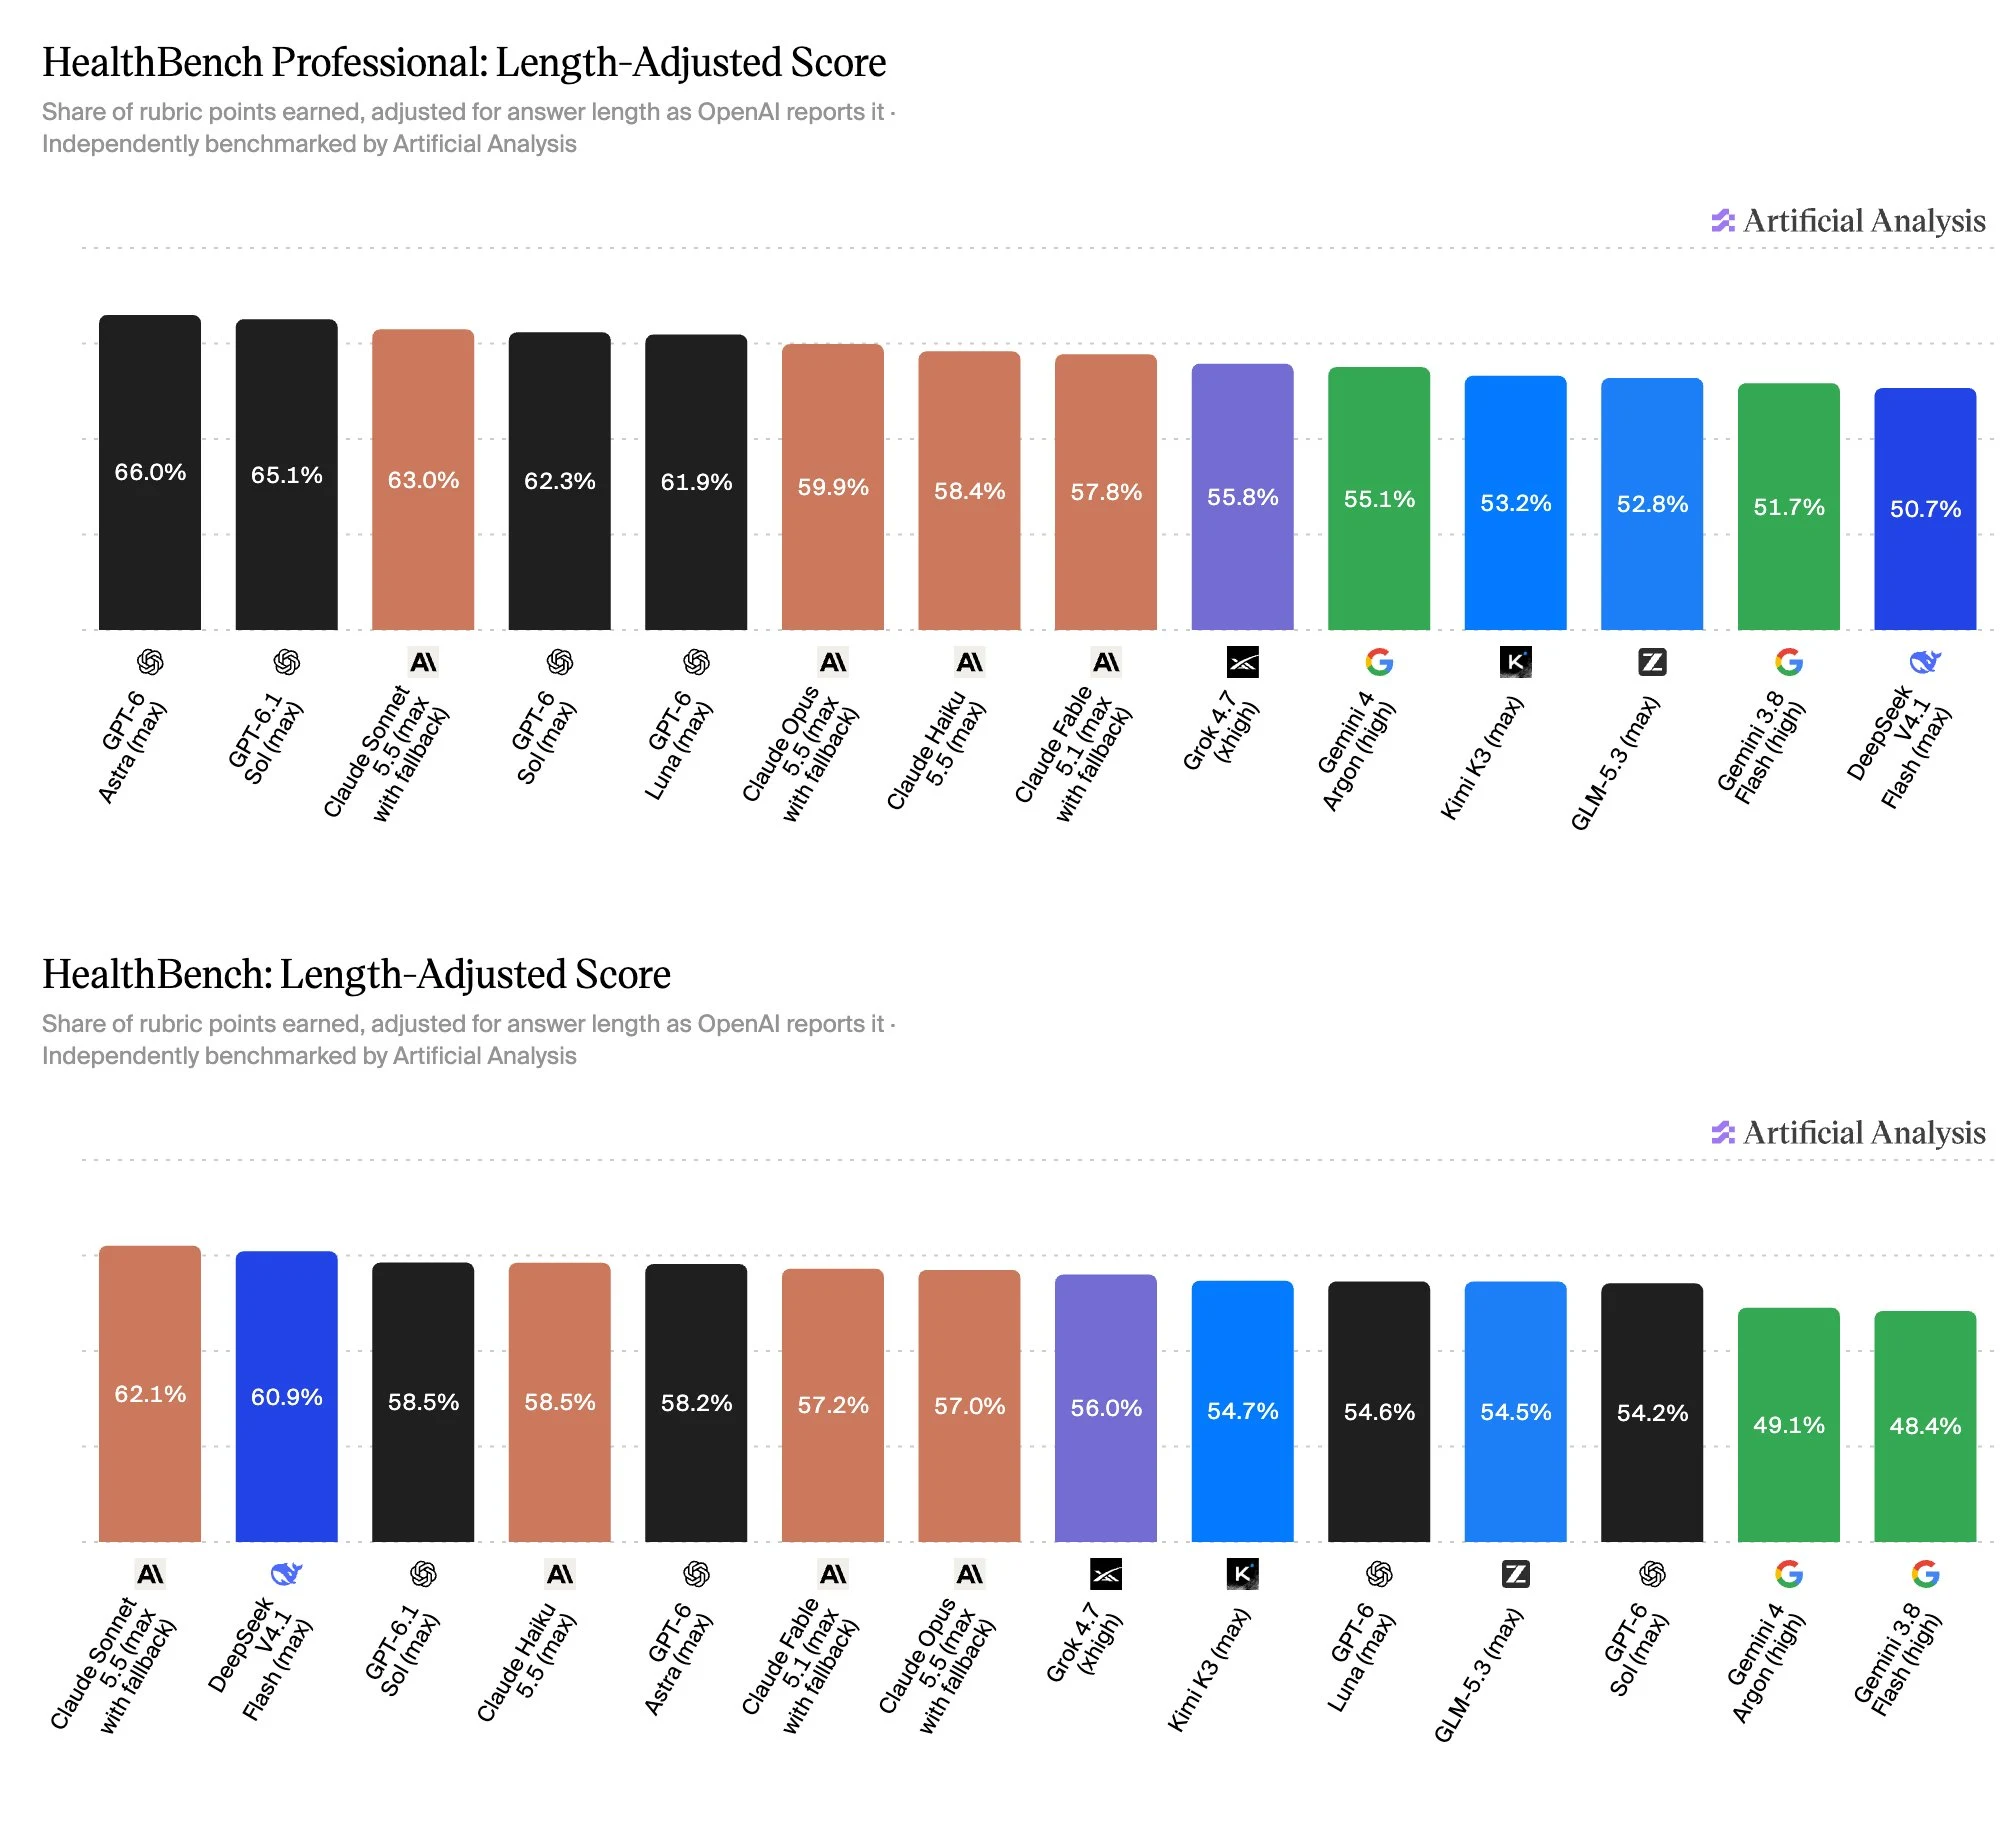
HealthBench와 HealthBench Professional 두 기준 테스트 제품에 리더보드 기능을 출시합니다. 이는 AI 모델이 실제 건강 관련 대화에서 어떻게 반응하는지를 평가하는 것입니다.
HealthBench와 HealthBench Professional은 @OpenAI에서 제공하는 기준으로, 의사가 만든 기준에 따라 실제 건강 관련 대화에 대한 모델의 답변을 평가합니다.
HealthBench은 일상적인 사용자와 의료진과의 5,000건의 건강 대화를 바탕으로 모델을 테스트합니다. 이는 응급 처치 추천부터 세계 보건에 이르는 7가지 주제를 포함하며, 각 기준은 정확성, 완전성, 의사소통 품질, 맥락 인식, 지시 따름이라는 5개의 기준에 해당합니다. HealthBench Professional은 525건의 대화로 구성된 더 작은 집합으로, HealthBench와 달리 모두 임상진과의 대화입니다. 이들은 상담, 글쓰기 및 연구 작업을 포함하며, 모델에 도전하기 위한 대립적이고 어려운 대화도 포함됩니다.
우리는 OpenAI가 보고하는 원래 점수와 길이 조정된 점수를 모두 보고합니다. 길이 조정된 점수는 2,000자 이상인 답변의 점수를 낮추고, 짧은 답변의 점수를 높입니다. OpenAI의 원래 구현 방식에 따라, 답변은 GPT-5.4(낮음)(HealthBench Professional)와 GPT-4.1(HealthBench)으로 평가됩니다.
HealthBench Professional의 주요 결과
➤ GPT-6 Astra와 GPT-6.1 Sol이 리더보드를 차지했습니다: GPT-6 Astra(최대)는 길이 조정된 점수에서 66.0%를 기록했으며, 이는 GPT-6.1 Sol(최대 65.1%)과 비슷하며 Claude Sonnet 5.5(최대 대체 점수 63.0%)보다 앞섰습니다.
➤ OpenAI 모델들이 작업당 비용 대비 점수의 파레토 최적점선을 구성합니다: 파레토 최적점선은 GPT-6 Luna(최대, 61.9%, 작업당 $0.004)부터 GPT-6 Sol(최대, 62.3%, $0.036), GPT-6.1 Sol(최대, 65.1%, $0.047)까지, 그리고 GPT-6 Astra(최대, 66.0%, $0.27)로 이어집니다. GPT-6 Luna(최대)의 점수는 GPT-6 Astra(최대)보다 4점 낮으며, 비용의 2% 미만입니다.
➤ Claude Opus 5.5와 Claude Fable 5.1은 가장 큰 길이 처벌을 받습니다: 두 모델 모두 답변당 약 5,900자로, 2,000자 임계값의 거의 3배에 달하며 조정 후 11점 이상을 잃습니다. Claude Opus 5.5(백업 옵션 최대)는 가장 높은 원시 점수(71.4%)를 기록하지만 6위(59.9%)로 하락합니다. GPT-6 Sol(최대)만이 평균적으로 2,000자 미만(~1,600자)이며, 점수가 상승한 유일한 모델입니다.
HealthBench의 주요 결과:
➤ Claude Sonnet 5.5는 HealthBench에서 최고 점수를 기록합니다: Claude Sonnet 5.5(최대값으로 대체)는 길이 조정 점수에서 62.1%를 달성하여 DeepSeek V4.1 Flash(최대값, 60.9%)와 GPT-6.1 Sol(최대값, 58.5%)보다 앞서 있습니다.
➤ GPT-6 Luna, DeepSeek V4.1 Flash 및 Claude Sonnet 5.5의 점수와 작업당 비용의 파레토 최적점선: GPT-6 Luna(최대)는 작업당 $0.002로 54.6%의 점수를, DeepSeek V4.1 Flash(최대)는 작업당 $0.005로 60.9%의 점수를 기록합니다. Claude Sonnet 5.5(대체 방식 포함)의 평균 작업당 비용은 $0.08이며, 약 1점의 점수 향상을 위해 DeepSeek V4.1 Flash보다 약 16배 더 비쌉니다.
➤ 더 짧은 답변은 완전성 대신 의사소통의 질을 추구합니다: HealthBench 루브릭 항목 각각은 다섯 가지 기준 중 하나로 태그됩니다. 완전성은 답변에 모든 중요한 정보가 포함되어 있는지 확인하며, 의사소통의 질은 명확하고 잘 구성되었으며 적절한 길이와 세부 수준을 갖추고 있는지를 확인합니다. GPT-6 Sol (최대)는 가장 짧은 답변을 작성하며 (~1,000자) 그리고 가장 높은 원시 의사소통의 질 점수(81%)를 가집니다. 하지만 가장 낮은 완전성 점수(34%)를 가지고 있습니다. 클로드 소네트 5.5(대체 옵션 포함 최대값)이 완전성 부문에서 63%를 기록하며 선두에 나섬