
윤중(允中) 아오비쓰(凹非寺) 발
챈쯔웨이(量子位) | 공식 계정 QbitAI
범용 모델에서 개인화 지능으로, 인공지능 경쟁은장기 학습과 전용 능력의 축적으로확장되고 있다.
통연링즈(通衍灵智)는 파라미터화 학습과 지속적 진화를 핵심으로 하는 Personal AI를 탐구하며, 개인과 조직이 AI를 사용하는 과정에서 점차 자신만의 지능 자산을 축적해 나가도록 한다.
지난 몇 년간 대규모 모델은 능력의 한계를 계속 돌파했고, 점점 더 많은 기업이 API, 지식 베이스, Agent를 통해 AI를 연구개발, 투자연구, 운영 등 핵심 업무에 도입하기 시작했다.
그러나 AI가 실제 업무에 참여하는 시간이 길어질수록 새로운 문제가 떠오르기 시작했다.기업이 매일 생성하는 방대한 업무 경험은 과연 모델이 임시로 호출하는 것에 그치는 것인지, 아니면 점차 자신만의 AI 능력으로 축적될 수 있는 것인가?
글로벌 테크 기업들은 이미 이 방향을 탐색하기 시작했다.
OpenAI는 Dreaming을 통해 ChatGPT의 장기 기억을 개선하여 과거 상호작용을 종합하고 사용자 선호, 프로젝트 배경, 장기 요구를 더 잘 이해할 수 있게 했으며, Meta가 출시한 Muse는 개인화 이해와 자율 실행을 결합해 Personal Agent가 질문에 답하는 단계에서 실제 과제를 수행하는 단계로 나아가도록 한다.
장기 기억이든 능동적 실행이든, 모두 하나의 날로 명확해지는 추세를 반영한다. AI는 모든 사람을 대상으로 하는 범용 도구에서 특정 사용자를 위한 장기 지능 서비스로 발전하고 있다.
베이징 범용인공지능연구원 산업플랫폼 CEO 리웨이(李未)는 “기반 모델이 강할수록 개인화 지능이 발휘할 수 있는 역할이 커진다. 우리가 주목하는 것은 새로운 기술적 분업이다. 선진 기반 모델은 공유되는 범용 능력을 제공하고, 개인화 모델은 장기 상호작용과 지속적 진화 학습을 통해 서로 다른 주체의 요구에 부합하는 전용 능력을 점차 형성한다”고 말했다.
참고: 통연링즈는 베이징 범용인공지능연구원(BIGAI) 체계의 과학 연구 축적과 산업화 자원에 기반하여, 기업과 개인을 위한 지속적 자가진화 전용 모델(Personal AI) 연구개발에 집중한다. 개인화 모델 훈련, 지속 학습, 저변 연산력 최적화를 통해 전문 지식과 업무 경험이 지속 가능하게 진화하는 전용 지능 능력으로 축적되도록 추진한다.
개인화가 업계의 공통 관심 방향이 되면서, 기술 탐구도 모델 내부로 확장되기 시작했다.
사용자의 정보를 기억하는 것 외에, AI가 개인과 조직이 장기간 형성해 온 경험을 진정으로 학습할 수 있을까? 이러한 능력이 사용 과정에서 지속적으로 갱신되고, 기반 모델을 교체한 후에도 보존될 수 있을까? 전용 모델의 수가 계속 증가할 때, 훈련과 운영 비용은 어떻게 관리해야 할까?
통연링즈는 기술 방향을Recursive Self-Improving Personal AI(재귀적 자가진화 개인화 지능)에 집중하고, 앞서 언급한 문제들에 대한 체계적 해결책을 제시하려 한다.
베이징 범용인공지능연구원 체계의 연구·산업 자원에 기반하여, 회사는 기존 범용 모델 위에서 경량화된 개인화 파라미터로 서로 다른 주체의 전용 능력을 담고, 지속 학습 메커니즘과 연산력 스케줄링 기술을 결합하여 모델이 장기 사용 중에 사용자에게 지속적으로 적응하도록 한다.
이 기술 체계의 목표는 개인, 프로젝트, 기업이 각각 완전한 범용 대규모 모델을 훈련하지 않고도 자신의 요구에 맞고 지속적으로 진화할 수 있는 전용 지능을 점차 구축할 수 있게 하는 것이다.
장기 기억에서 모델 학습으로, 개인화가 파라미터 층으로 진입하다
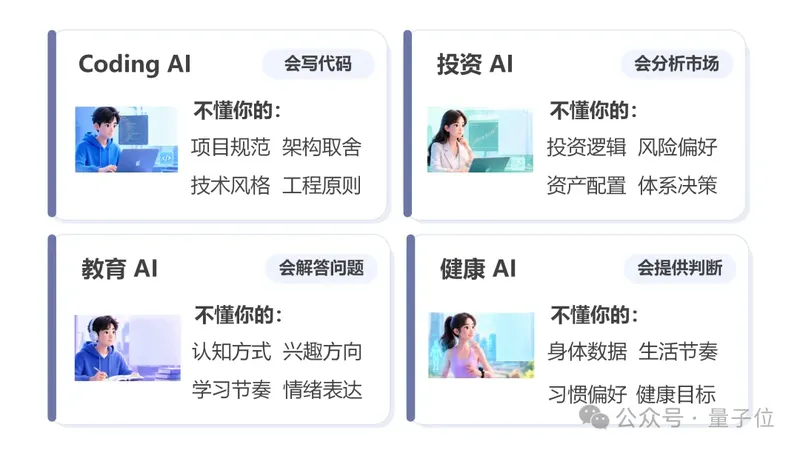
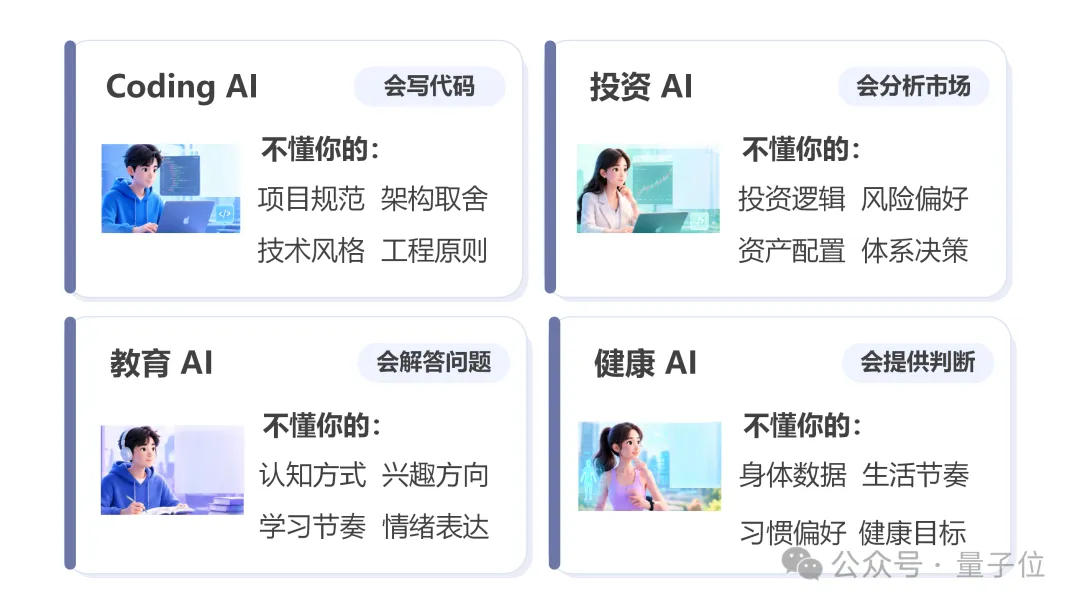
똑같이 Coding Agent를 사용해도 서로 다른 개발팀이 얻는 결과는 뚜렷한 차이를 보일 수 있다.
성숙한 소프트웨어 시스템에는 대개 자체적인 아키텍처 원칙, 기술 규범, 역사적 제약이 있으며, 숙련된 엔지니어는 어떤 모듈을 쉽게 수정할 수 없는지 알고 있고, 언제 기술적으로 최적인 해법보다 안정성을 우선해야 하는지도 잘 안다.
이러한 경험은 일부가 문서에 기록되어 있지만, 더 많은 부분은 장기간의 코드 수정, 방안 논의, 프로젝트 실무에 흩어져 있다.
유사한 상황은 금융 투자연구, 기업 운영 등 분야에도 존재한다. 범용 모델은 시장을 분석하고 업무 프로세스를 이해할 수 있지만, 서로 다른 팀이 장기간 형성해 온 리스크 선호, 의사결정 습관, 업무 방식은 대개 지속적인 협업을 통해 점차 습득해야 한다.
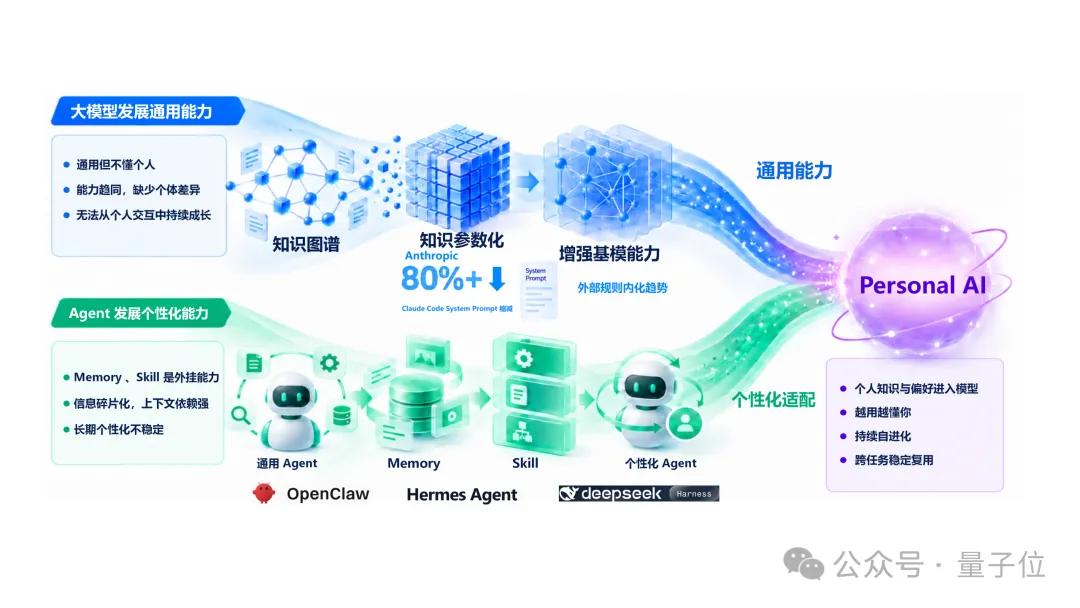
현재 AI는 주로 Prompt, RAG, Memory, Skill 등의 메커니즘으로 구체적인 시나리오에 적응한다. 이들은 각각 지시 제약, 지식 검색, 상태 저장, 능력 재사용 등의 역할을 담당하며, 이미 기업이 대규모 모델을 적용하는 데 중요한 구성 요소가 되었다. 다만 이런 메커니즘은 주로 모델 외부에서 정보를 조직하며, 모델 자신의 파라미터는 보통 한 번의 업무 상호작용으로 변하지 않는다.
개인화 요구가 정보 획득에서 장기 행동 패턴으로 확장됨에 따라, 파라미터화 학습이 또 하나의 기술적 선택지를 제공한다.
통연링즈는 공유 기반 모델(Base Model)과 개인화 파라미터(Personal Parameters)를 결합한 아키텍처를 채택했다.기초 모델은 범용 지식과 추론 능력을 제공하며, 서로 다른 개인, 프로젝트, 기업은 경량화된 Personal LoRA를 통해 파라미터를 조정하여 검증된 전문 선호와 행동 특성을 점진적으로 모델에 녹여낸다.
전통적인 산업별 모델이 주로 산업 간 능력 차이를 해결하는 것과 비교할 때, 이 접근 방식은 같은 산업, 같은 작업 안에서 서로 다른 사용자 간의 차이에 더욱 주목한다. 예를 들어, 똑같이 소프트웨어 개발이라도 두 프로젝트는 완전히 다른 엔지니어링 규범을 필요로 할 수 있고, 똑같이 투자 리서치라도 팀마다 각자의 평가 기준과 리스크 규율을 가지고 있다.
이것이 지식 베이스와 장기 기억의 가치가 사라진다는 의미는 아니다. 동적 지식은 여전히 검색이 필요하고, 작업 상태는 여전히 기록이 필요하며, 장기적인 실천 과정에서 반복적으로 나타나는 비교적 안정적인 행동 패턴은 추가로 훈련을 통해 파라미터화된 능력으로 전환될 수 있다.
이렇게 개인화는 '모델이 사용자에 대한 더 많은 정보를 파악하게 하는 것'에서 점차 '모델이 사용자의 요구에 더 부합하는 능력을 형성하게 하는 것'으로 확장된다.
통연영지(通衍灵智) CEO 셰샤오난(谢枭楠)은 다음과 같이 말했다: “기업의 AI에 대한 수요는 범용 능력을 확보하는 것에서 고유 능력을 축적하는 것으로 이동하고 있다. 같은 유형의 범용 지능 서비스는 점점 더 많은 기업이 확보하게 될 것이며, 진정한 격차를 만드는 것은자신들이 오랜 기간 형성해온 전문적 판단과 일하는 방식을 모델 능력으로 축적할 수 있는가하는 것이지, 영원히 '자료 찾기' 수준에 머무는 것이 아니다.”
모델이 실제 업무 속에서 성장하게 하려면 핵심은 신뢰할 수 있는 학습 메커니즘을 구축하는 것이다
전용 파라미터를 갖게 되면 새로운 과제가 뒤따릅니다. 모델이 어떻게 가치 있는 경험을 지속적으로 흡수하고, 학습 과정에서 오류가 축적되는 것을 피할 수 있을까요?
기업의 일상적인 AI 사용은 대량의 피드백을 발생시킵니다. 개발자는 코드를 수용하거나 수정하고, 영업 담당자는 고객 소통 전략을 조정하며, 투자 매니저는 연구 결론을 수정하는데, 이러한 행동에는 모두 잠재적 학습 신호가 담겨 있습니다. 그러나 단일 피드백이 반드시 장기적인 패턴을 대표하지는 않으며, 한 번의 성공적인 판단이 동일한 전략이 모든 시나리오에 적용될 수 있음을 의미하지도 않습니다.
상호작용 기록을 선별 없이 학습에 사용하면 모델이 우연한 선호를 강화하거나 기존 능력을 손상시킬 수 있습니다. 따라서 지속 학습에는 유효한 피드백을 식별하고, 업데이트 효과를 평가하며, 모델 동작 변화를 제어할 수 있는 메커니즘을 구축해야 합니다.
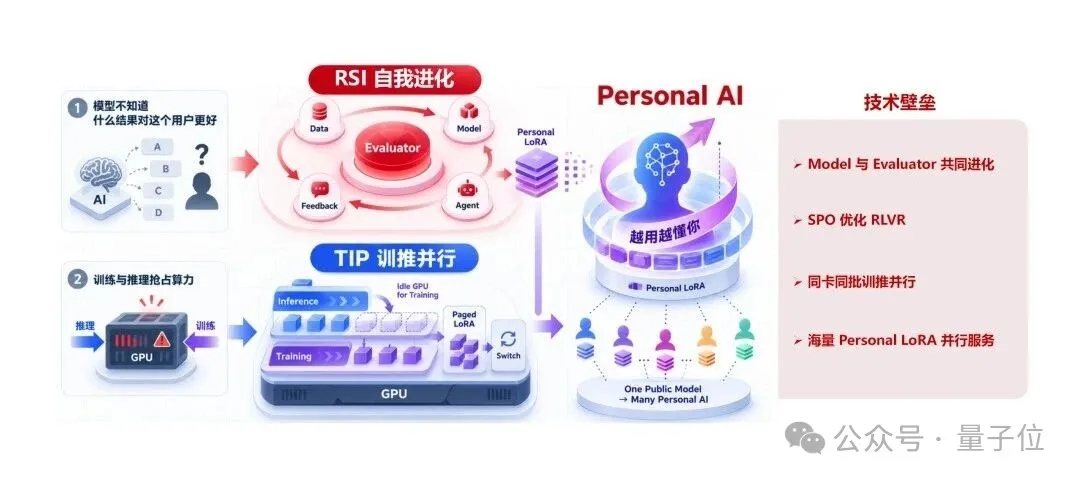
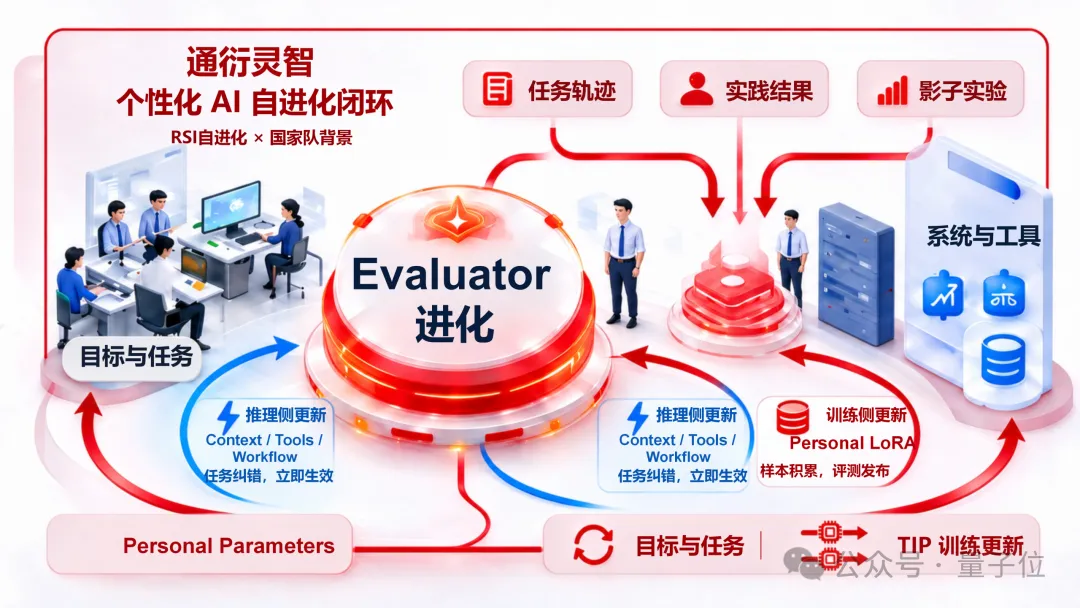
통연링즈(通衍灵智)는 이러한 수요에 맞춰 RSI(Recursive Self-Improvement, 재귀적 자기 개선) 기술을 연구 개발하고 있으며, 모델과 평가기의 협력적 반복을 통해 지속 학습 프레임워크를 구축합니다.
이 프레임워크에서는 비즈니스 운영에서 발생한 태스크 궤적, 인간의 수정, 실제 결과가 먼저 후보 학습 데이터를 형성하고, Evaluator가 구체적인 사용자 또는 기업의 평가 기준에 따라 피드백을 선별·판단한 뒤, 유효한 샘플을 Personal LoRA의 증분 업데이트에 사용합니다.
업데이트된 모델은 추가 평가를 받아야 하며, 기존 버전과의 태스크 수행 성능을 비교합니다. 사전 설정된 요구 사항을 충족하는 업데이트만 서비스에 투입되고, 이상 결과는 버전 관리 및 롤백 메커니즘을 통해 처리해야 합니다.
동시에 모델 업데이트의 실제 효과는 Evaluator를 개선하는 데 역으로 활용될 수 있어, 시스템은 학습 데이터 선별 방식과 평가 기준을 점차 최적화해 나갑니다.
소프트웨어 개발을 예로 들면, 시스템은 코드 Review 기록을 활용해 특정 유형의 수정이 왜 반복적으로 수용되거나 거부되는지 분석할 수 있고, 후속 태스크를 통해 모델이 관련 엔지니어링 요구 사항을 실제로 습득했는지 검증할 수 있습니다. 유효한 피드백이 계속 축적되면 모델은 팀이 장기간 형성해 온 업무 방식에 점진적으로 적응할 기회를 얻습니다.
이 메커니즘은 파국적 망각, 피드백 오염, 모델 드리프트, 업데이트 안정성 등의 기술적 과제와 관련됩니다. 통연링츠는 현재 RSI 핵심 기술 로드맵과 제품 아키텍처가 명확해졌으며, 관련 모듈의 엔지니어링을 진행 중이고, 완전한 자동화 폐루프는 여전히 지속적인 연구 개발 단계에 있다고 밝혔습니다.
통연링츠 CTO 저빙빙(储兵兵)은 학습 과정에서 절대로 사용자가 ‘거절’을 클릭하는 즉시 모델 학습에 사용하지 않으며, 도입한 Evaluator가 먼저 해당 피드백에 학습 가치가 있는지 판단하고, 한 번의 피드백은 단지 신호일 뿐 반복적으로 나타나는 패턴만이 진정으로 학습으로 전환될 수 있다고 말했습니다. 또한 모델 업데이트 후에는 이전 버전과 동일한 태스크 배치에서 재실행하여, 개선이 확인되면 출시하고 성능이 저하되면 롤백하여 진화의 안전성과 효율성을 보장한다고 밝혔습니다.
장기적으로 보면, 모델이 실제 비즈니스에서 안정적으로 학습할 수 있다면 기업은 반복적인 설정과 중앙집중식 학습 작업을 줄일 기회를 얻고, AI 능력은 비즈니스 발전에 따라 점진적으로 갱신될 수 있습니다.
전용 모델이 규모화되면서 컴퓨팅 자원 비용이 현실적 과제로
개인화 모델의 상용화는 또 다른 현실적 제약에 직면해 있습니다. 바로 비용입니다.
한 기업이 미래에 수백 개 직무, 수천 개 Agent를 위해 서로 다른 모델 파라미터를 유지 관리하고, 동시에 이 모델들의 지속 학습과 온라인 서비스를 지원해야 한다면, 전통적인 독립 학습·독립 배포 방식은 상당한 컴퓨팅 및 관리 비용을 초래합니다. 대량의 개인 사용자에게 서비스를 제공하는 플랫폼의 경우 자원 효율성의 중요성은 더욱 높아집니다.
이에 통연링츠는 AI 인프라를 Personal AI의 중요한 구성 요소로 삼고, 학습과 추론의 협력적 스케줄링, 그리고 대량의 개인화 파라미터에 대한 메모리 관리를 중심으로 최적화를 진행하고 있습니다.
그중 TIP(训推并行, 학습·추론 병렬화)은 주로 학습과 온라인 추론 간의 자원 할당 문제를 해결합니다. 전통적인 아키텍처는 일반적으로 모델 학습과 추론 서비스를 각각 관리하지만, 지속 학습은 두 유형의 태스크가 모델 실행 과정에서 빈번하게 교차함을 의미합니다.
통연링츠는 동일 카드·동일 배치 학습·추론 병렬화, 비동기 그래디언트 누적 등의 기술을 통해 온라인 서비스를 보장하는 전제 아래 사용 가능한 컴퓨팅 자원을 활용해 개인화 파라미터의 증분 학습을 수행하고, 독립 학습 자원 풀에서 발생하는 추가 비용을 줄이려 시도하고 있습니다.
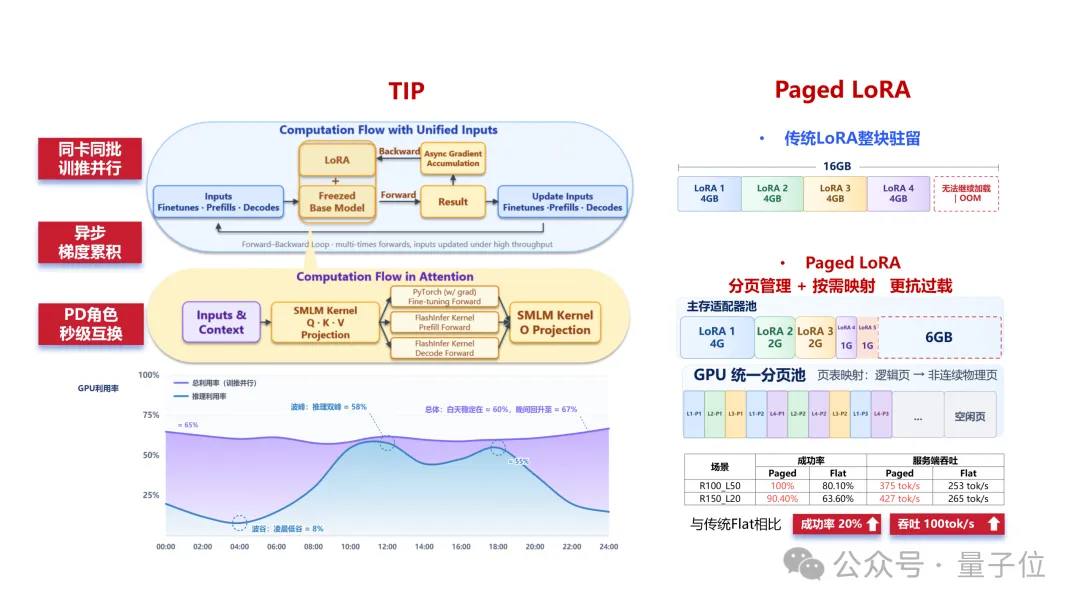
Paged LoRA는 대량의 Adapter가 동시에 실행될 때의 메모리 관리 문제를 겨냥합니다. 전통적인 방식은 대체로 큰 고정 단위로 메모리를 할당하기 때문에, 모델 수와 접근 빈도가 변화하면 자원 활용 불충분과 응답 지연 변동이 발생하기 쉽습니다. Paged LoRA는 페이지 기반 관리와 온디맨드 매핑 메커니즘을 채택하여 서로 다른 Personal LoRA가 기반 모델과 GPU 메모리를 더 유연하게 공유할 수 있도록 합니다.
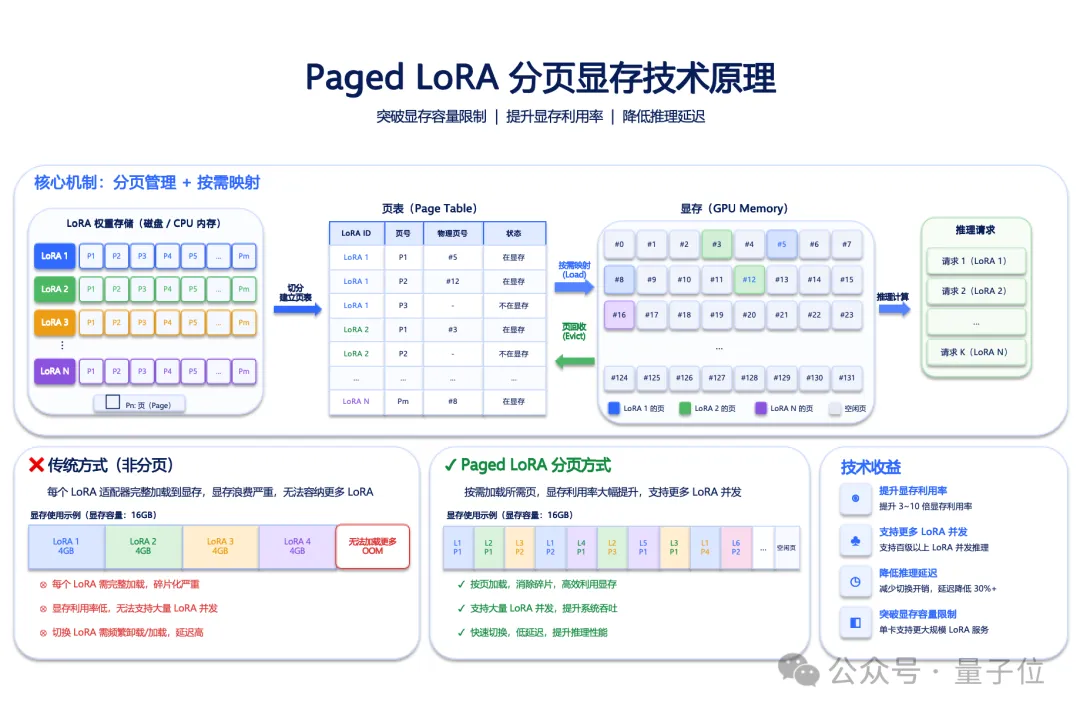
이미 완료된 단계적 테스트에서 통연링츠는 Qwen2.5-72B-Instruct 및 NVIDIA H800 GPU 8장을 사용하여 Paged 방식과 전통적인 Flat 방식의 LoRA 메모리 예산을 모두 5.79GB로 통일했습니다. LoRA 요청 비중이 1%에서 30%인 테스트 부하에서 Paged 방식은 응답 지연과 롱테일 성능 면에서 일정한 우위를 확보했습니다.
테스트는 동시에, LoRA 요청 비중이 50%로 높아지면 빈번한 파라미터 스왑 인·아웃이 여전히 성능 저하를 초래함을 보여주었습니다. 팀은 비동기 로딩, 핫스팟 파라미터 프리페치 등의 방향으로 최적화를 계속 진행 중이며, 관련 기술이 더 넓은 프로덕션 환경에서 보여줄 성능은 추가 검증이 필요합니다.
저빙빙은 추가로, 기반 모델 추론 비용은 하락하고 있지만 Agent 호출 빈도와 개인화 학습 수요는 증가하고 있으며, 지속 학습 시스템은 한 번의 모델 호출 가격만 볼 것이 아니라 장기적인 학습, 업데이트, 서비스의 종합 비용을 봐야 하고, 경제성이 합리적일 때만 이런 서비스가 더 넓은 사용자를 커버할 수 있다고 말했습니다.
통연링츠에게 있어 기반 컴퓨팅 최적화는 개인화 모델의 장기 운영을 위한 것입니다. RSI로 지속 학습을 추진하고, TIP과 Paged LoRA로 학습 및 동시 서비스의 자원 효율을 개선함으로써, 회사는 전용 모델의 사용 문턱을 점차 낮춰 고비용 맞춤형 서비스에서 더 넓은 실제 적용으로 나아가기를 희망합니다.
모델이 교체·전환되는 가운데, 지능 능력은 어떻게 장기간 축적·보존될 수 있을까?
기반 모델의 능력, 가격, 배포 방식이 끊임없이 변화함에 따라, 기업은 미래에 여러 모델을 동시에 사용하거나 비즈니스 필요에 따라 기술 기반을 교체할 수도 있습니다.
일단 AI가 일상 경영에 깊이 관여하면, 모델 전환에 따르는 비용은 더 이상 인터페이스와 시스템 적응에 국한되지 않습니다. 기업은 과거 많은 시간을 들여 축적한 학습 데이터, 업무 습관, 인간 피드백, 평가 기준이 새로운 모델 환경에서도 계속 역할을 발휘할 수 있는지 고려해야 합니다.
통연링츠는 공유 기반 모델과 개인화 능력의 계층 분리를 통해 기업이 단일 모델 기반에 장기적으로 의존하는 것을 줄이기를 희망합니다.
명시할 필요가 있는 것은, 서로 다른 기반 모델의 구조와 파라미터 공간은 자연스럽게 호환되지 않으며, Personal LoRA는 일반적으로 모델 간 직접 재사용이 불가능하다는 점입니다. 그러나 기업이 이미 축적한 비즈니스 데이터, 학습 샘플, 태스크 궤적, 평가 체계는 새 모델의 적응과 학습에 계속 사용할 수 있어, 전용 능력을 다시 구축하는 작업량을 줄일 수 있습니다.
이러한 사고방식은 기업이 자체 모델 평가 기준을 수립하고, 모델 공급업체가 제공하는 범용 지표에 완전히 의존하지 않고 실제 비즈니스 성과에 따라 여러 기반 모델을 비교할 기회를 제공합니다.
모델 전환만큼 중요한 것은, 장기간 축적된 데이터와 모델 성과를 어떻게 관리할 것인가입니다.
통연링츠의 제품 설계에서는 공유 기반 모델, 기업 비즈니스 데이터, 개인화 파라미터가 서로 다른 계층으로 구분되어, 데이터 사용, 모델 적응 및 관련 성과 관리를 위한 기술적 기반을 제공합니다. 구체적인 데이터 권리, 지식재산권, 모델 성과의 귀속은 여전히 계약, 라이선스 및 데이터 거버넌스 메커니즘을 통해 명확히 해야 하며, 기술적 계층 분리 자체가 법적 소유권을 자동으로 발생시키지는 않습니다.
이 아키텍처가 제공하는 가능성은, 기업이 AI를 지속적으로 사용하면서 상대적으로 독립적인 학습 데이터, 평가 체계, 개인화 모델 능력을 점차 형성하고, 미래 모델 업그레이드나 전환 시에도 이러한 축적을 계속 활용할 수 있게 하는 것입니다.
개인에게도 마찬가지입니다. 개인이 장기간 형성해 온 지식 구조, 전문 경험, 업무 선호가 효과적으로 보존되고 새로운 지능형 시스템의 적응에 지속적으로 사용될 수 있다면, 그 가치는 더 이상 특정 제품이나 특정 서비스에 국한되지 않습니다.
샤오 시아오난(谢枭楠)은 또한 모델 기반(base) 교체로 축적된 것이 모두 사라질 것을 기업이 걱정할 필요는 없다고 생각한다. 진정으로 기업에 속하는 것은 장기간 축적된 업무 데이터, 작업 궤적, 인간 피드백 및 평가 체계이며, 이러한 자산은 새 모델 위에서 다시 적응시킬 수 있고 제로부터 시작하는 것이 아니다. 모델은 교체할 수 있지만, 기업의 경험이 함께 초기화되어서는 안 된다.
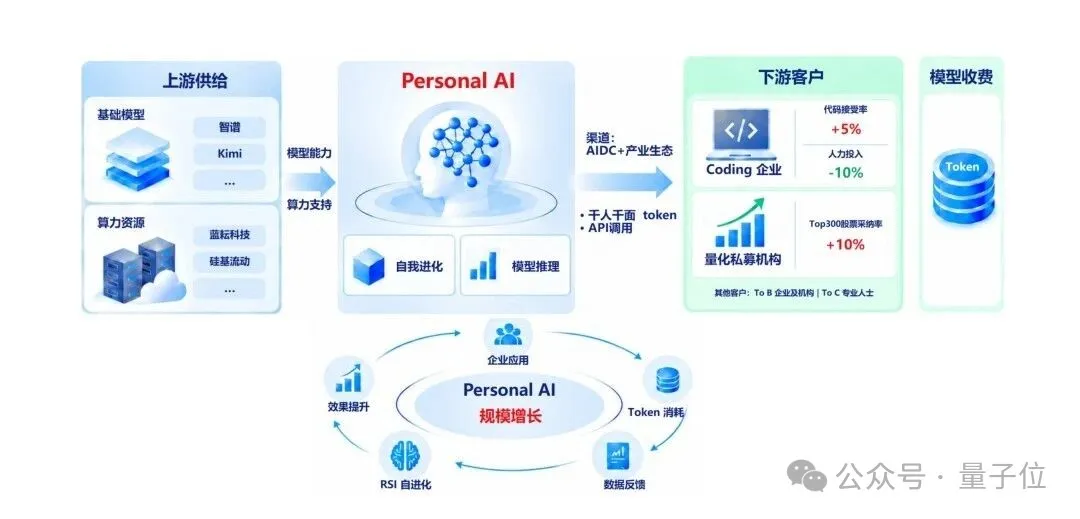
비즈니스 모델 관점에서 보면, Personal AI는 여기서 주목할 만한 방향 하나를 제시합니다.AI 서비스의 가치는 즉각적인 작업 수행에서 한 걸음 더 나아가 사용자의 장기적 지능 자산 축적으로 확장될 수 있습니다.
기술 진보에서 가치 공유까지, 지능이 진정으로 인간에게 봉사하도록 하다
인공지능이 지식과 생산 능력이 형성되는 방식을 다시 정의하고 있습니다.
과거에는 개인의 경험이 주로 자신의 인지와 실천 속에 보관되었고, 기업의 전문 역량은 직원, 제도, 업무 시스템, 조직 협업 속에 분산되어 있었다. AI가 사회 생산과 일상생활에 점점 더 깊이 관여하면서, 이렇게 분산되어 있던 지식과 경험이 체계적으로 정리되고 학습되며 재활용될 기회를 얻기 시작했다.
그러나 기술 역량이 지속적으로 향상되는 동시에, 더 근본적인 문제를 생각해볼 필요도 있다.
사용자가 끊임없이 상호작용, 수정, 비즈니스 피드백을 제공하여 AI 시스템이 더욱 지능적으로 발전하도록 이끌 때, 이러한 투입이 창출하는 장기적 가치는 어떻게 개인과 조직 자신에게 돌아와야 할까요?
기존 플랫폼형 AI 서비스는 주로 사용자에게 즉각적인 모델 기능을 제공하며, 사용자의 이용 행위가 플랫폼이 제품을 지속적으로 개선하는 데 도움이 될 수도 있습니다. 반면 Personal AI가 탐구하는 것은 사용자가 서비스를 받는 동시에 자신의 지식, 경험, 판단으로 형성된 고유의 지능 자산을 점진적으로 축적하여, AI를 장기간 사용함으로써 얻는 가치가 지속적으로 축적될 수 있도록 하는 것입니다.
이러한 축적이 가져오는 의미는 개인화 효과의 개선 그 이상이다.
~에 대해개인있어서, 전문 경험은 점진적으로 장기적으로 활용 가능한 디지털 역량으로 전환되어, 서로 다른 도구와 서로 다른 작업 환경 속에서 자신이 쌓아온 것을 지속할 수 있도록 도울 수 있습니다.
~에 대해기업있어, 오랜 기간 형성된 업무 방법과 조직 지식이 전용 모델을 통해 보존·계승될 기회를 얻어, 핵심 노하우가 인력 이동이나 기술 교체에 따라 유실될 위험을 줄일 수 있습니다.
이러한 역량이 서로 다른 기반 모델 간에 재적용될 수 있게 되면, 개인과 조직도 더욱 충분한 기술 선택의 여지를 얻게 되며, 자신의 필요에 따라 모델을 평가하고 채택하고 교체할 수 있어 단일 플랫폼에 대한 장기적 의존을 낮출 수 있습니다.
기업이 반드시 자체 범용 대형 모델을 새로 학습시킬 필요는 없지만, 점진적으로 자신만의 지능 역량을 갖출 기회는 있어야 한다.
이는 또한 통옌 링즈(通衍灵智)가 주창하는 "사람 중심의 개인화 지능"을 보여준다. 그들의 관점에서 인공지능의 발전은 사용자에게 더 큰 자율권을 부여하고, 개인과 조직이 오랫동안 축적해 온 지식, 경험, 판단이 존중받고 보존되며 계승되도록 하며, 기술 진보가 창출하는 가치가 더 널리 사용자에게 혜택이 돌아가도록 해야 한다.
마지막으로 리웨이(Li Wei)는 인공지능의 보편적 혜택이 단순히 더 많은 사람이 첨단 모델을 사용할 수 있다는 것만이 아니라, 더 많은 사람이 AI를 통해 자신의 능력을 축적하고 발전시킬 수 있다는 것을 의미해야 한다고 말했다. 기술 진보의 성과가 더 많이 사람의 성장, 기업의 혁신, 사회 생산력의 향상으로 전환되는 것, 이것이 퉁옌링즈(通衍灵智)가 이해하는 인간 중심이다.
북경 범용 인공지능연구원(北京通用人工智能研究院) 체계의 연구 축적에 기반하여, 통연령지(通衍灵智)는 이러한 이념을 파라미터화 학습, 지속적인 진화 및 기반 컴퓨팅 아키텍처에 구현하고 있습니다.
관련 기술은 여전히 지속적인 연구개발과 산업 검증이 필요하지만, 이것이 가리키는 장기적 가치는 더 광범위한 사회적 의미를 갖는다. 즉, 첨단 인공지능 능력이 개인의 발전, 조직의 성장, 사회 생산력 향상을 뒷받침하는 지속적인 기반이 되도록 하는 것이다.
더 장기적인 관점에서 보면, 인공지능은 인간의 지식을 끊임없이 흡수하고 자신의 능력을 지속적으로 향상시키는 시스템이어야 할 뿐만 아니라, 인간이 지식을 축적하고 경험을 전승하며 능력을 확장하는 데 도움을 주는 중요한 인프라가 되어야 한다.
범용 지능이 점차 사회 전반이 널리 이용할 수 있는 기반 역량이 되어갈 때, 진정으로 기대할 만한 것은 모든 개인과 모든 조직이 기술 발전 속에서 자신만의 장기적인 축적을 쌓고, 그러한 역량을 선택하고 발전시킬 수 있는 공간을 갖는다는 것이다.
AI는 단지 사람의 참여 때문에 더 똑똑해져서는 안 되며, 사람 역시 AI의 보급으로 인해 더 많은 역량을 갖추게 되어야 합니다. 기술 진보의 성과는 모델과 플랫폼에만 축적되는 것이 아니라, 개인의 성장, 조직의 발전, 사회의 진보를 위한 지속적인 힘으로 축적되어야 합니다.
*본 글은 퀀텀비트(量子位)가 승인을 받아 게재한 것으로, 견해는 원저자에게 귀속됩니다.