
Cornerstone OnDemand, Inc. (Cornerstone)是劳动力就绪解决方案领域的全球领导者,服务于 186 个国家的 140 百万用户。该公司构建了一个多智能体 AI 系统,将数据库运营从被动救火转变为主动的、自编排的工作流。该系统名为 Orion AI,使用 Amazon Bedrock 和 Strands Agents(AWS 的开源智能体编排框架)来协调专门的智能体。
在 Orion AI 出现之前,Cornerstone 的 Enterprise DataOps 团队在将工作移交其他团队之前,每次数据库事故都要花费多达 45 分钟手动查询系统视图并交叉比对日志。使用 Orion AI 后,数据库诊断时间从 45 分钟降至 10 分钟,降幅达 78%。一个三人团队在六个月内交付了该系统。
在这篇文章中,我们将介绍 Cornerstone 面临的运营问题、他们如何设计 Orion AI、他们衡量的成果,以及其他团队可以复用的设计决策。
运营挑战
在 Orion AI 出现之前,Cornerstone 的 Enterprise DataOps 团队以被动方式运作,存在四个反复出现的痛点:
- 数据库性能调查每次事故大约需要 45 分钟,分散在多个工具和系统视图之间。
- 数据库生命周期工作流需要 10 个或更多手动步骤,从建立连接到传达状态更新。
- 站点可靠性工程(SRE)团队与数据团队之间的报告存在 15 分钟的延迟。
- 冗余和重叠的告警产生了噪音,淹没了重要的信号。
这些因素加在一起,意味着工程师把时间花在手动协调上,而不是解决问题上。
解决方案:Orion AI
Orion AI 是一个多智能体系统,其中一个协调智能体(元编排器)将工作委托给按中心辐射拓扑结构组织的专门子智能体。工程师通过 Web 应用程序与其交互,在他们已经协调运营工作的同一地点提问和批准操作。这些智能体涵盖基础设施监控、数据库诊断、数据库生命周期操作、客户分析和知识驱动的支持。
构建过程遵循两个原则:在 共担责任模型下利用 AWS 控制实现数据隐私,以及与现有运营工具的深度集成。Amazon Bedrock 提供了对基础模型的托管访问,Strands Agents 提供了编排层。
成果
Orion AI 在诊断速度和准确性方面都带来了可衡量的改进,并将团队从手动协调中解放出来。通过自动化手动瓶颈并简化跨团队工作流,Cornerstone 取得了以下成果。
| 指标 | 之前 | 之后 | 改进 |
| 数据库诊断时间 | 45 分钟 | 10 分钟 | 快78% |
| 手动生命周期步骤 | 10多个步骤 | 1次交互 | 减少70% |
SRE-to-data-team 报告延迟 |
15分钟 | 即时 | 实时 |
| 冗余警报 | 高基线告警量 | 已过滤 | 减少65%(中位数) |
更快地进行性能故障排查
缩短数据库诊断时间是 Orion AI 迄今为止最大的单项效率提升。以前,工程师需要手动连接到受影响的 SQL Server 实例,查询系统视图以获取阻塞链和等待类型,交叉比对日志以定位长时间运行的查询,并关联证据以形成根本原因假设。平均每次事件大约耗时 45 分钟。
借助 Orion AI,三个专门的智能体共同参与调查,各自负责不同的阶段。除了诊断之外,Orion AI 还会将问题推进到修复环节:识别根本原因、推荐修复方案,并创建一个填好内容、分配给合适的值班工程师的 Jira 工单。原本需要四步的手动交接流程 collapses 为一次交互。
自动化数据库生命周期管理
以前需要超过 10 个手动步骤的任务,从建立数据库连接到运行跨系统查询再到传达状态更新,现在只需一次自然语言交互即可完成。Orion AI 识别合适的工具和数据源,跨系统运行查询,验证结果,并返回统一的响应。从工程师的角度来看,这项工作简化为提示 Orion AI 并验证其反馈的发现。
实时监控与减少警报疲劳
Orion AI 消除了 15 分钟的 SRE-to-data-team 报告延迟,用持续的跨系统可见性取代了周期性的手动检查。
Orion AI 通过去重、阈值过滤和跨信号关联,将冗余警报的中位数减少了 65%。以前每生成 10 条警报,现在只有 3–4 条会到达工程师手中。警报直接路由到负责的团队,无需中间警报层。
关键设计原则
三个决策塑造了 Orion AI,你也可以将它们应用到你自己的多智能体项目中:
- 按领域而非任务复杂度拆分智能体: 每个智能体针对一个运营领域承载一组窄化的工具集成。这使模型的上下文保持聚焦并提高工具选择的准确性,而不是让一个通用智能体包揽所有事情。
- 默认使用关键词路由,退回到语义搜索: 可预测的请求通过关键词匹配以保证速度。模糊的请求退回到语义搜索以保证准确性。这在更困难的查询上不牺牲正确性的同时保持了低延迟。
- 将对话记忆限定于会话范围,实时指标绕过记忆: 持久记忆支持多轮对话,但运营类问题总是读取当前系统状态。实时指标绕过记忆有助于防止过期数据污染实时诊断。
架构概述
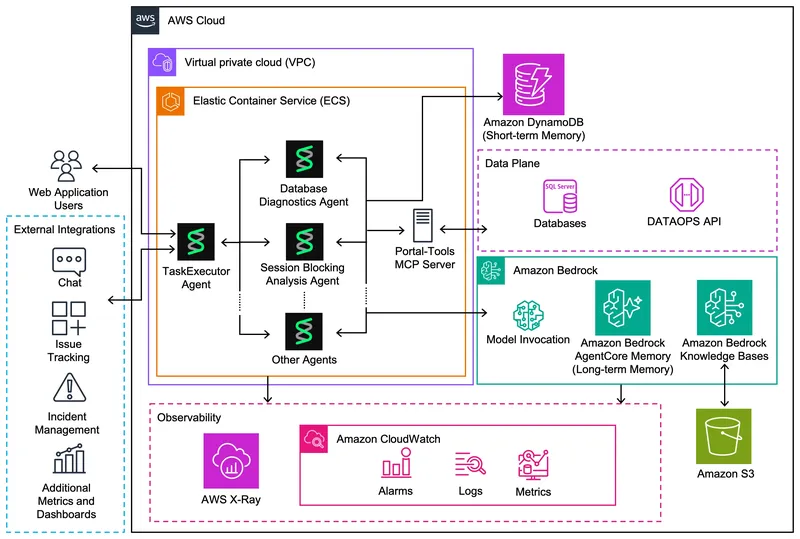
Orion AI 以容器化服务的形式部署在 Amazon Elastic Container Service (Amazon ECS)上。用户通过一个 Web 应用程序进行交互,该程序将每个请求路由到相应的智能体,调用所需的工具,并组装响应。下图展示了这些组件在 AWS 云中的连接方式。
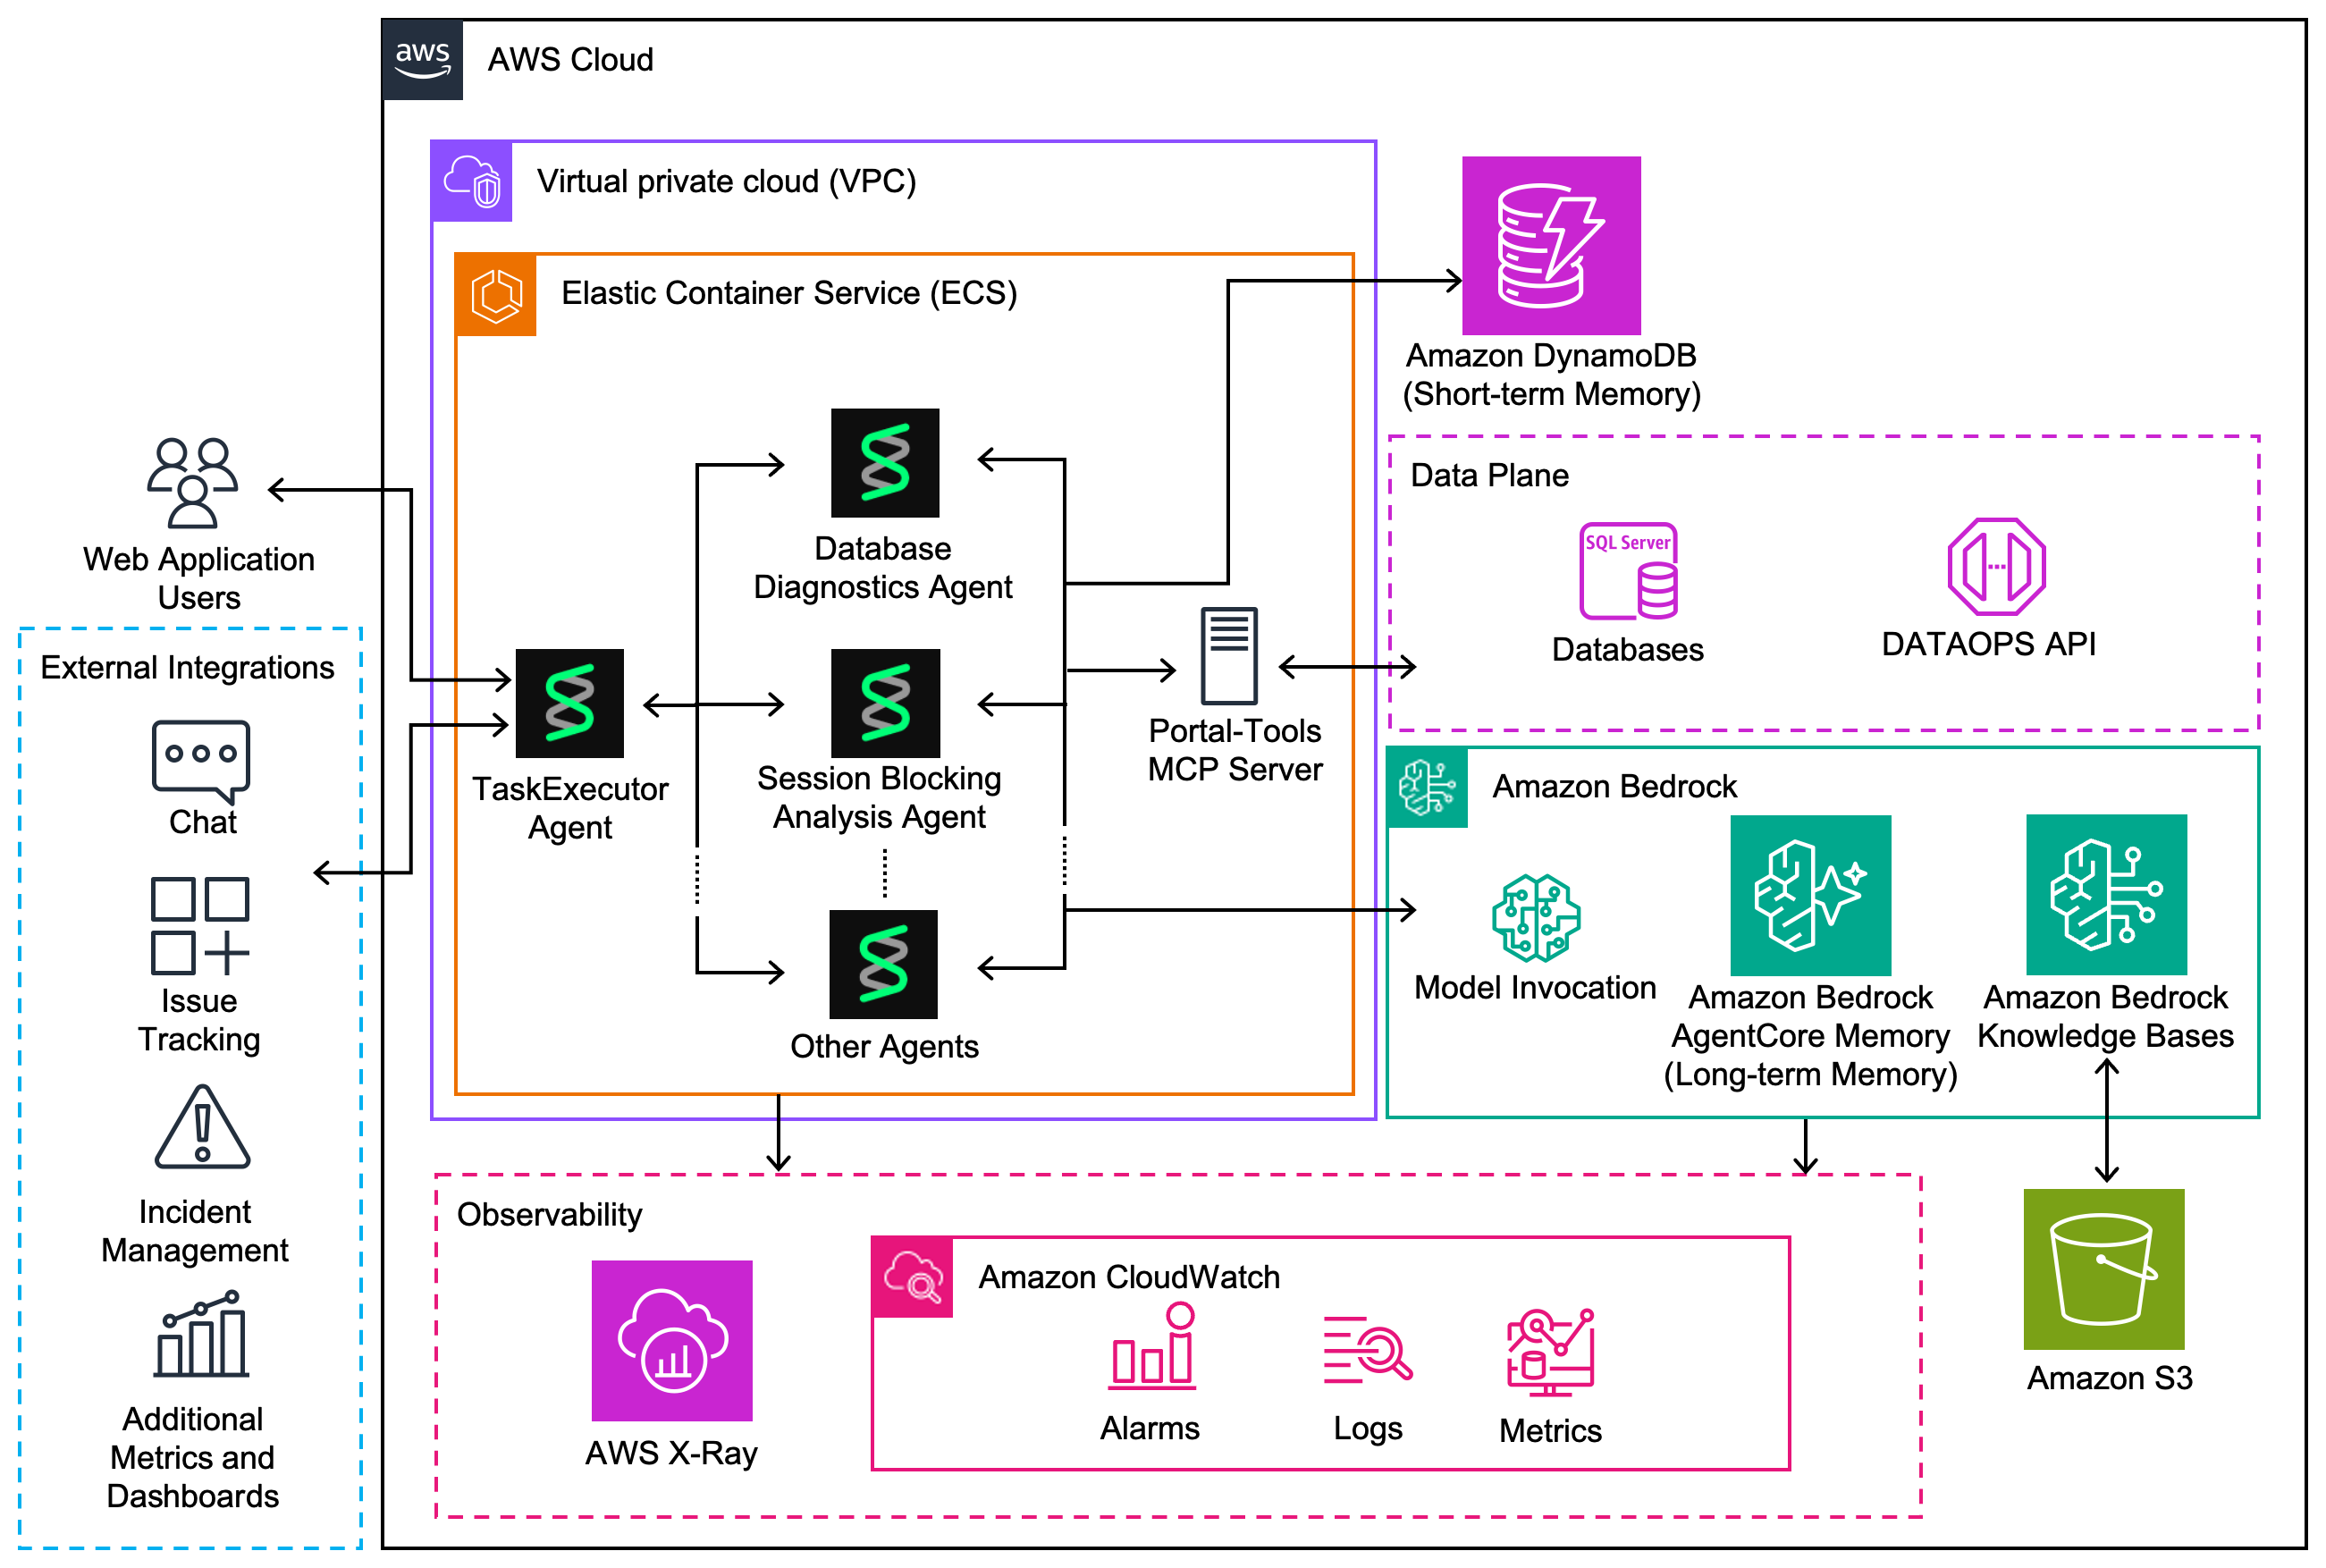
图 1:Orion AI 架构:Amazon ECS 上的元编排器将请求路由到专门的智能体,这些智能体通过 Portal-Tools MCP 服务器访问数据源,并使用 Amazon Bedrock 提供模型、长期记忆和检索增强生成
架构深入解析
前面的设计原则在架构中得到了具体体现。本节其余部分将逐一介绍 Orion AI 的核心组件。
使用 Strands Agents 构建中心辐射模式
Orion AI 使用少量 Strands Agents 原语来表达其拓扑结构。 Agent 类是专家智能体和元编排器的共同构建块。每个智能体的工具都是标有 @tool 装饰器的普通 Python 函数。该装饰器根据函数的类型提示和文档字符串推导出工具规范,因此无需维护单独的模式。 BedrockModel 包装每个智能体所运行的 Amazon Bedrock 模型,而 MCPClient 将智能体连接到外部工具服务器。
拓扑结构如下:
- 中心是单个 Strands Agent,充当元编排器(TaskExecutor)。它不持有任何领域工具——只有路由工具(
find_relevant_agents,call_agent)和控制流工具(emit_plan_step,emit_confirmation_gate),以便逐步推理请求。 - 分支是独立的
Agent实例,通过基于装饰器的注册表懒加载。每个分支都拥有自己的模型、领域工具和本地化系统提示词。
在运行时,中心通过已注册的 call_agent 工具按名称调用专家智能体。每个专家智能体运行自己的工具调用循环,并将合成后的文本返回给中心,由中心组装最终响应。
混合路由
Orion AI 采用关键词优先、语义搜索兜底的路由方式。大约 80% 的查询通过内存中的关键词快速路径在不到一毫秒内完成解析。当关键词不足以判断意图时,系统会回退到由 Amazon Titan Text Embeddings V2 提供支持的语义搜索,按含义进行路由。有关各 AWS 区域的模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型.
当直接工具调用不合适时,会启用一条回退链: Amazon Bedrock Knowledge Bases作为完全托管的检索增强生成(RAG)能力,它会检索运维文档,使回复基于经批准的流程,而不是在没有上下文的情况下生成。
领域特定智能体及其边界
Orion AI 使用 13 个领域专用代理。三个 SQL Server 代理说明了领域划分如何对应真实调查的各个阶段:
- 数据库诊断代理 呈现阻塞链、等待类型和长时间运行的查询,然后将技术发现转化为业务影响并提供修复建议。它回答的是“正在发生什么以及这意味着什么”。
- 会话阻断分析代理 通过推理模型运行多步骤调查,将阻塞链映射到根本阻塞点。它能回答“为什么会发生这种情况,根本原因是什么”,并提供从立即终止会话到长期架构修复的优先建议。
- 实时SQL诊断代理 通过 Cornerstone 的 DATAOPS API 直接查询 SQL Server 实例,以获取实时阻塞数据和高 CPU 会话分析。它回答的是“当前真实情况是什么”。
剩余的代理遵循相同的窄域负责原则:基础设施监控、运营分析、数据库生命周期管理、客户分析、来自运行手册的知识检索、通知路由、复合查询分解、可用性组侦听器解析以及模型连接预热。
工具集成与服务连接
Orion AI 通过两种模式访问数据源:
- 模型上下文协议 (MCP) 供多个智能体共享的工具(例如实时SQL诊断)。一个Strands
@tool函数调用一MCPClient通过流式 HTTP 连接到 Portal-Tools MCP 服务器,该服务器再访问 SQL Server 和 DATAOPS API。Jira 集成则通过外部 Atlassian MCP 工具采用相同方式实现。 - 直接 SDK 或 REST API 调用 用于不需要共享 MCP 接口的数据源。这包括指标和仪表板、值班安排表,以及通过 AWS SDK for Python (Boto3).
访问的 Amazon Bedrock Knowledge Bases。这种划分意味着每个智能体都使用最适合其数据源的最轻量机制,而 MCP 服务器则集中管理多个智能体共享的工具。这些连接通过 TLS 运行,诸如 MCP 令牌和 REST API 授权等凭据按请求提供,而非嵌入在智能体代码中。
对话记忆
Amazon Bedrock AgentCore是一个可以使用任何框架或模型大规模构建、连接和优化智能体的平台,它提供跨会话记忆层。Orion AI 通过一个中央记忆管理器协调上下文,该管理器并行读取三个层级,每个层级都有各自独立的超时和令牌分配。
Orion AI 跨三个层级协调上下文。短期记忆通过 Amazon DynamoDB保存同一会话内的上下文,该数据库默认静态加密,并配有由 Amazon Nova 2 Lite 异步生成的滚动会话摘要。长期记忆通过 AgentCore memory 提供跨会话召回,这是 Amazon Bedrock AgentCore 的一项功能,按用户 ID 进行命名空间隔离。在任务完成时,Orion AI 调用 create_event 以触发自动化的提取、摘要和整合。第三个层级是智能体间记忆,它是一个临时的内存暂存区,用于在单个任务内的各子智能体步骤之间传递发现结果。
内存管理器在500毫秒的硬超时和4,000个token的预算内跨各层级进行检索,并由最近最少使用缓存作为支撑。当请求涉及当前系统状态时,智能体会完全绕过内存而直接读取实时数据,从而避免过时的上下文污染实时诊断。
负责任的AI与防护栏
由于DataOps安全依赖于特定领域的规则(例如哪些数据库操作具有破坏性),团队构建了自定义的防护栏逻辑,而不是依赖通用的内容过滤器。Orion AI在四个层级上应用控制:
- 提示词级别的安全约束 注入到每个智能体的系统提示词中,阻止危险的推荐操作(例如终止关键数据库进程),并强制使用非破坏性的方法。
- 人在回路中的确认门控 在执行破坏性操作前暂停,等待用户在五分钟窗口内确认,超时则默认拒绝。
- 用于输入验证的自定义防护栏模块 (长度限制、提示词注入和SQL注入拦截)、输出净化(脱敏机密信息和个人身份信息)、速率限制、基于角色的访问控制以及按请求的成本跟踪。
- 路由级别的保护 阻止从内存回答运维查询,强制针对当前状态的问题执行实时工具调用。
可观测性
Orion AI使用标准的AWS可观测性服务进行监控和调试。 Amazon CloudWatch 为路由置信度、延迟和智能体调用活动提供指标和结构化日志。 AWS X-Ray 跨智能体执行追踪分布式调用,实现端到端请求路径的可视化。
经验教训
让 Orion AI 成为可能的设计决策是您可以复用的。按领域拆分代理使每个代理都能携带狭窄的工具集成,而不会撑爆单一模型的上下文。默认使用关键词路由并以语义搜索作为回退,在不对模糊请求牺牲准确性的情况下保持了低延迟。将会话记忆限定在会话范围内,同时对实时指标绕过该记忆,保证了实时诊断的可信度。
团队还做出了务实的基础设施选择。他们将在 Amazon ECS 上部署计算,因为 Amazon Bedrock AgentCore runtime——Amazon Bedrock AgentCore 的一项能力——在项目开始时尚未可用,他们目前正在评估将其作为未来的迁移选项。如果您今天正在构建,请为自己的技术栈权衡同样的取舍:从现在稳定可用的方案开始,并随着托管能力的成熟重新审视。
结论
Orion AI 将数据库诊断时间从 45 分钟缩短到 10 分钟,避免了 70% 的手动生命周期步骤,并将告警噪音降低了 65%。一个三人团队在 Amazon Bedrock 上用六个月交付了它。这些结果背后的模式是其他运营团队可以采用的:领域范围的代理、混合路由,以及带有实时指标绕过的会话范围记忆。
要开始使用 AWS 上的多代理编排,请查看 AWS Solutions Library guidance.