
企业组织正在采用检索增强生成(RAG)来从 Microsoft SharePoint、Google Drive 和 Atlassian Confluence 等公司知识来源中挖掘洞察。然而,这些知识来源包含受复杂权限结构约束的敏感信息。确保 AI 生成的答案遵守这些权限是企业 AI 中最困难的挑战之一。
在这篇文章中,我们将探讨 Amazon Quick 和 Amazon Bedrock Knowledge Bases 如何通过实时访问控制列表(ACL)强制执行来解决这一挑战,在查询时直接向权威来源验证权限。
业务问题
考虑这样一个场景:一位 SharePoint 站点所有者为其组织创建了一个知识库。跨多个部门的团队成员使用 AI 助理从这个知识库中获取答案。关键要求是每个团队成员只能从其有权访问的文档中获得 AI 生成的洞察。
这是一个普遍的企业级挑战。组织希望在损害现有安全态势的前提下实现 AI 驱动洞察的普及化。AI 响应中只要出现一份未经授权的文档,就可能泄露机密战略文件、未发布的财务数据或敏感的人事信息。
为什么现有方法存在不足
RAG 访问控制的一种常见方法采用复制加过滤的方式来强制执行文档级权限。其典型工作方式如下:
- 数据源连接器(例如 SharePoint 连接器)在定期同步作业中拉取 ACL。
- ACL 从数据源复制而来,并作为属性存储在索引中。
- 在查询时,AI 系统将登录用户映射到存储的 ACL 属性,并据此过滤结果。
虽然这种方法表面上看起来合理,但它有三个根本性的弱点。
问题 1:AI 系统不是权威来源
在这种模型中,AI 系统独自承担强制执行的责任,却不是权限的权威来源。这要求数据连接器在各种数据源之间准确复制复杂的、特定于来源的 ACL 逻辑。每个数据源都有其独特的权限模型。在数十个连接器之间映射继承层次结构、组成员身份、条件访问策略和拒绝规则是一项容易出错的工作。
问题 2:过期的权限造成安全漏洞
一般来说,数据连接器支持按需运行或按客户定义的计划运行的拉取式同步。这些 AI 解决方案中的 ACL 只是上次同步运行时某个时间点的快照。一些解决方案使用基于事件的更新,但这并非普遍适用。例如,像 Confluence 这样的数据源在组成员身份发生变化时不会发出事件。在两次同步之间,访问权限已被撤销的用户可能仍然会从其不应再看到的文档中获得 AI 答案。
问题 3:数据源能力不断演进
数据源会定期更改或引入新的内容访问控制机制。SharePoint 中的新权限功能或 Google Drive 共享模型的更改都可能在 ACL 映射逻辑中造成漏洞。这可能使内容在连接器更新之前一直处于暴露状态。
AWS 如何解决这一问题:实时 ACL 强制执行
为了应对这些挑战,我们在 Amazon Quick 和 Amazon Bedrock Knowledge Bases 现有的检索前 ACL 过滤之上,将实时 ACL 检查作为额外的安全层来实施。这确保系统在查询时直接向权威来源检查权限,从而强制执行最新的访问控制。这避免了依赖可能过期或映射错误的 ACL 数据。
架构概览
下图展示了我们的混合方法,它同时提供语义搜索性能和实时安全能力。
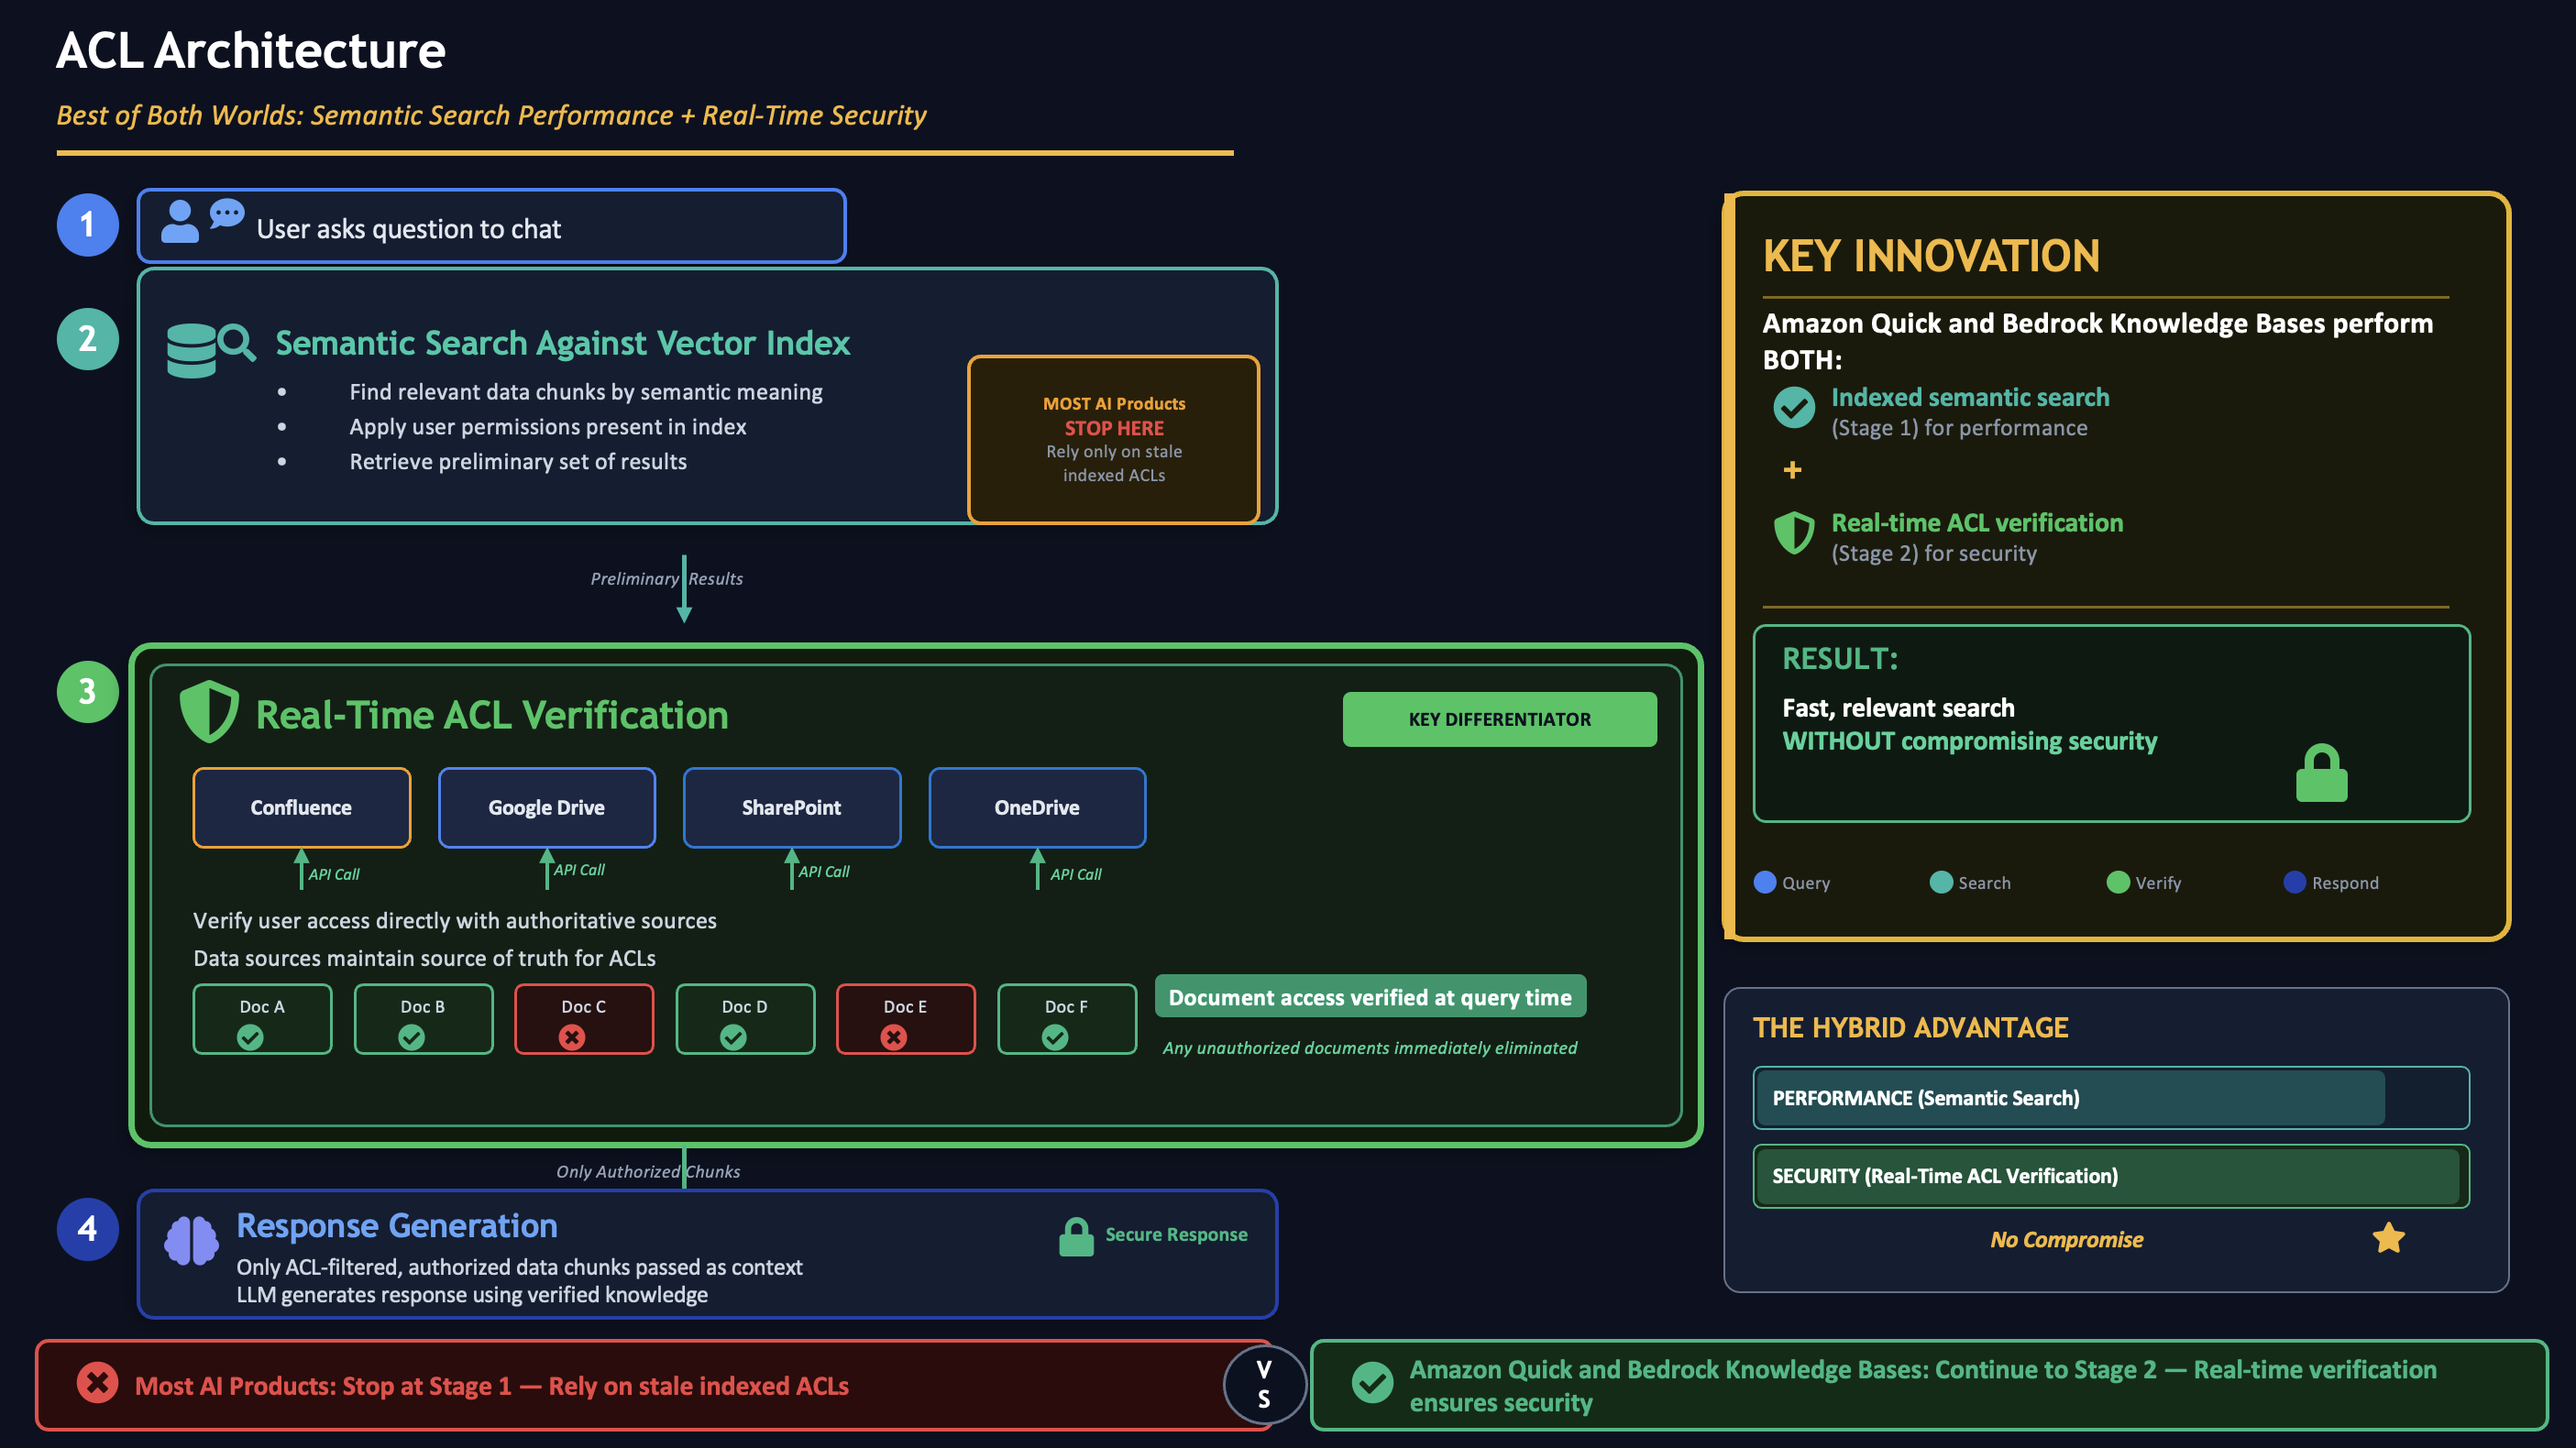
图 1:Amazon Quick 和 Amazon Bedrock Knowledge Bases 的实时 ACL 强制执行架构,将检索前过滤(阶段 1)与针对权威来源的实时验证(阶段 2)相结合
工作原理:以 Google Drive 为例
当用户向使用 Google Drive 知识库的 Amazon Quick 智能体提交查询时,系统分两个阶段强制执行访问控制:
阶段 1:检索前过滤
Amazon Quick 对向量索引执行语义搜索,以查找最相关的文档片段。系统会应用已存储在索引中的访问控制列表。这会产生一个初步的候选文档集合。这一阶段是必要的,因为对索引中的每个文档都进行实时 API 调用在规模化场景下成本过高。
阶段 2:实时验证
Amazon Quick 通过调用 Google Drive API 实时验证候选文档。它使用管理员提供的服务账号凭证,通过模拟(impersonation)生成特定于用户的访问令牌。Google Drive 维护着与每个文档关联的访问控制列表的权威数据源。用户无权访问的文档将从检索结果集中被排除。只有经过验证且获得授权的文档片段才会作为上下文传递给大型语言模型(LLM)。模型利用这些知识生成响应。
这种两阶段方法在性能与安全性之间取得平衡。它使用缓存的ACL以提高效率,同时通过实时检查确保正确性。除了ACL执行之外,Amazon Bedrock还提供负责任的AI控制措施,包括用于内容过滤的Amazon Bedrock Guardrails、减少幻觉的接地检查,以及帮助组织负责任地部署生成式AI应用的可配置安全策略。
为什么这对您的组织很重要
这种方法带来三大关键优势:
- 始终最新的权限 ——在使用RAG产品时,同步周期之间不再出现安全缺口。如果员工的访问权限被撤销,该变更会在几分钟内(而不是数小时或数天)反映到AI响应中。
- 放心扩展 ——组织可以扩展其知识库覆盖范围,因为实时ACL检查会在每次查询时与权威数据源核对权限,无论数据来源如何。
- 降低运维负担 ——您无需担心同步频率。
客户对此的评价
“当我们着手为组织评估AI解决方案时,我们的安全与合规团队明确了首要任务:确保同事只会看到他们有权访问的信息。这是一项基本要求,但许多平台难以真正解决这一问题。Amazon Quick的实时访问控制方法明确地回答了这个问题,并在我们的整个评估过程中展现出与众不同的严谨性。它让我们的内部评审委员会有信心向前推进,并为我们今后思考AI治理奠定了坚实的基础。”
——Mondelēz International公司M365创新高级专员Jamahl Wiggins
Mondelēz International已为四个地区超过35,000名员工部署了Amazon Quick。
结论
在这篇文章中,我们介绍了Amazon Quick和Amazon Bedrock Knowledge Bases如何实现实时ACL执行,以解决企业面临的一项关键安全挑战。这种双层ACL架构在查询时直接与权威数据源核对权限,确保AI生成的答案仅包含用户有权访问的内容。
要开始使用,请访问 Amazon Quick 和 Amazon Bedrock Knowledge Bases.