
核心要点
- 你现在可以将工具绑定到技能上。 工具的架构在被智能体读取其绑定的技能之前不会占用上下文,而且在支持会话中途添加新工具的模型上,添加工具不会破坏提示缓存。
- 应用可以在运行时固定技能,因此指令会在第一次模型调用之前就进入上下文,无需
read_file多次往返。 - 技能可以在会话中途重新加载,因此长时间运行的智能体可以在不开启新会话的情况下获取新增、编辑或删除的技能。
技能是为智能体提供领域知识的最佳方式之一。 技能 是一个包含指令、脚本和参考文件的文件夹,教会智能体如何做事,例如为客户会议做准备,或按照你的销售团队的方式审阅通话记录。Agent Skills 是一种 开放标准 ,可与任何模型配合使用,并得到 数十种智能体产品的支持。编写技能也不需要技术背景:技能的核心就是一个 markdown 文件。
技能之所以有效,是因为 渐进式披露机制。智能体一开始只能看到每个技能的名称和描述,只有当任务需要时才会读取完整指令。这使上下文保持精简,而 上下文工程 正是构建高效智能体的关键。
随着使用规模扩大,团队对技能的需求也在变化。我们看到企业级技能注册表已增长到数千个技能,并在团队和智能体之间共享。我们对 Deep Agents 中的技能支持 进行了革新,以解决一些常见的请求:
- 将工具绑定到技能: 绑定到技能的工具只在智能体读取该技能时才会加载。
- 固定技能: 当用户明确请求某个技能时,例如
/meeting-prep,你的应用可以在下一次模型调用之前加载它。 - 技能重新加载: 长时间运行的会话可以在不重新开始的情况下获取新增或更改的技能。
技能的运作方式
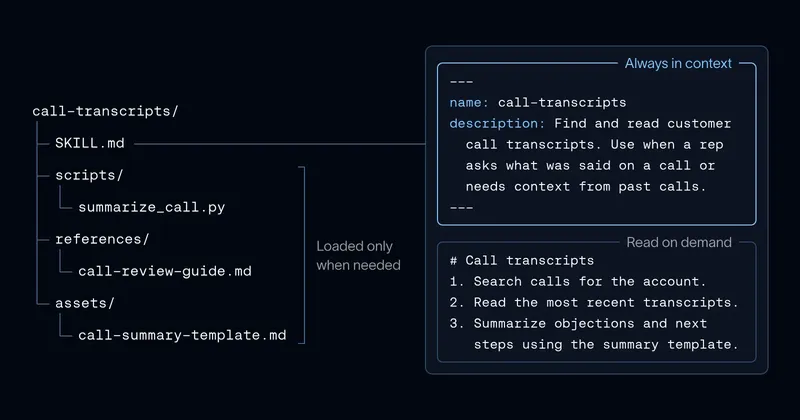
技能是一个包含以下内容的目录 SKILL.md 文件:包含 YAML frontmatter 的 name 和 description,随后是智能体所遵循的指令。技能还可以在 scripts/, references/以及 assets/ (规格).
在这篇文章中,我们将使用 我们的GTM智能体 作为贯穿全文的运行示例。它构建于 深度智能体,其拥有超过50项技能的技能库涵盖了销售代表的日常重复性工作,例如 meeting-prep, call-transcripts以及 competitive-intel-card.
- 发现。 启动时,智能体会查看每个技能的
name和description在其系统提示词中。 - 激活。 当任务匹配到一项技能时,代理会读取完整的
SKILL.mdwithread_file. - 执行。 该智能体遵循指令,只有在脚本或参考文件被要求时才读取它们。
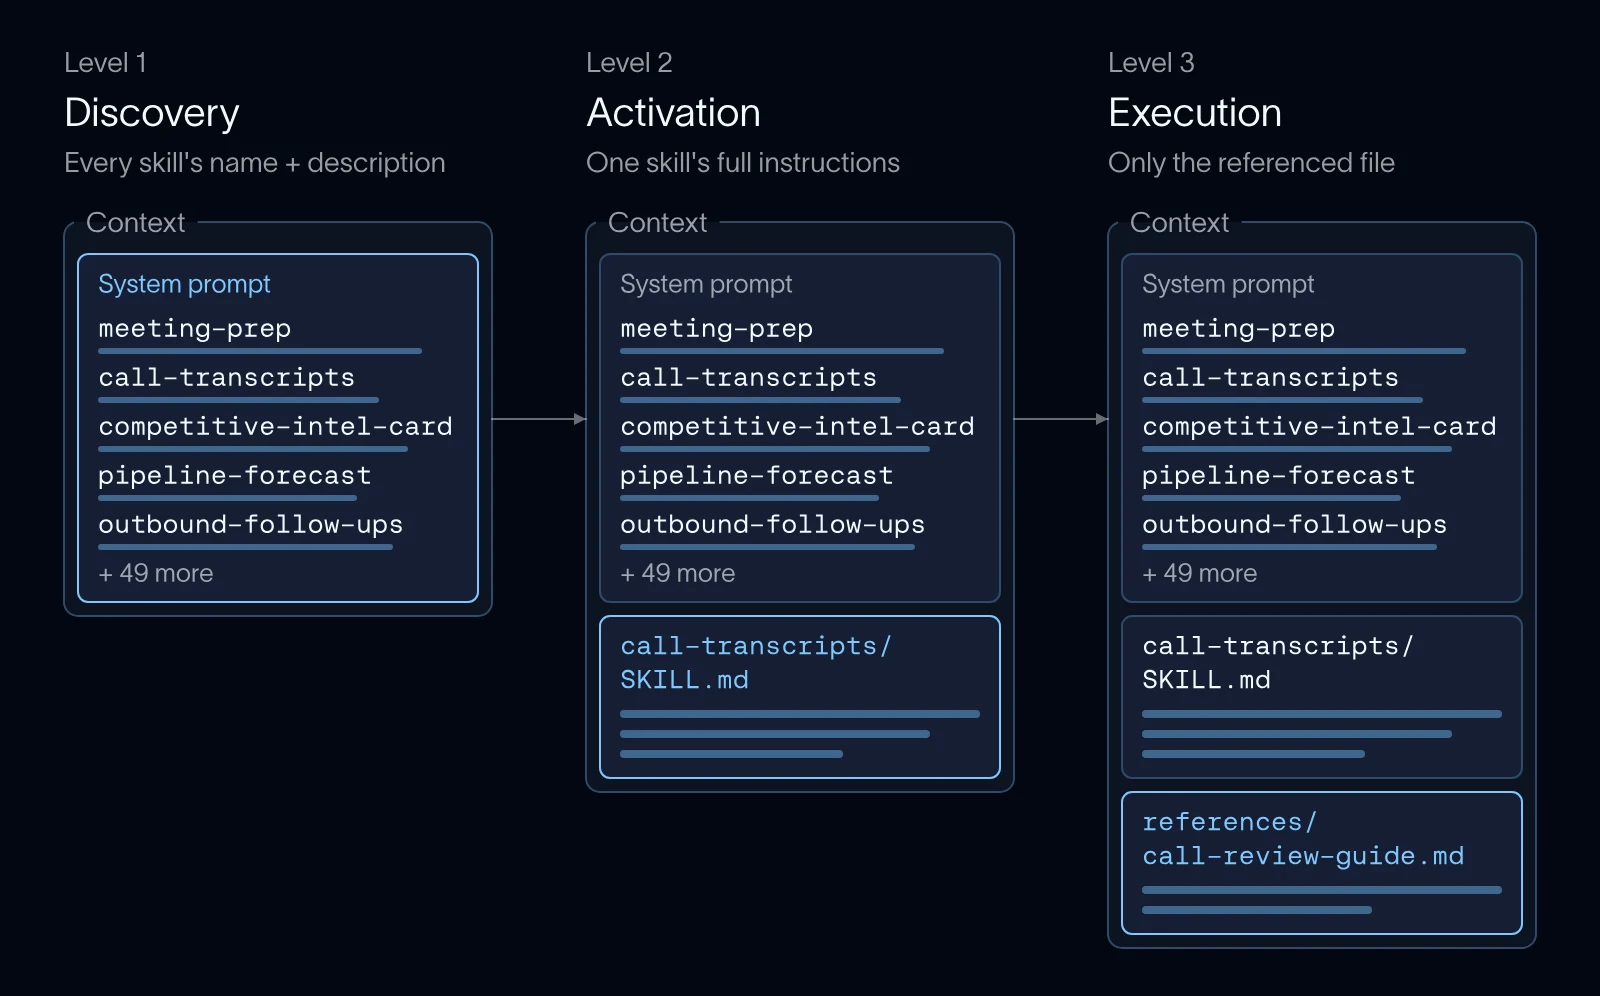
在技能被使用之前,它在系统提示词中只占一行,因此一个库可以容纳大量技能的引用而不会挤占上下文。现在让我们来看看我们在 Deep Agents 中所做的增强。
将工具绑定到技能
技能通常会告诉智能体如何使用特定的工具,而某些工具只有在智能体阅读了那些说明之后才能良好运作。此前,技能和工具是分开披露的。你可以通过 工具搜索,但没有任何机制将工具与解释它的技能关联起来:智能体可以在不阅读技能的情况下找到并调用工具,或者阅读了技能之后还得去搜索对应的工具。
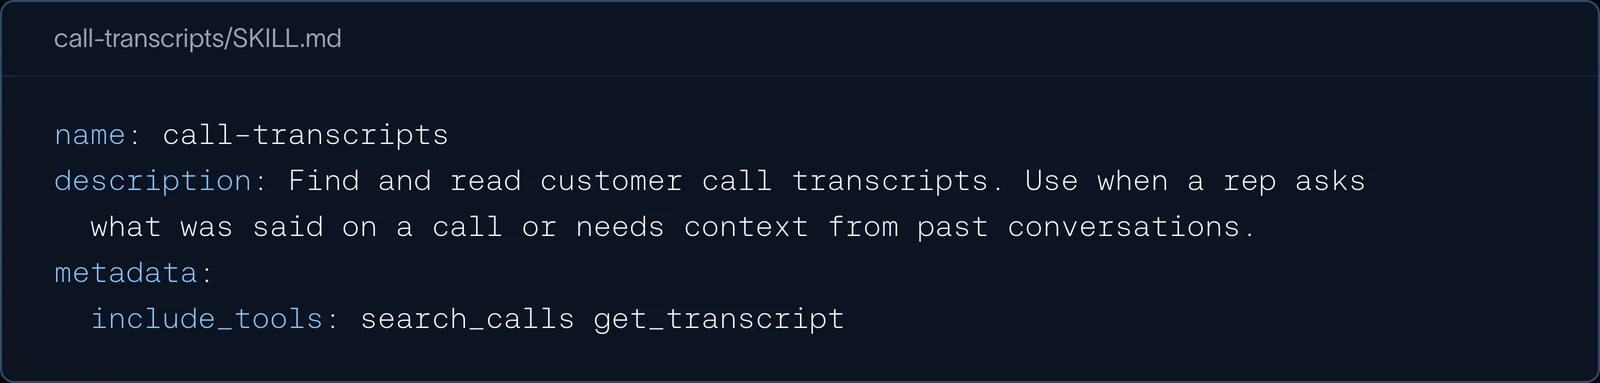
现在您可以 将工具绑定到一个技能,因此技能及其工具是一起披露的。被绑定的工具在代理读取其技能之前不会添加到上下文中,而在此之前调用它会因未知工具而失败。这样既保持了上下文的精简,也意味着代理在调用工具之前已经阅读过如何使用它。在我们的 GTM 代理, call-transcripts 中解释了如何搜索通话和阅读转录文本,所以它是绑定这些工具的天然位置。
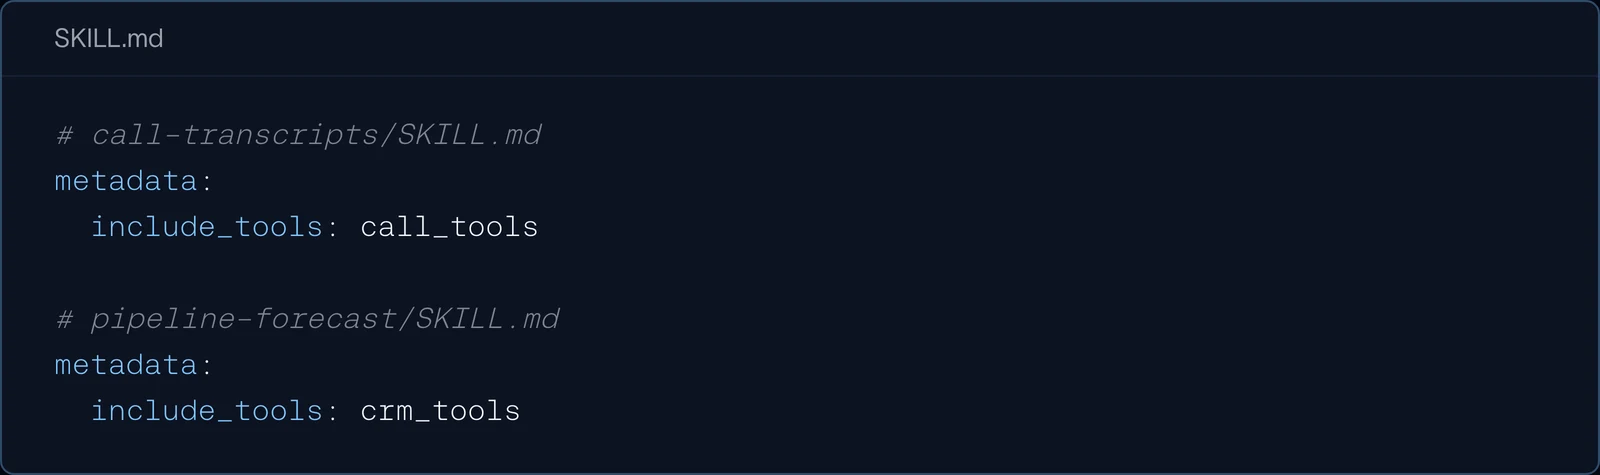
在技能的 frontmatter 中列出工具,放在 metadata.include_tools:
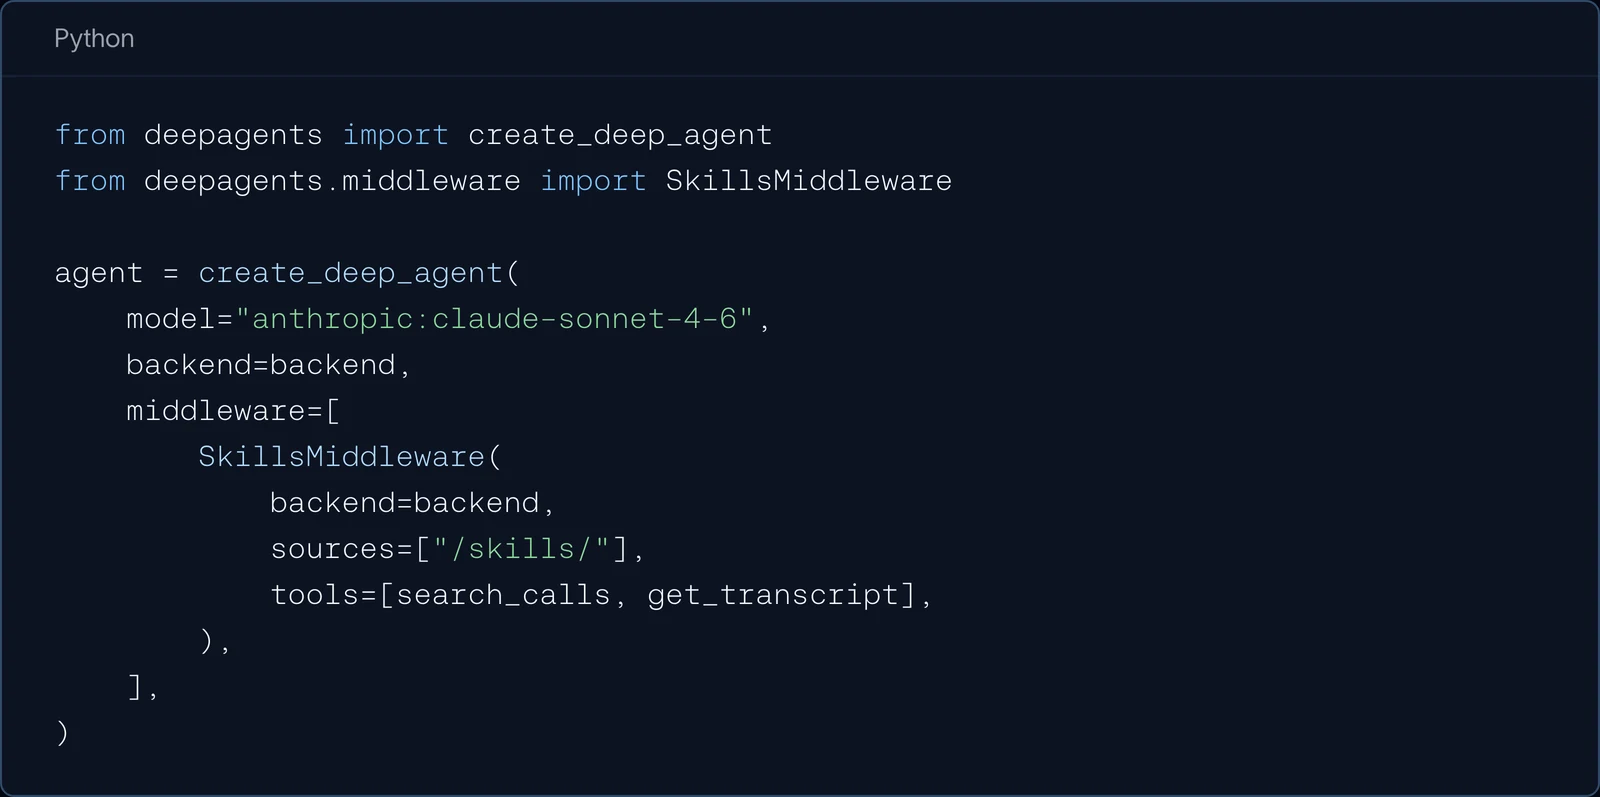
把这些工具传递给 SkillsMiddleware 而不是代理:
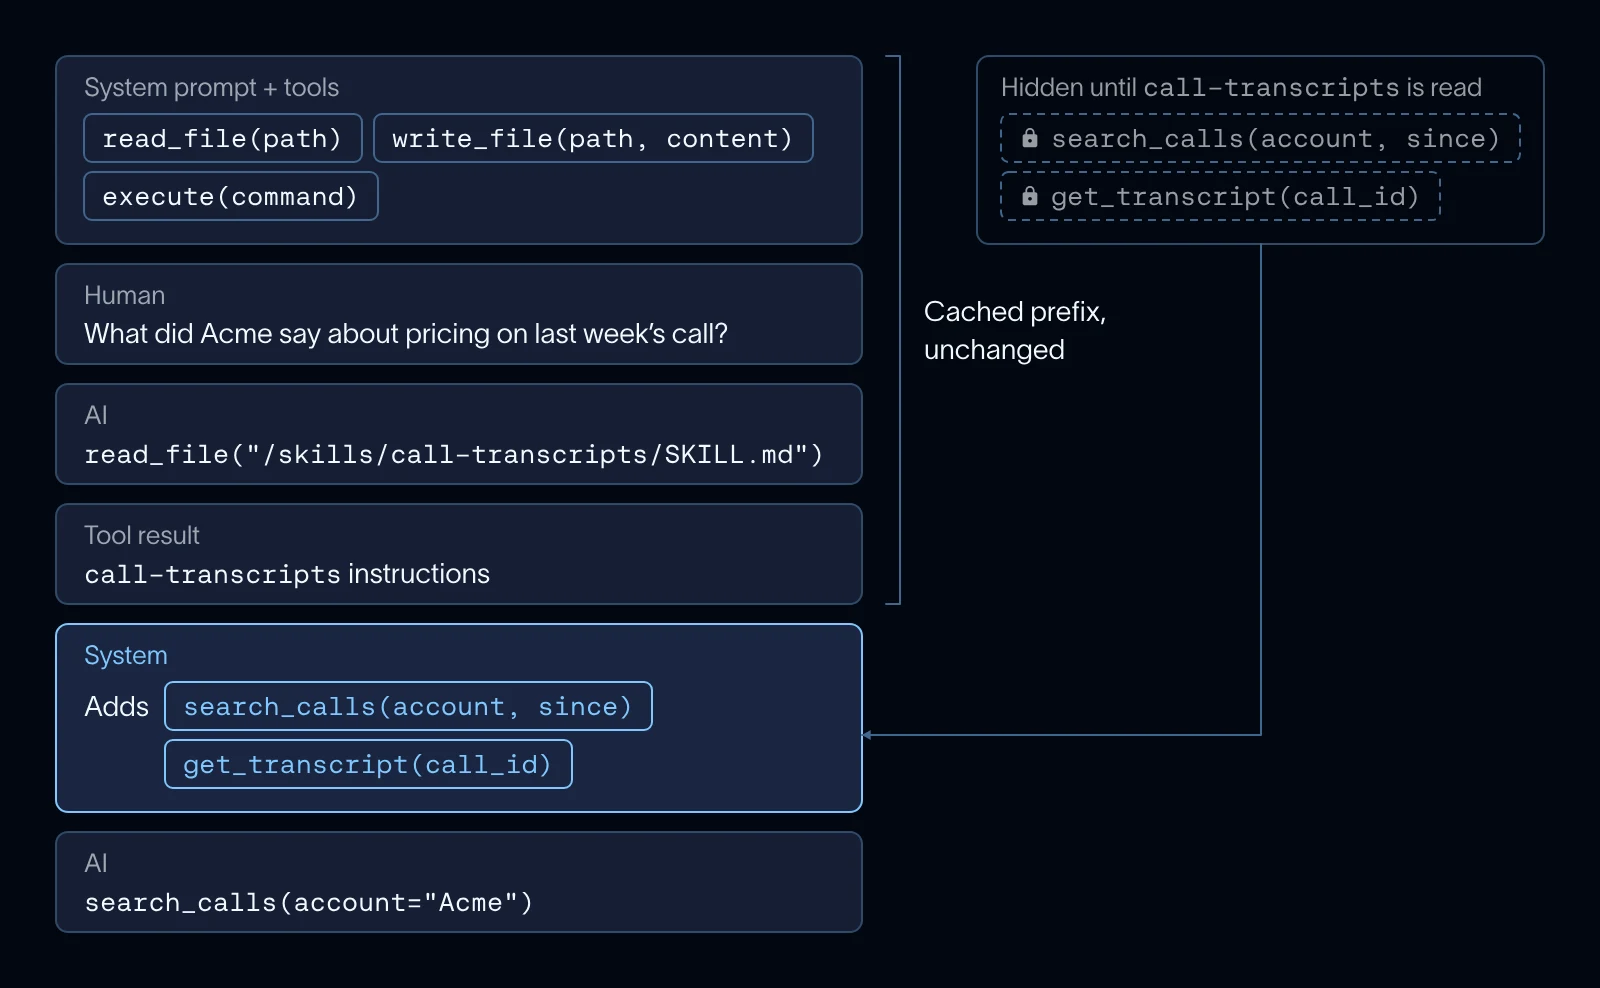
过去在对话中途添加工具意味着编辑请求的工具列表,这会使提示词缓存失效。 Anthropic 和 OpenAI 现在允许较新的模型在对话中途接受工具,因此在这些模型上,Deep Agents 会在读取技能后立即添加该技能绑定的工具,并且缓存前缀保持完好(Anthropic 和 OpenAI 集成文档)。在其他模型上,工具仍像以前一样附加到请求中。
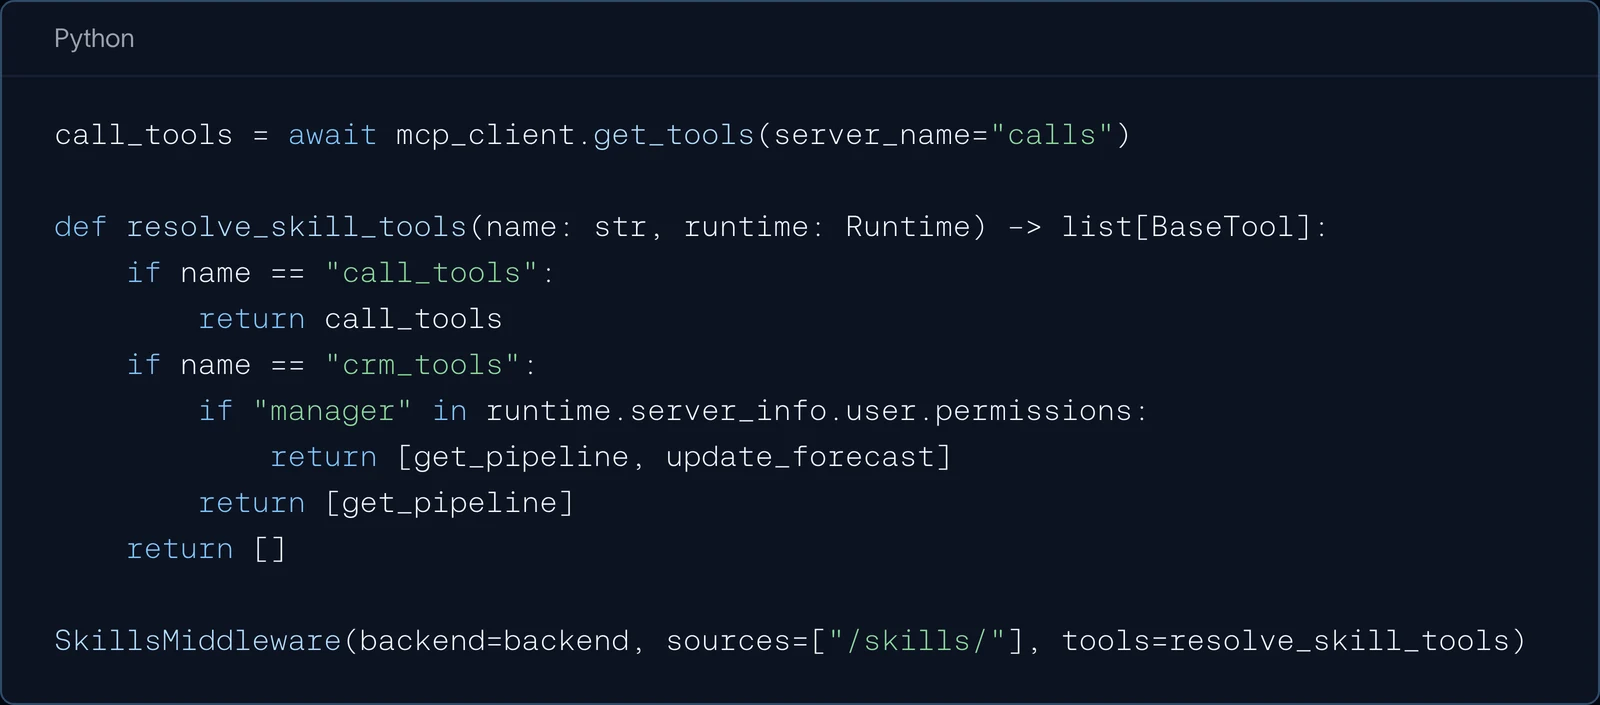
一个列表即可涵盖大多数技能。如需更多控制,技能可以列出标签而非工具名称,并由你传递给 SkillsMiddleware 的函数将每个标签转换为工具。这让你能够:
- 用一个名称披露整个工具组,例如 MCP 服务器上的每个工具,而无需在技能中逐个列出工具。
- 基于运行时权限对工具进行限制。 该函数会接收图的运行时,因此它可以检查用户身份,并只返回该用户被允许使用的工具。
在这里, call-transcripts 获取 calls MCP 服务器上的每个工具, pipeline-forecast 获取 CRM 工具,但只有经理才能更新预测:
详见 为技能添加工具 。
固定技能
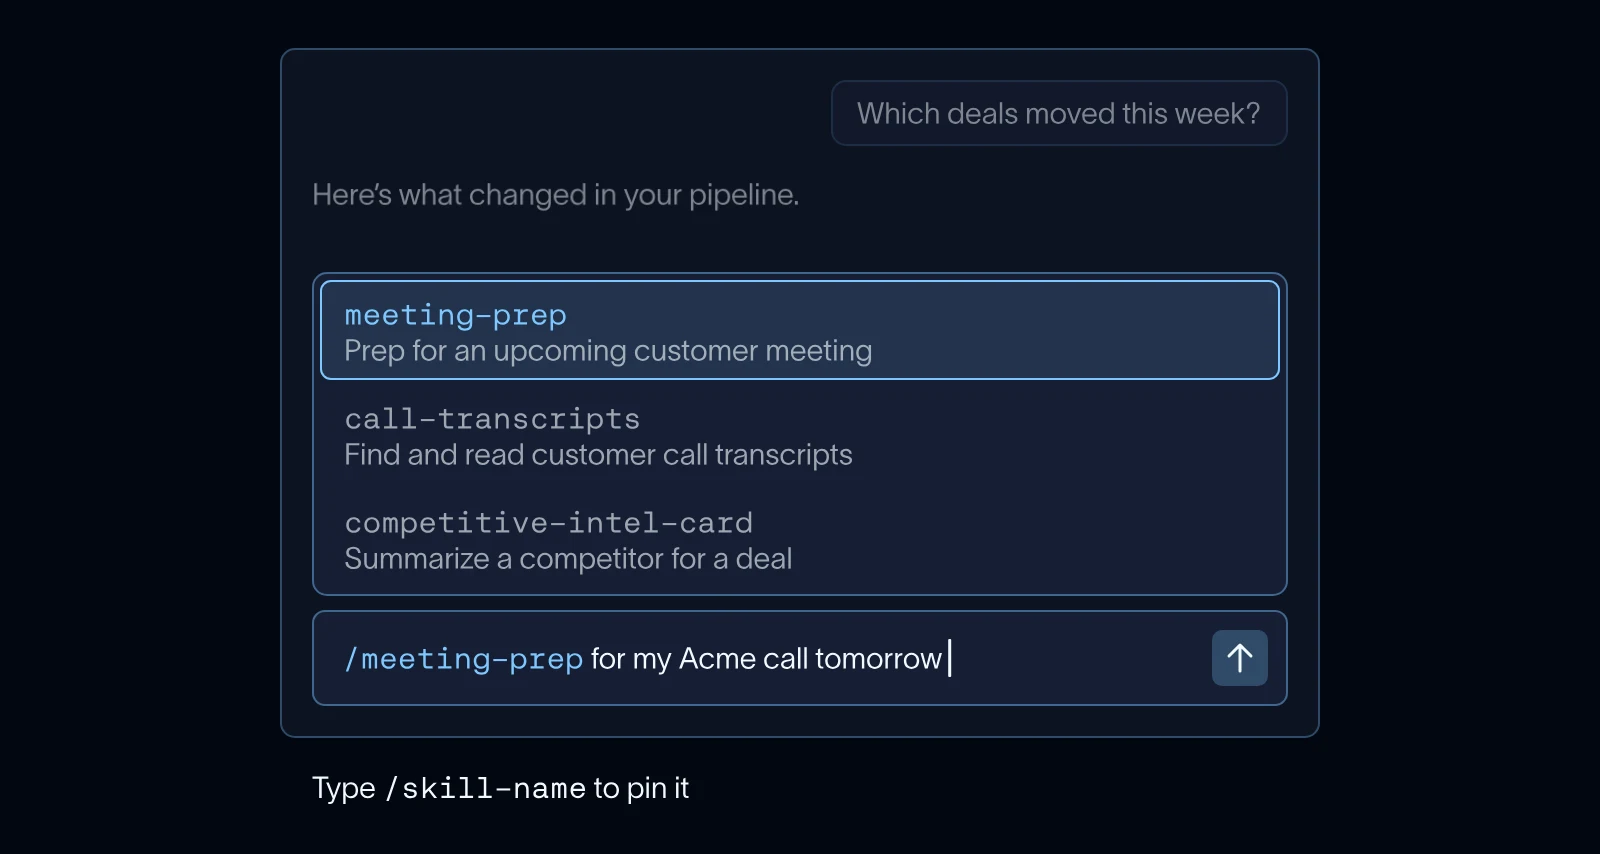
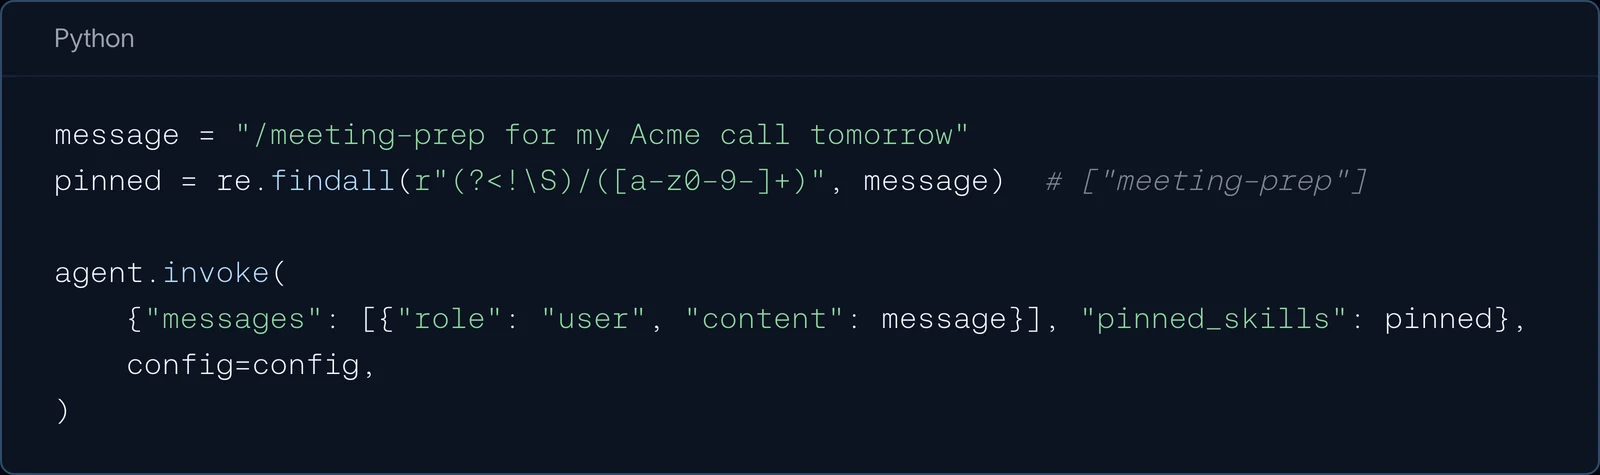
有时用户已经知道自己想要哪个技能。在我们的 GTM 代理中,销售代表可以输入 /meeting-prep for my Acme call tomorrow。如果不固定,模型只能看到技能的描述,并且必须读取它。这在工作开始前增加了一个来回,而且模型也不能保证加载正确的技能。使用 固定技能时,你的应用会在消息中找到技能名称(或从 UI 解析),并将它们传入 pinned_skills,中间件会在下一次模型调用前把每个技能的指令添加到对话中。Deep Agents 本身不解析消息,因此由你选择语法:
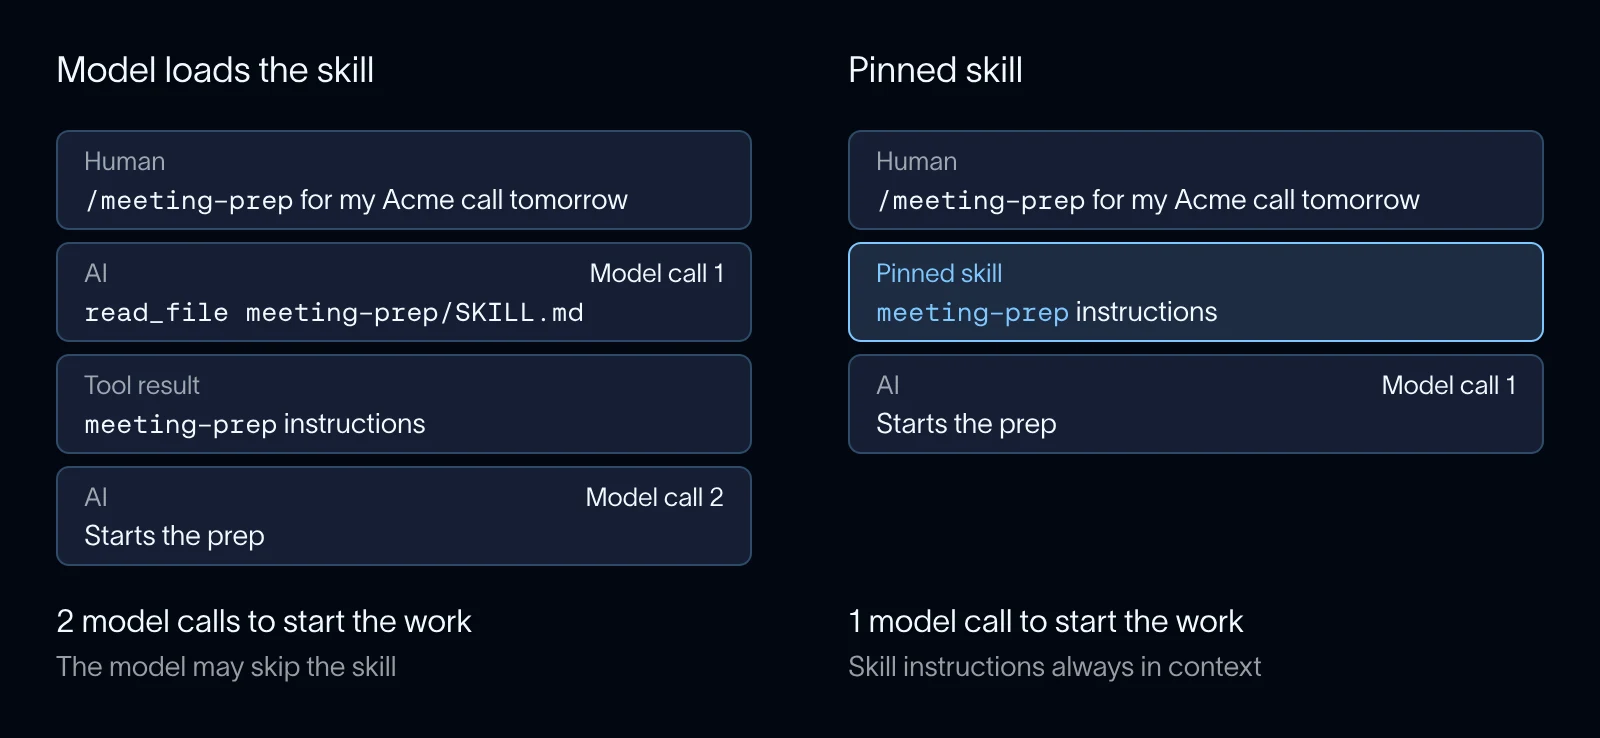
这降低了延迟并使行为更可预测:指令保证已在上下文中,且被固定的技能所绑定的工具也随之而来。每个被固定的技能只作为一条带标签的消息添加一次,因此更早的消息永不改变,提示缓存保持有效,聊天界面可以将技能显示为标签而非其全文。
在线程中途重新加载技能
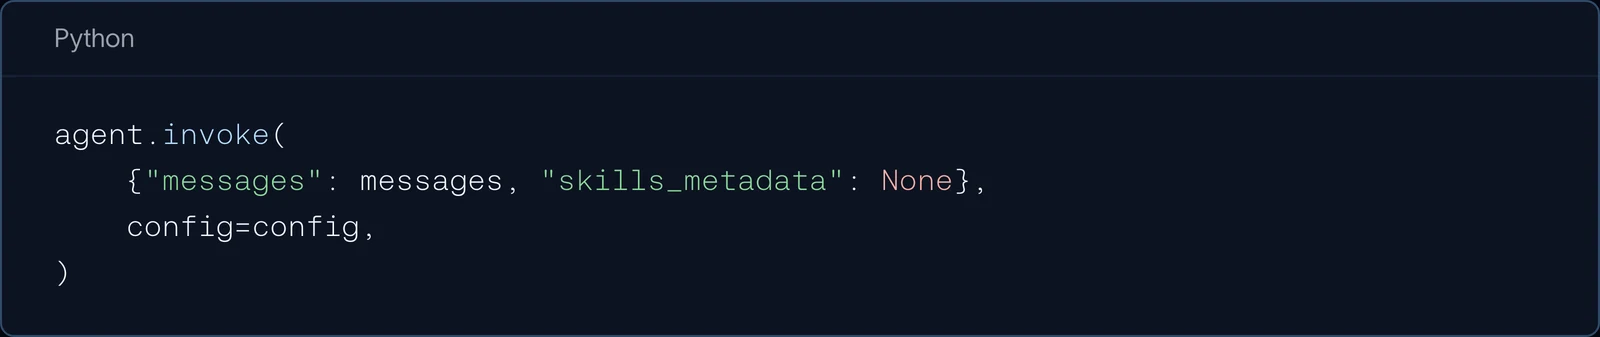
技能在每个线程开始时加载并保存在代理状态中,因此后续每一轮都复用同一组技能。你现在可以 使此列表失效 方法是在调用代理时将 skills_metadata 设置为 None 。如果队友向库中添加了一个 competitive-intel-card 技能,应用程序可以选择使技能列表失效,下一次运行将重新扫描每个来源:
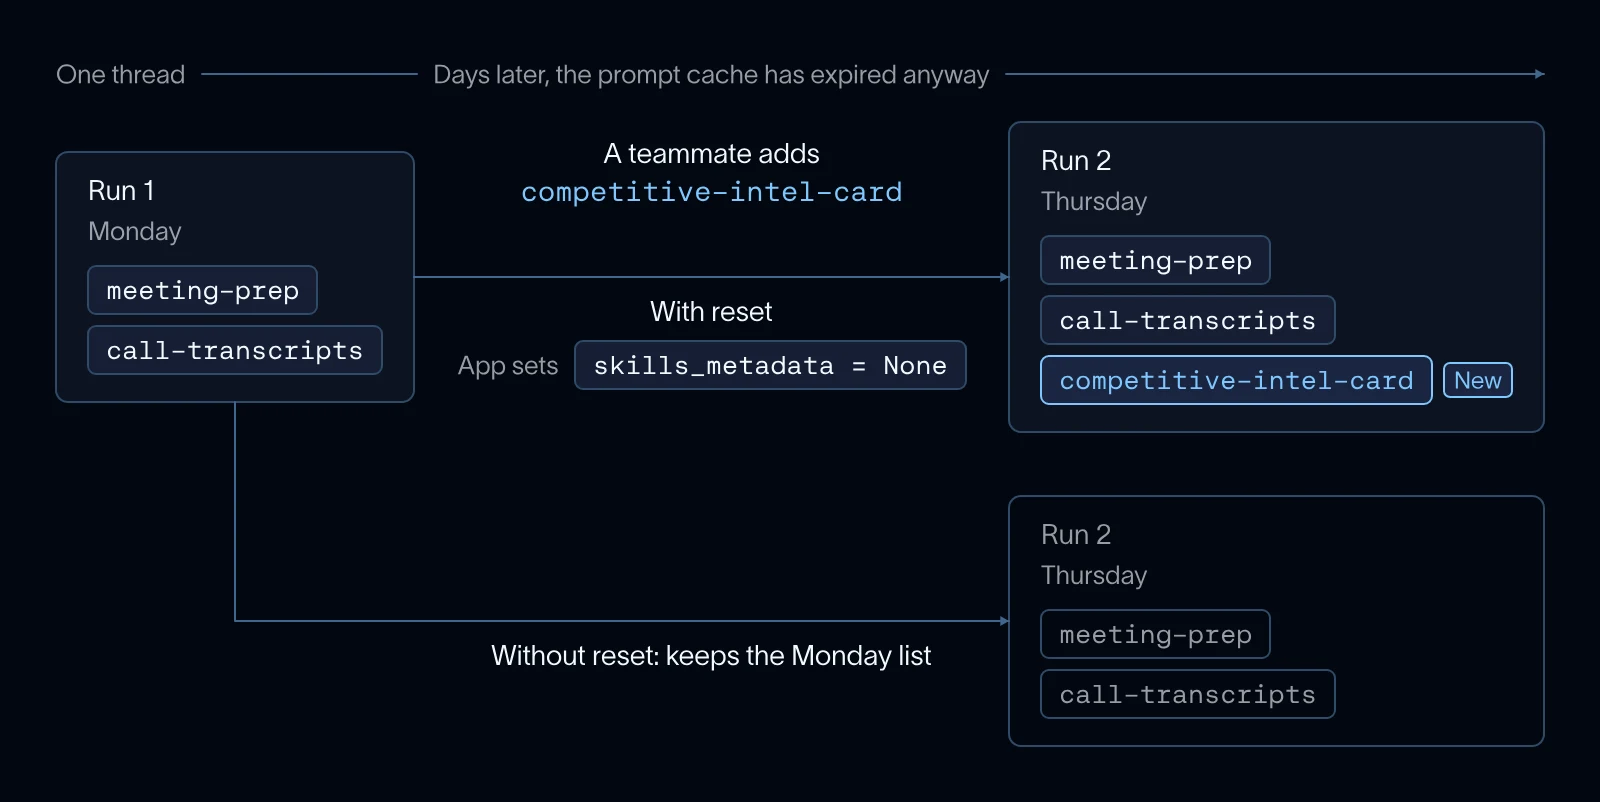
发现新技能的重载会更改系统提示,从而使提示缓存失效。对于一个闲置已久的线程,这一成本通常已经支付:提供商的缓存通常在闲置几分钟到一小时内过期(Anthropic, OpenAI),因此当销售代表回来时缓存早已失效。
由于重置只是运行输入,你也可以把控制权交给用户。例如,客户端一侧的一个 /reload 命令:
你还可以从 update_state 或从中间件进行重置,由你的应用控制何时发生技能重载。参见 Reload skills.
开始使用
技能是向代理提供有条理的领域知识的行业标准机制。这些更新使其更易于大规模运行:工具仅在技能需要时加载,工作流所需的技能预先加载,而长时间运行的线程会随着库的变化保持最新。由于技能是一个开放标准,你的团队编写的技能可以跨模型和代理使用。
所有这些均可在最新版本中获取 deepagents。请阅读 技能文档 立即上手,并通过以下方式告诉我们你的想法: GitHub issues、 论坛或 X.
致谢
感谢 Rich Scarrott 领导这些新功能的开发,并感谢 Hunter Lovell 进行功能与博客审阅!