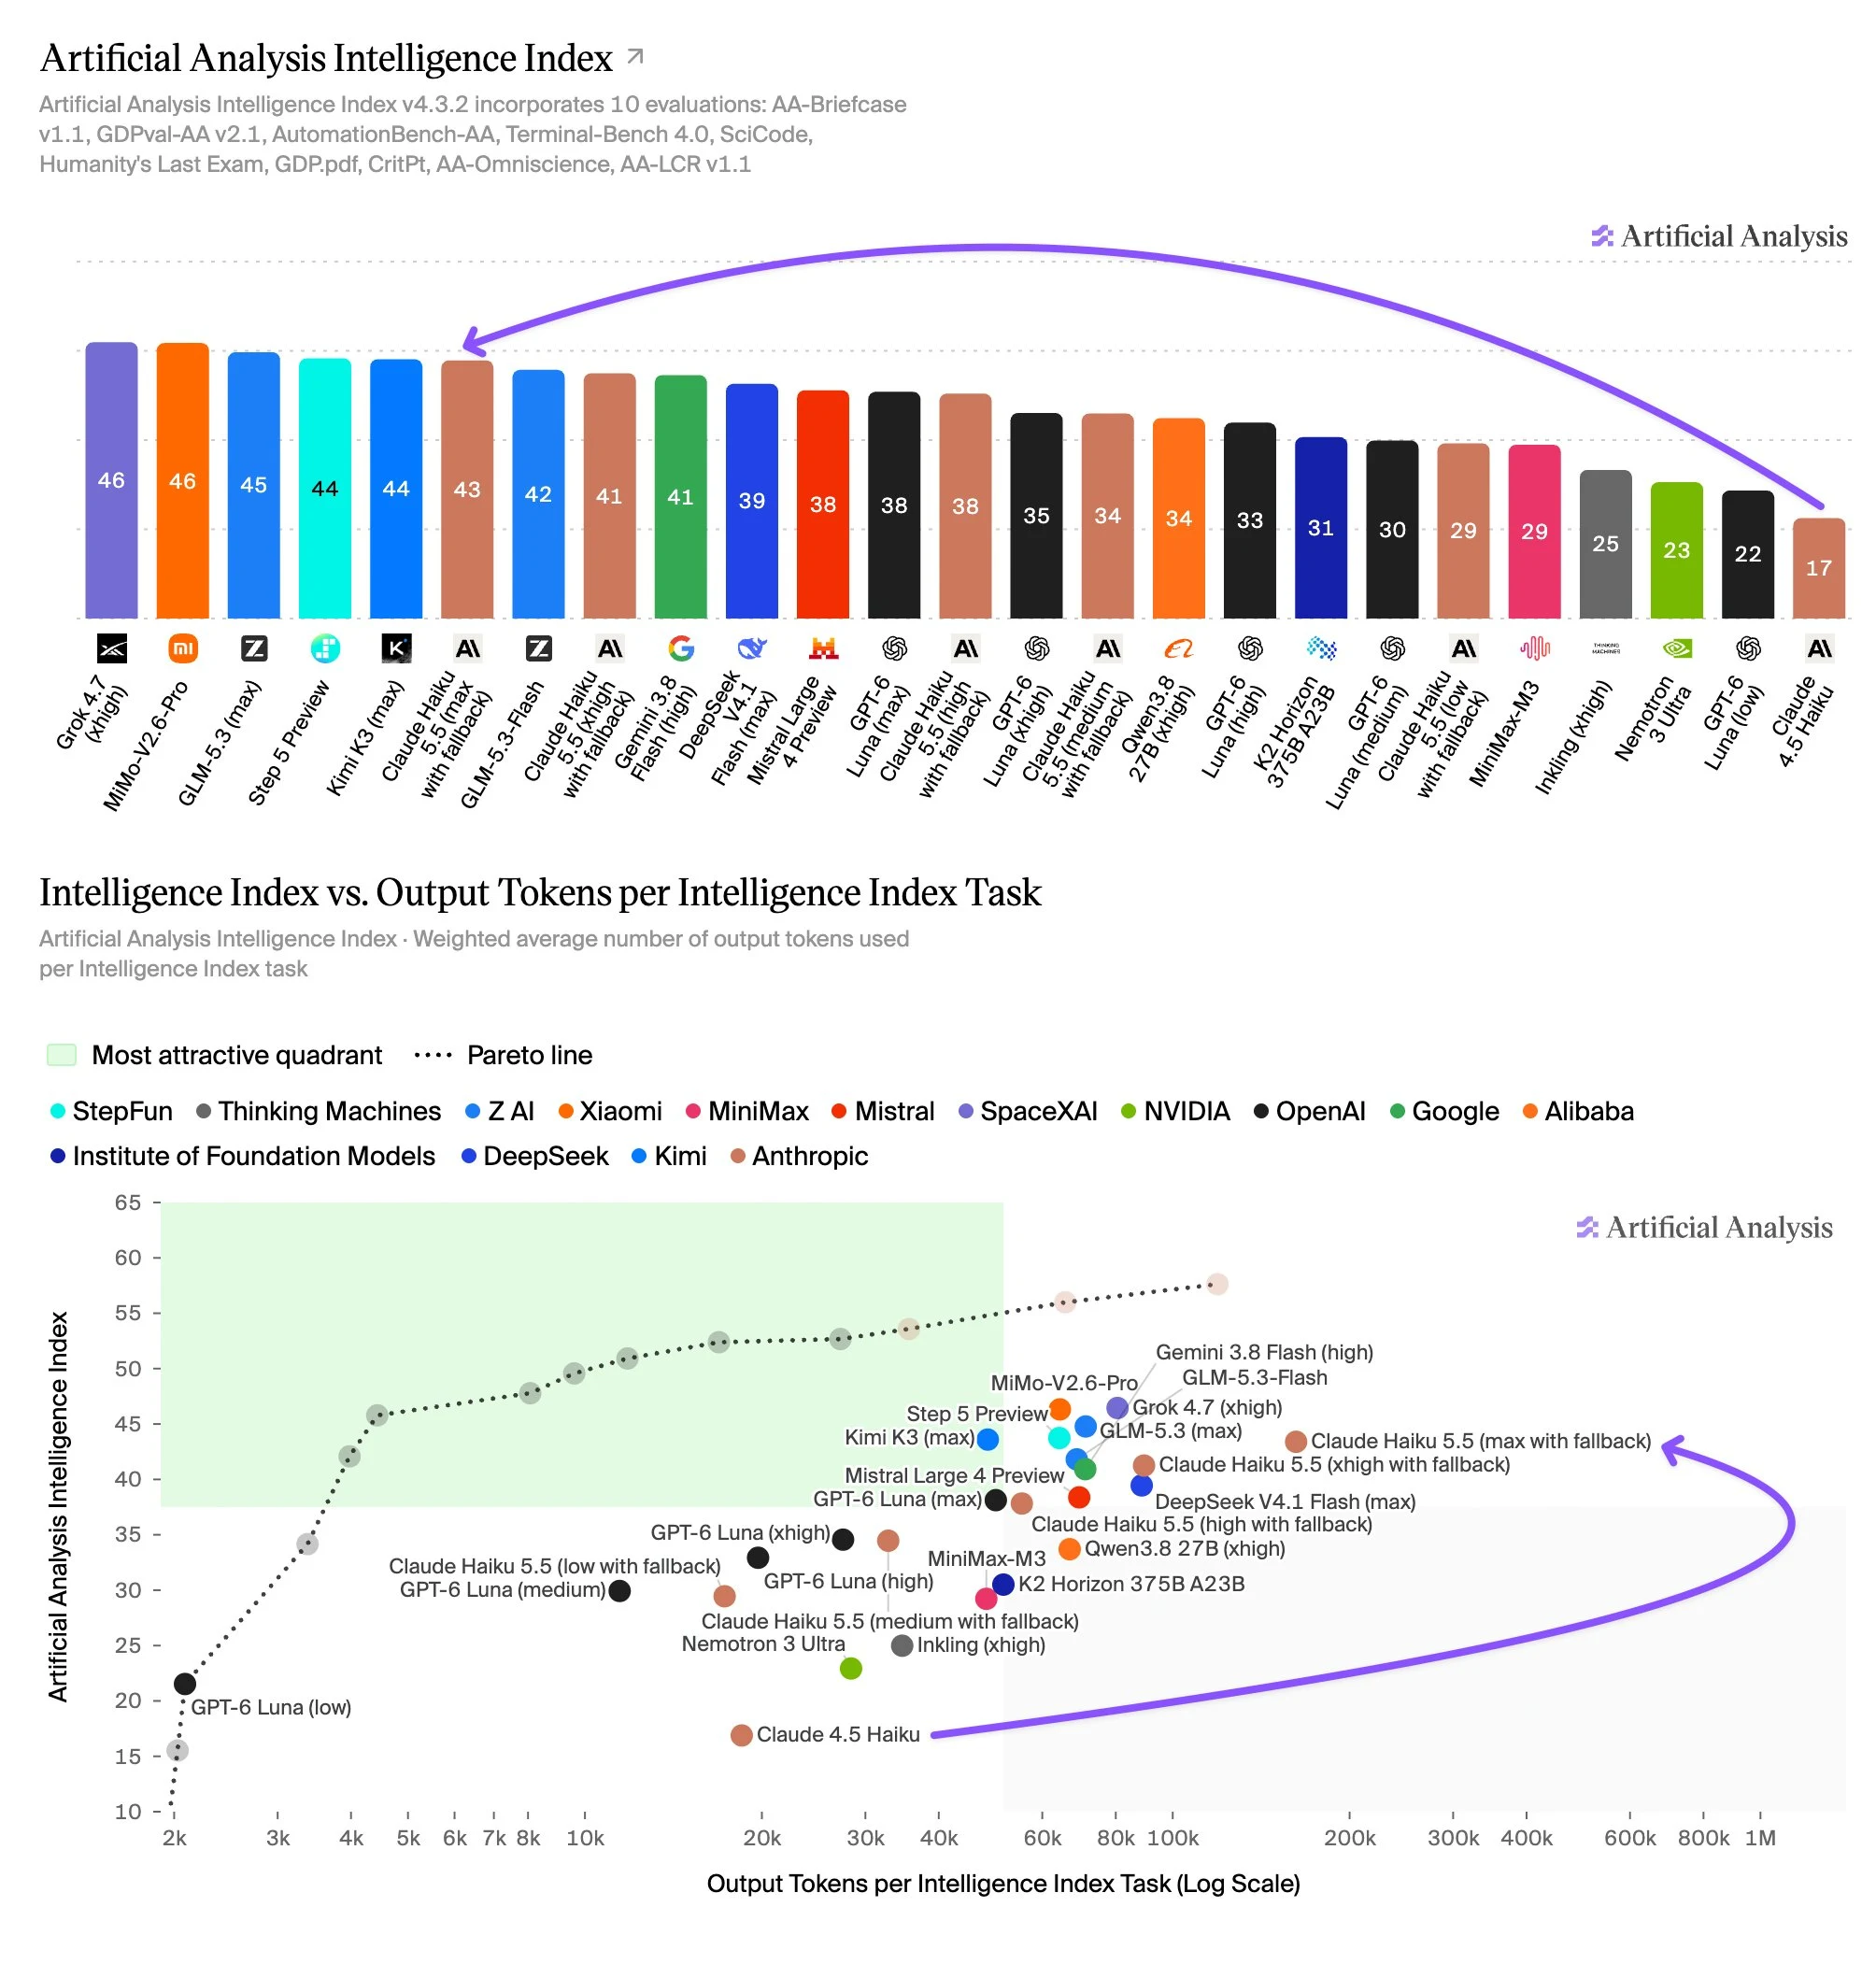
Anthropic 发布了 Claude Haiku 5.5,在 Artificial Analysis Intelligence Index 上得分为 43 分——比上一次 Haiku 发布一年后提升了 26 分
Haiku 5.5 是首个具备 Anthropic effort 设置和自适应思考(adaptive thinking)的 Haiku 模型,Anthropic 还引入了分级定价。
Haiku 5.5 比其前代更便宜——对于不超过 100k tokens 的提示词,其价格为每 1M 输入/输出 tokens 0.10/0.50 美元(与 GPT-6 Luna 相同,为上一代 Haiku 模型的 10%)。然而,超过 100k 后该定价上升 5 倍至 0.50/2.50 美元。网站尚未反映分级定价,因此 Haiku 5.5 的临时成本数据未包含这一阶梯上涨成本。我们正在开发支持,并将很快跟进 Cost per Task 的报道。
要点:
➤ 领先的小型模型性能:在最大 effort 下,Haiku 5.5 略微领先于 GLM-5.3 Flash(42)、Gemini 3.8 Flash(41)和 GPT-6 Luna(38)等模型。其得分与 Kimi K3(44,一个 2.8T 参数的开源权重模型)相当,落后于 Claude Sonnet 5.5(max,56)13 分
➤ 相比 GPT-6 Luna 的沉重 token 使用:Haiku 5.5(max)在每项 Intelligence Index 任务上使用约 162k 输出 tokens,约为 GPT-6 Luna(max,约 50k)的 3 倍。从 xhigh 到 max 增加 2 分但 token 用量约为 1.8 倍。在相近智能水平下,它也比 GPT-6 Luna 使用更多 tokens:Haiku 5.5(high)以每任务约 55k tokens 得 38 分,而 Luna(max)以约 50k tokens 得 38 分,且在更低 effort 设置下差距进一步扩大
➤ 在智能体知识工作方面能力突出:在 AA-Briefcase(我们面向真实知识工作任务的私有评测)上,Haiku 5.5(max)达到 1578 Elo,领先于 Kimi K3 和 GLM-5.3 等模型,与 Muse Spark 1.3(max)相当
➤ 终端使用方面的改进:在 Terminal-Bench 4.0 上得分为 33%,高于 Haiku 4.5 的 0%。这与 GLM-5.3 Flash 持平,领先于 Gemini 3.8 Flash(20%)和 GPT-6 Luna(13%)
➤ 事实知识较低,但幻觉相对较少:正如对更小型模型的预期,Haiku 5.5 的事实知识低于其同系列模型。AA-Omniscience 准确率为 36%,而 Gemini 3.8 Flash 为 55%,GPT-6 Luna 为 44%,但这部分源于它更愿意承认自己不知道——其幻觉率更低,为 40%,而另外两者分别为 55% 和 77%
➤ AutomationBench-AA 结果可能被低估:Haiku 5.5 得分为 35%,而 GPT-6 Luna、Gemini 3.8 Flash 和 GLM-5.3 Flash 为 53–60%。在发布前测试期间,一个安全拒绝问题导致该模型过度拒绝。Anthropic 正在解决这一问题——我们将在修复后重新运行此评测,并预计该得分会上升
其他模型细节:
➤ 上下文窗口:1 百万 tokens,高于 Claude 4.5 Haiku 的 200k
➤ 定价:不超过 100k tokens 时每 1M 输入/输出 tokens 0.10/0.50 美元,超过部分为 0.50/2.50 美元。缓存读取 0.01 美元(超过 100k 为 0.05 美元),5 分钟缓存写入 0.125 美元(超过 100k 为 0.625 美元)
➤ 多模态:文本和图像输入,文本输出